Zusammenfassung
- RFC 1049 schlug
Content-Typefür strukturierte Mail-Inhalte wie PostScript, TeX und TROFF vor. Der Inhalt blieb im ASCII-Rahmen des damaligen Mailformats; ein Leseprogramm konnte anhand des Felds einen Darstellungsprozessor auswählen. - Optional konnten Version und benötigte Ressourcen genannt werden. Solange die Fähigkeiten des Empfängers nicht automatisch bekannt waren, führte der Absender seine eigene Liste geeigneter Adressaten. RFC 2045 verallgemeinerte das Feld später für MIME.
Eine Nachricht kann jedes Zeichen sicher ans Ziel bringen und trotzdem an den Augen des Empfängers scheitern. Wer 1988 PostScript in einem gewöhnlichen Mailprogramm öffnete, sah womöglich die Anweisungen für einen Drucker. Gewünscht war eine Seite mit Formeln und Satz; geliefert wurde die Bauanleitung für diese Seite. Martin Sirbus RFC 1049 vom März 1988 setzte genau dort an: Die Nachricht sollte ihren Inhalt als bestimmtes Format ausweisen.
RFC 822 beschrieb Mail mit definierten Kopfzeilen und einem ASCII-Zeichenkörper. Nutzer schickten darin bereits TROFF, TeX, Scribe, SGML, DVI und PostScript. Diese Dokumente konnten als erlaubte Zeichen transportiert werden und verlangten für ihre beabsichtigte Darstellung doch ein zusätzliches Programm. Ein Feld namens Content-Type gab dem Mailleser die Möglichkeit, die Technik zu erkennen und den Inhalt an den passenden Prozessor weiterzugeben. Die Transportstrecke trug weiter die Zeichen; die Arbeit am Bild übernahm der lesende Rechner.
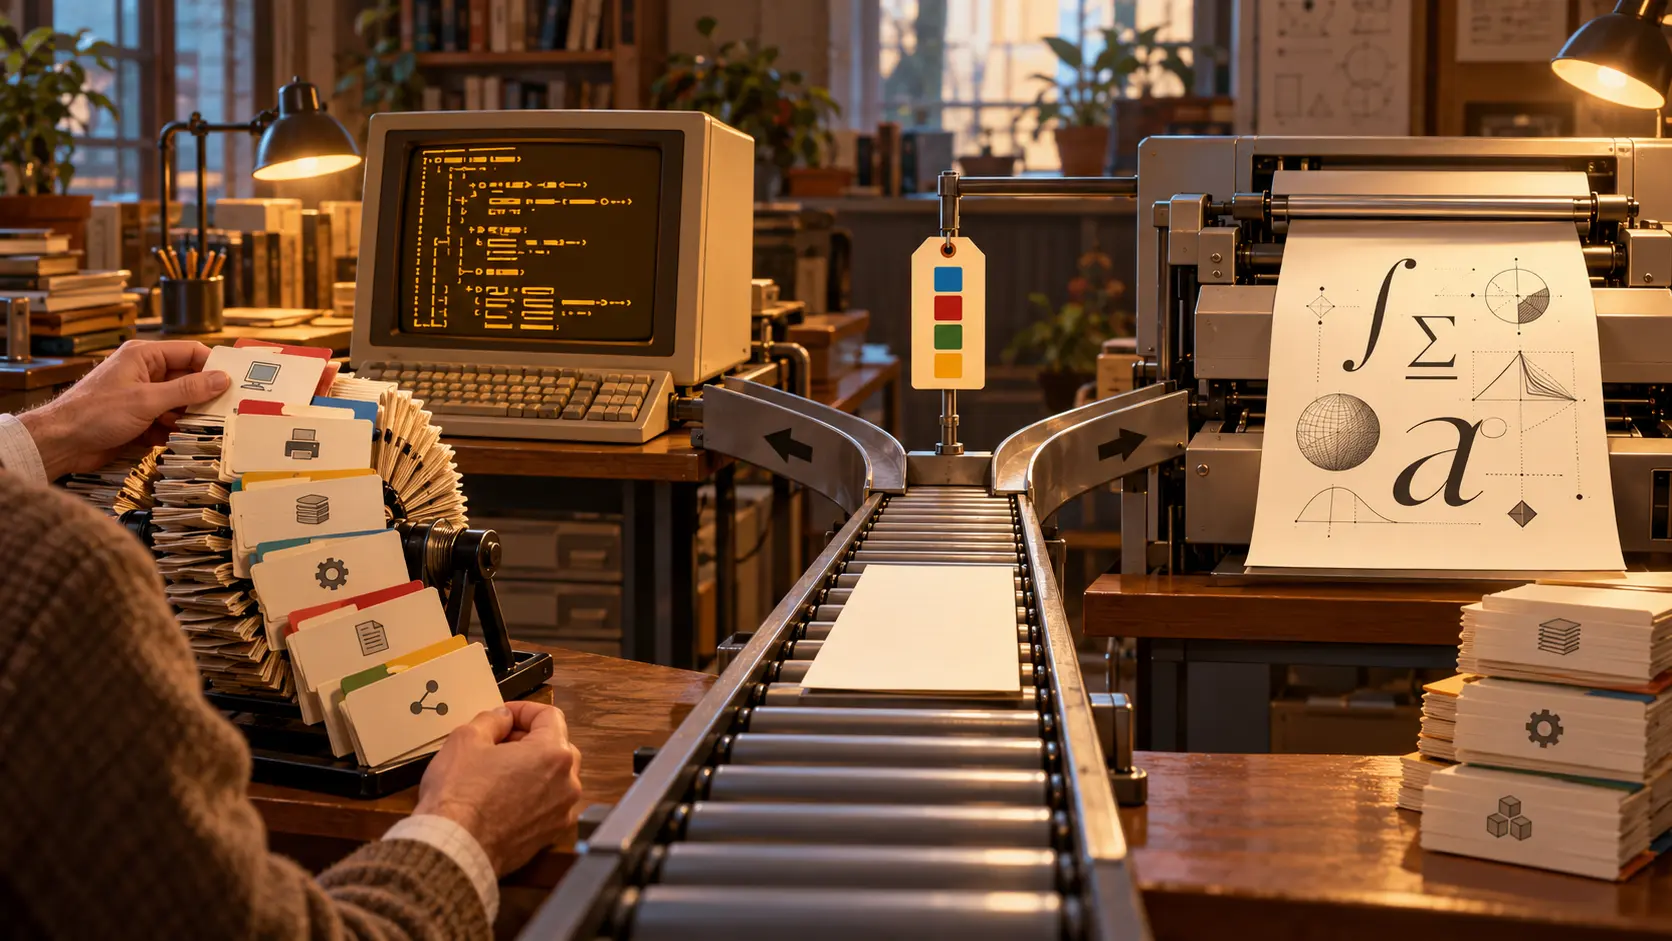
Das Etikett sollte mehr sagen als „irgendein Sonderformat“. Zuerst stand der Typ, etwa POSTSCRIPT oder TROFF, mit einer X--Schiene für private Absprachen. Danach konnten Versionsnummer, Ressourcenverweis und Kommentar folgen. Sirbu nannte LaserPrep-Versionen für PostScript sowie eqn, tbl und me für TROFF. Der Name eines Gerichts verrät viel, doch ohne die nötigen Zutaten bleibt der Teller leer. Ein Ressourcenverweis machte solche Abhängigkeiten im Nachrichtenkopf sichtbar.
Am Ziel fehlte möglicherweise gerade dieses Werkzeug. Der ASCII-Inhalt konnte ankommen, während das Leseprogramm nur Rohbefehle zeigte. Wie sollte der Absender erfahren, welche Adressaten welche Programme besaßen? RFC 1049 prüfte drei Wege. Jeder Sender könnte eine Datenbank fremder Fähigkeiten pflegen. SMTP könnte während der Zustellung Fähigkeiten aushandeln und den Inhalt umwandeln. Ein Verzeichnisdienst könnte die Ausstattung der Zielsysteme veröffentlichen. Die erste Liste veraltet; die zweite verlangt Umbauten an Mailern und erreicht nicht jede Route über andere Netze; die dritte bindet Versand und Namensdienst in die Aufgabe ein.
Für frühe Versuche entschied sich Sirbu für die menschlichste Variante: Absender sollten ihre eigene private Liste geeigneter Empfänger führen. Das Format bekam einen gemeinsamen Namen, die Kompatibilität blieb im Adressbuch. Auch die konkrete Reaktion eines Leseprogramms auf ein gültiges Feld wurde offengelassen. Einen Typ zu erkennen, seinen Interpreter zu besitzen und eine brauchbare Seite zu zeigen sind drei verschiedene Leistungen.
Die spätere Verbindung ist in RFC 2045 ausdrücklich dokumentiert. MIME verallgemeinerte das Content-Type-Feld von RFC 1049 zu Medientyp und Untertyp samt Parametern; weitere Felder wie MIME-Version und Content-Transfer-Encoding kamen hinzu. Die Spezifikation von 1996 nennt die ältere Syntax einfacher und weitgehend kompatibel. Der entscheidende Moment von 1988 bleibt eigenständig: Mail konnte ihren Inhalt benennen, während das Wissen über die Leser noch beim Absender lag.
Mit dem kleinen Etikett mussten Empfänger das Format nicht mehr aus einem Bildschirm voller Befehle erraten. Die teurere Frage trat hervor: Wer hat den Interpreter, die richtige Version und das erforderliche Zubehör? Eine Zeit lang saß die wichtigste Fähigkeitsdatenbank vor der Tastatur und drückte auf „Senden“.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten