
摘要
- RFC 3545 把变化中的上下文值连续放进 N+1 个分组;只要连续丢包没有超出链路假设的范围,解压端就有机会重新同步。
- 可选的 HDRCKSUM 能在 IPv4 UDP 校验和为零时核验重建报头,却不覆盖 IPv4 Identification;丢失超过 N 个连续分组后,更稳妥的做法是使上下文失效并请求其状态。
这项校验有一个盲区。RFC 3545 允许压缩端用 16 位报头校验和替代值为零的 IPv4 UDP 校验和,让解压端核验重建结果。但 IPv4 Identification 并不在它检查的字段之中。在没有明显丢包的链路上,这个缺口可能藏在更完整的恢复机制里;连续丢包太多时,它却会改变“已恢复”究竟能证明什么。
RFC 2508 定义的 CRTP 会压缩 IP、UDP 和 RTP 报头,并让通信两端共享上下文。完整报头先建立状态,后续分组再携带变化或差分值。如果承载某次更新的分组丢失,压缩端继续向前,解压端却停在旧状态。这个差异可能要等下一份压缩报文到达才显现。长时延链路上的上下文修复至少需要一个往返时间;等待期间,解压端可能丢弃更多分组。
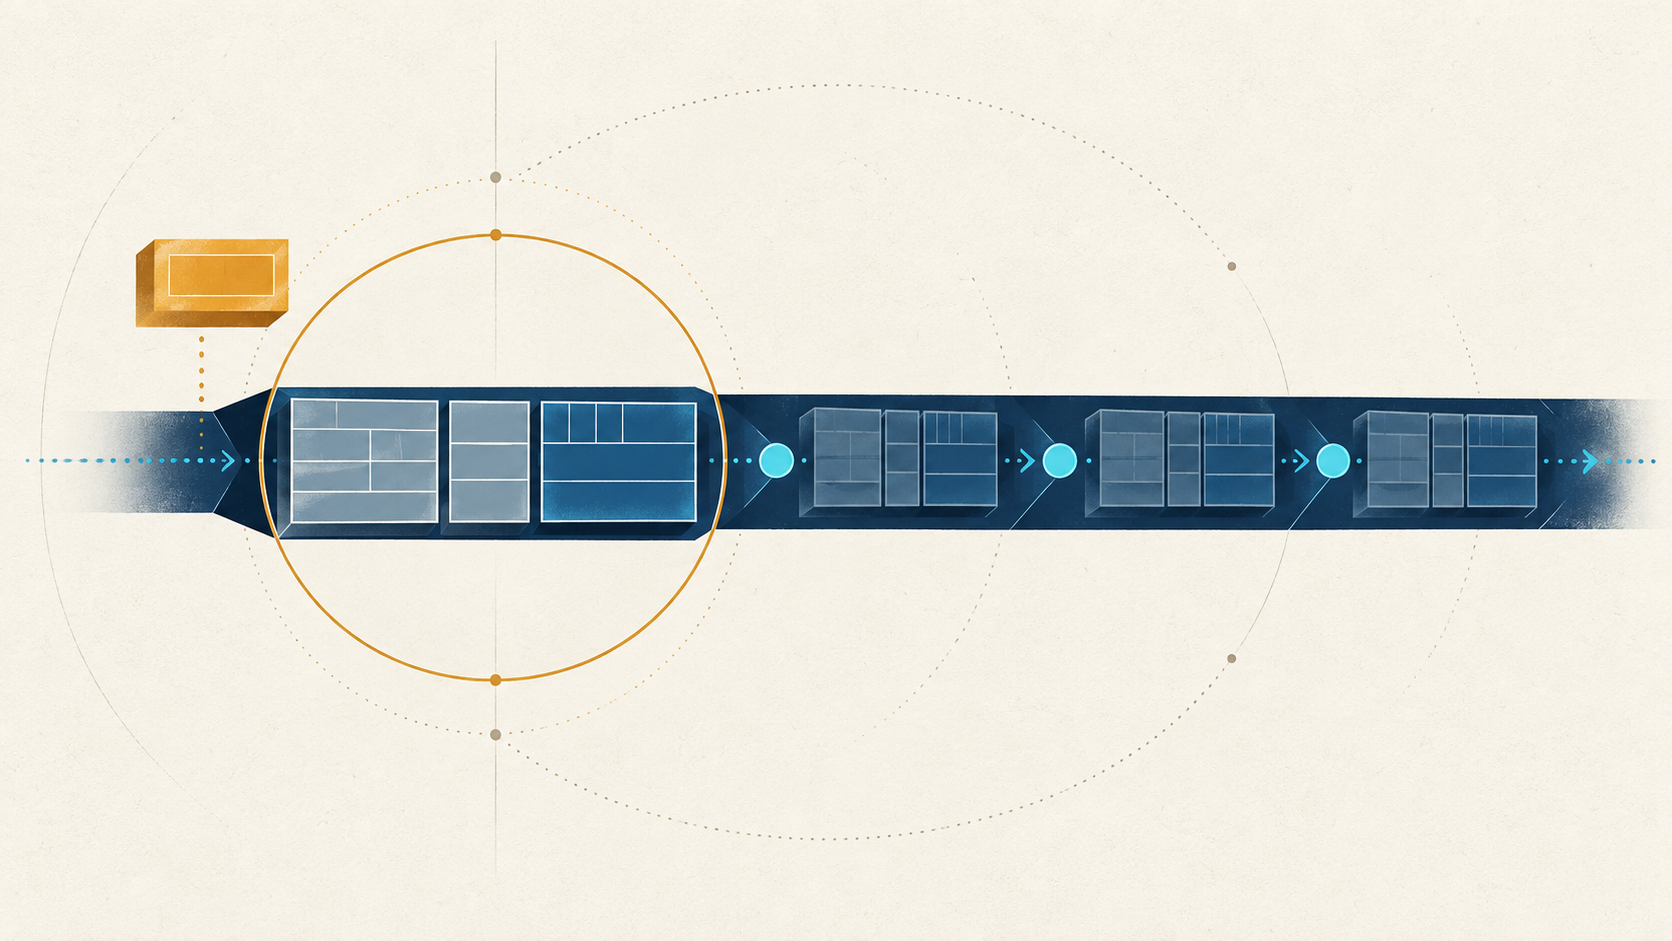
RFC 3545 用重复更新处理这个问题,同时划出明确的边界。它以 N 描述链路损失特征:连续丢失超过 N 个分组的概率应当较小。若一项更新连续出现在 N+1 个分组中,只要丢失突发不超过 N,解压端至少能收到一份副本。随后可以使用“twice”算法重建有限的间隔,并通过 UDP 校验和或适用时的 HDRCKSUM 核验结果。这提高了容错性,却不保证每次丢包都符合链路模型。
链路序号只有四位,每 16 个分组就循环一次。因此,序号差异不总能区分大量丢包与分组乱序:后发分组可能先到,较早的分组随后才到。如果一种合理解释对应的丢失数少于 N+1,解压端可以尝试相应的重建并核验。如果可能的丢失数超过 N,IPv4 的规则更明确:不要继续用“twice”猜测,而应使上下文失效并发送 CONTEXT_STATE,由压缩端恢复共享状态。
此时校验覆盖范围就很重要。仅当原始 IPv4 UDP 校验和值为零时,压缩端才可插入 HDRCKSUM;解压端核验后会将其移除。IPv6 不允许 UDP 校验和为零,因此不使用这一选项。可它仍然不核验 IPv4 Identification。丢失超过 N 个分组后,即使校验通过,也无法补上这一缺失:RFC 3545 要求放弃不确定的 IPv4 上下文。IPv6 没有 IPv4 ID 字段,因而可采用不同的恢复规则。
更新突发也有自己的身份保护。如果 N+1 个 FULL_HEADER 分组发送期间,一个应保持不变的上下文字段发生变化,压缩端必须开启新一轮发送并更改 generation number。否则解压端可能把重叠的两轮误当作更大的丢包容忍窗口,漏掉上下文不同步。CONTEXT_STATE 响应也应重复发送。这些只是协议机制,并不能证明某个设备实际启用了扩展,更不能证明 RTP 应用已经播放了负载。
这段历史中的要点很克制,却有运维意义:校验和只能证明其覆盖的字段,有限范围内的重建不等于交付,上下文修复也不是媒体确认。局部校验成功时,IPv4 ID 仍可能未经核验。丢包模式超出假定边界后,使上下文失效不是放弃恢复,而是不把含糊的序列伪装成确定事实。
来源
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance