
摘要
- 活动规则集可以忽略某种协议、交换方向后重试、遮蔽地址位、只把选定属性压入流记录,并规定 NeMaC 最终收集哪些列;记录因此是一种有版本的观察投影。
- NeTraMet 用哈希规则组和掩码索引让这套投影跑得动,但最小分组阈值、掩码表容量等编译期限制也随之进入了记录的语境。
- 流表接近容量时,计量器可以从生产规则切到更粗的备用规则,再在
FloodMark切到默认规则;重启后同样先运行默认规则,文档中的配置可能在生产规则恢复前损失最多五分钟数据。
数据包先遇到规则,后遇到计数器
RFC 2123 于 1997 年 3 月以 Informational 文档发布,记录了三年 RTFM 实现与运行经验。那套架构把工作拆成四环:计量器观察数据包,读取器搬运使用数据,管理器配置计量器并控制读取器,分析程序再把记录变成速率、图表和报告。
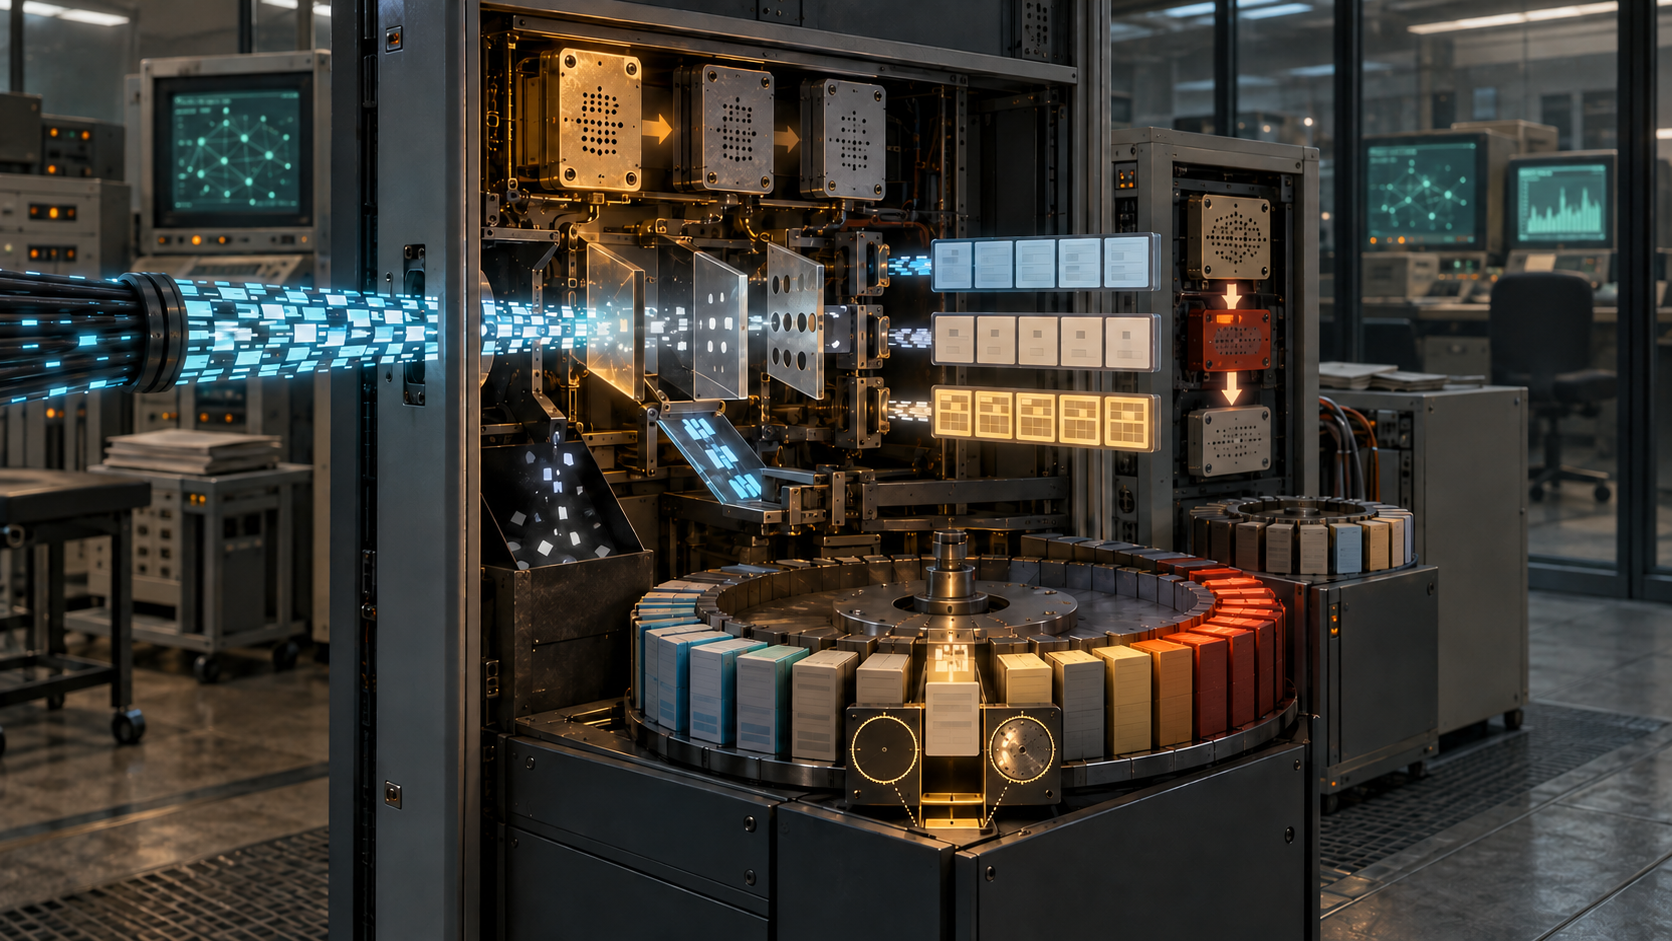
在本文所述实现中,NeTraMet 是计量器,NeMaC 兼任管理器与读取器。任何一行记录出现之前,NeMaC 已经把一套规则下载到 Packet Matching Engine。规则可以测试协议、地址和计算属性,可以把选中的值压入流结构,也可以忽略数据包、跳转到另一段规则,或者把源与目的对调后再做一次匹配。规则文件还带着输出格式,决定读取器后来取走哪些属性。
因此,“方向”并非线路天然附带且永远不变的事实。规则可以围绕本地网络、指定网关或知名端口来定向流量。这样的归一化很有用,但解释者必须拿到同一套约定,不能只看一列 Source 就把它当成宇宙通用的源端。
RFC Editor 记录与 IETF Datatracker保留了文档身份:这是一份实现经验,不是互联网标准,也不是对所有部署的审计结论。当前官方 RFC 2123 勘误查询没有匹配结果;“没有已登记勘误”不等于“任何实现和推断都已经得到认证”。
被忽略的流量不会留下“我曾存在”的凭证
RFC 2123 写到一个十分直接的优化:如果运营者只关心 IP,就没有必要缓存并继续处理 Novell 或 EtherTalk 数据包。NeTraMet 会检查活动规则,推断哪些 Peer type 属于关注范围;不在范围内的协议识别完类型后便停止处理。若规则从不测试相邻层地址,也无需把这些字段复制进缓冲区。
这同时节省处理器与内存,却也关闭了事后追问的入口。一份完整的 IP 流文件可以准确回答“所选 IP 流量是多少”,却无法证明同一链路上没有别的协议。选择器从未保留的属性,不会因为后来的调查更重要而重新出现。
RFC 2063 架构本来就主张在观察点附近完成数据压缩,以减少远程传输和后续分析负担。RFC 2123 展示了这种设计在运行代码里的样子:效率的正面与未选信息的消失,本就是同一项决定。
哈希与掩码让分类更快,也把实现边界带进了数据
地址分类可能包含数百条规则。逐条顺序测试太慢,NeTraMet 于是找出“测试相同属性、使用相同掩码”的规则组,在启用新规则集前把它们编译成哈希表。数据包到来时只需遮蔽属性、计算哈希并在通常很短的链上比较。小规则组仍按顺序执行,因为最小分组规模是在编译程序时确定的。
地址掩码也有成本。流记录既要保存遮蔽后的地址,又要区分“实际为零”与“被掩码忽略”的位。文档中的版本为常用掩码建立表格,流结构只存一个字节的索引;最大掩码数量同样是编译期上限,最高 256。
这些优化没有让记录失真,反而让复杂分类在当时的硬件上可行。但它们提醒我们:保留下来的地址,是经过特定掩码的地址;类别,是沿着特定规则路径得出的类别;一个规则文件能否装入,又受可执行程序限制。离开规则版本和构建语境,记录就只剩外形相同的数字。
内存压力会在不中断进程的情况下更换问题
NeTraMet 启动时确定最大流表规模。流结构按块分配,增量垃圾回收器根据不活跃时间和读取器进度释放空间。如果收集速度落后于新流生成速度,表仍可能逼近容量。
活动流比例超过 HighWaterMark 时,架构允许计量器改用备用规则。奥克兰的备用规则可以保留与生产规则相似的分类骨架,却少压入许多属性。文档说,这种降级曾让计量器在读取器故障后继续运行一两天,等读取器恢复后再取得累计数据。
到达 FloodMark 后,NeTraMet 切换到内建默认规则,避免垃圾回收占用越来越多时间,最终连管理器请求也无法回应。65% 的高水位和 95% 的洪泛位在该实践中表现良好,但它们不是适用于所有设备和负载的安全常数。
这里最容易误判的是“服务仍在线”。生产、备用、默认三种模式都可能产出内部一致的行,却以不同粒度和选择范围回答不同问题。进程连续,不等于统计口径连续。
重启先恢复最低默认状态,再等待政策归位
计量器因停电等原因重启后,先执行内建的规则集 1。NeMaC 定期读取 sysUptime;若新值比上次小,便判断计量器已重启,随后重新下载备用与生产规则,并要求重新启用生产规则。
文档中的日常配置是五分钟 keepalive、十五分钟收集间隔。因此,计量器重启后,在规则重新下载前最多可能损失五分钟数据。这个数字来自那一处配置,不是协议向所有系统提供的上限。更重要的是,默认规则期间的分类范围可能与生产规则不同,缺口既可能是数量缺失,也可能是口径改变。
所以,重启后重新增长的计数器并不能自动接回旧序列。只有同时保留 uptime、重启检测时间、规则下载时间与活动规则身份,才知道两侧数字是否可比较。
FlowIndex 是可复用位置,不是永久身份
垃圾回收器释放一行后,计量器可以把同一个 FlowIndex 分给另一条流。RFC 2123 明确要求用 FlowRuleSet、FlowIndex 与 StartTime 的组合唯一识别一条流。单独的 index 只是表格位置。
收集过程也不是冻结瞬间。为了减少 SNMP 报文,NeMaC 可以按列读取所需属性;当较早一列已经读完后,新行才变为活动,这一行会被留到下一轮。一次成功轮询证明请求得到了响应,却不证明取得了整张表的原子快照。RFC 2064 Meter MIB给出了相关控制对象。1999 年的 RFC 2722 架构后来修订并澄清了模型,但不能倒推成每个 1997 年站点都已经运行的事实。
文档还记录了特定硬件性能:10 MHz 286 约每秒 750 包,25 MHz 386SX 约 1,250 包,用户报告 40 MHz 486 可在无丢包时承受约 3,000 包峰值。它们是特定机器、代码路径与负载的观察,不是普遍无丢包证明,更不是计费权威、完整覆盖或安全保证。RFC 2123 也没有详细规定安全,而是把完整性与机密性责任交给管理和收集协议。
Lu Heng 后来的运行代码优先提供了一个阅读纪律:先问系统实际执行了什么,不让名称代替行为。最小初始规范把部署选择留在本地,不把一种配置提升为普遍权威;现实层级则区分文档、可执行规则、收集记录与网络结果。这些是后来的分析框架,不是对 RFC 作者意图的史料。
RFC 2123 真正留下的是一条证据保管链:管理器提出问题,计量器按规则投影,资源压力可能降低分辨率,读取器取得非原子视图,分析程序再生成结论。流量记录之所以有价值,是因为每个环节都能被指认;不是因为那一行数字可以假装自己就是线路。
来源
- RFC 2123,Traffic Flow Measurement: Experiences with NeTraMet
- RFC Editor 的 RFC 2123 记录
- IETF Datatracker 的 RFC 2123 记录
- RFC 2123 勘误查询
- RFC 2063,流量测量架构
- RFC 2064,Meter MIB
- RFC 2722,后续流量测量架构
- Running-Code Primacy
- Minimum Initial Specification
- On Reality Layers, Symbolic Power, and Why Clarity Feels So Hostile
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance