
摘要
- HTTP
Age表示缓存对“响应自始发服务器生成或成功验证以来所经过秒数”的估算,不是 URL、文档、表示内容或其中事实的创建时间。 - 每个缓存把上游的
Age、始发站的Date、本地请求与响应时刻、网络延迟和驻留时间合并;无验证复用时,它用计算所得的current_age替换旧值,而不是追加一份路径清单。 - “是否新鲜”是另一道判断:把当前年龄与来自缓存指令、
Expires或许可启发式的生命周期比较。一个年龄数字既不证明验证,也不单独决定能否复用。
两分钟的响应可以承载三年前的内容
设想一份三年前写成、正文一直未改的政策文档。始发服务器两分钟前确认缓存中的表示仍然有效,边缘缓存随后把它交给读者。此时 Age: 120 完全合理。它回答的是“从生成或最近一次成功验证这份响应起经过了多久”,而不是“这篇文档诞生了多久”。
日常语言把年龄归给对象,HTTP 却把这个字段归给响应。URL 所指资源可能比服务器还老;相同字节可以经历多次验证;缓存条目可以被更新、替换和驱逐。Age 不保存这些历史,也不对内容的新旧作文化判断。它只是缓存复用计算中的一个时间量。
这个量之所以需要跨网络传递,是因为一次读取可能连续经过多个独立缓存。每个节点只知道自己的时钟和本地驻留时间。如果下游每次都从零开始,响应便会在每一层“返老还童”;如果只拿始发站 Date 与本地墙上时钟相减,时钟偏差又可能制造负数或夸大的年龄。
HTTP/1.0 有缓存,却没有共同年龄字段
1996 年的 HTTP/1.0 规范描述了缓存、日期和过期,但它列出的响应头没有 Age,也没有一套让响应年龄穿过缓存链的标准算法。实现可以看 Date、Expires 和本地接收时刻,却无法从一个共同字段得知响应在上游已经停留多久。
HTTP/1.1 在 1997 年补上这层薄协议。发送缓存响应的一方携带自己的年龄估算,接收方在此基础上继续计算。早期规范还明确指出:缓存响应若经过成功验证,年龄以验证时刻为基础,而不是以原始响应为基础。这一条从一开始就划清了边界:Age 服务于复用决定,不服务于档案定年。
它没有要求建立全球时间服务,也没有要求每个缓存公开完整日志。共同层只传递一个可继续运算的数值;各节点仍要对自己看到的字段、时钟和复用结果负责。
两种不完美观察互相校正
缓存收到响应时,可以从两个方向估算初始年龄。第一种把本地接收时刻与始发站 Date 相减:
apparent_age = max(0, response_time - date_value)
若始发时钟走在前面,差值可能为负,因此算法以零为下限。这种“表观年龄”直观,却同时依赖两个时钟。
第二种继承上游 Age,再补上本次请求往返所占时间:
response_delay = response_time - request_time
corrected_age_value = age_value + response_delay
这条路径主要依靠同一节点的本地经过时间,不必相信两台机器的墙上时钟完全同步;但它要求上游缓存确实按照 HTTP/1.1 或更新规则维护 Age。旧实现或错误实现会让继承值偏小。
兼容性更保守的做法取两者较大值:
corrected_initial_age = max(apparent_age, corrected_age_value)
当前规范允许在不担心旧缓存漏写 Age 时直接采用修正年龄值。无论采用哪条规定,设计的要点都不是寻找一只绝对正确的远端时钟,而是让本地代码在可见证据之间作出确定选择。
驻留时间只能由本地节点添加
响应进入缓存后,上游无法预知它会停留多久。这个事实只在本地形成:
resident_time = now - response_time
current_age = corrected_initial_age + resident_time
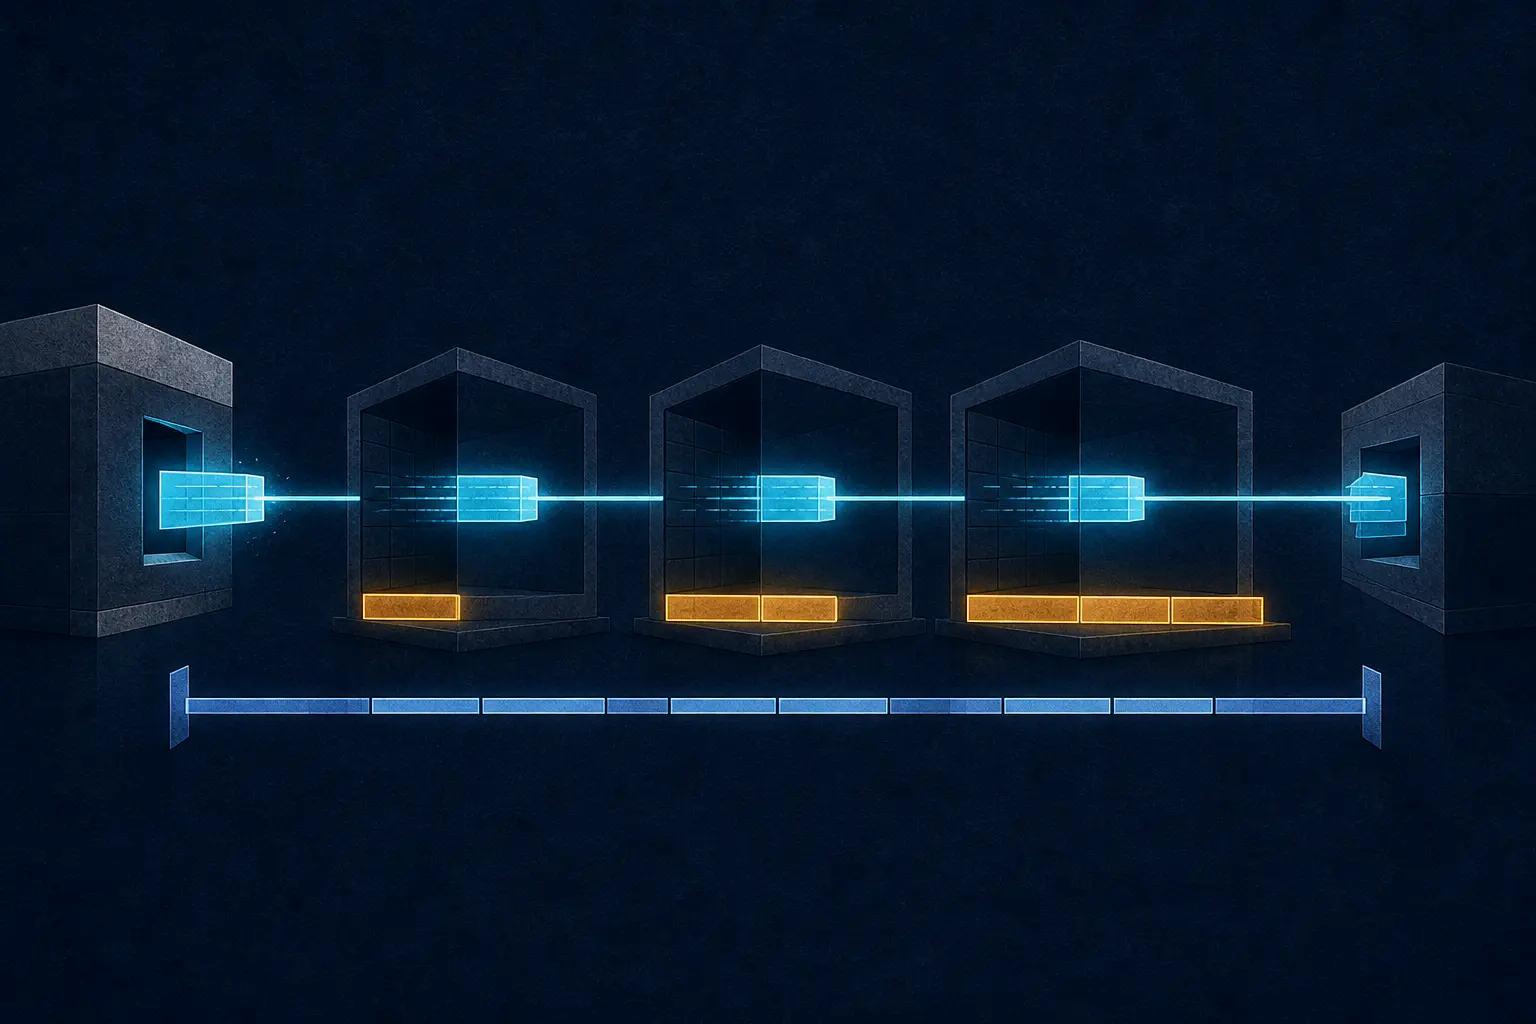
当缓存不经验证就用存储响应回答新请求时,它必须生成 Age,并用当前计算结果替换收到的旧字段。它不会添加第二个年龄,也不会把每一跳的名称串在后面。下一层继承这个总数,再加入自己的网络延迟和驻留时间。
因此,一个标量保存了“时间已经累积”这一事实,却主动舍弃了“时间在哪里累积”的路径细节。两个长驻留缓存与十个短驻留缓存可能给出同样的数字。接收者不能从 Age: 120 反推出缓存跳数、节点身份、托管顺序或每一层收据。
这种信息压缩不是缺陷,而是协议范围的选择。下游无需取得所有上游日志即可继续作新鲜度计算,但任何需要追责或溯源的场景都不能只保存最终数字。
年龄与新鲜生命周期是两张不同的账
把 Age: 120 读成“还能新鲜 120 秒”或“新鲜了 120 秒”都不对。年龄是已经经过的估计时间;新鲜生命周期是规则允许响应在无验证情况下复用多长时间。
真正的比较是:
response_is_fresh = (freshness_lifetime > current_age)
生命周期可以由共享缓存适用的 s-maxage、一般 max-age、Expires 与 Date 的间隔,或在允许时由启发式算法得出。同一个 120 秒年龄,在 300 秒生命周期下仍新鲜,在 60 秒生命周期下已经陈旧。
“陈旧”也不是对内容真假或安全性的裁决。缓存可以发起验证;某些指令、扩展或断网条件可以允许复用陈旧响应。反过来,一个年龄很小的响应也可能因为 no-store、请求约束或错误变体而不可用。对象选择、年龄计算、生命周期与复用授权是四个不同问题。
成功验证可以让旧字节获得较新的响应年龄
缓存保存一份表示一天后,用验证器向始发站询问是否仍然有效。若得到成功确认,原有字节可以继续使用,而响应年龄以这次验证为新的依据。内容并没有被改写,发布日期也没有消失;改变的是始发站最近一次确认复用的时间关系。
这正说明为什么不能用较小的 Age 推断内容刚刚更新,也不能用较大的值推断始发站已经失联。Age 不携带 ETag 是否匹配、返回了什么验证状态、哪些元数据被更新。验证证据必须另行记录。
当前 HTTP 允许一项更窄的推论:出现 Age,表示该响应并非一手响应,而是缓存基于已存状态生成。仅凭这个字段,无法判断缓存是在本次请求中向始发站完成验证,还是沿用了更早的验证结果。反向推论不成立。没有 Age 不证明始发站被联系过;旧缓存可能不支持,错误实现可能遗漏,观察系统也可能丢掉字段。
溢出值保护计算,不制造精确历史
Age 是以秒计的非负整数。值若包含其他内容,缓存应忽略。若接收的秒数过大或后续运算溢出,规范保留历史约定:按 2147483648 或实现可便利表达的最大正整数处理。
这个值常被解释为超过 68 年的“实际无限大”,目的是防止溢出重新变成负数或小数,使极老响应看起来年轻。它不是一次精确观测,不证明响应真的在缓存里住了 2,147,483,648 秒。饱和是安全的计算状态,而不是历史证书。
可解释决定需要保存整个算式
调查缓存异常时,最终 Age 远远不够。记录应包含完整缓存键与变体、收到的 Date 和 Age、同一时钟域中的请求时刻、响应时刻和决定时刻、各个中间计算量,以及生命周期来自哪条指令或启发式。
还要记录是否进行了始发验证、返回什么状态和验证器元数据,以及最终走的是直接新鲜复用、验证后复用、规则许可的陈旧复用还是失败。只有这样,运维人员才能区分上游驻留、网络延迟、本地驻留、时钟偏差和错误选择。
互联网在这里没有建立一个替所有缓存裁决的中央账本。始发站提供时间、策略和验证器;缓存选择对象、测量本地经过时间、执行比较并承担复用后果;下游再用同样的共同规则验证与延续。字段协调了计算,却没有取得对象历史的统治权。
来源
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance