
摘要
- Observability Pipelines 可在客户自己的基础设施内过滤、采样、去重、脱敏并分流遥测数据,位置早于下游索引和存储。
- 经济性不能只看减少了多少字节,而要看已验证的节省是否仍高于 Worker 运维、规则治理、恢复演练,以及无法重建证据所带来的预期损失。
- 可辩护的部署必须保护不可删除的数据类别,计量每一次裁剪,保留独立恢复路径,并通过限时回放证明未来的事故与审计问题仍可回答。
把一条过滤规则从下游日志索引移到数据产生系统旁边的 Worker。下一张账单可能马上变小。随后发生事故,调查者需要一个未命中过滤条件的事件。它从未到达索引,也没有进入归档,更不会出现在分析人员的查询里。节省是真的,缺失的事实也是真的。
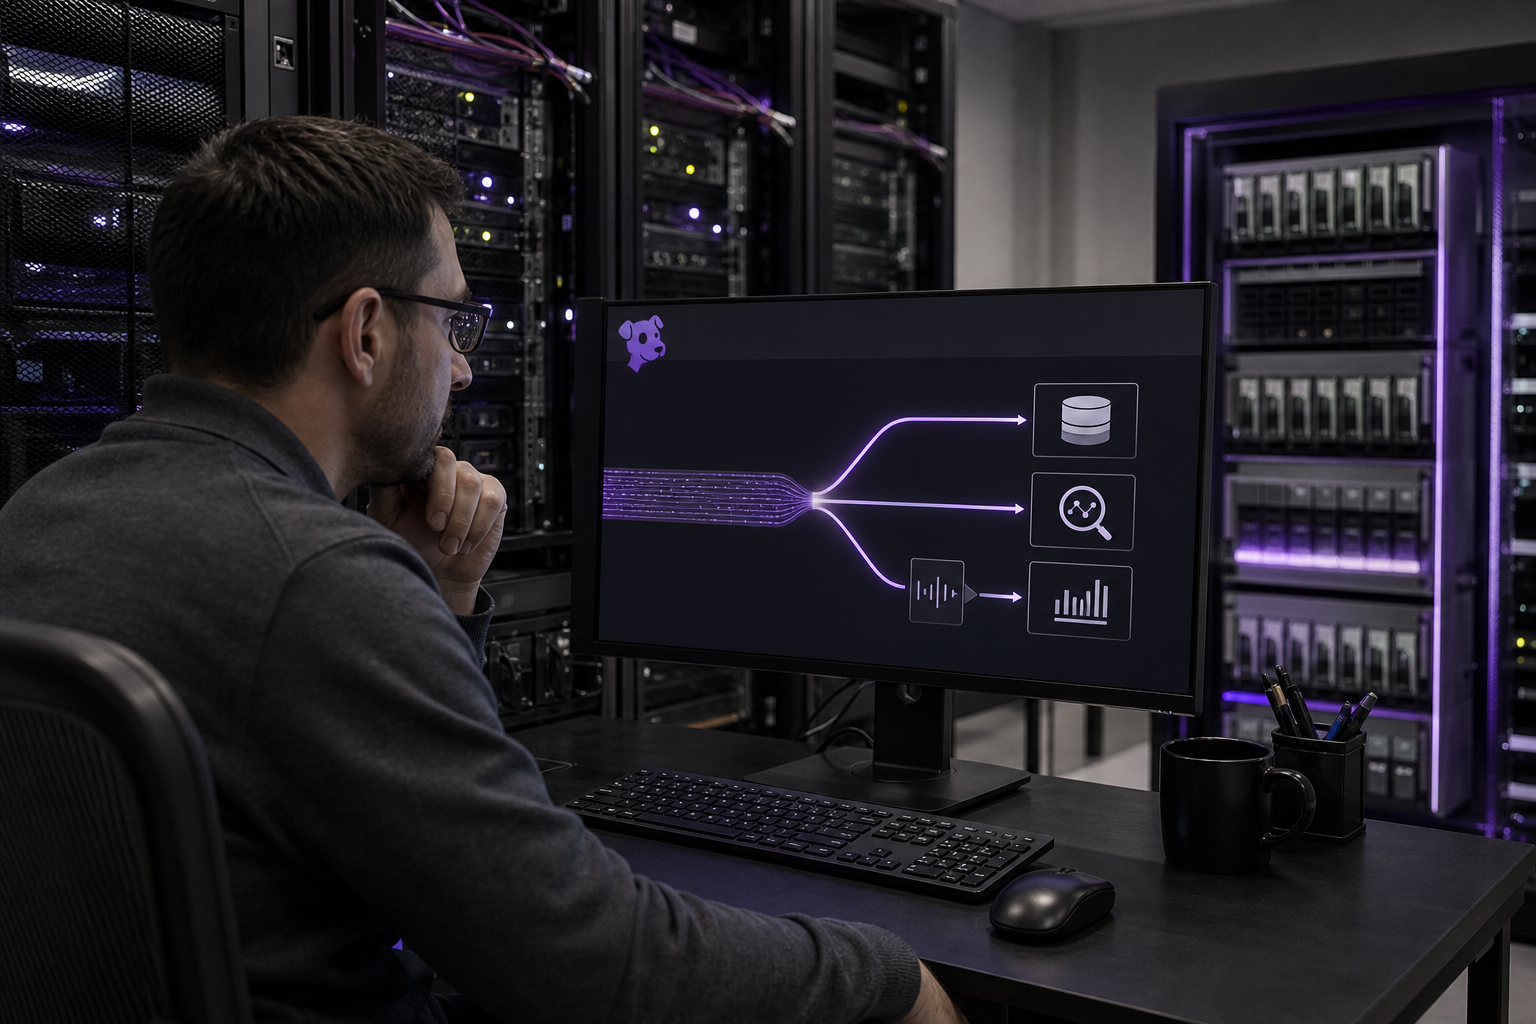
这正是 Datadog Observability Pipelines 的战略意义。Datadog 的文档称,Worker 运行在客户基础设施中,可在日志、指标和追踪数据离开该环境之前完成处理与分流。产品模板包括数据量控制、敏感数据脱敏、双路发送、原始日志归档、指标标签治理和追踪采样。它不只是传输工具,而是把一个关键控制面重新安置到了上游。
商业吸引力并不难理解。可观测性与安全费用往往随事件数、字节数、索引量、保留时间或高基数维度上升。更早剔除噪声,可以避免多个下游系统为同一批低价值数据重复收费。把重复日志转成指标,也可能用更小的存储量保留趋势。数据在导出前完成脱敏,还能缩小秘密和个人信息的扩散范围。
但处理器的明确语义说明,单纯设定“削减百分比”并不够。Datadog 的 Filter 文档写明:匹配的事件继续向后传递,不匹配的事件会在后续处理器或目的地之前被丢弃。Sample 处理器只保留指定比例的匹配日志或追踪,其余删除。Quota 处理器在每日限额达到后可保留、丢弃或把超额日志送往存储;分布式计数在 Worker 同步之间可能超出限额。去重则使用每个 Worker 本地的内存 LRU 缓存来删除重复事件。每种功能都可能合理,但每种功能也在替未来作判断:哪些事实以后不会再需要。
这种判断的真正责任人很容易被组织结构掩盖。采购批准平台,FinOps 要求降低数据量,安全团队规定保留策略,服务团队才知道哪些罕见事件能解释系统故障,法务或审计人员以后可能提出最初规则里从未出现的问题。Datadog 提供机制并记录其行为;这些材料不能证明某个客户的规则一定安全,也不能证明节省已经扣除了全部成本,更不能证明被删除的事件以后没有证据价值。
正确的对照方案并不是“所有数据永久保存”,而是受治理的选择权。买方可以对受保护类别实行双路发送,把超出配额的数据送到对象存储,在明确期限内保留原始流,或为安全证据维持独立路径。Datadog 的目的地目录包括自家服务、对象存储、Kafka、SIEM、OpenTelemetry 端点以及其他可观测性平台。架构上存在选择权,不等于运营上可以兑现;只有当团队能取回并使用那份副本时,它才是真的。
运维成本也必须纳入计算。Worker 是由客户管理、位于关键数据路径上的软件。Datadog 建议每个小版本和补丁版本都更新,至少每月更新一次。容量、缓冲、部署、配置评审、回滚和在岗支持不会因为索引量下降而消失。OpenTelemetry 的独立 Collector 指南也强调同一个韧性边界:内存队列与由预写日志支撑的持久队列,在重启时提供的生存保证不同。
因此,决策可以被量化。只有当已验证的可变成本节省高于 Worker 运维、变更治理、恢复测试和不可恢复证据的预期代价时,上游控制才创造价值。这个命题可以被证伪:选择有代表性的事故和审计问题,保护相关事件类别,再从保留路径进行限时回放。如果团队能在约定的完整性和恢复时间内重建所需事实,同时节省仍然存在,设计才证明了经济性。否则,较低账单只是把一部分风险转给未来的调查者。
事实、推断和未知必须分开。文档中的处理器确实能够丢弃、采样、限额、去重和分流,这是事实;这些能力把证据裁决权推向上游,是本文的推断。本文没有指控 Datadog 隐瞒损失,也没有指控任何具名客户销毁证据。统一定价、客户实际节省、规则质量、恢复表现,以及特定版本在特定拓扑中的行为,仍然未知。批准决策必须正面处理这些未知。
来源
- https://csrc.nist.gov/pubs/sp/800/92/final
- https://docs.datadoghq.com/observability_pipelines.md
- https://docs.datadoghq.com/observability_pipelines/configuration/install_the_worker.md
- https://docs.datadoghq.com/observability_pipelines/destinations.md
- https://docs.datadoghq.com/observability_pipelines/monitoring_and_troubleshooting/pipeline_usage_metrics.md
- https://docs.datadoghq.com/observability_pipelines/processors/dedupe.md
- https://docs.datadoghq.com/observability_pipelines/processors/filter.md
- https://docs.datadoghq.com/observability_pipelines/processors/quota.md
- https://docs.datadoghq.com/observability_pipelines/processors/sample.md
- https://opentelemetry.io/docs/collector/resiliency/
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance