
摘要
- 按照ThousandEyes的时间线,2025年10月20日09:25 UTC恢复的是DNS信息;新EC2实例启动失败或连接异常的影响则延续至20:50 UTC。这两个节点相隔11小时25分钟,但不能据此声称所有客户连续停机了这么久。
- Dipak Kr das在Medium发表的解析描述了两项后续障碍:DynamoDB恢复后集中涌入的租约重建工作,以及新实例网络状态更新的积压。修复最初的依赖,并不会自动清空恢复过程中累积的工作。
依赖重新可达,不等于依赖它的系统已经恢复
一次云故障可以同时留下两种截然不同的状态:原有计算资源继续运行,但新增或替换资源仍难以交付。对Amazon Web Services(AWS)这次事件的分析,重点就在这条分界线上,而不是把整个区域概括成一个开关。
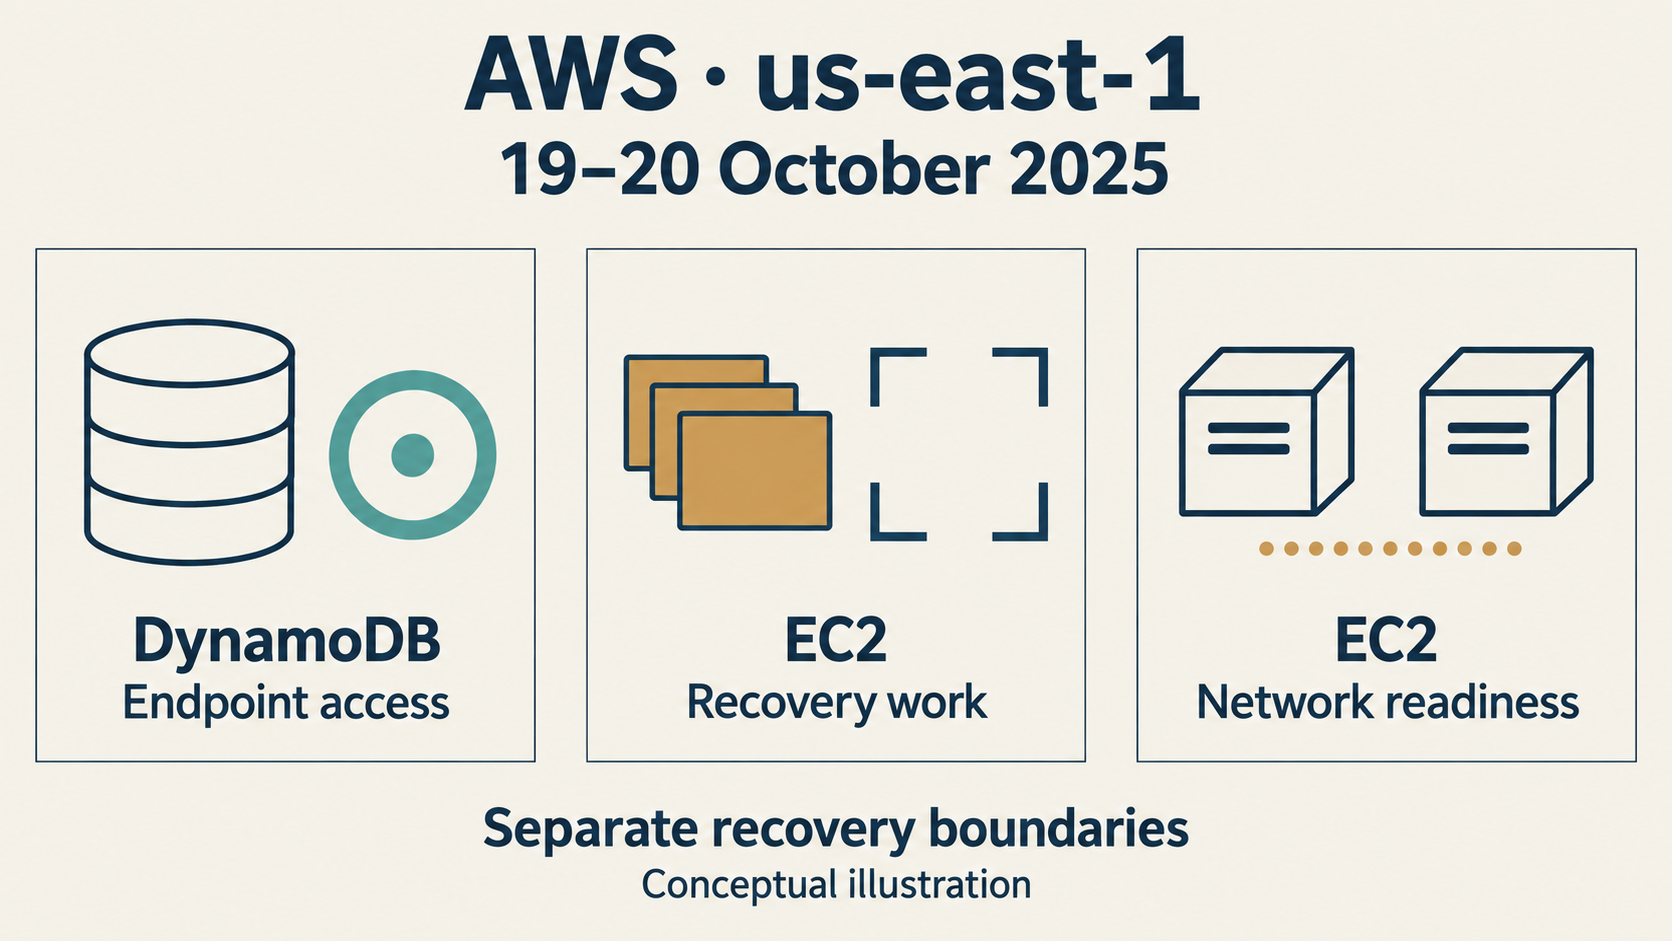
事件发生于2025年10月19日至20日,涉及北弗吉尼亚的us-east-1区域。Dipak Kr das在10月25日发表的技术解析将起点归因于DynamoDB自动化DNS管理中的潜在竞态条件:DynamoDB端点解析失败,随后影响了依赖它的其他系统。这是该作者对故障原因的解释,并非本文根据AWS内部日志作出的独立鉴定,也不是所有AWS区域同时失效的证据。
关键的下游系统之一,是EC2的Droplet Workflow Manager,简称DWFM。ThousandEyes称,DynamoDB不可用期间,DWFM无法完成所需的状态检查,租约管理因而受到干扰。这里的租约指内部有时限的管理关系,不是客户购买EC2服务的商业租赁合同。Medium的解析进一步说明,这些状态检查与承载EC2实例的物理服务器有关。ThousandEyes的分析将数据库访问问题与计算资源管理问题连接起来,但两者并非同一项服务能力。
这个区别决定了恢复为什么不能只看上游。假如一项管理任务在依赖中断时无法完成,依赖返回后,它仍然需要被处理。系统面对的不是故障前平稳的工作流,而可能是需要集中补做的工作。恢复通道本身是否有能力消化这些任务,是另一个问题。
按照Dipak Kr das的描述,DynamoDB返回后,大量租约重建工作涌向DWFM,使其过载,难以继续推进。工程师通过限制进入系统的工作量,并选择性重启DWFM主机来解除拥堵。该解释没有为本文提供可核验的队列长度、重试速率或容量余量,因此不宜把这一机制包装成精确的性能模型。
但即使不补上这些数字,因果关系也已经足够清楚:DynamoDB访问恢复是DWFM恢复工作的前提,不是DWFM已经完成恢复的证明。上述干预针对AWS内部管理系统,也不能被改写成普通EC2客户能够直接执行的操作清单。
三个时间节点,三种不同的含义
ThousandEyes对10月20日的分析给出了下列节点。时间统一使用UTC,以免把时区转换误当成恢复进度的差异。
| 时间 | 报道所描述的状态 | 不能据此推出的结论 |
|---|---|---|
| 09:25 | DNS信息恢复 | 所有客户端当即连接成功,或所有下游服务已经恢复 |
| 09:25至09:40 | 随着缓存记录过期,端点解析和连接陆续成功 | EC2的新容量已经全面可用 |
| 至20:50 | 新EC2实例启动失败或连接异常的影响仍有延续 | 每一次启动都持续失败,或所有应用都在这一刻恢复 |
从09:25到20:50,算术上的间隔是11小时25分钟。这个数字衡量的是两类恢复节点之间的距离,而不是一条统一的停机时长。前一个节点关乎DNS信息;后一个节点把启动失败和连接异常两种影响合在一起描述。它既不是失败率,也不是所有客户遭受同等影响的持续时间。
09:25与09:40也不应被随意互换。DNS信息恢复与客户端在缓存过期后重新连接,可以先后发生。若把前者写成客户全面恢复,就会掩盖缓存与连接这一层;若把后者写成EC2恢复,则又跨过了资源管理与网络配置这两层。
这组时间线最有价值的地方,不是制造一个更长的“宕机数字”,而是提示读者:一个依赖的恢复通知,未必回答了另一个服务何时可以完成客户操作。
启动之后,还有网络交付这道关
即使租约管理开始恢复,新实例也未必立即具备可用网络。Dipak Kr das的解析另行描述了Network Manager传播网络状态时的积压,导致部分新实例缺乏连接能力,或未能通过健康检查。这项网络更新问题与前面的租约重建拥堵应当分开理解。
两者作用于不同的交付条件。租约管理恢复,使资源管理流程能够继续推进;网络状态传播完成,才为实例实际通信提供必要条件。一个启动请求获得结果,不等于实例已经能与所需系统通信,更不等于应用已经完成一次有效业务操作。
这里也没有依据把网络更新积压扩大解释成整个互联网的路由故障。报道支持的是特定云内部恢复链条上的问题。对客户而言,实用的结论是验收对象要足够具体:究竟验证了资源创建,还是验证了这个资源能够工作?
原有实例存活,不是应用可用性的保证书
Gremlin在11月7日发表的可靠性分析区分了故障前已经启动的EC2实例与新实例:前者被其描述为保持健康,后者在DynamoDB问题解决后仍面临启动困难。这一观察为“运行中的计算”和“交付新计算”提供了重要边界。
然而,实例保持运行并不能证明其上的应用端到端可用。应用是否仍能访问必要的依赖,是另一个验收问题;Gremlin对既有实例的概括,不能代替逐个应用的成功交易记录。反过来,新实例启动受阻,也不能被写成所有既有实例都停止了执行。
这一点会影响故障应对的选择。如果一项恢复方案要求先关闭或替换仍在工作的资源,再临时获取新资源,那么新增容量的交付能力就成了该方案必须验证的前提。这是从事件机制得到的条件性风险判断,不是对本次故障中某个客户操作的指认。
这次复盘能说明什么,不能说明什么
上述解释依赖ThousandEyes、Dipak Kr das和Gremlin的二手技术分析。其中,Medium文章是具名作者自行发表的解释,不是AWS的原始事故报告。本文没有对AWS内部日志进行审计,也不把这些分析视为每个客户体验的完整记录。
因此,不能由此推算客户总损失、数据损失情况,或判断后续修复措施今天是否仍有效;也不能宣布所有多可用区或跨区域架构都失去了作用。本文讨论的是2025年的历史事件,不是当前故障告警。
有依据的结论更窄,也更有操作价值:恢复最初的依赖之后,控制系统仍可能面对积压工作,网络配置仍可能尚未就绪。判断恢复是否完成,应当回到客户需要的能力,而不是停在第一个转绿的信号上。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance