
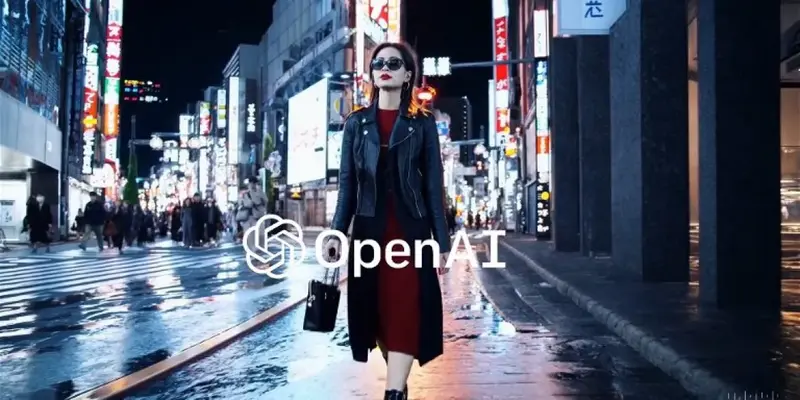
OpenAI представляет поразительную новую генеративную видеомодель Sora, основанную на более ранних исследованиях моделей DALL-E и GPT; Sora способна генерировать до 60 секунд видео по текстовым инструкциям, создавая сцены с несколькими персонажами, определёнными типами действий и детализированным фоном. Sora также может создавать несколько планов в рамках одного сгенерированного видео. Мировой лидер в области моделей искусственного интеллекта OpenAI запустила модель под названием Sora, способную мгновенно создавать короткие видео по текстовым инструкциям.
Ранее в 2023 году, в ходе острой конкуренции между мультимодальными моделями ИИ, похожие модели выпустили такие компании, как Google, Meta, а также стартапы Runway и Pika Labs. Однако продемонстрированные OpenAI видео продолжают привлекать внимание благодаря высокому качеству. Читайте также: OpenAI лечит «лень» GPT-4 с помощью новых обновлений. Sora может взаимодействовать с реальным миром. Сейчас на официальном сайте OpenAI информации о Sora немного.
OpenAI публично описала контекст исходных данных для обучения модели, заявив лишь: «Мы учим ИИ понимать и моделировать физический мир в движении, стремясь создать модели, которые помогают людям решать задачи, требующие взаимодействия с реальным миром». OpenAI утверждает, что Sora может генерировать видео длительностью до 60 секунд по текстовым описаниям, создавая сцены с несколькими персонажами, конкретными типами действий и точными деталями фона. Sora также может создавать несколько планов в одном сгенерированном видео, подчёркивая персонажей и визуальные стили.
Кроме того, Sora может генерировать видео целиком за один раз или продлевать уже сгенерированные видео. OpenAI заявляет: «Заставляя модель генерировать сразу несколько изображений, мы решаем сложную задачу: гарантировать, что объект остаётся согласованным, даже когда он временно исчезает из поля зрения». OpenAI также признаёт, что у нынешней модели Sora есть слабые места. Она может испытывать трудности с точным моделированием физических явлений в сложных сценах и не понимать некоторые конкретные причинно-следственные связи. Например, человек может откусить кусочек печенья, но после укуса на печенье не останется следов.
Модель также может путать пространственные детали, такие как лево и право, и испытывать трудности с точным описанием событий, разворачивающихся во времени, например, при следовании по конкретной траектории камеры. Безопасность не вызывает беспокойства. Что касается проблем безопасности ИИ, которые неоднократно поднимал генеральный директор OpenAI Сэм Альтман, OpenAI заявляет: «В настоящее время Sora предоставлена “редтимерам” — тем, кто проводит “красные командные тесты” на потенциально вредоносных выходах больших моделей ИИ, — для оценки вреда или рисков в критически важных областях.
Мы также предоставляем доступ некоторым художникам-визуалистам, дизайнерам и кинематографистам, чтобы получить обратную связь о том, как улучшить модель и сделать её максимально полезной для творческих профессионалов». OpenAI отмечает, что Sora опирается на более ранние исследования моделей DALL-E и GPT. Она использует техники DALL·E 3, что позволяет ей более точно следовать текстовым инструкциям пользователей в генерируемых видео. Помимо создания видео с нуля, модель может генерировать видео из существующих статичных изображений и точно, детально анимировать содержимое изображений.
Модель также может брать существующие видео и продлевать их или заполнять недостающие кадры. В настоящее время на сайте OpenAI опубликовано 48 демонстрационных видео, сгенерированных Sora, отличающихся яркими цветами и реалистичными эффектами.