
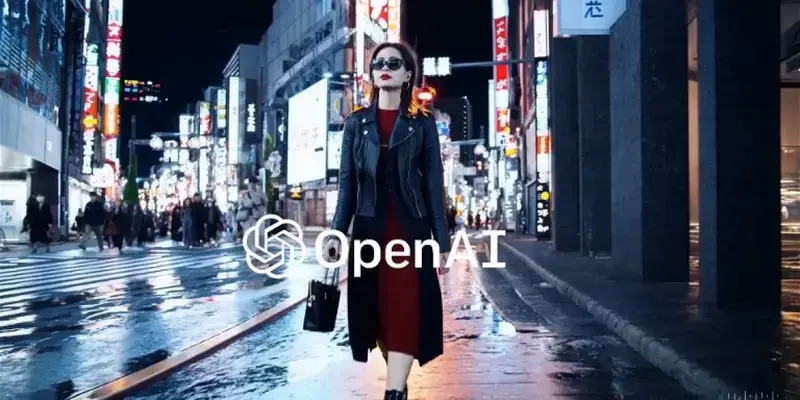
A OpenAI apresenta um impressionante novo modelo de vídeo generativo, o Sora, baseado em pesquisas anteriores sobre os modelos DALL-E e GPT; o Sora é capaz de gerar até 60 segundos de vídeo a partir de instruções textuais, fornecendo cenas com vários personagens, tipos específicos de ações e detalhes de fundo minuciosos; o Sora também pode criar vários planos em um mesmo vídeo gerado. A líder mundial em modelos de inteligência artificial, a OpenAI, lançou um modelo chamado Sora, capaz de gerar instantaneamente vídeos curtos a partir de instruções textuais.
No início de 2023, durante a acirrada competição de modelos de IA multimodais, empresas como Google, Meta e startups como Runway e Pika Labs também publicaram modelos semelhantes. No entanto, os vídeos demonstrados pela OpenAI continuam atraindo atenção devido à sua alta qualidade. Leia também: OpenAI cura a “preguiça” do GPT-4 com novas atualizações. O Sora pode interagir com o mundo real. Atualmente, as informações sobre o Sora são limitadas no site oficial da OpenAI.
A OpenAI documentou publicamente o contexto dos dados de origem para o treinamento do modelo, declarando apenas: “Estamos ensinando a IA a entender e simular o mundo físico em movimento, com o objetivo de treinar modelos que ajudem as pessoas a resolver problemas que exigem interação com o mundo real.” A OpenAI afirma que o Sora pode gerar vídeos de até 60 segundos a partir de descrições textuais, fornecendo cenas com vários personagens, tipos específicos de ações e detalhes de fundo precisos. O Sora também pode criar vários planos dentro de um vídeo gerado, destacando os personagens e os estilos visuais.
Além disso, o Sora pode gerar vídeos inteiros de uma só vez ou estender vídeos gerados para torná-los mais longos. A OpenAI declara: “Ao fazer o modelo gerar várias imagens de uma vez, resolvemos um problema difícil: garantir que o assunto permaneça consistente mesmo quando temporariamente fora de vista.” A OpenAI também reconhece que o modelo Sora atual tem fraquezas. Ele pode ter dificuldade em simular com precisão fenômenos físicos em cenas complexas e pode não entender certas relações causais específicas. Por exemplo, uma pessoa pode dar uma mordida em um biscoito, mas após a mordida, pode não haver nenhuma marca no biscoito.
O modelo também pode confundir detalhes espaciais mencionados, como esquerda e direita, e pode ter dificuldade em descrever com precisão eventos que ocorrem no tempo, como seguir uma trajetória de câmera específica. Sem preocupações com a segurança. Em relação aos problemas de segurança da IA, que o CEO da OpenAI, Sam Altman, tem abordado constantemente, a OpenAI declara: “Atualmente, o Sora foi disponibilizado para ‘red teamers’ (aqueles que realizam ‘testes de equipe vermelha’ em saídas potencialmente prejudiciais de grandes modelos de IA) para avaliar danos ou riscos em áreas críticas.
Também estamos permitindo que alguns artistas visuais, designers e cineastas tenham acesso para coletar feedback sobre como melhorar o modelo, para torná-lo o mais útil possível para profissionais criativos.” A OpenAI indica que o Sora se baseia em pesquisas anteriores sobre os modelos DALL-E e GPT. Ele adota as técnicas do DALL·E 3, o que lhe permite seguir mais fielmente as instruções textuais dos usuários nos vídeos gerados. Além de gerar vídeos do zero, o modelo também pode gerar vídeos a partir de imagens estáticas existentes e animar o conteúdo das imagens com precisão e minúcia.
O modelo também pode extrair vídeos existentes e estender ou preencher as imagens faltantes. Atualmente, o site da OpenAI foi atualizado com 48 vídeos de demonstração gerados pelo Sora, apresentando cores vibrantes e efeitos realistas.