
Resumo
- A localização do servidor inicial era uma escolha operacional, não um filtro implícito sobre a nacionalidade ou a região dos registros.
- O cliente WHOIS++ recebia registros ou
SERVER-TO-ASK, perseguia as referências que escolhesse e mantinha memória própria para não consultar o mesmo servidor duas vezes. - Expandir a malha podia elevar a cobertura possível, mas também o tempo, a rede e cobranças por resposta; um resultado vazio valia apenas para o percurso efetivamente realizado.
O endereço da pergunta não definia seu território
O RFC 1914 recomendava que o cliente começasse por um servidor configurado tão local quanto fosse prático. Proximidade podia reduzir latência e custo. Não dizia, porém, quais registros estariam dentro daquele servidor ou de seus índices. Um serviço norte-americano podia conhecer pessoas na Suécia por ter sondado outro nó.
Se o usuário quisesse restringir a resposta aos Estados Unidos, deveria incluir o país na consulta. O ponto de entrada e o escopo semântico eram campos diferentes. Inferir o segundo a partir do primeiro criaria resultados inesperados e uma explicação falsa sobre o que havia sido pesquisado.
Essa regra é a primeira pista de que a malha não entregava completude como atributo de um servidor. O cliente chegava com uma pergunta explícita, entrava por um lugar escolhido e construía seu alcance ao seguir ou recusar relações. Duas máquinas podiam enviar o mesmo texto, mas obter conjuntos distintos porque começaram em servidores diferentes ou ampliaram a busca de maneiras diferentes.
Uma referência transferia trabalho
A interação básica era breve: abrir conexão, enviar consulta, receber resposta, fechar. A resposta podia conter fichas ou blocos SERVER-TO-ASK. O servidor de índice indicava outro destino possivelmente útil; não prometia que ele estivesse acessível, fosse barato, confiável ou contivesse o registro procurado.
A referência, portanto, era conhecimento de encaminhamento, não resposta. O servidor de base governava seus dados. O índice governava os resumos e as sugestões. O cliente decidia quais sugestões virariam novas conexões e como as respostas seriam reunidas. A coordenação ausente de um centro aparecia como política local do software de consulta.
Quando o primeiro resultado não bastava, o cliente podia perguntar por polled-by e polled-for. Essas relações revelavam outros indexadores; então a consulta original era repetida. A busca aprendia a topologia ao mesmo tempo em que procurava os dados.
Uma malha podia levar de volta ao mesmo lugar
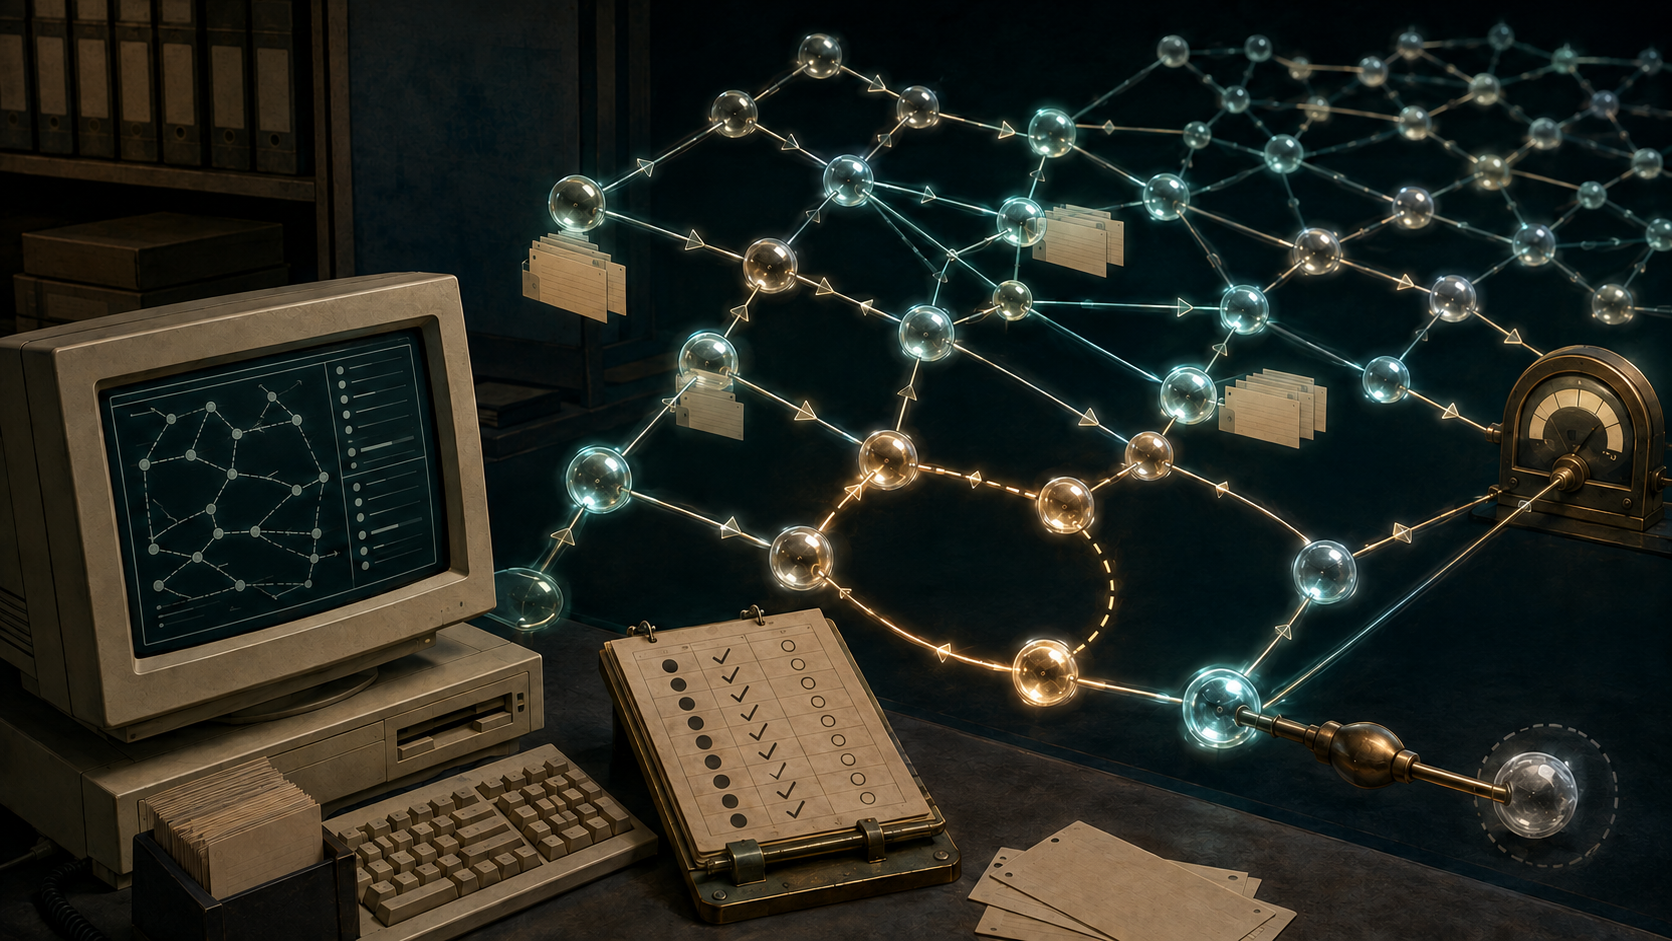
WHOIS++ permitia várias hierarquias. Um servidor de uma filial poderia alimentar tanto uma estrutura nacional quanto o índice global da organização. Atalhos entre entidades também eram possíveis. O desenho resultante era um grafo, não necessariamente uma árvore, e podia conter ciclos.
O RFC colocou toda a detecção e eliminação de ciclos no cliente. O algoritmo ilustrativo separava OriginalServers, ServerList, QueriedServers e AnswerList. Antes de enviar uma consulta, verificava se o destino já fora visitado. Nenhum nó isolado conhecia todo o caminho; a memória que estabilizava a pesquisa viajava com o cliente.
Essas listas são objetos de prova. Uma referência recebida não é um servidor selecionado. Um servidor selecionado não é uma conexão bem-sucedida. Uma conexão não é uma resposta, e uma resposta não é necessariamente um registro mostrado ao usuário. Guardar apenas a lista final apaga as exclusões, duplicações, falhas e ramos nunca descobertos.
Mais alcance podia produzir uma conta maior
O documento advertiu que a expansão automática e cega poderia fazer o consumo de recursos crescer exponencialmente. Partes da malha considerada cobravam por respostas. A decisão de seguir mais ligações podia aumentar simultaneamente a chance de encontrar algo e uma fatura real.
Por isso o RFC 1914 não recomendou expansão automática sem controle. Clientes sofisticados deveriam permitir cortes ou listas de bloqueio, inclusive para evitar servidores caros. O usuário precisava poder interromper uma transação longa. O botão de parar definia o limite da evidência, não apenas o conforto da interface.
Uma busca rápida poderia parecer eficiente porque abandonou ramos lentos. Uma busca ampla poderia parecer defeituosa por continuar esperando. Sem informar quantidade de pedidos, profundidade, tempo, bytes, tarifas, tentativas e motivo do encerramento, comparar desempenho ou completude seria comparar políticas ocultas.
O diretório de servidores também precisava ser conhecido
O Directory of Servers era um serviço WHOIS++ especial. Seus registros ligavam um identificador de servidor relativamente estável ao host e à porta então conhecidos, além de descrições que ajudavam a escolher um ponto inicial. Mas o próprio host e a porta desse diretório precisavam estar pré-configurados.
Não havia, portanto, uma raiz universal que eliminasse o bootstrap. Havia uma ferramenta de navegação cuja entrada ainda dependia de configuração. O texto recomendava apresentar as opções ao usuário, em vez de fazer a escolha automaticamente, porque o melhor começo dependia da consulta e da situação operacional.
O identificador estável também ajudava quando uma referência envelhecia. Host ou IP copiado durante uma sondagem poderia estar semanas desatualizado. Se a conexão falhasse, o cliente consultaria o identificador para obter o último host conhecido. “Último conhecido” não significava “vivo agora”; menos ainda provava que os dados continuavam iguais. A tentativa antiga, a resolução pelo identificador e a nova tentativa eram eventos independentes.
O centroid só anunciava possibilidade
O RFC 1913 descreveu como um índice podia saber para onde apontar sem copiar a base inteira. Um centroid reunia nomes de modelos e atributos, além de uma lista sem duplicatas das palavras que haviam aparecido em algum registro. O índice consultava esse resumo e escolhia servidores com uma correspondência possível.
A compressão impunha um teto à afirmação. A presença de uma palavra não revelava o registro que a continha, não garantia que dois termos aparecessem juntos, não demonstrava atualidade nem confirmava a veracidade do campo original. O centroid justificava uma tentativa. Só o servidor de base podia devolver o registro.
O RFC 1835 também separou a manutenção distribuída dos dados básicos do serviço usado para localizá-los. Seu modelo de consulta e sua estrutura de autenticação não criavam uma autoridade universal sobre todas as identidades ou todos os fatos da malha.
Recusar um servidor não autenticava os demais
O RFC 1914 considerou que um servidor WHOIS++ falso poderia ser introduzido e sugeriu uma lista de bloqueio mantida pelo cliente. Era um instrumento local de recusa. A ausência nessa lista não equivalia a aprovação, e a confiança passada não garantia integridade presente.
Cada camada afirmava algo mais estreito: o índice oferecia uma referência; o Directory of Servers oferecia um endereço registrado; DNS resolvia um nome naquele momento; a rede oferecia ou negava alcance; o servidor remoto respondia com sua própria política. O cliente compunha as evidências e aplicava sua regra. Nenhum recibo sozinho autenticava o conjunto.
O CIP preservou a responsabilidade como liberdade de escolha
O RFC 2651, de 1999, generalizou a arquitetura no Common Indexing Protocol. Reconheceu que o cliente parecia receber o trabalho difícil, mas tratou esse encargo também como controle sobre a velocidade, a profundidade e o tamanho do conjunto de resultados. Rejeitou uma raiz única por razões de escala, conservou o tratamento de ciclos e manteve a relevância do ponto de entrada.
Essa continuidade arquitetural não prova adoção universal do WHOIS++. Tampouco os cenários TISDAG registrados no RFC 2968 demonstram cobertura global. Publicado em fevereiro de 1996, o RFC 1914 hoje é Historic e o grupo WNILS foi encerrado, mas esses estados administrativos não fornecem uma data exata de retirada nem uma curva de implantação.
O que os documentos sustentam é mais preciso: retirar a raiz obrigatória não retirou a coordenação. Ela foi deslocada para a política de percurso do cliente, com seus benefícios, custos e lacunas.
Toda ausência precisava de um mapa percorrido
Para defender “não encontrado”, seria preciso guardar a consulta original e suas restrições, o servidor inicial, cada SERVER-TO-ASK, as relações de sondagem, a versão do centroid, o identificador e o destino anunciado, a idade do cache, DNS, tentativas, respostas, conjunto de visitados, bloqueios, orçamento e decisão de parar.
Sem esse recibo, zero pode querer dizer que o primeiro servidor não tinha o registro; que o índice não continha a palavra; que o destino estava antigo ou indisponível; que um ramo caro foi excluído; que um ciclo foi suprimido; que o usuário cancelou; ou que o alcance acessível foi realmente percorrido. A malha não tinha uma raiz obrigatória. A completude ainda precisava de um responsável capaz de explicar o caminho.
Fontes
- Registro informativo do RFC Editor para o RFC 1914
- RFC 1914 — How to Interact with a Whois++ Mesh
- Registro informativo do RFC Editor para o RFC 1913
- RFC 1913 — Architecture of the Whois++ Index Service
- Registro informativo do RFC Editor para o RFC 1835
- RFC 1835 — Architecture of the WHOIS++ service
- Registro informativo do RFC Editor para o RFC 2651
- RFC 2651 — The Architecture of the Common Indexing Protocol
- Registro informativo do RFC Editor para o RFC 2968
- RFC 2968 — Mesh of Multiple DAG servers: Results from TISDAG
- IETF Datatracker — documentos do grupo WNILS encerrado
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance