요약
- 상태 검사가 각각 연결된 주·보조 장애 조치 레코드가 모두 비정상이면 Route 53은 주 레코드를 반환한다.
- AWS는 잘못된 검사와 연쇄 과부하 속에서도 연결 기회를 남기려 한다. 그 주소에서 어떤 업무를 계속 받아들일지는 이용 기업의 몫이다.
예비 서버가 사 주지 않는 결정
서버를 하나 더 마련하면 견적서는 길어진다. 책임 소재까지 또렷해지는 것은 별개의 일이다. 주 서버가 고장 나고 예비 서버도 쓸 수 없다고 판정될 때, 고객에게 어느 주소를 알려 줄지부터 결정해야 한다.
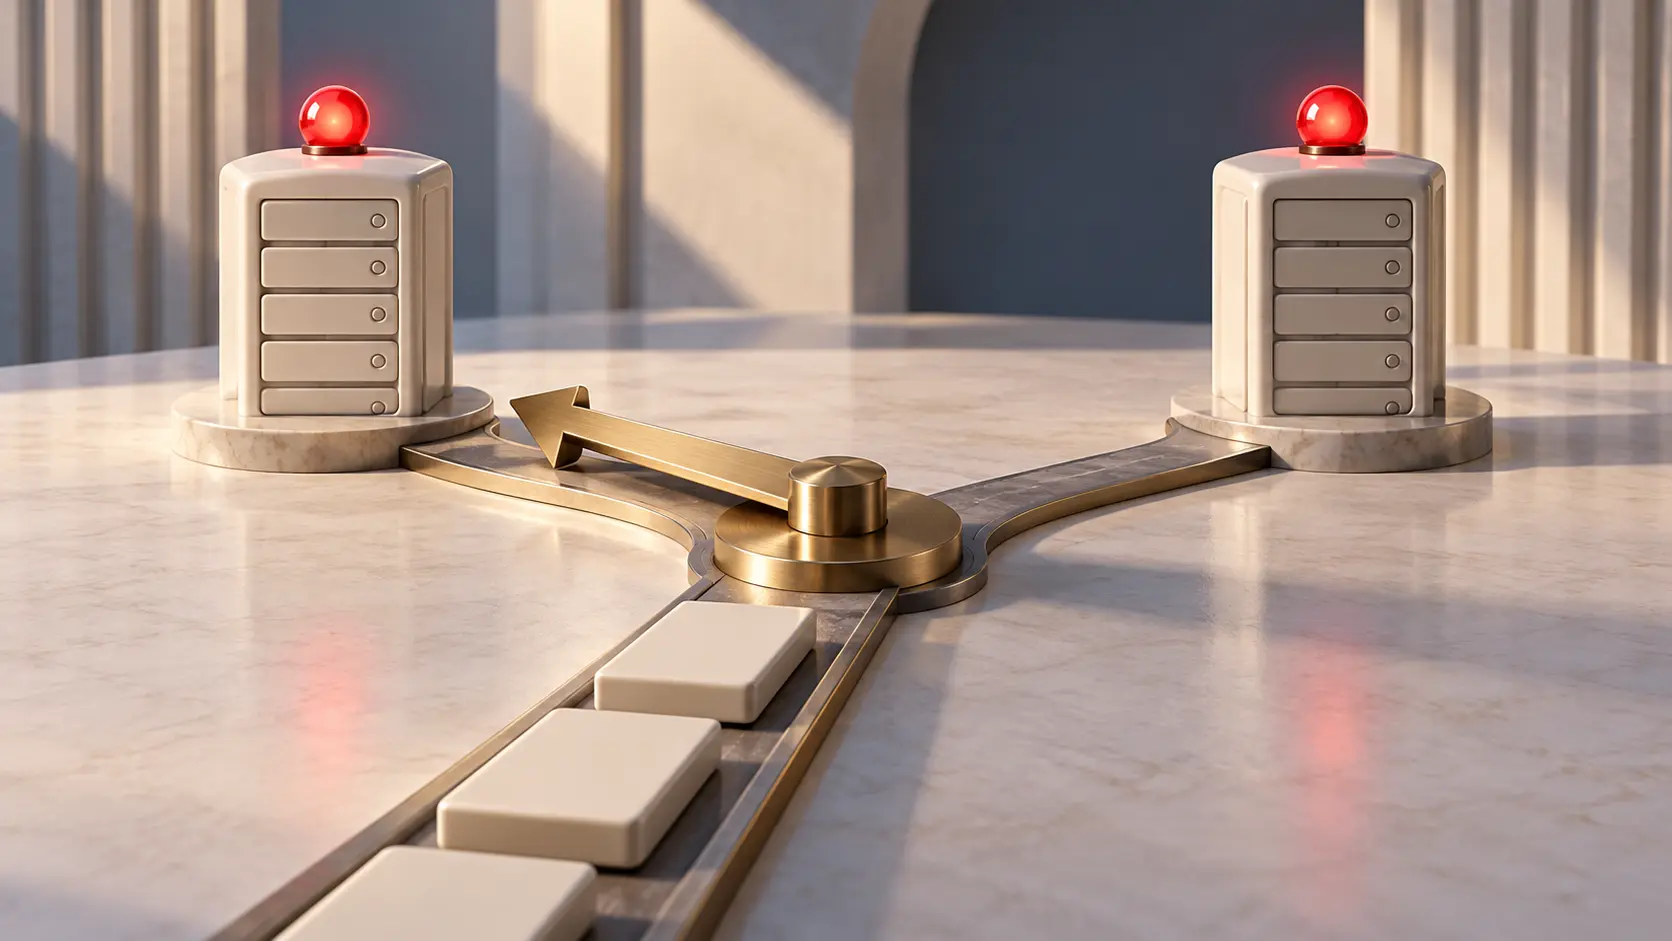
Amazon Route 53은 이미 답을 적어 놓았다. 주 레코드와 보조 레코드 양쪽에 상태 검사가 연결된 장애 조치 구성에서, 주 레코드가 정상이면 주 레코드를 반환한다. 주 레코드가 비정상이고 보조 레코드가 정상이면 보조 레코드다. 둘 다 비정상이면 다시 주 레코드다. 레코드 선택 규칙
이때 돌아오는 것은 DNS 응답에 담긴 주소다. 주 서버의 상태 판정이 정상으로 바뀌는 절차가 아니다. 실제 애플리케이션이 요청을 끝낼 수 있는지는 그다음 문제다. 양쪽의 빨간불을 보고 모든 접근이 자동으로 차단될 것이라 기대했다면, 구매자가 예상한 문지기와 제품이 제공하는 안내원의 직무가 어긋난다.
이 차이는 사소한 설정 이야기를 넘어선다. 기업이 비상시에 무엇을 계속 팔고, 무엇을 잠시 중단할지에 관한 결정이 DNS의 기본 선택 뒤에 숨어 있을 수 있기 때문이다.
AWS가 마지막 주소를 남기는 이유
AWS는 상태 검사가 잘못 설정돼도 애플리케이션은 이용자에게 정상적으로 서비스를 제공할 수 있다고 설명한다. 이때 모든 목적지를 제외하면 관측의 오류가 실제 접근 중단을 만든다. 마지막 응답을 유지하면 성공할 수 있었던 요청에 기회가 남는다. 장애 조치 문제 설명
공식 문서의 과부하 예도 같은 논리다. 세 목적지 가운데 하나를 제외하면서 나머지 둘의 부담이 늘고, 그 둘마저 검사에 실패할 수 있다. 모두를 제외한 상태를 유지하기보다 다시 세 곳에 분산하는 편이 나을 수 있다는 설명이다. 특정 고객의 장애 측정 결과가 아니라 설계의 이유를 보여 주는 예다.
검사 도구도 틀릴 수 있다는 사실을 인정한 판단이다. 관측 시스템에 무조건적인 폐쇄 권한을 주면, 그 시스템이 오히려 가용성을 무너뜨릴 수 있다. 주소를 남겨 두는 정책에는 충분한 실용적 근거가 있다.
다만 이용 기업이 사고파는 것은 주소 자체가 아니다. 독자가 자료를 다시 열어 보는 시도와, 고객이 되돌리기 어려운 거래를 확정하는 시도는 실패 비용이 다르다. 접속 기회를 남기는 것이 좋은 선택인 업무도 있고, 일부 동작을 애플리케이션에서 멈추는 편이 나은 업무도 있다. 그 경계를 예비 서버의 존재만으로 결정할 수는 없다.
상태 검사의 이력서부터 읽어야 한다
Route 53의 엔드포인트 검사는 프로토콜, 주기, 연속 실패 기준 등을 설정해 사용한다. 실패가 정해진 횟수에 도달하면 비정상으로 판단하고, 그 전에 성공하면 실패 횟수를 초기화한다. CloudWatch와 SNS를 통한 알림도 설정할 수 있다. 알림과 레코드 선택은 각각의 역할을 수행한다. 상태 검사 작동 방식
검사 주기는 10초 또는 30초이며 검사기들은 독립적으로 동작한다. DNS 질문이 들어올 때마다 해당 이용자를 대신해 업무 전체를 새로 시험하는 구조가 아니다. 정기적으로 모은 관측을 주소 선택에 활용한다. 정상 여부 판단 조건
HTTP나 HTTPS 검사에서 정해진 연결과 응답 조건을 만족하는 일은 유용한 증거다. 장바구니, 재고 확인, 승인, 결과 저장까지 끝났다는 증거는 따로 필요하다. AWS 문서에는 HTTPS 상태 검사가 SSL/TLS 인증서를 검증하지 않는다는 설명도 있다. ‘정상’이라는 단어가 덮는 범위는 실제 시험 항목만큼이다.
보조 레코드의 검사를 생략했을 때도 의미가 달라진다. 검사가 없는 레코드는 정상으로 간주된다. 주 레코드가 비정상이면 보조 서버의 실제 상태에 문제가 있어도 그 보조 레코드를 반환할 수 있다. 관측하지 않는다고 설비가 튼튼해지지는 않는다. 선택 과정에서 탈락시킬 근거가 사라질 뿐이다.
구매 기업은 그래서 세 가지를 따로 계산해야 한다. 추가 처리 용량, 고장을 알아볼 능력, 성능이 떨어진 상태에서도 올바른 업무 결과를 낼 능력이다. 두 주소가 같은 필수 후방 시스템을 바라본다면, 주소 두 개의 비용을 냈어도 독립적인 업무 수행 조건은 하나일 수 있다.
두 번째 빨간불까지 검수하기
주 서버를 끄고 보조 서버가 받는 장면은 장애 조치의 한 칸이다. 양쪽 검사 모두 비정상인 칸도 통제된 시험에 포함해야 한다. 그때 검사 상태, 실제 DNS 응답, 애플리케이션이 허용한 동작을 함께 기록한다. 세 기록을 맞춰야 마지막 주소가 업무상 어떤 결과를 만들었는지 알 수 있다.
콘솔은 해당 검사의 상태와 최근 실패 이유, 검사기 IP 주소, 시각 등을 제공한다. 계산된 상태 검사에는 표시 항목의 예외가 있다. 상태 확인 방법
관측 위치도 빼놓을 수 없다. AWS는 네트워크 분할이 생기면 Route 53의 위치별 상태 판단이 달라지고 CloudWatch에 표시되는 판단과도 다를 수 있다고 설명한다. 중앙 화면 한 장으로 모든 이용자가 받은 답을 대신하면 분석의 빈칸이 커진다.
공식 문서는 특정 고객이 양쪽 비정상 상태에서 얼마나 많은 업무를 성공시켰는지 제공하지 않는다. 실제 사건을 평가하려면 같은 시간대의 DNS 응답과 애플리케이션 결과가 필요하다.
현재 문서만으로도 구매자에게 던질 질문은 분명하다. AWS는 마지막 주소를 정했다. 그 주소에서 계속 받아도 되는 약속을 누가 정하는가. 예비 서버를 구매한 부서와 고객에게 약속하는 부서가 이 질문을 함께 받아야 한다.
회원 브리핑
프로필 심층 컨텍스트
올바른 멤버십 등급으로 로그인하면 전체 브리핑과 출처 노트를 볼 수 있습니다.
전략 서클 전용
Strategic Circle
모든 독자에게 공개됩니다. 가입 후 로그인하면 프로필 브리핑를 열람할 수 있습니다.
Strategic Circle 가입하기Leadership Alliance 전용
Leadership Alliance
자격을 갖춘 IP 자산 소유자 및 운영진을 위한 콘텐츠입니다. 로그인하면 Leadership Alliance 브리핑을 열람할 수 있습니다.
Leadership Alliance 가입하기