Zusammenfassung
- Sind beim Failover sowohl der primäre als auch der sekundäre Datensatz mit einer Zustandsprüfung verbunden und beide ungesund, gibt Route 53 den primären Datensatz zurück.
- AWS hält damit eine Verbindungschance offen, wenn Prüfungen falsch liegen oder Überlastung weitere Ziele ausschließt. Die Entscheidung über zulässige Geschäftsvorgänge bleibt beim Kunden.
Eine Adresse besteht keine Nachprüfung
Auf dem Papier hat das Unternehmen alles doppelt: einen Hauptstandort, einen Ersatzstandort und für beide eine Zustandsprüfung. Nun melden beide Prüfungen einen Fehler. Wer erwartet, dass der Auskunftsschalter deshalb schließt, sollte die Auswahlregel von Route 53 lesen.
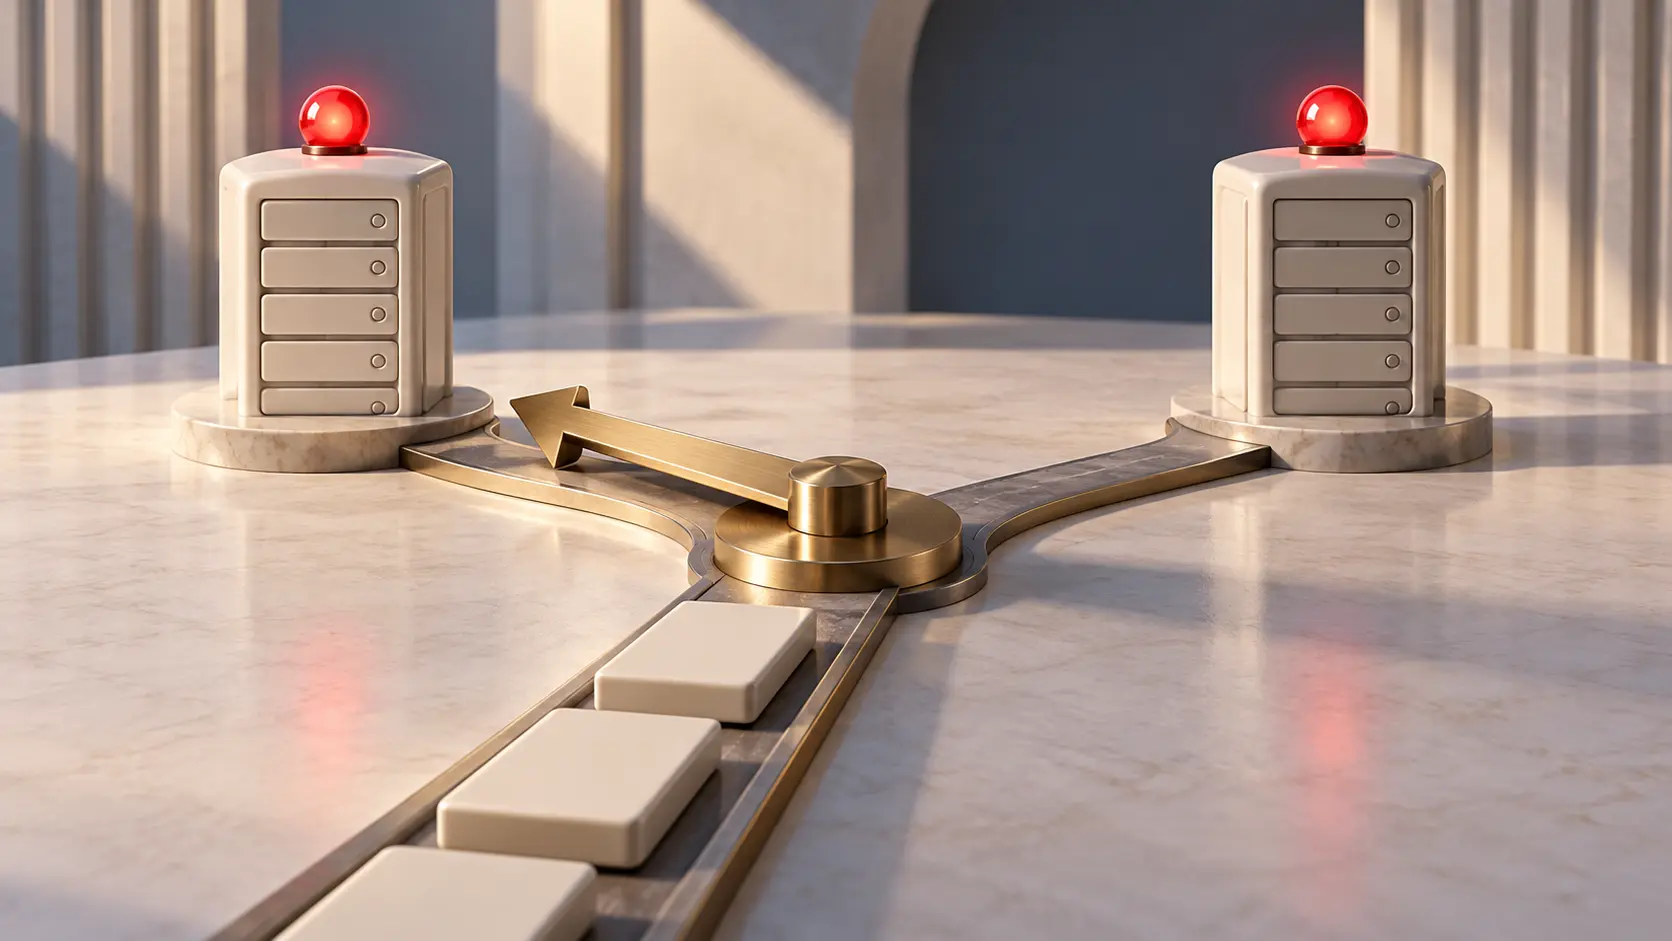
Für zwei entsprechend geprüfte Failover-Datensätze ist die Reihenfolge eindeutig. Ein gesunder primärer Eintrag wird ausgegeben. Ist er ungesund und der sekundäre gesund, folgt der sekundäre. Sind beide ungesund, folgt wieder der primäre. Das Hauptsystem erhält seine Adresse zurück auf die Gästeliste, ohne einen neuen Gesundheitstest bestanden zu haben. Auswahl der Datensätze
Es geht um die DNS-Antwort. Der Gesundheitszustand wird dadurch nicht umbenannt; die Anwendung hinter der Adresse muss eine ankommende Anfrage weiterhin selbst bewältigen. In dieser Trennung steckt der wirtschaftliche Punkt. Ein Dienst, der einen erreichbaren Versuch ermöglicht, entscheidet noch nicht, welche Zusage das Unternehmen seinem Kunden geben darf.
Der Name Failover lässt die letzte Entscheidung leicht verschwinden. Man stellt sich einen Übergang von krank zu gesund vor. AWS hat auch den Fall beschrieben, in dem die Beobachtung keinen gesunden Kandidaten übrig lässt. Dann gilt eine andere Priorität: lieber noch eine Antwort als gar kein Ziel.
Warum diese Wahl vernünftig sein kann
AWS begründet den Rückgriff mit fehlbaren Prüfungen. Ein falsch konfigurierter Check kann eine Anwendung ablehnen, die Nutzern weiterhin dient. Würden daraufhin sämtliche Antworten verschwinden, könnte das Messinstrument den Ausfall erst herbeiführen. Eine verbleibende Adresse bewahrt die Chance auf einen erfolgreichen Zugriff. Erläuterung zu Failover-Problemen
Die Dokumentation nennt außerdem eine Überlastungskette. Von drei Zielen scheidet eines aus. Die beiden übrigen bekommen mehr Arbeit und fallen ebenfalls durch die Prüfung. Wieder auf alle drei zu verteilen kann dann mehr Möglichkeiten lassen, als alle ausgeschlossen zu halten. Das ist das offizielle Erklärungsbeispiel, kein hier gemessener Kundenvorfall.
Ein Prüfer ist ein Beobachter mit einem Auftrag und einer Fehlerquote. Ihm die uneingeschränkte Macht zu geben, sämtliche Wege zu sperren, macht das Unternehmen zusätzlich von seiner Genauigkeit abhängig. Der letzte Versuch kann tatsächlich etwas retten.
Welchen Wert dieser Versuch hat, hängt vom Geschäft ab. Ein weiterer Abruf einer Informationsseite und die endgültige Bestätigung eines schwer rückgängig zu machenden Vorgangs haben unterschiedliche Folgen. Die Anwendung kann dafür unterschiedliche Befugnisse brauchen. Diese muss jemand festlegen, der den Vorgang kennt; eine weitere DNS-Adresse bringt dieses Wissen nicht mit.
Das Ersatzsystem kauft Kapazität und eine alternative Route. Die Frage, was bei zweifelhaftem Zustand noch abgewickelt werden darf, gehört zusätzlich in die Betriebsentscheidung. Auf der Rechnung fehlt dafür meist eine eigene Zeile.
Die Prüfbescheinigung ist kleiner als ihr Name
Bei Endpunktprüfungen bestimmt der Kunde unter anderem Protokoll, Intervall und Fehlerschwelle. Erst die entsprechende Zahl aufeinanderfolgender Fehlschläge führt zum ungesunden Zustand. Ein Erfolg vor Erreichen der Schwelle setzt den Fehlerzähler zurück. Meldungen über CloudWatch und SNS können die Beobachtung weitergeben. Die Auswahl von Datensätzen folgt ihrer eigenen Logik. Arbeitsweise der Zustandsprüfungen
Die Endpunktprüfungen laufen in Intervallen von zehn oder dreißig Sekunden, ihre Prüfer arbeiten unabhängig. Eine eingehende DNS-Abfrage löst keine vollständige neue Prüfung des Geschäftsprozesses aus. Der Dienst nutzt regelmäßig erhobene Beobachtungen. Kriterien für den Gesundheitszustand
Eine HTTP- oder HTTPS-Antwort kann die Prüfbedingungen erfüllen, während für den vollständigen Vorgang weitere Voraussetzungen nötig sind. Laut AWS validieren die HTTPS-Prüfungen auch keine SSL/TLS-Zertifikate. Das Etikett gesund beschreibt die absolvierte Prüfung, nicht jeden Schritt, den ein Kunde anschließend ausführen möchte.
Beim Ersatzdatensatz lohnt ein zweiter Blick. Ein Datensatz ohne Prüfung gilt als gesund. Hat nur der primäre eine Prüfung und wird ungesund, kann Route 53 den sekundären ausgeben, selbst wenn dessen Ziel tatsächlich Probleme hat. Weniger Beobachtung bedeutet hier weniger Ausschlussgründe, nicht mehr Leistungsfähigkeit.
Für den Einkauf entstehen somit drei getrennte Aufgaben: zusätzliche Ressourcen bereitstellen, ihren Zustand sinnvoll beobachten und im eingeschränkten Betrieb korrekte Ergebnisse liefern. Zwei Zugänge, die dieselbe unverzichtbare Abhängigkeit benötigen, können bei der dritten Aufgabe gemeinsam scheitern. Die Stückzahl der Adressen ist dafür eine wenig ergiebige Kennzahl.
Die Abnahme braucht das zweite Rot
Ein Test mit ausgefallenem Hauptsystem und gesundem Ersatzsystem zeigt einen wichtigen Übergang. Er sollte eine zweite Szene bekommen: Beide zugeordneten Prüfungen melden ungesund. In einem kontrollierten Test lässt sich dann erfassen, was die Prüfer melden, welche DNS-Antworten eintreffen und welche Handlungen die Anwendung abschließt.
Die Konsole stellt für entsprechende Prüfungen Informationen wie Zustand, letzten Fehlergrund, Prüferadresse und Zeitpunkt bereit; für berechnete Prüfungen gelten Ausnahmen. Diese Daten helfen bei der zeitlichen Zuordnung. Zustand in der Konsole ansehen
Auch der Beobachtungsort gehört ins Protokoll. AWS erläutert, dass eine Netzpartition unterschiedliche Gesundheitsbilder an verschiedenen Route-53-Standorten erzeugen kann, auch abweichend von CloudWatch. Eine zentrale Bildschirmaufnahme ersetzt daher keine Aufzeichnung der tatsächlich empfangenen Antworten.
Die offiziellen Unterlagen nennen keine Erfolgsquote eines bestimmten Kunden in diesem Doppelzustand; für einen konkreten Vorfall wären gleichzeitige DNS-Antworten und Anwendungsergebnisse erforderlich.
Der Käufer braucht trotzdem nicht auf einen Vorfall zu warten. Die dokumentierte Regel reicht aus, um die Abnahme zu ergänzen und Zuständigkeiten zu klären. AWS bestimmt die letzte Adresse. Das Unternehmen bestimmt, welche Versprechen dort noch angenommen werden. Erst beides zusammen ergibt einen brauchbaren Notbetrieb.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für den Strategischen Kreis
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten