
Résumé
Meta a publié la recherche et les points de contrôle de la première version de V-JEPA le 15 février 2024. L’objectif prédisait des caractéristiques latentes cachées à partir du contexte visible, sans texte, annotation humaine, encodeur d’image préentraîné, exemples négatifs ni reconstruction des pixels.
Les évaluations gelaient l’encodeur de représentation, mais entraînaient des sondes légères propres à chaque tâche. Les scores restaient donc liés au point de contrôle, aux données, à la résolution, à l’échantillonnage, à la sonde et au protocole exacts.
L’artefact initial n’était ni un générateur vidéo, ni un système de légendage, ni un planificateur autonome, ni un produit. Les capacités linguistiques et robotiques de V-JEPA 2 appartiennent à une publication ultérieure et ne peuvent pas être projetées en arrière.
Les conditions non commerciales, la provenance d’environ deux millions de vidéos publiques et la responsabilité liée aux vidéos privées demeuraient des portes distinctes. Une adoption exigeait une réception qui fixe artefact, licence, données, sonde, tests locaux et autorité humaine.
La date fixe le périmètre technique
Le 15 février 2024 n’est pas un simple repère éditorial. Il identifie la première famille de points de contrôle V-JEPA et son objectif de représentation. Des travaux ultérieurs ont porté un nom voisin tout en ajoutant d’autres données, objectifs et évaluations. Les regrouper ferait attribuer à l’artefact initial des capacités qu’il ne possédait pas.
La formulation la plus fidèle est donc précise : la recherche montrait qu’une prédiction de caractéristiques masquées pouvait soutenir des représentations vidéo utiles. Elle ne démontrait pas une compréhension complète du monde, une explication causale ou une capacité générale à choisir une action.
La cible se trouvait dans l’espace des caractéristiques
V-JEPA séparait une vidéo en contexte visible et régions cibles masquées. Un chemin encodait le contexte, puis un prédicteur estimait la représentation de la cible. La comparaison portait sur des caractéristiques latentes. Le système n’avait pas besoin de redessiner les images absentes ni de reproduire chaque détail lumineux ou textural.
Ce choix pouvait détourner l’apprentissage de détails imprévisibles qui intéressent peu une tâche aval. Il ne prouvait toutefois pas que la représentation capturait une physique complète. Une corrélation de mouvement, de cadrage ou d’arrière-plan pouvait rester utile à une sonde sans correspondre au concept que l’utilisateur croyait mesurer.
La politique de masquage faisait partie de l’artefact. Modifier les zones cachées, la durée des clips ou la préparation des images changeait le problème appris. Une reproduction sérieuse devait donc conserver le masquage, l’échantillonnage et le prétraitement avec le hash du point de contrôle.
Prédire une caractéristique ne génère pas une vidéo
Le mot prédiction peut suggérer une image future visible. Ici, la sortie d’apprentissage était une représentation numérique. Elle n’était ni un cadre reconstruit, ni une légende, ni une probabilité directement exploitable. La qualité devait être examinée au moyen de tâches définies, et non par la seule inspection d’une vidéo générée.
Toute visualisation de l’espace latent aurait ajouté un décodeur ou une procédure d’interprétation. Cet outil auxiliaire aurait eu ses propres données et erreurs. Il ne faudrait pas présenter son rendu comme la sortie brute de V-JEPA, pas plus qu’un graphique de diagnostic ne constitue le phénomène mesuré.
L’apprentissage autosupervisé ne s’auto-valide pas
Meta indiquait que le préentraînement n’utilisait ni texte, ni étiquettes humaines, ni encodeur d’image préentraîné, ni exemples négatifs, ni reconstruction pixel par pixel. Cette isolation rendait l’expérience lisible : elle testait directement la capacité de l’objectif vidéo à produire des représentations réutilisables.
Elle ne supprimait pas les décisions humaines. Les chercheurs choisissaient l’architecture, les masques, les jeux de données, l’optimisation, le calcul et les évaluations. Autosupervisé décrit l’origine de la cible d’apprentissage ; il ne signifie pas que le modèle vérifie la qualité, la légalité ou la représentativité de ses propres observations.
Deux millions de vidéos publiques n’effacent pas la provenance
Le mélange d’entraînement comptait environ deux millions de vidéos provenant de jeux publics. Cette échelle élargissait les motifs observables, mais le terme public n’était pas une autorisation universelle. Chaque source conservait son contexte de collecte, ses conditions, ses personnes filmées et ses limites géographiques.
Une vidéo téléchargeable peut contenir des visages, des lieux ou des activités dont l’usage secondaire exige une analyse. La permission technique d’accéder à un fichier ne résout ni le consentement, ni la finalité, ni la durée de conservation. Ces questions deviennent encore plus directes avec des vidéos privées.
Un encodeur gelé utilise encore une sonde entraînée
Les évaluations conservaient les paramètres du backbone tout en entraînant une sonde légère propre à une tâche. Cette méthode vérifie si l’information est accessible sans réajuster l’encodeur. Elle ne signifie pas que le système complet fonctionne sans labels, entraînement aval ou adaptation à un vocabulaire défini.
La sonde possède sa propre architecture, son jeu d’apprentissage, sa graine, son optimisation et son seuil. Chacun peut modifier le résultat. Une phrase sur des caractéristiques gelées doit donc nommer la sonde et confirmer quels paramètres ont changé. Sinon, elle masque l’étape qui transforme un vecteur en classe.
Légère ne veut pas dire sûre. Une petite tête de classification peut être surconfiante, instable ou inégale entre groupes. Son autorité dépend de tests locaux, d’une possibilité d’abstention et de la gravité de l’usage, pas de sa taille relative.
Les scores appartiennent à une configuration
Les résultats publiés dépendaient du point de contrôle, du jeu de données, de la résolution, de la sélection des clips, du prétraitement, de la sonde et des vues d’évaluation. Retirer ces paramètres transforme une mesure reproductible en réputation de famille. Le dénominateur et le protocole doivent accompagner chaque chiffre.
Une résolution différente peut révéler ou supprimer un détail. Un échantillonnage différent change les moments observés. Une sonde et un jeu étiqueté différents changent la définition de la tâche. Ces facteurs appartiennent au système mesuré, même si le backbone reste byte pour byte identique.
Une représentation n’est ni explication ni autorité
Un embedding peut conserver de l’information utile sans expliquer pourquoi une sonde choisit une étiquette. Il n’est pas une justification en langage naturel ni une preuve causale. Des outils de voisinage ou de visualisation peuvent aider l’analyse, mais dépendent encore de références et de métriques choisies.
L’autorité doit être écrite. Une sonde peut aider à rechercher ou prioriser des clips sans décider seule d’un accès, d’une sanction ou d’une mesure de sécurité. Le système doit préciser qui confirme, qui corrige et quelle preuve est conservée.
La licence non commerciale est une porte autonome
Meta présentait l’artefact initial sous des conditions Creative Commons non commerciales. Un téléchargement de recherche n’autorise pas tout usage commercial. L’équipe doit fixer le fichier, la révision du dépôt et le texte de licence exacts avant d’évaluer une redistribution, un service hébergé ou un produit interne.
La licence et la performance sont deux décisions différentes. Un modèle peut réussir un test tout en restant juridiquement inadapté, ou être autorisé à des fins de recherche sans être fiable. Les accords sur les données privées, la sonde et les composants ajoutés créent encore d’autres surfaces.
Les conditions publiées plus tard pour V-JEPA 2 ne requalifient pas V-JEPA 1. La chronologie et la lignée des fichiers gouvernent. Choisir une annonce ultérieure tout en utilisant un ancien point de contrôle briserait la traçabilité.
V-JEPA 2 ne doit pas être rétroprojeté
Les travaux ultérieurs ont exploré des capacités linguistiques et une planification robotique conditionnée par l’action. Ils utilisaient d’autres artefacts, données, objectifs et évaluations. Leur intérêt ne change pas la nature de la première version. En février 2024, la planification était une direction future.
La même règle exclut le légendage et le dialogue. Le premier encodeur ne répondait pas à des questions en langage naturel. Un modèle de langage ou un adaptateur ajouté pourrait inventer des détails ou mal aligner une représentation avec des mots. La preuve initiale ne couvre pas ce risque.
Les vidéos privées ajoutent une chaîne de contrôle
Avant l’encodage, une organisation doit définir la source légitime, la finalité, l’accès et la conservation des clips. Elle doit réduire les images inutiles et traiter les identifiants. V-JEPA ne fournit aucun de ces contrôles ; ils appartiennent au responsable du traitement.
La sonde doit disposer de seuils calibrés, d’une classe d’abstention et d’une file de revue. Les opérateurs doivent voir un contexte suffisant, pouvoir rejeter la suggestion et corriger le dossier. Une étape humaine sans pouvoir réel ne constitue pas un contrôle.
Une réception complète relie toutes les preuves
Le reçu commence par le hash du point de contrôle, la révision, la licence, la taille, la résolution et l’échantillonnage. Il ajoute prétraitement, architecture de sonde, données étiquetées, graine, vues, erreurs par classe, calcul et latence de la chaîne complète.
Le reçu contient aussi des exclusions explicites : pas de génération vidéo, pas de légendage, pas d’interface linguistique, pas de planification, pas de robotique et aucune condition ultérieure de V-JEPA 2. Une exclusion lisible empêche une intégration de dépasser silencieusement la preuve.
Une contribution forte reste une contribution bornée
V-JEPA a fourni une expérience claire sur la prédiction de caractéristiques latentes. Les résultats avec sondes gelées ont soutenu l’idée que cette approche pouvait produire des représentations utiles. Cette conclusion suffit pour motiver une évaluation sérieuse sans invoquer une intelligence physique générale.
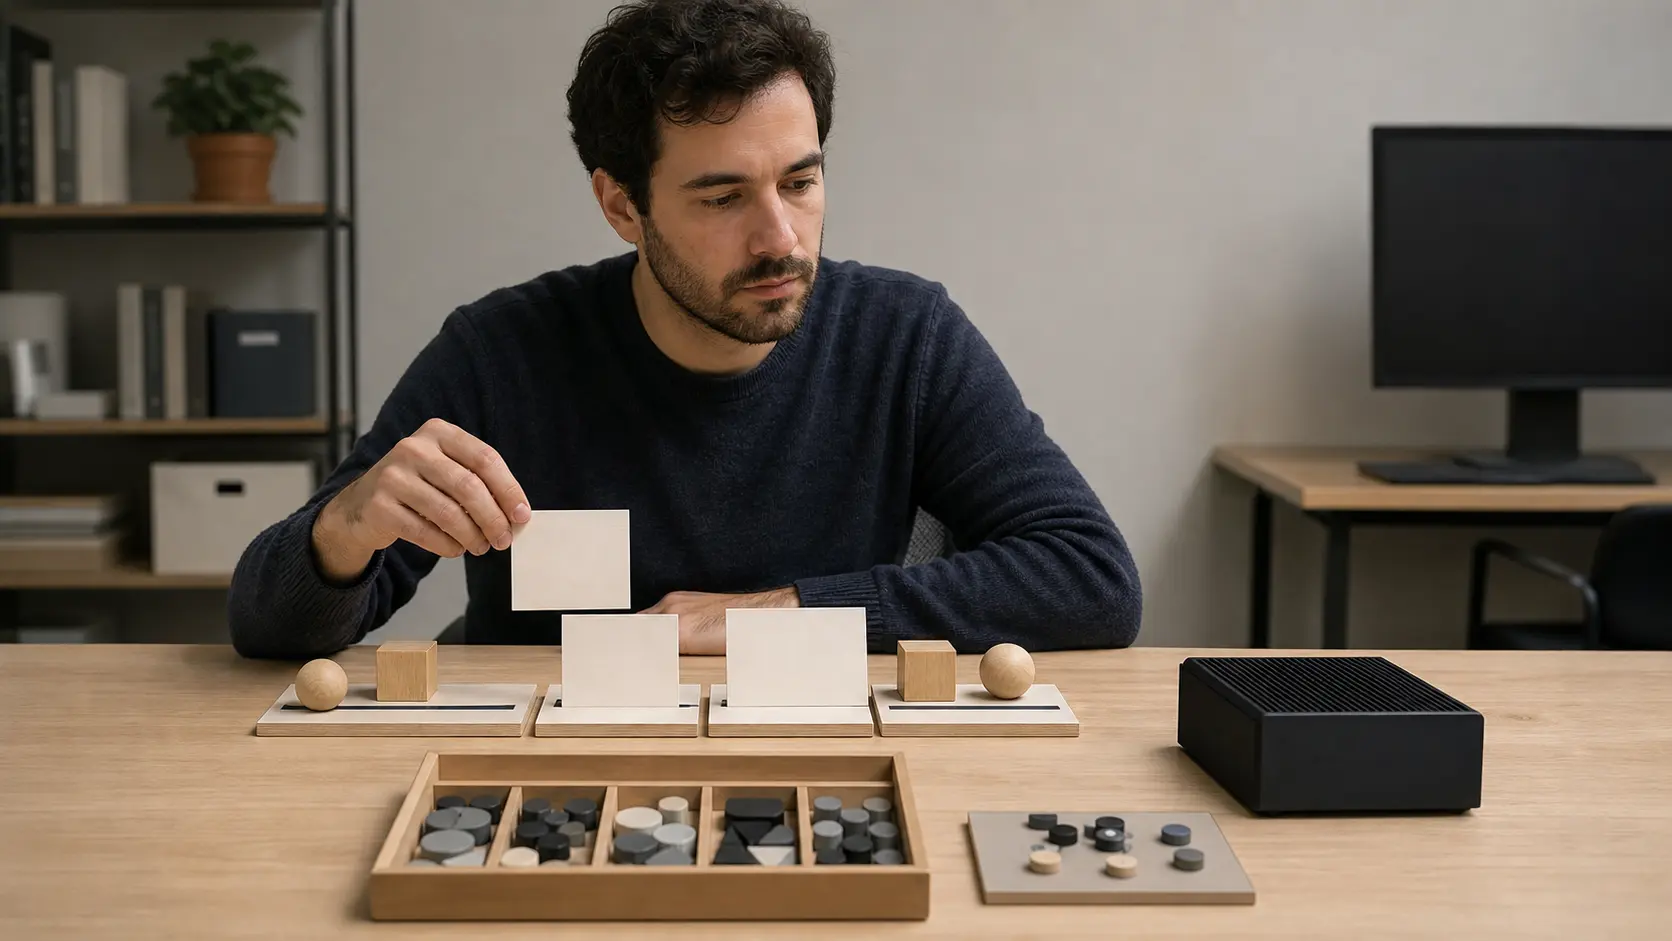
L’image associée suit la même discipline. Elle représente un chercheur fictif face à des cartes masquées, des jetons et une sonde séparée. Elle ne montre ni personnel de Meta, ni installation réelle, ni sortie V-JEPA, ni résultat de benchmark. Elle illustre une frontière, pas une preuve.
Sources
- Meta AI Research, publication de recherche V-JEPA du 15 février 2024 : https://ai.meta.com/research/publications/revisiting-feature-prediction-for-learning-visual-representations-from-video/
- Meta FAIR, dépôt officiel JEPA et contexte des points de contrôle : https://github.com/facebookresearch/jepa
- Bardes et coauteurs, article original V-JEPA : https://arxiv.org/abs/2404.08471
- Meta, présentation contemporaine et frontière des travaux futurs : https://ai.meta.com/blog/v-jepa-yann-lecun-ai-model-video-joint-embedding-predictive-architecture/
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance