
Résumé
- Slurm alloue les nœuds, les processeurs, la mémoire, les GPU et d’autres ressources, traduisant les partitions, les priorités, les règles de qualité de service, le fair-share et les réservations en décisions de file d’attente.
- TRES, GRES, la topologie et les cgroups permettent aux opérateurs de planifier les accélérateurs comme des ressources physiques contraintes; un simple nombre de GPU ne garantit pas un placement utile ni une exécution efficace.
- Les développeurs de Slurm ont fondé SchedMD en 2010 pour fournir de l’ingénierie, du support et de la formation commerciaux; NVIDIA a acquis la société le 15 décembre 2025 et s’est engagée à poursuivre un développement open-source et neutre vis-à-vis des fournisseurs.
- La crédibilité post-acquisition dépendra de tests multi-fournisseurs, du comportement des versions et des schémas de contribution, tandis que chaque opérateur de cluster reste responsable de la politique que ses utilisateurs vivent réellement.
Un GPU inactif n’est pas nécessairement un GPU disponible
Sur un cluster Slurm, un accélérateur physiquement inactif ne va pas automatiquement à la personne suivante qui en fait la demande. Un job doit d’abord être éligible à une partition, correspondre à la forme de ressources demandée, satisfaire aux règles de compte et de qualité de service, éviter les réservations qui bloquent les nœuds requis et surpasser les travaux concurrents. Ce n’est qu’ensuite que l’ordonnanceur alloue les ressources et permet au job de démarrer.
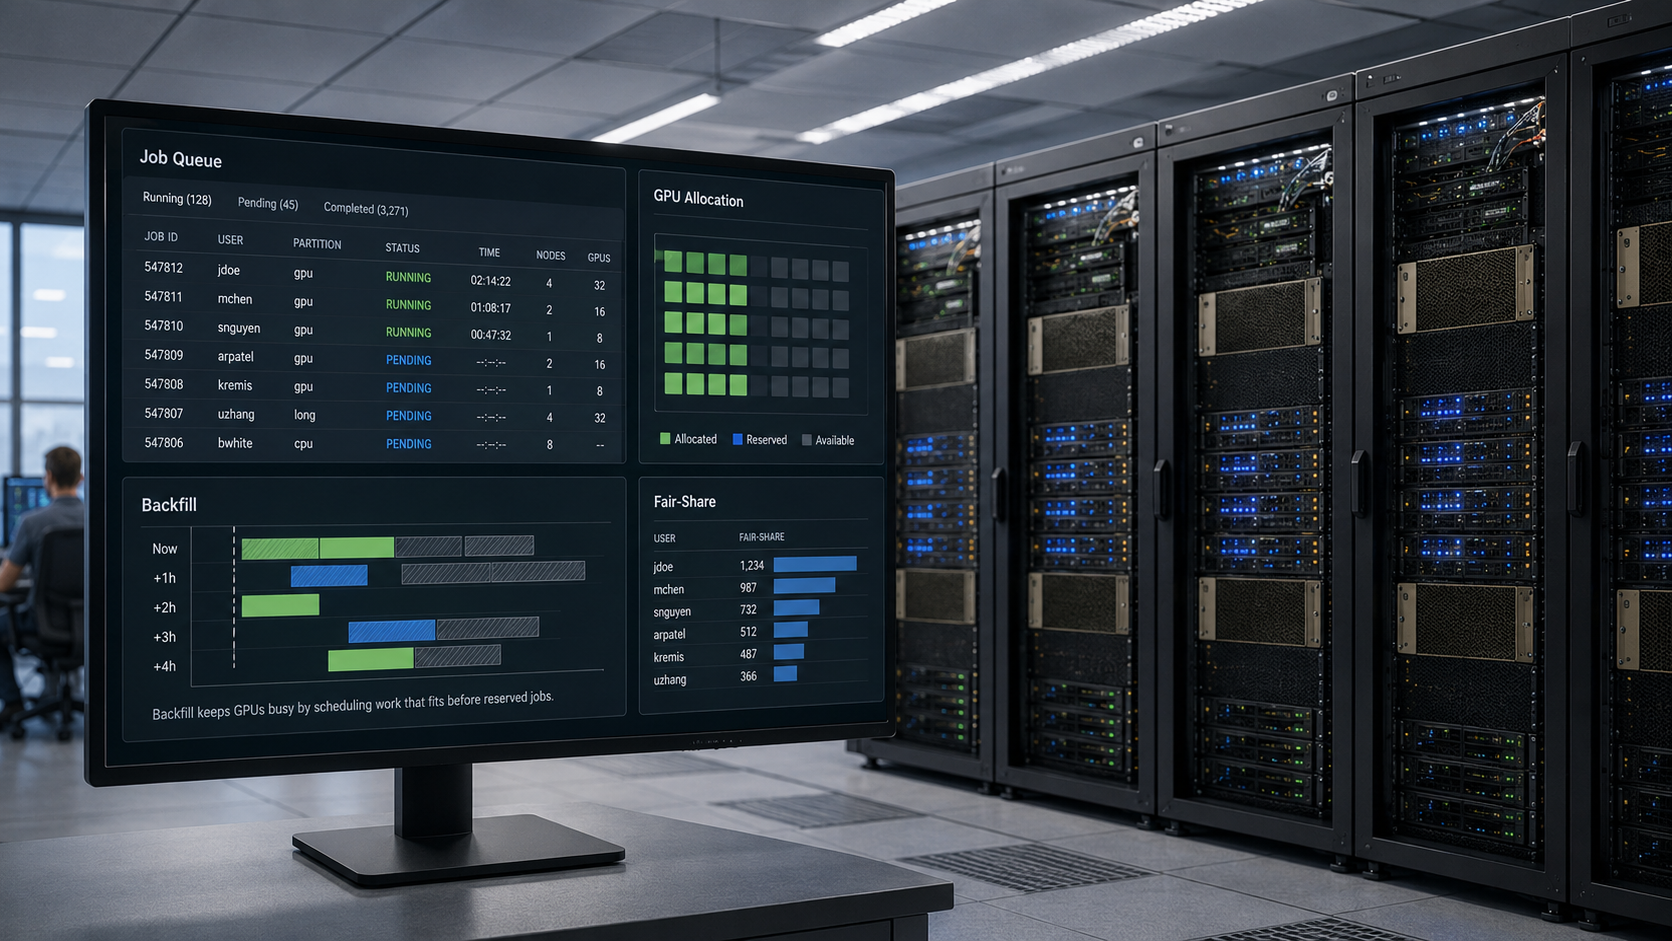
Cette séquence fait de Slurm plus qu’une file d’attente. C’est un plan de contrôle d’admission et d’allocation pour une large classe de systèmes de calcul haute performance et d’IA. Les utilisateurs soumettent des jobs;slurmctldles évalue par rapport à l’état du cluster et à la politique;slurmdsur les nœuds de calcul lance et surveille les travaux;slurmstepdgère les étapes de job individuelles. Un service optionnelslurmdbdenregistre les jobs, l’utilisation des ressources et les relations de compte dans une base de données.
La conséquence est économique autant que technique. Un cluster d’IA peut avoir assez de GPU au total et être tout de même incapable de démarrer un grand job d’entraînement parce que les dispositifs libres sont fragmentés entre les mauvais nœuds, se trouvent derrière une topologie inadaptée ou sont réservés pour un autre projet. Un ordonnanceur peut réduire ce gaspillage en représentant les contraintes pertinentes. Il ne peut pas créer des GPU manquants, réparer un réseau congestionné ni rendre une application inefficace utile.
L’importance de Slurm vient donc des décisions qu’il prend avant que l’application ne s’exécute. Le projet a passé plus de deux décennies à transformer une question simple — qui peut utiliser quelle machine maintenant? — en un système configurable pour allouer des infrastructures de plus en plus hétérogènes et coûteuses.
Slurm transforme la politique locale en temps machine
Slurm a débuté dans une collaboration menée par le Lawrence Livermore National Laboratory et est apparu pour la première fois en 2002. Son rôle initial était de coordonner des travaux parallèles soumis indépendamment sur de grands clusters Linux sans exiger que chaque application comprenne la machine entière. L’architecture d’origine séparait l’allocation des ressources de l’exécution des jobs et exposait une couche de contrôle commune adaptable à travers les institutions.
Cette séparation de base reste visible. Le contrôleur maintient une vue centrale des nœuds, des jobs et de l’état d’ordonnancement, tandis que les démons des nœuds de calcul exécutent le travail déjà autorisé. Un contrôleur de secours et un état persisté peuvent réduire l’impact d’une panne du contrôleur, mais la haute disponibilité dépend toujours d’un état cohérent, d’une authentification fonctionnelle, d’une accessibilité réseau et de procédures de récupération testées. « Tolérant aux pannes » est une capacité de conception, pas une garantie que toute panne du plan de contrôle est sans conséquence.
Le changement plus profond est venu lorsque Slurm a accumulé des primitives de politique. Les partitions regroupent les nœuds en classes de service ou en pools administratifs. Les associations relient les utilisateurs et les comptes à des parts, des limites et un usage historique. Les règles de qualité de service peuvent modifier la priorité, les limites ou le comportement de préemption. Les réservations retiennent des ressources pour la maintenance, des événements ou des utilisateurs nommés. La priorité multifacteur peut combiner l’âge, le fair-share, la taille du job, la partition, la QOS et des facteurs définis par le site.
Il n’existe pas de définition universelle de l’équité dans Slurm. Une université peut favoriser les projets qui ont utilisé moins que leur allocation à long terme. Un laboratoire national peut réserver une capacité pour une campagne. Un opérateur commercial de GPU peut créer des niveaux de service différenciés. Le même logiciel peut exprimer les trois parce que le site définit la politique.
Cette flexibilité est l’une des forces de Slurm et l’un de ses risques opérationnels. Une file d’attente peut devenir difficile à expliquer lorsque les partitions se chevauchent, que les exceptions s’accumulent et que plusieurs systèmes de pondération interagissent. Les utilisateurs vivent alors le résultat comme arbitraire même lorsque le logiciel implémente la configuration exactement. L’ordonnanceur peut calculer la priorité; l’institution doit encore justifier la politique.
Le fair-share détermine qui attend, pas ce que signifie l’équité
Le fair-share est souvent discuté comme s’il s’agissait d’une propriété objective de l’ordonnanceur. En pratique, c’est un mécanisme pour transporter les choix d’allocation d’une institution dans le temps. L’utilisation historique, la hiérarchie des comptes et les parts configurées peuvent influencer la priorité future afin qu’un groupe qui a consommé moins que son droit reçoive un avantage sur un autre qui a consommé plus.
Cela fait de la comptabilité une partie de la gouvernance.slurmdbdpeut enregistrer les jobs, les étapes, les associations et les ressources traçables sur un ou plusieurs clusters. Les administrateurs utilisent ces enregistrements pour les rapports, la refacturation, les limites d’utilisation et les calculs de fair-share. Un champ de base de données qui semble administratif peut donc affecter le moment où une équipe de recherche ou d’ingénierie reçoit ensuite des ressources de calcul rares.
La qualité du registre compte. Si les utilisateurs sont mappés sur le mauvais compte, si l’utilisation des ressources n’est pas enregistrée de manière cohérente ou si les données historiques sont conservées incorrectement, la priorité résultante peut être techniquement valide et institutionnellement fausse. Les changements d’appartenance aux projets, les comptes de service partagés et les enregistrements corrigés manuellement nécessitent tous une gouvernance parce que l’ordonnanceur peut les traiter comme des preuves de droits.
C’est l’une des raisons pour lesquelles les litiges de file d’attente sont difficiles à réduire à un bug logiciel. Une longue attente peut être causée par la demande, des demandes de temps de paroi inexactes, une réservation, un facteur de fair-share faible, une exigence de topologie, une règle de QOS ou simplement un job qui ne peut pas tenir dans les ressources libres actuelles. Slurm expose les mécanismes, mais l’opérateur a besoin d’une observabilité suffisante pour reconstruire lequel a compté.
Pour les utilisateurs, l’explicabilité fait donc partie de la qualité de service. Une file d’attente est plus facile à accepter lorsque les gens peuvent voir pourquoi un job est en attente, quelle politique s’applique et ce qui lui permettrait de démarrer. À mesure que les clusters deviennent plus chers et plus importants commercialement, cette transparence devient une question de gestion plutôt qu’une commodité pour les chercheurs.
Le backfill transforme les trous vides en travail utile
Une file d’attente à priorité stricte peut gaspiller de la capacité. Un grand job à haute priorité peut être premier en ligne mais incapable de démarrer tant que suffisamment de nœuds ne sont pas libres. Sans logique supplémentaire, les petits jobs qui pourraient se terminer avant cette réservation pourraient aussi attendre, laissant les ressources inactives.
L’ordonnanceur de backfill de Slurm résout ce problème en estimant quand les jobs à plus haute priorité peuvent commencer, puis en démarrant des travaux à plus basse priorité qui devraient se terminer sans les retarder. L’ordonnanceur ne demande pas simplement quel job vient ensuite. Il demande si un job peut utiliser une ouverture temporaire tout en préservant un démarrage attendu pour le travail devant lui.
Le mécanisme est puissant car les grands clusters sont souvent fragmentés. Certains nœuds se terminent tôt; d’autres restent occupés. Un job court peut tenir dans l’intervalle sans changer l’heure de début du job que l’institution considère plus important. Le backfill peut donc améliorer l’utilisation et réduire le temps d’attente en même temps.
Son efficacité dépend des informations qu’il reçoit. Si les utilisateurs demandent beaucoup plus de temps de paroi que nécessaire, l’ordonnanceur peut conclure qu’un job ne peut pas tenir en toute sécurité. S’ils en demandent trop peu, le job peut être terminé avant d’avoir fini. Les contraintes de topologie et d’accélérateur peuvent rendre un intervalle théoriquement disponible inutilisable. Les défaillances peuvent invalider le calendrier prévu.
Le backfill illustre en miniature le modèle opérationnel de Slurm. Le logiciel peut prendre une décision sophistiquée à partir d’un état déclaré, mais il ne peut pas connaître parfaitement l’avenir. De meilleurs résultats de file d’attente dépendent de demandes précises, d’un état de cluster fiable et de politiques qui donnent à l’ordonnanceur assez de marge pour faire des compromis.
Les GPU ont rendu la forme d’une allocation aussi importante que sa taille
Les accélérateurs ont changé ce que signifie « capacité disponible ». Une demande de huit processeurs est souvent plus interchangeable qu’une demande de huit GPU dans un job d’entraînement distribué. Le modèle d’accélérateur, la capacité mémoire, les relations PCIe ou NVLink, la position réseau et la composition des nœuds peuvent déterminer si l’allocation fonctionne comme prévu.
Slurm représente les ressources hétérogènes via les Trackable RESources, ou TRES, et les Generic RESources, ou GRES. Les GPU peuvent être comptés, typés et associés à des nœuds. L’intégration des dispositifs et des cgroups peut restreindre un job aux accélérateurs qui lui ont été alloués. Les plugins de topologie et les contraintes peuvent aider l’ordonnanceur à placer le travail avec une certaine conscience de la machine physique.
Cela transforme le GPU d’un périphérique attaché en une unité économique ordonnançable. Les administrateurs peuvent comptabiliser l’utilisation des accélérateurs, limiter l’accès, réserver des types de dispositifs particuliers et concevoir des politiques autour d’un matériel rare. Pour les infrastructures d’IA, cela est important car la file d’attente décide souvent de l’accès au composant le plus cher du cluster.
Un modèle de ressources, cependant, n’est aussi utile que la topologie qu’il capture. Huit GPU libres répartis sur des nœuds avec des chemins de communication inadaptés peuvent ne pas être équivalents à huit GPU dans deux serveurs étroitement connectés. Un ordonnanceur peut choisir en fonction de la topologie configurée, mais il ne peut pas déduire automatiquement chaque dépendance réseau, mémoire ou applicative.
La même limite s’applique à l’utilisation. Un tableau de bord peut montrer que les GPU sont alloués tandis que le job attend sur le stockage, la communication collective, le chargement de données ou des échecs répétés. Slurm peut dire à un opérateur qui détenait la ressource et quand. Il ne prouve pas, à lui seul, que l’accélérateur faisait un travail productif.
L’ordonnanceur se situe au-dessus du réseau mais en dépend toujours
Slurm n’est pas dans le chemin des données. Une fois qu’un job démarre, le trafic applicatif circule à travers les processeurs, la mémoire, les interconnexions et le stockage sans passer par l’ordonnanceur. Cela ne rend pas l’ordonnanceur indépendant de l’infrastructure physique.
Les choix de placement peuvent concentrer ou répartir le travail sur les commutateurs, les blocs ou les domaines d’accélérateurs. Une allocation consciente de la topologie peut réduire la distance de communication pour un job parallèle. Une allocation aveugle à la topologie peut transformer une capacité brute suffisante en un job aux performances médiocres parce que la bande passante utile est ailleurs.
L’ordonnanceur dépend aussi d’un état précis des nœuds. Un GPU peut être présent mais en mauvaise santé. Un nœud peut être accessible au contrôleur alors que son chemin de stockage est dégradé. Une partition réseau peut faire paraître un job en cours différent de la vue du contrôleur. Les plugins, les contrôles de santé des nœuds et les opérations locales doivent traduire ces conditions physiques en états sur lesquels l’ordonnanceur peut agir.
Cela crée une frontière facile à mal interpréter dans les rapports de performance. Si un job tourne lentement, la cause racine peut être l’allocation, le comportement applicatif, le stockage, la contention réseau, la santé des accélérateurs ou une combinaison. Si le cluster est inactif, la cause peut être une faible demande, une fragmentation, des réservations ou des défaillances plutôt qu’un mauvais algorithme d’ordonnancement.
Pour les opérateurs, la mesure utile est donc tout le chemin de la demande au travail terminé: délai de file d’attente, qualité d’allocation, succès de lancement, temps d’exécution, nouvelles tentatives, travail perdu et achèvement final. L’allocation globale de GPU est informative, mais elle n’est pas la même chose que la production productive.
SchedMD a transformé un projet open source en entreprise de support
À mesure que Slurm dépassait ses origines en laboratoire, les organisations avaient besoin de plus que du code source. Les clusters de production exigeaient des versions prévisibles, du débogage, de l’aide à la mise à niveau, de la formation et des ingénieurs capables de travailler sur des configurations de site inhabituelles. Les développeurs de Slurm ont créé SchedMD en 2010 pour fournir cette couche commerciale.
Cet arrangement a créé un compromis open source familier. Le code restait ouvertement disponible sous sa licence de projet, tandis que les clients payaient pour l’expertise, le support et le développement autour de systèmes de production difficiles. Le travail commercial a donné aux mainteneurs un moyen de financer une ingénierie durable et a donné aux opérateurs une voie d’escalade lorsque la file d’attente contrôlant un cluster majeur se comportait de manière inattendue.
SchedMD est aussi devenu un point de concentration des connaissances. Les grands systèmes d’ordonnancement accumulent des détails opérationnels difficiles à apprendre uniquement à partir de la documentation: récupération après panne, ordre des mises à niveau, interactions des plugins, cas limites de comptabilité et effets de politiques inhabituelles. Une entreprise qui emploie des mainteneurs clés peut transformer cette expérience en avantage de support sans posséder chaque contribution ni chaque déploiement.
Cette distinction compte parce que la politique de Slurm est toujours restée locale. SchedMD pouvait livrer du code, des correctifs et des conseils; il ne décidait pas des poids de fair-share, des réservations ou des droits de compte dans une université, un laboratoire national ou un service commercial d’IA. L’expérience utilisateur de Slurm est en partie le logiciel en amont et en partie la propre constitution de l’institution.
Au moment où l’IA a élargi la valeur de la capacité GPU planifiée, le rôle de SchedMD était donc plus grand que celui d’un vendeur de logiciels conventionnel. C’était le principal gardien commercial d’un plan de contrôle ouvert que de nombreux opérateurs avaient déjà intégré dans leurs flux de travail, leurs scripts, leurs systèmes de comptabilité et leurs procédures opérationnelles.
NVIDIA a changé les incitations autour de la gouvernance
NVIDIA a annoncé l’acquisition de SchedMD le 15 décembre 2025. Elle a déclaré que Slurm resterait open source et neutre vis-à-vis des fournisseurs, tout en affirmant que les développeurs de SchedMD auraient accès à davantage de systèmes accélérés et de ressources d’ingénierie. La licence n’est pas soudainement devenue propriétaire, et l’acquisition n’a pas transféré la politique d’ordonnancement locale des opérateurs à NVIDIA.
Ce qui a changé, c’est la structure d’incitations autour du principal gardien commercial du projet. NVIDIA n’est pas seulement une entreprise de logiciels qui finance des mainteneurs. C’est aussi un fournisseur majeur de GPU, de réseaux et de systèmes dont la performance peut dépendre de la manière dont les charges de travail sont découvertes, placées et lancées.
Cela crée un bénéfice plausible et une préoccupation plausible. Un accès plus précoce à des systèmes d’IA complexes peut améliorer les tests et raccourcir le chemin entre les changements matériels et le support de l’ordonnanceur. La même proximité soulève une question légitime: les accélérateurs, interconnexions et conceptions de systèmes concurrents continuent-ils de recevoir une attention de première classe?
Les preuves disponibles dans les premiers mois suivant l’acquisition ne justifient pas de déclarer soit une capture, soit une neutralité parfaite. Le développement public a continué. Slurm 26.05 et les correctifs suivants ont montré un travail de publication actif, tandis que les versions de correctifs de juillet 2026 traitaient des crashs et d’autres problèmes opérationnels. Slinky a également continué à se développer. Ce sont des indicateurs plus forts de gouvernance qu’une promesse faite le jour de l’acquisition, mais ils ne résolvent pas la question comparative à long terme.
NVIDIA a également décrit Slurm comme largement utilisé dans les principaux systèmes de supercalcul et a déclaré que SchedMD soutenait des centaines de clients au moment de l’acquisition. Ces déclarations indiquent une échelle mais restent rapportées par l’entreprise et datées. Elles ne constituent pas un recensement complet des clusters d’IA privés, des systèmes de recherche ou de chaque déploiement d’ordonnanceur.
La question de la neutralité devrait donc être formulée comme un test d’ingénierie observable. Les interfaces restent-elles génériques lorsque c’est possible? Les problèmes affectant le matériel concurrent sont-ils traités ouvertement et rapidement? Les processus de publication et les environnements d’intégration continue exercent-ils une base matérielle véritablement hétérogène? Les contributeurs externes peuvent-ils encore influencer le code sans passer par un produit propriétaire NVIDIA?
L’open source donne aux opérateurs un droit de sortie, pas un remplacement gratuit
La licence open source de Slurm compte parce que les opérateurs peuvent inspecter, modifier et redistribuer le code selon ses termes. Cela crée une barrière formelle contre une simple conversion en logiciel fermé et donne à la communauté une voie légale pour forker si la gouvernance devient inacceptable.
Un fork viable, cependant, n’est pas créé par une licence seule. L’ordonnancement à grande échelle nécessite des mainteneurs qui comprennent l’état du contrôleur, la comptabilité, les plugins, les versions, la sécurité et une large matrice matérielle. Il faut des systèmes de test, la confiance des utilisateurs et des personnes prêtes à backporter des correctifs sur les versions supportées.
Le coût pratique de changement est aussi beaucoup plus grand que le remplacement d’un exécutable. Les environnements Slurm matures accumulent des scripts de job, des structures de compte, un usage historique, des plugins personnalisés, de la supervision, des procédures opérationnelles et des habitudes utilisateur. Un autre ordonnanceur peut être techniquement capable et exiger quand même une migration coûteuse de la politique et de la mémoire institutionnelle.
C’est pourquoi la propriété de NVIDIA mérite un examen attentif sans traiter la forkabilité comme une réponse complète. La forme la plus forte de neutralité n’est pas la capacité théorique de partir après un problème. C’est un projet qui reste utile à travers une infrastructure hétérogène avant que le départ ne devienne nécessaire.
Le même raisonnement s’applique au support commercial. Les opérateurs peuvent compter sur l’expertise de l’entreprise qui emploie des mainteneurs clés même lorsque le code est ouvert. Si cette expertise se rétrécit autour d’un écosystème matériel, la source peut rester disponible tandis que la frontière pratique du support devient moins neutre.
Slinky place deux plans de contrôle dans le même environnement
Les infrastructures d’IA modernes combinent de plus en plus l’ordonnancement par lots avec Kubernetes. Les équipes de plateforme peuvent vouloir Kubernetes pour le provisionnement, les opérateurs, les services et le cycle de vie des conteneurs tout en conservant le modèle de job de Slurm, le fair-share, les réservations et la sémantique des charges de travail parallèles.
Slinky est la tentative de SchedMD de faire le pont entre ces mondes. Sonslurm-operatorpeut déployer et gérer les composants Slurm via des mécanismes orientés Kubernetes, tandis queslurm-bridgecoordonne le travail entre Kubernetes et Slurm sur des ressources partagées. La version 1.2.0 est sortie le 2 juillet 2026 après la première ligne stable apparue fin 2025.
L’attrait est clair. Une organisation peut préserver une politique Slurm établie tout en utilisant des outils cloud natifs pour gérer l’infrastructure autour. Cela peut réduire le besoin de construire un environnement opérationnel entièrement séparé pour le calcul par lots.
La difficulté est l’autorité. Kubernetes et Slurm ont des modèles différents d’état souhaité, de propriété des charges de travail et de récupération. Si les deux systèmes croient contrôler un nœud, un dispositif ou une charge de travail après une panne, l’intégration a besoin d’une réponse claire sur quel état est autoritaire et comment l’autre système est réconcilié.
Ce n’est pas une raison pour rejeter l’approche. C’est la raison pour laquelle Slinky devrait être jugé sur des preuves opérationnelles plutôt que sur la propreté architecturale. Les déploiements de production doivent montrer comment les mises à niveau, le fencing, le RBAC, les pannes de contrôleur et les partitions réseau partielles sont gérés lorsque deux systèmes d’orchestration sont impliqués.
L’histoire de Slurm a à plusieurs reprises élargi la frontière de ce que l’ordonnanceur coordonne. L’intégration Kubernetes poursuit ce schéma, mais chaque nouvelle surface de contrôle accroît l’importance de savoir où la responsabilité se déplace quand quelque chose casse.
La file d’attente peut améliorer l’utilisation et produire quand même un mauvais résultat
Slurm donne aux opérateurs de nombreux moyens de rendre une capacité coûteuse plus utile. Le backfill peut réduire les intervalles vides. Le fair-share peut répartir l’accès dans le temps. Un placement conscient de la topologie peut améliorer la localité. Les réservations peuvent protéger un travail critique. La préemption peut faire de la place pour des jobs urgents ou premium.
Chaque mécanisme a aussi un coût. Une réservation peut immobiliser une capacité si le job attendu n’arrive pas. La préemption peut détruire un travail utile lorsque les applications ne peuvent pas faire de checkpoint. Une règle de topologie peut préserver la performance d’un job tout en augmentant la fragmentation pour d’autres. Le fair-share peut récompenser une politique qui ne correspond plus aux priorités de l’institution.
Le risque grandit lorsque les opérateurs optimisent une seule métrique. Une allocation élevée de GPU peut être obtenue en gardant des dispositifs assignés à un travail qui est bloqué ailleurs. Un temps de file d’attente faible peut être obtenu en admettant des jobs sur des formes de ressources qui allongent l’exécution. Une préemption agressive peut protéger un niveau de service tout en gaspillant l’énergie et le calcul déjà dépensés sur des jobs interrompus.
Pour les infrastructures d’IA, la meilleure mesure est le travail utile achevé par unité de capacité et de temps rares. Slurm contribue à ce résultat, mais il n’est qu’une couche. Les frameworks d’entraînement, le stockage, la conception réseau, le checkpointing, la santé des accélérateurs et la qualité des demandes utilisateur affectent tous si l’allocation crée de la valeur.
C’est aussi la frontière entre la responsabilité en amont et la responsabilité locale. Si un site choisit une politique qui privilégie un compte, abuse des réservations ou fixe des règles de préemption irréalistes, le résultat ne devrait pas automatiquement être attribué à SchedMD ou à NVIDIA. Si l’ordonnanceur calcule mal l’état, manipule mal un dispositif ou introduit une régression, le comportement en amont devient la couche pertinente.
Une opération crédible a besoin d’assez d’auditabilité pour distinguer ces cas.
La véritable surface de contrôle est répartie entre plusieurs acteurs
La gouvernance de Slurm peut sembler centrale parce qu’un contrôleur ordonnance le cluster et qu’une seule entreprise emploie désormais de nombreux experts du projet. En pratique, le contrôle est divisé.
Les mainteneurs en amont décident quel code entre dans les versions. NVIDIA possède SchedMD et peut allouer des ressources d’ingénierie. Les fournisseurs de matériel contribuent au travail d’intégration et fournissent des systèmes de test. Les administrateurs de cluster choisissent les versions, les plugins, les modèles de topologie, les comptes, la QOS et les limites. Les dirigeants institutionnels décident qui a droit aux ressources de calcul rares. Les utilisateurs décident quelles ressources demander et avec quelle précision ils décrivent le temps d’exécution. L’application détermine ensuite si l’allocation est utilisée efficacement.
Ce contrôle en couches est le fait central de Slurm. Aucun acteur unique ne possède l’ensemble du résultat.
Cela explique aussi pourquoi la gouvernance de la file d’attente est devenue stratégiquement importante. Lorsque les accélérateurs étaient moins rares et moins précieux, une règle sous-optimale pouvait être irritante. Dans un grand parc d’IA, la même règle peut changer les temps d’attente, la fragmentation et la quantité de capacité coûteuse qui termine un travail utile.
L’accomplissement de Slurm est qu’un système ouvert commun peut exprimer des modèles d’allocation très différents sans forcer chaque institution à une définition unique de l’équité. Sa limite est identique: le logiciel ne peut pas garantir qu’un modèle choisi est sage, lisible ou légitime.
Le test à long terme n’est donc pas de savoir si Slurm continue d’ordonnancer des jobs. C’est de savoir si les opérateurs peuvent encore reconstruire pourquoi un job a reçu ou perdu l’accès à des ressources de calcul rares, tandis que le projet en amont reste crédible à travers le matériel hétérogène que ces opérateurs veulent faire fonctionner.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance