
Résumé
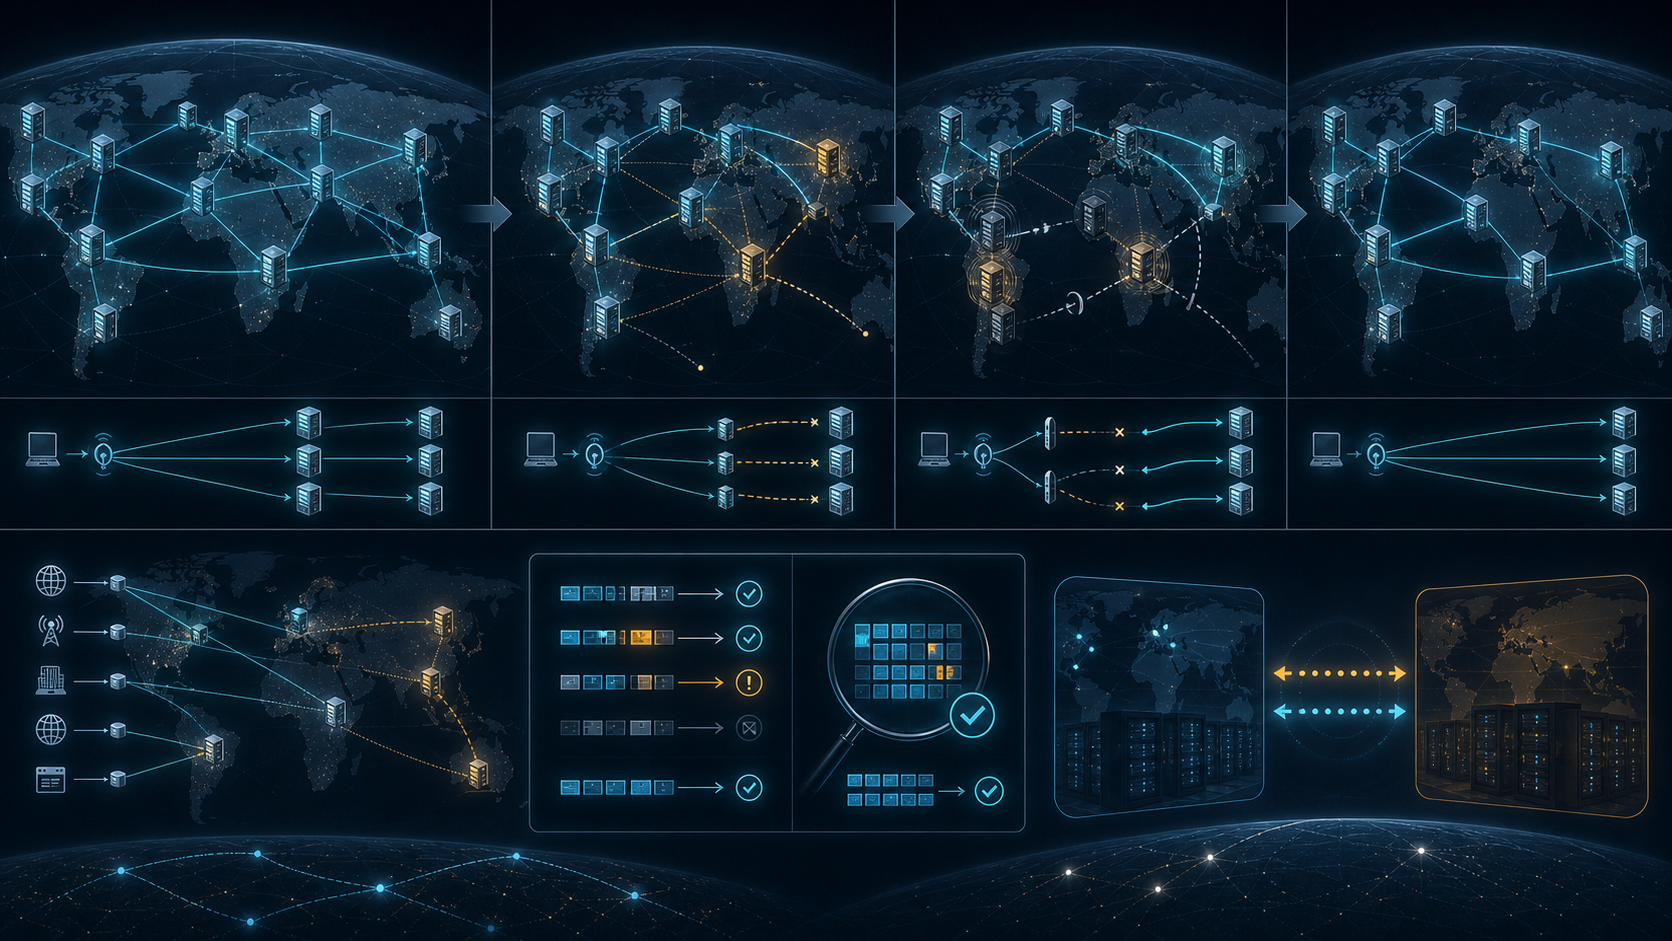
- Un défaut introduit pendant un déploiement logiciel progressif de Cloudflare a conduit certains nœuds F-Root exploités en partenariat à omettre des enregistrements glue nécessaires, provoquant des échecs sporadiques de résolution de la zone .net.
- ISC a appris l’existence du problème à 17 h 33 UTC et le service a été entièrement rétabli à 20 h 51 UTC. La réparation immédiate est documentée, mais les éléments publics examinés ne démontrent pas que la procédure de retrait BGP a ensuite fait l’objet d’exercices récurrents assortis de critères et d’une vérification indépendante.
Une panne produite par des réponses DNS incomplètes
La panne n’a pas pris la forme d’une disparition totale de F-Root. Selon le compte rendu publié par Internet Systems Consortium, un bug introduit pendant un déploiement progressif du logiciel de Cloudflare a affecté certains nœuds F-Root exploités dans le cadre du partenariat avec ISC. Les réponses de ces instances omettaient des enregistrements glue requis, ce qui entraînait des échecs sporadiques de résolution pour la zone .net.
Cette intermittence est importante. Une panne franche produit généralement un signal plus facile à agréger : un service cesse de répondre, un seuil de disponibilité est franchi ou une alarme de connectivité se déclenche. Ici, les instances concernées pouvaient encore répondre tout en renvoyant une réponse sémantiquement défectueuse. Le système restait donc visible, mais certaines de ses réponses n’étaient pas suffisamment complètes pour permettre la résolution attendue.
La redondance géographique ne neutralise pas automatiquement ce type de défaut. Elle protège surtout contre certaines catégories de défaillance physique, de perte de connectivité ou de surcharge. Lorsqu’un défaut logiciel est propagé à plusieurs instances et que le routage anycast peut conduire un résolveur vers une instance affectée, la distribution peut aussi distribuer l’erreur. L’existence d’autres nœuds sains réduit potentiellement l’impact, mais elle ne garantit pas que chaque requête évitera une réponse fautive.
Le mécanisme observé oblige donc à distinguer trois questions souvent confondues : le serveur répond-il, sa réponse est-elle correcte, et l’organisation qui constate le défaut peut-elle isoler rapidement les instances concernées ? L’incident F-Root a mis ces trois dimensions en relation.
Qui contrôlait le déploiement, la détection et le retrait
Le récit d’incident d’ISC décrit une répartition concrète du contrôle. Cloudflare contrôlait le déploiement progressif à l’origine du défaut, l’implémentation affectée et la correction logicielle sur les nœuds exploités en partenariat. ISC a reçu le signal d’un grand opérateur de réseau, a vérifié le comportement, a coordonné l’escalade et a demandé le retrait opérationnel des préfixes F-Root concernés.
Cette répartition ne justifie pas d’attribuer indistinctement toutes les étapes à une seule organisation. Elle révèle plutôt une dépendance d’interface. L’entité qui reçoit et confirme le signal n’est pas nécessairement celle qui peut modifier le code. Celle qui possède la vision institutionnelle du service n’est pas nécessairement celle qui contrôle chaque annonce de route issue de l’infrastructure partenaire. Le temps de réponse dépend alors non seulement de la compétence technique de chaque partie, mais aussi de la clarté des pouvoirs d’action entre elles.
La détection initiale est elle-même venue de l’extérieur. ISC indique avoir appris l’existence du problème grâce à un grand opérateur de réseau. Cela signifie que le premier signal documenté n’a pas été produit par un mécanisme interne ayant automatiquement identifié l’omission des enregistrements glue. Un opérateur observant les effets en aval a fourni l’alerte qui a démarré la séquence de réponse.
Une détection externe n’est pas en soi un échec : des opérateurs de services critiques doivent pouvoir recevoir et exploiter rapidement des signalements provenant de réseaux tiers. Mais elle pose une question de contrôle préventif. Si une réponse techniquement disponible peut être sémantiquement incorrecte, les contrôles doivent vérifier le contenu attendu de la réponse, et pas seulement la disponibilité du processus ou le volume du trafic.
Trois heures et dix-huit minutes entre l’alerte et le rétablissement
La chronologie publiée par ISC permet de mesurer la séquence sans la réduire à une formule générale. ISC a été informé du problème à 17 h 33 UTC. L’organisation a accusé réception du signalement à 17 h 41, soit huit minutes plus tard. À 17 h 46, elle avait vérifié le comportement et l’avait transmis à Cloudflare. Le service a été entièrement rétabli à 20 h 51. Entre la première prise de connaissance documentée et le rétablissement complet, il s’est donc écoulé trois heures et dix-huit minutes, selon le compte rendu officiel de l’opérateur.
La première partie de la séquence a été rapide : treize minutes séparent l’alerte initiale de la vérification et de l’escalade. La majeure partie de l’intervalle de rétablissement se situe après cette confirmation, lorsque les organisations devaient identifier le défaut de version, corriger le logiciel, retirer les préfixes affectés, vérifier le comportement puis réannoncer les routes.
La réparation a donc combiné une modification applicative et une action de routage. La correction du code supprimait la cause technique, tandis que le retrait BGP permettait d’écarter du service les instances fautives pendant l’intervention. Les préfixes ont ensuite été réannoncés après correction et vérification. Ces actions étaient complémentaires : une correction sans isolation immédiate pouvait laisser des instances fautives accessibles pendant le déploiement, tandis qu’un retrait sans correction aurait seulement déplacé ou suspendu le problème.
Le chiffre de trois heures et dix-huit minutes ne doit pas être transformé en mesure exhaustive de l’impact. Les éléments publics examinés ne quantifient pas le nombre total de résolveurs ou d’utilisateurs affectés. Ils établissent une durée de restauration à partir de la prise de connaissance d’ISC, pas le début absolu de chaque manifestation du défaut ni l’expérience de chaque réseau en aval.
Pourquoi la redondance n’a pas supprimé le risque de coordination
Une architecture redondante peut contenir une panne sans éliminer la nécessité d’une autorité d’urgence. Dans cet incident, la question décisive n’était pas seulement de savoir s’il existait d’autres instances F-Root. Il fallait déterminer quelles instances étaient fautives, empêcher le trafic de continuer à les atteindre, corriger leur logiciel et les réintroduire sans rétablir le défaut.
La redondance protège lorsqu’une défaillance est suffisamment isolée et lorsque le mécanisme de basculement fonctionne comme prévu. Elle est moins probante lorsque plusieurs instances partagent le même risque de version ou lorsque la capacité d’isolation dépend d’une organisation différente de celle qui reçoit le signalement. Dans ce cas, le nombre de nœuds ne dit pas à lui seul combien de temps il faudra pour retirer les nœuds défectueux.
Le contrôle pertinent se situe à l’intersection de quatre capacités : gouverner les versions déployées, vérifier la correction sémantique des réponses DNS, disposer d’une procédure d’escalade entre organisations et pouvoir retirer rapidement les préfixes affectés. Une faiblesse dans l’une de ces capacités peut réduire la valeur opérationnelle des trois autres.
L’incident montre aussi la limite d’un indicateur de santé uniquement fondé sur le trafic. Une instance qui reçoit et traite des requêtes peut sembler active tout en renvoyant un contenu incomplet. Pour détecter ce scénario, la surveillance doit poser des questions représentatives au service et vérifier les éléments attendus de la réponse. Un voyant vert attestant qu’un serveur répond n’est pas équivalent à une preuve que la réponse permet la résolution correcte.
Ce que l’engagement de tester démontre — et ce qu’il ne démontre pas
Après l’incident, ISC a indiqué qu’un accord avait été conclu avec Cloudflare pour tester régulièrement la fonction de retrait BGP. Cette déclaration, rapportée dans le document d’ISC, montre que les parties ont reconnu l’importance de rendre la procédure d’isolation disponible et testable.
Elle ne suffit toutefois pas à démontrer une préparation durable. Les éléments publics examinés n’établissent pas les dates d’exercices ultérieurs propres à cet incident, leur fréquence, leurs critères de réussite, les délais observés, les éventuels échecs ni l’existence d’une vérification indépendante. Cette limite documentaire ne prouve pas que les tests n’ont jamais eu lieu. Elle signifie uniquement que leur exécution et leurs résultats ne sont pas démontrés par le dossier public ici examiné.
La distinction est essentielle. Une intention de tester est une décision de gouvernance. Un exercice achevé est une observation opérationnelle. Une série d’exercices réussis selon des critères prédéfinis constitue un niveau de preuve supplémentaire. Une validation indépendante, enfin, permet à des tiers de vérifier que la procédure reste disponible lorsque les équipes, les logiciels ou les relations contractuelles changent.
Un test de durabilité borné pour les opérateurs
Un opérateur souhaitant démontrer la solidité d’une procédure comparable devrait pouvoir répondre à six questions précises : qui peut ordonner le retrait, qui peut l’exécuter, quel délai maximal est accepté, comment la disparition des routes est-elle observée, quelles conditions autorisent la réannonce, et où les résultats sont-ils conservés ?
Le test doit vérifier la chaîne complète, pas seulement la possibilité théorique d’envoyer une commande. Il faut confirmer que l’autorité est joignable, que l’opérateur de routage identifie les bons préfixes, que les annonces sont effectivement retirées, que les instances défectueuses cessent d’être accessibles par les chemins concernés et que la réintroduction suit une validation de la correction.
La preuve durable ne réside donc pas dans l’affirmation abstraite que l’infrastructure est redondante. Elle réside dans une capacité d’isolation mesurée, répétée et réexaminée. Le 23 janvier 2020, le défaut a été corrigé et le service entièrement rétabli. Le dossier public étudié permet d’établir cette réparation immédiate. Il ne permet pas, à lui seul, d’établir que le chemin d’urgence a ensuite été exercé de façon récurrente selon des critères publiquement vérifiables.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance