
Résumé
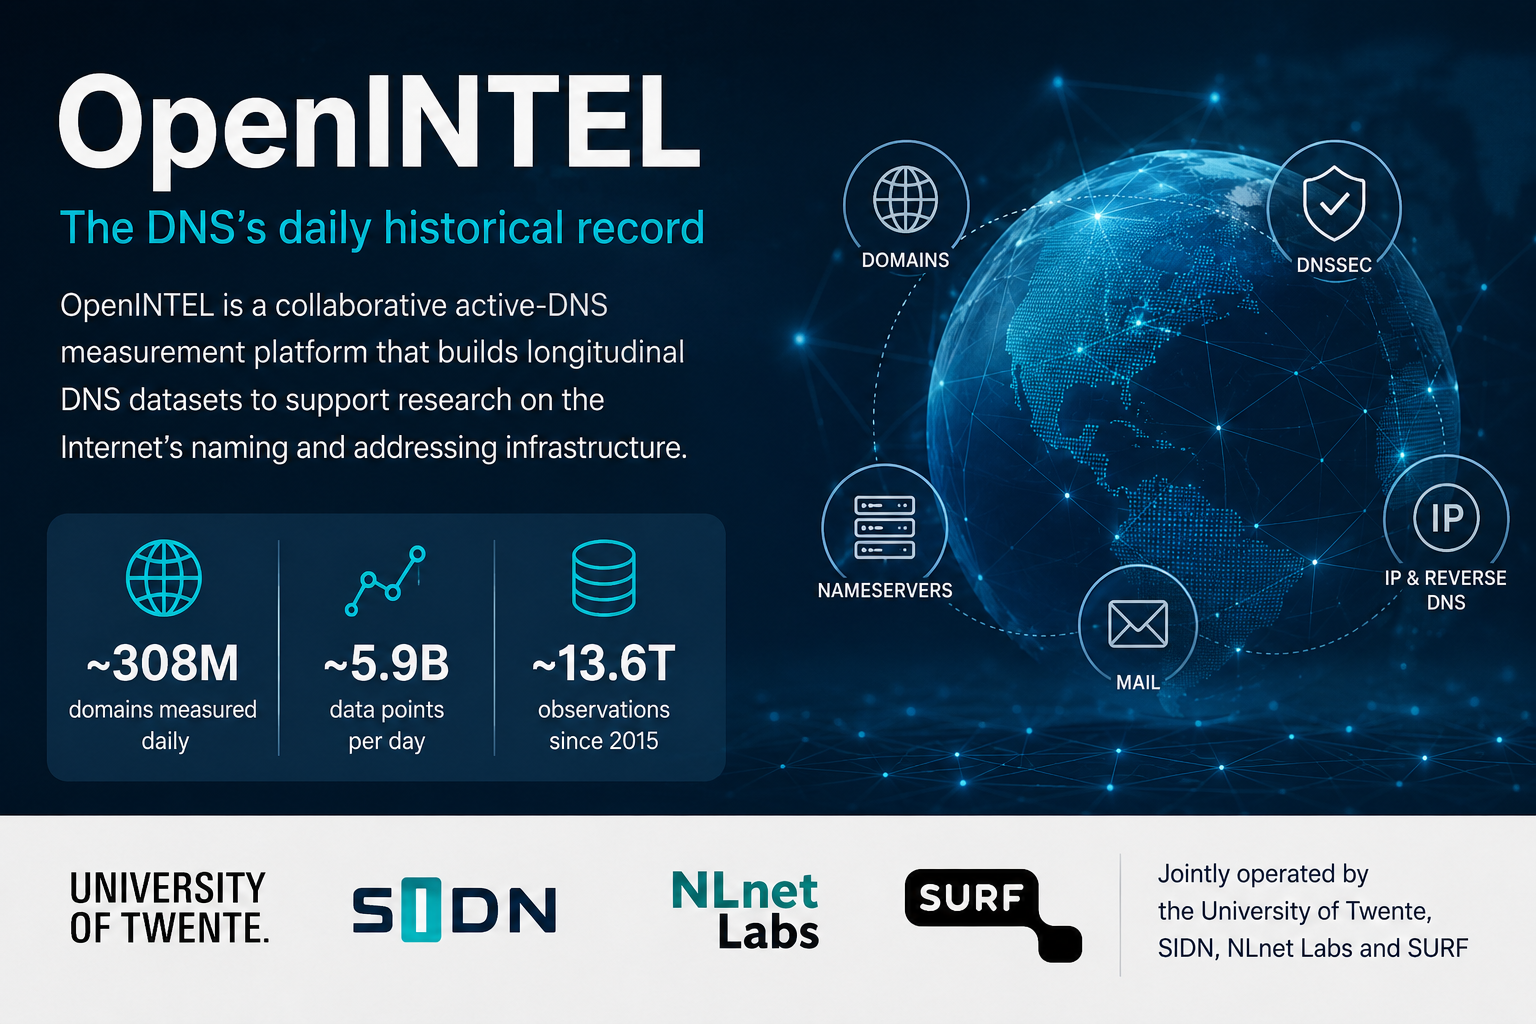
- OpenINTEL est une plateforme collaborative de mesure DNS active exploitée par l’Université de Twente, SIDN, NLnet Labs et SURF, et non un registre, un résolveur ou une entreprise de DNS passif.
- Sa page d’accueil indique environ 308 millions de domaines mesurés quotidiennement, 5,9 milliards de points de données produits chaque jour et 13,6 billions d’observations accumulées depuis le début des opérations régulières en 2015.
- La cohérence longitudinale crée la valeur de la plateforme, tandis que la sélection des sources, le point de vue, la méthode d’interrogation, la version du logiciel, les changements de méthode et les contrôles des données manquantes délimitent chaque résultat.
- OpenINTEL n’observe pas la demande des utilisateurs ni tous les états du DNS; certains jeux de données sont ouverts sous licence non commerciale, tandis que des contrats d’accès aux zones maintiennent d’autres données sous contrôle.
Un système de l’Université de Twente est devenu une infrastructure nationale de recherche partagée
La mise en œuvre d’OpenINTEL a commencé en 2014 à l’Université de Twente. La première exécution quotidienne complète a démontré que le pipeline pouvait interroger, traiter et stocker un très vaste espace de noms dans la fenêtre opérationnelle nécessaire à la répétition. Les mesures régulières ont débuté en mars 2015. Le passage d’une expérience à un système quotidien a créé la principale valeur de l’archive: la continuité.
Le projet a été fondé par des chercheurs dont Anna Sperotto, Mattijs Jonker et Roland van Rijswijk-Deij, dont les rôles actuels au sein du projet couvrent la direction de la recherche, l’architecture des données, la conception des mesures et le financement. Le modèle opérationnel s’est étendu au-delà d’une seule université. SIDN a apporté son expertise de registre et un soutien durable. NLnet Labs a rejoint le projet en tant que partenaire de recherche et de logiciels DNS. SURF a fourni un contexte de réseau de recherche et d’infrastructure. Les quatre institutions exploitent désormais conjointement le projet.
Cet arrangement ne doit pas être décrit comme une entreprise autonome. Il n’existe aucune société OpenINTEL vérifiée avec des actionnaires, des revenus consolidés ou une valorisation. Le personnel, le matériel, les contrats, les subventions et les droits sur les données relèvent des institutions partenaires. La gouvernance du projet est moins formelle publiquement qu’un conseil de fondation, mais sa diversité institutionnelle réduit la dépendance à un seul laboratoire.
Chaque partenaire apporte également un point de vue différent sur le DNS. Une université valorise la recherche reproductible et le travail des étudiants. Un registre comprend les données de zone, les relations avec les opérateurs et les contraintes des accords d’accès. Une organisation de logiciels DNS apporte des connaissances sur les protocoles et leur mise en œuvre. Un réseau national de recherche peut soutenir la capacité de calcul et la connectivité nécessaires à une mesure soutenue.
Le modèle crée des limites. Les partenaires peuvent financer des équipements et du personnel sans publier un budget de projet unique. Les données de zone obtenues sous contrat peuvent être mesurées mais pas redistribuées librement. Les pages des contributeurs peuvent devenir obsolètes lorsque les personnes changent d’emploi, de sorte qu’elles sont fiables pour l’historique du projet et moins fiables pour les titres actuels sans rapport. L’exploitation partagée ne rend pas tous les actifs institutionnels détenus en commun.
Le développement d’OpenINTEL, d’un système de laboratoire à une infrastructure commune, a également modifié ses obligations de service. Les chercheurs dépendent de la continuité des données. Les opérateurs ont besoin d’un trafic identifiable et d’un moyen de signaler les dommages. Les utilisateurs de données ont besoin de formats stables et de conditions d’accès. Les migrations de stockage doivent préserver l’historique. Le projet doit se comporter comme un observatoire de longue durée plutôt que comme un jeu de données temporaire d’un article.
La première journée complète a été un jalon technique. La décision de continuer à mesurer pendant une décennie a été la réalisation institutionnelle.
Le DNS répond au présent et oublie le passé
Une requête DNS demande la réponse actuelle disponible par un chemin particulier. La réponse peut identifier des serveurs de noms, des adresses, des systèmes de messagerie, des enregistrements liés aux certificats ou d’autres configurations. Demain, l’opérateur peut la modifier. L’état précédent peut rester dans les caches pendant un certain temps, apparaître dans les journaux détenus par un fournisseur ou disparaître entièrement de la vue publique.
Ce comportement est approprié pour un système de nommage en direct. Le DNS n’existe pas pour fournir aux historiens un registre complet. Il existe pour mettre en correspondance des noms et d’autres identifiants sous une autorité distribuée. Les registres, les bureaux d’enregistrement, les opérateurs faisant autorité, les résolveurs récursifs et les applications conservent chacun des preuves différentes. Aucune institution ne préserve naturellement une vue longitudinale sur de nombreux espaces de noms et types d’enregistrements.
Cette absence compte. Les chercheurs veulent savoir comment l’adoption de DNSSEC a changé, quand l’hébergement ou l’infrastructure de messagerie a migré, à quel point le service faisant autorité est devenu concentré et si une politique ou une vulnérabilité a modifié le comportement. Les équipes de sécurité veulent reconstituer ce vers quoi un domaine résolvait avant un incident. Les décideurs politiques veulent des preuves de la dépendance à l’égard des fournisseurs. Un scan ponctuel peut décrire un état; il ne peut pas révéler la transition.
OpenINTEL a été conçu pour créer cette preuve temporelle par des mesures actives répétées. Le projet obtient ou construit des listes de noms et de plages d’adresses, envoie des requêtes DNS définies selon un calendrier et stocke les réponses avec des horodatages et des métadonnées. La répétition du processus permet à un chercheur de comparer des éléments comparables au fil des jours et des années.
Le mot « comparable » exige de la discipline. Les listes de sources changent. De nouveaux types d’enregistrements sont ajoutés. Les logiciels et l’infrastructure sont mis à niveau. Certains jours sont incomplets. Un serveur faisant autorité peut limiter le débit ou bloquer le projet. Une réponse peut varier selon le point de vue, l’emplacement anycast ou l’heure. La valeur longitudinale dépend de l’enregistrement de ces changements plutôt que du traitement de l’archive comme une table parfaitement uniforme.
La contribution centrale d’OpenINTEL n’est donc pas simplement le volume de scan. Les scanners à l’échelle de l’Internet peuvent également produire d’énormes jeux de données. L’atout distinctif est un instrument de longue durée dont les méthodes, les partenaires et les produits de données sont suffisamment stables pour que le changement lui-même devienne un sujet d’étude.
Cette force soutient le titre « l’enregistrement historique quotidien du DNS » uniquement avec une limite. OpenINTEL préserve un historique des mesures qu’il a été configuré pour effectuer. Il n’enregistre pas chaque requête DNS, chaque domaine ou chaque réponse vue par les utilisateurs. L’archive est suffisamment grande pour qu’un langage négligent puisse la faire paraître universelle. Sa crédibilité dépend de la résistance à cette tentation.
La liste cible définit le champ de vision de l’archive
La mesure DNS active nécessite une population cible. OpenINTEL peut recevoir des listes de domaines dérivées de zones, des noms de transparence des certificats, des listes de popularité, des données d’apex de codes pays, des plages d’adresses et d’autres sources. Chaque source répond à une question de recherche différente et contient un biais différent.
Une zone de registre peut fournir une large couverture des noms délégués sous ce domaine de premier niveau, sous réserve de contrat. Elle peut omettre des noms dans d’autres espaces de noms et ne dit rien sur le fait qu’un domaine héberge un service actif. Les journaux de transparence des certificats révèlent des noms associés à des certificats enregistrés publiquement, favorisant les services compatibles TLS et exposant des sous-domaines absents des listes de zones. Les listes de popularité mettent l’accent sur les noms fréquemment consultés selon des méthodologies opaques ou changeantes.
La mesure DNS inverse commence à partir de l’espace d’adressage plutôt que des noms.
La combinaison de sources augmente la portée et le risque de double comptage ou de changement de composition. Un chiffre de page d’accueil de 308 millions de domaines mesurés quotidiennement doit être lu comme la métrique actuelle du projet pour les observations de domaines configurées, et non comme 308 millions de sites web actifs uniques. Un domaine peut être parqué, délégué sans contenu, dupliqué dans les listes, ou utilisé pour la messagerie et l’infrastructure plutôt que pour un site web.
La sélection des sources affecte l’interprétation longitudinale. Supposons qu’un nouveau domaine de premier niveau soit ajouté à la mesure. Le nombre total d’enregistrements observés augmente parce que l’instrument s’est étendu, et non parce que le DNS a changé de manière organique. Une liste de popularité peut réviser sa méthodologie et créer un apparent renouvellement. La couverture de la transparence des certificats peut augmenter à mesure que les pratiques d’émission changent. Les analystes ont besoin de listes versionnées et de critères d’inclusion.
Les méthodes du projet peuvent encore produire des tendances robustes lorsque les comparaisons sont délimitées. Les chercheurs peuvent examiner un sous-ensemble stable de noms dans le temps, contrôler les ajouts et classer les types de sources. La taille de l’archive permet d’étudier des événements rares et des relations d’infrastructure, mais les grands nombres ne compensent pas une population indéfinie.
La gouvernance des listes est également commerciale et politique. Les registres peuvent autoriser la mesure dans le cadre d’accords qui restreignent la redistribution. Les opérateurs peuvent s’opposer à la charge. Un projet engagé en faveur de la science ouverte ne peut pas simplement publier des données qu’il n’a pas le droit de partager. L’archive comporte donc des couches ouvertes et contrôlées.
La première question pour tout résultat d’OpenINTEL devrait donc être: quels noms ou adresses étaient éligibles à la mesure à ces dates? La réponse n’est pas un détail de fond. Elle définit l’affirmation.
OpenINTEL mesure des noms et des espaces d’adressage depuis une base institutionnelle néerlandaise avec des listes de sources et des collaborations mondiales. Cela lui donne un sujet d’étude mondial, mais pas une représentation automatique de chaque région ou de chaque expérience utilisateur.
L’accès aux zones varie selon les registres. Certaines listes de codes pays sont exhaustives, d’autres sont assemblées à partir de sources publiques et certaines ne peuvent pas être redistribuées. Les noms dérivés des certificats favorisent les services utilisant des certificats publics. Un point de vue de mesure peut recevoir une réponse anycast différente de celle observée sur un autre continent. Le DNS à horizon divisé et géolocalisé peut rendre les deux observations valides.
Les chercheurs comparant des pays doivent donc séparer l’étiquette d’enregistrement du domaine de la localisation de son opérateur, de ses utilisateurs et de son infrastructure. Un nom en.brpeut être hébergé en Europe; un domaine de premier niveau générique peut servir une organisation locale. Compter les noms par suffixe n’équivaut pas à mesurer la dépendance nationale.
La réplication et des points de vue complémentaires peuvent tester la sensibilité géographique. Lorsque les résultats diffèrent, la différence est une donnée plutôt qu’un inconvénient à moyenner. Elle peut révéler une politique anycast, une localisation de contenu ou un blocage.
Le rôle d’intérêt public du projet est le plus fort lorsque les lacunes de couverture sont cartographiées explicitement. Les régions disposant d’accords de source plus faibles ne doivent pas disparaître dans un pourcentage mondial. Un enregistrement historique ne peut réduire l’inégalité des connaissances que si les utilisateurs savent où son instrument était moins capable de voir.
Des milliards de requêtes ne comptent que si leur contexte survit
Le pipeline de mesure transforme les listes cibles en requêtes planifiées. Les travailleurs émettent des demandes pour des types d’enregistrements définis, reçoivent des réponses, normalisent les champs et stockent les observations avec des horodatages et des métadonnées. À l’échelle rapportée par OpenINTEL — environ 5,9 milliards de points de données par jour — le défi opérationnel n’est pas d’envoyer un paquet DNS. C’est d’achever le cycle quotidien de manière fiable sans submerger l’infrastructure faisant autorité ni perdre les conditions derrière le résultat.
Les travailleurs ont besoin d’un contrôle du débit, d’une politique de nouvelle tentative et d’une identification claire de la source. Un délai d’attente peut signifier l’absence de service, une perte de paquets, une limitation du débit, une défaillance transitoire ou un blocage intentionnel. Réessayer de manière trop agressive peut créer le préjudice que le projet essaie d’éviter. Fournir aux opérateurs une explication publique et un chemin de contact rend le trafic responsable.
Les réponses doivent être analysées sur de nombreux types d’enregistrements et cas limites du DNS. Les noms peuvent contenir des encodages inhabituels. Les délégations peuvent être boiteuses ou cycliques. DNSSEC ajoute des signatures, des clés et des enregistrements de non-existence. La troncature peut faire passer une requête d’UDP à TCP. Les serveurs faisant autorité peuvent renvoyer des réponses différentes selon la localisation de la source. La normalisation doit préserver le sens sans transformer chaque paquet en un format ingérable.
Le système a également besoin d’une définition de l’achèvement. Une exécution quotidienne peut se terminer pour la plupart des cibles et en manquer un sous-ensemble. Stocker uniquement les réponses réussies rendrait l’absence invisible. Les chercheurs doivent savoir quelles requêtes ont été tentées, lesquelles ont échoué et si une panne de plateforme a affecté une période. Un enregistrement manquant ne devrait pas automatiquement devenir une preuve qu’un domaine l’a supprimé.
La page d’accueil d’OpenINTEL fait état de 13,6 billions de points de données cumulés depuis 2015. Ce chiffre communique l’échelle et reste rapporté par le projet. Sa valeur analytique dépend de la façon dont le « point de données » est défini selon les produits et le temps. Un décompte peut croître grâce à davantage de domaines, davantage de types d’enregistrements ou des observations plus fréquentes. Les utilisateurs devraient consulter la méthodologie du jeu de données pertinent plutôt que de comparer les totaux cumulés comme une simple mesure de la croissance du DNS.
À ce volume, les décisions d’ingénierie façonnent la recherche. Le partitionnement, la compression, les index et les formats de stockage déterminent quelles requêtes sont pratiques. Les migrations de données peuvent modifier la représentation. Les systèmes de contrôle qualité doivent identifier les exécutions incomplètes. L’archive est à la fois un instrument scientifique et une plateforme de données.
Le DNS direct révèle la configuration plutôt que le comportement applicatif
La mesure directe commence par un nom et demande des enregistrements sélectionnés. Les données de délégation peuvent montrer quels fournisseurs faisant autorité desservent le domaine. Les enregistrements d’adresse peuvent montrer des relations d’hébergement ou de CDN. Les enregistrements d’échange de messagerie exposent l’infrastructure de courrier électronique. Les enregistrements DNSSEC indiquent le déploiement et les choix d’algorithmes. D’autres types révèlent la configuration des services et des politiques.
Les observations répétées rendent les transitions visibles. Un domaine peut passer d’un fournisseur faisant autorité à un autre, ajouter IPv6, activer DNSSEC ou changer de service de messagerie. À grande échelle, les chercheurs peuvent estimer l’adoption et la concentration. Ils peuvent examiner si les changements se produisent progressivement ou autour d’un événement.
Un enregistrement renvoyé reste une observation à un moment et depuis un point de vue. Une adresse A ou AAAA ne prouve pas qu’un site web a répondu, que l’adresse a servi le même contenu aux utilisateurs ou que l’application était sécurisée. Un échange de messagerie ne prouve pas une livraison réussie. Une signature DNSSEC peut être présente alors que la validation échoue ailleurs. Les tests de la couche applicative nécessitent des méthodes distinctes.
Les CDN et l’anycast compliquent l’interprétation. Une réponse faisant autorité ou récursive peut varier selon la localisation de la source. Un domaine peut renvoyer des adresses sélectionnées pour le point de vue d’OpenINTEL plutôt que les adresses qu’un utilisateur d’une autre région reçoit. Les systèmes à horizon divisé donnent délibérément des réponses différentes aux clients internes et externes. La mesure du projet n’est pas fausse; c’est une vue parmi d’autres.
La mise en cache ajoute une autre distinction. Le système actif d’OpenINTEL peut interroger via des chemins de résolveurs définis ou une infrastructure faisant autorité selon le jeu de données. Il n’observe pas ce que chaque résolveur récursif a mis en cache. Un utilisateur peut recevoir une valeur antérieure jusqu’à l’expiration du TTL. Les changements dans l’archive peuvent précéder ou suivre les transitions visibles par les utilisateurs.
La valeur de la plateforme est la plus forte lorsque la question de recherche correspond à la méthode: comment les réponses DNS configurées observées par le projet ont changé. Elle s’affaiblit lorsque la réponse est utilisée comme indicateur de popularité, de succès applicatif ou d’expérience utilisateur sans preuves supplémentaires.
Le DNS inverse et les produits d’espace d’adressage relient le nommage à l’administration réseau
Le DNS inverse part d’une adresse IP et demande quel nom, le cas échéant, est associé par la hiérarchie in-addr.arpa ou ip6.arpa. OpenINTEL s’est étendu à la mesure inverse IPv4, créant une autre grande vue longitudinale. Le jeu de données peut révéler des schémas de nommage administratifs, des changements d’infrastructure et la présence d’enregistrements dans l’espace d’adressage.
Un enregistrement PTR n’est pas une preuve faisant autorité de qui utilise une adresse ou du service qu’elle fournit. Les détenteurs d’adresses peuvent laisser des enregistrements obsolètes, utiliser des noms génériques ou déléguer des zones inverses. Les réseaux cloud et d’accès peuvent appliquer un nommage systématique. Certaines adresses n’ont aucune entrée inverse. Les données sont utiles pour la classification et le changement, pas pour une carte d’identité universelle.
La mesure de l’espace inverse IPv4 est réalisable par rapport à IPv6 car la population d’adresses est plus petite et énumérable sous une politique définie. IPv6 est trop vaste pour un scan exhaustif adresse par adresse. La recherche doit utiliser des préfixes alloués, des adresses observées ou d’autres méthodes de sélection de cibles. Cette différence empêche de projeter la méthodologie IPv4 sur le nouveau protocole sans réserve.
Le projet publie également des produits au niveau des RIR et des préfixes réseau. Les listes temporelles de préfixes tentent de classer les préfixes réseau selon des observations définies. Ces listes peuvent soutenir l’échantillonnage de mesure et la recherche, mais elles ne constituent pas une hiérarchie objective de l’importance des réseaux. Un préfixe peut paraître important en raison de la construction de la liste et de la population de services. La valeur commerciale, le trafic et le nombre d’utilisateurs restent distincts.
Ces produits élargissent OpenINTEL d’un observatoire de domaines vers une plateforme de nommage et d’adressage. Ils augmentent également le besoin d’étiquettes soignées. L’« historique DNS » peut couvrir les enregistrements de domaines, les noms inverses, les cibles dérivées de certificats et les changements de zone inférés, chacun avec une population et une cadence différentes.
L’expansion est analytiquement précieuse car l’infrastructure Internet relie les noms, les adresses et les réseaux. Une migration d’hébergement peut apparaître dans les enregistrements directs et les relations de préfixes. Le nommage inverse peut fournir un contexte opérationnel. Les données RIR peuvent regrouper les observations. La connexion reste un cadre d’inférence plutôt qu’un registre complet de propriété.
Zonestream réduit l’écart entre les instantanés quotidiens et les changements intra-journaliers
Un scan quotidien enregistre un état large. Le DNS peut changer plusieurs fois entre les scans. Une campagne malveillante peut s’activer et disparaître. Un grand fournisseur peut migrer les enregistrements par étapes. Une erreur de configuration peut être introduite et corrigée avant la prochaine exécution planifiée.
Zonestream et les travaux connexes visent à fournir des preuves davantage orientées événements en inférant les changements de zone et en produisant des flux plus proches du moment du changement. L’approche complète l’archive quotidienne plutôt que de la remplacer. Un flux peut identifier des transitions rapides; le pipeline quotidien fournit des instantanés larges et cohérents.
Une mesure plus rapide crée des défis de charge et d’interprétation. Des requêtes plus fréquentes augmentent le trafic vers les opérateurs faisant autorité. Les changements dans une source de zone ne signifient pas toujours la même chose que les changements dans les réponses DNS observées. Un flux peut contenir des rafales provenant de la maintenance ou de systèmes automatisés. Les consommateurs doivent distinguer les événements bruts des transitions d’infrastructure significatives.
Le produit montre comment l’architecture d’OpenINTEL a évolué au-delà d’un processus par lots unique. Le projet a commencé par prouver qu’une énorme exécution quotidienne pouvait s’achever. Il a ensuite ajouté des moyens d’observer les changements à différentes résolutions temporelles. Cela élargit les cas d’usage tout en compliquant la comparabilité.
Les chercheurs doivent indiquer quelle cadence soutient une affirmation. Un jeu de données quotidien peut montrer qu’une configuration a différé entre deux dates. Un flux peut montrer une séquence intermédiaire. Ni l’un ni l’autre n’explique nécessairement pourquoi l’opérateur a agi. Leur combinaison avec des preuves de registre, de certificat ou d’incident peut renforcer le récit.
Zonestream augmente également l’importance opérationnelle de la disponibilité continue. Un scan quotidien manquant crée une lacune. Un flux d’événements défaillant peut perdre une séquence difficile à reconstruire. La redondance, la relecture et la surveillance font partie de la méthode de recherche.
Le stockage est la production la plus durable du projet et sa plus grande obligation
L’archive d’OpenINTEL est précieuse parce que le DNS d’hier ne peut pas être interrogé directement. Une fois qu’un état change et que les caches expirent, la mesure répétée peut être la seule preuve publique que le point de vue du projet l’a observé. Cela fait du stockage et de l’intégrité des données une infrastructure centrale.
Une archive à l’échelle d’une décennie nécessite plus que de la capacité. Elle a besoin de schémas versionnés, de sommes de contrôle, de réplication, de migrations documentées et d’un moyen de préserver la relation entre les observations et les méthodes. Une colonne renommée sans enregistrement de migration peut briser la reproductibilité. Un changement de compression peut améliorer le coût et compliquer les outils plus anciens. Une partition corrompue peut supprimer des preuves qu’aucun nouveau scan ne peut régénérer.
La rétention crée une pression financière. Des milliards de points quotidiens nécessitent du calcul, du réseau et du stockage. Les sources publiques ne divulguent pas un coût annuel consolidé. La charge est partagée entre les institutions partenaires et les programmes de financement. À mesure que l’archive grandit, le projet doit choisir entre conserver les détails bruts, produire des jeux de données dérivés et contrôler l’accès.
Le coût des requêtes est une autre contrainte. Un chercheur peut vouloir analyser des années d’enregistrements sur des millions de domaines. Autoriser des requêtes illimitées peut submerger la plateforme. Les produits téléchargeables et l’accès contrôlé répartissent le travail mais exigent que les utilisateurs stockent et traitent eux-mêmes les données. Des copies hébergées dans le cloud pourraient améliorer l’accès tout en créant des questions de coût et de gouvernance.
L’intégrité longitudinale dépend également de la préservation de l’absence. Un jour sans enregistrement peut signifier que le domaine n’avait pas la valeur, que la requête a échoué, que la cible n’était pas dans la liste ou que le pipeline était incomplet. L’archive a besoin de suffisamment de données de contrôle pour distinguer ces états. Sinon, une tendance peut être un artefact de l’instrumentation.
L’avenir du projet sera déterminé en partie par la volonté des institutions de continuer à financer ce travail invisible. Les nouveaux types d’enregistrements et les tableaux de bord attirent l’attention. La maintenance des anciens octets, de la documentation et du contexte crée l’actif historique. Si le stockage ou le personnel spécialisé sont perdus, la continuité de l’archive ne pourra pas être rachetée plus tard.
Quatre institutions partagent la plateforme sans budget visible unique
La résilience organisationnelle d’OpenINTEL provient du partenariat. L’Université de Twente fournit la direction académique et les chercheurs. SIDN apporte sa connaissance des registres et son soutien. NLnet Labs apporte une expertise logicielle et opérationnelle du DNS. SURF contribue à l’infrastructure nationale de recherche. La combinaison est plus forte qu’un projet dépendant d’un seul chercheur principal et d’une seule subvention.
Le modèle est également opaque en termes financiers conventionnels. Il n’y a pas de revenus, de dépenses ou d’effectifs consolidés du projet. Le matériel peut être financé par un partenaire, les chercheurs employés par un autre et la capacité réseau fournie par un troisième. Les pages publiques identifient les rôles mais ne fournissent pas de charte de vote unique ni de registre des actifs.
Cela ne rend pas le projet non gouverné. Les décisions passent par des relations institutionnelles et une équipe centrale. Cela signifie que des changements dans les priorités des partenaires peuvent affecter la plateforme sans apparaître comme un événement d’entreprise. Une subvention se termine, un serveur atteint l’âge de remplacement ou un spécialiste change de rôle. L’archive peut continuer tandis que la capacité de développement se réduit.
La concentration de l’expertise est un risque. Les systèmes de mesure de longue durée accumulent des connaissances sur les particularités, les migrations de données et les relations avec les opérateurs. La documentation et la succession sont aussi importantes que le nouveau code. Un partenariat ne peut répartir la charge que si plus d’une institution peut exploiter les composants critiques.
Le modèle façonne également la responsabilité envers les opérateurs mesurés. Une identité de projet visible et un contact pour les abus permettent aux fournisseurs faisant autorité de signaler un trafic excessif. Les partenaires ayant une position dans la communauté DNS peuvent négocier les problèmes. Le système doit préserver cette confiance à mesure que l’échelle et les produits se développent.
OpenINTEL est mieux décrit comme une infrastructure de recherche partagée. Son autorité provient de la qualité et de la continuité de ses preuves, et non d’une revendication statutaire sur le DNS. Il mesure un système distribué sous la tolérance d’organisations qui restent libres de le bloquer ou de le restreindre.
Les données ouvertes dépendent encore de contrats, de licences et d’un financement à long terme
OpenINTEL promeut l’accès à la recherche et publie les jeux de données éligibles sous licence CC BY-NC-SA 4.0. La licence exige l’attribution, restreint l’usage commercial et applique des conditions de partage dans les mêmes conditions. D’autres données restent contrôlées parce que des accords d’accès aux zones ou des contrats de source n’autorisent pas une redistribution sans restriction.
Cet arrangement peut décevoir les utilisateurs qui entendent « OpenINTEL » et supposent que chaque observation est librement téléchargeable à toutes fins. Le nom du projet décrit un engagement de recherche, pas la propriété de chaque entrée. Un registre peut autoriser la mesure sous conditions sans accorder le droit de republier l’intégralité de ses données dérivées de zone.
La restriction non commerciale soutient le partage académique et limite certaines réutilisations industrielles. Une entreprise peut avoir besoin d’un accord distinct pour un produit commercial. Le projet ne publie pas de licence commerciale universelle ni de prix. Les utilisateurs doivent contacter les opérateurs plutôt que supposer que les conditions d’accès peuvent être déduites des jeux de données ouverts.
Les données contrôlées peuvent encore soutenir la recherche par des demandes, des accords institutionnels ou des sorties dérivées. Le processus introduit des coûts de sélection et d’administration. Les chercheurs ayant des affiliations établies peuvent accéder plus facilement que les analystes indépendants. La reproductibilité est plus difficile lorsque le jeu de données sous-jacent ne peut pas être redistribué.
La tension est structurelle. La recherche DNS longitudinale bénéficie d’un large accès aux sources. Les registres et les opérateurs ont des préoccupations contractuelles, de sécurité et commerciales. Une plateforme qui violerait ces accords pourrait publier davantage à court terme et perdre l’accès futur. L’ouverture durable exige parfois une frontière documentée plutôt qu’une diffusion maximale.
Pour les utilisateurs de données, la bonne pratique est spécifique au jeu de données. Indiquez la source, la licence, la couverture et la condition d’accès. Ne décrivez pas les données contrôlées comme publiques. Ne supposez pas qu’une table dérivée ouverte contient l’archive sous-jacente complète. La gouvernance des données fait partie de la méthode.
Les jeux de données ouverts actuels utilisent une licence Creative Commons non commerciale, tandis que d’autres données restent contrôlées par des contrats de source. Cela soutient le travail académique et évite de supposer simplement que tout le contenu de l’archive est libre pour tout usage commercial.
Les analystes commerciaux peuvent vouloir des preuves DNS historiques pour la sécurité, l’étude de marché ou la diligence raisonnable. Leur demande pourrait aider à financer l’infrastructure et entrer en conflit avec les restrictions imposées par les registres et les attentes des opérateurs mesurés. Une voie payante devrait distinguer le service et le support des droits que le projet ne possède pas.
Les partenaires pourraient fournir des agrégats dérivés, des environnements de recherche contrôlés ou des licences négociées pour les données éligibles. Chaque modèle change qui peut reproduire un résultat. Un produit privé construit à partir d’une archive d’intérêt public peut générer de la valeur sans restituer les méthodes ou les correctifs.
La question de gouvernance n’est pas de savoir si l’usage commercial est bon ou mauvais. C’est de savoir si les accords de revenus préservent l’enregistrement longitudinal, respectent les droits des sources et évitent de rendre les données les plus complètes disponibles uniquement aux utilisateurs bien financés.
La durabilité d’OpenINTEL pourrait éventuellement exiger des niveaux d’accès plus formels. La crédibilité de ces niveaux dépendra de critères transparents et d’une base publique protégée. L’archive est devenue précieuse grâce à la recherche partagée. Financer son avenir ne devrait pas rendre son passé impossible à examiner.
Une réponse DNS enregistre une configuration, pas une intention ni un préjudice
Les grands jeux de données DNS invitent à des conclusions catégoriques. Un enregistrement pointe vers une adresse associée à un fournisseur, donc le domaine est dit y être hébergé. Un nom renvoie NXDOMAIN, donc il est déclaré inexistant. Un nom dérivé d’un certificat résout, donc le service est supposé actif. Chaque inférence peut être utile et erronée dans un cas particulier.
Une réponse DNS enregistre ce que l’infrastructure interrogée a renvoyé dans les conditions de mesure. Elle ne montre pas pourquoi l’opérateur l’a configurée. L’adresse peut être une redirection, un puits, une page parquée ou un bord CDN partagé. L’application peut rejeter le nom d’hôte. L’enregistrement peut être obsolète. Une panne serveur transitoire ou une limitation de débit peut produire une absence apparente.
NXDOMAIN signifie que le chemin DNS qui a répondu a affirmé la non-existence du nom interrogé dans son état actuel. Cela ne prouve pas que le nom n’a jamais existé ou n’existera pas plus tard. Les erreurs de délégation et les serveurs faisant autorité incohérents peuvent créer des résultats variables. Des observations répétées et des vérifications directes auprès de l’autorité améliorent la confiance.
L’analyse de sécurité exige encore plus de prudence. Les changements rapides de domaine ou d’adresse peuvent être associés à des abus et à des CDN, basculements et migrations légitimes. Un enregistrement ne prouve pas qu’un domaine est malveillant. L’étiquetage exige des preuves supplémentaires telles que le contenu, les relations de campagne, l’enregistrement et le comportement observé.
La demande des utilisateurs est entièrement en dehors de la mesure active. OpenINTEL génère ses propres requêtes. Il ne voit pas à quelle fréquence les utilisateurs demandent un nom, ce que servent les caches récursifs ou quelle réponse produit du trafic. Le DNS passif ou la télémétrie des résolveurs répondent à des questions différentes et portent des préoccupations de confidentialité différentes.
La culture analytique la plus forte du projet est celle qui traite ces frontières comme essentielles. Une énorme archive peut soutenir une meilleure inférence parce que les schémas et l’historique sont disponibles. Cela ne change pas le statut logique d’une observation. La mesure reste une entrée de l’explication, pas l’explication elle-même.
Une réponse NXDOMAIN peut indiquer qu’un nom n’existe pas dans la vue DNS pertinente. Un délai d’attente peut indiquer un serveur inaccessible, une limitation de débit, une perte de paquets ou un refus délibéré. Un SERVFAIL peut provenir de problèmes de validation, de délégation ou opérationnels transitoires.
L’analyse longitudinale doit préserver ces catégories au lieu de les réduire à « en panne ». Un domaine qui passe d’une réponse valide à NXDOMAIN a un historique différent de celui qui expire par intermittence. Un changement d’analyseur ou de stratégie de nouvelle tentative peut modifier la distribution mesurée sans qu’aucun opérateur ne change de configuration.
La distinction est particulièrement importante dans la recherche sur la sécurité et les politiques. Une absence de réponse n’est pas une preuve qu’un domaine a été supprimé ou censuré. Des points de vue supplémentaires, des requêtes auprès de l’autorité et des vérifications applicatives peuvent être nécessaires.
L’échelle d’OpenINTEL rend la classification des erreurs importante. Un petit choix méthodologique peut affecter des millions d’enregistrements. Le traitement soigné des preuves négatives est l’un des moyens les plus clairs pour le projet d’empêcher une vaste archive de produire des conclusions trop confiantes.
Les affirmations longitudinales dépendent de l’historique des méthodes et des observations manquantes
Un jeu de données à l’échelle d’une décennie contient deux histoires: l’histoire du DNS et l’histoire de l’instrument. Le matériel est remplacé, le logiciel d’interrogation change, les analyseurs sont corrigés et les accords de source s’étendent. Un type d’enregistrement ajouté en 2024 ne peut pas être comparé directement à une absence en 2018. Une nouvelle règle de nouvelle tentative peut améliorer l’achèvement tout en modifiant la probabilité qu’un serveur lent paraisse réactif.
Pour cette raison, le versionnage des méthodes fait partie des données. Chaque série d’observations doit être liée à la liste cible, au type de requête, au point de vue de mesure, à la version du logiciel et aux événements opérationnels connus. Les jours manquants nécessitent des indicateurs explicites. Un analyste ne doit pas inférer que des millions de domaines ont changé lorsqu’un cluster de travailleurs a échoué ou qu’un flux d’entrée est arrivé en retard.
Le problème devient plus difficile après une migration de stockage. Un nouveau schéma peut compresser des champs répétés, normaliser les noms différemment ou reclasser les erreurs. Ces changements peuvent rendre l’archive moins chère et plus facile à utiliser tout en modifiant les anciennes requêtes. La préservation des enregistrements sources bruts ou suffisamment détaillés, du code de migration et des échantillons de validation permet aux chercheurs de distinguer une tendance DNS d’une transformation de base de données.
La reproductibilité n’exige pas que toute la plateforme reste figée. Elle exige suffisamment de preuves pour reconstituer comment un résultat a été produit. Les travaux publiés doivent identifier la version du jeu de données ou la date d’accès, les filtres de population et le code. Lorsque les conditions contractuelles empêchent la redistribution des enregistrements bruts, les chercheurs peuvent toujours publier les méthodes, les agrégats et les contrôles de validation dans le cadre de l’accord.
Le partenariat d’OpenINTEL avec des chercheurs externes et les travaux de réplication est important ici. Une seconde implémentation ou une mesure indépendante ne produira pas des réponses identiques, mais les différences peuvent exposer des hypothèses. La réplication est particulièrement précieuse lorsque l’anycast, le blocage ou les licences de listes rendent un point de vue structurellement incomplet.
L’âge de l’archive augmente le coût d’un changement silencieux. Une correction d’analyse mineure appliquée rétroactivement peut modifier des années de données. Laisser l’erreur intacte peut perpétuer un défaut connu. L’approche responsable consiste à documenter la correction, à préserver l’état d’origine lorsque cela est possible et à préciser quelle version sous-tend un résultat.
C’est le travail peu glamour qui sépare l’infrastructure d’une collection de fichiers. Les billions de points de données rapportés par la plateforme ne comptent que si les futurs utilisateurs peuvent dire quels points appartiennent à la même comparaison. La science longitudinale est un exercice de préservation du contexte à la même échelle que les observations.
Le scan responsable doit rester visible pour les opérateurs qui en supportent le coût
La mesure active consomme des ressources en dehors du projet. Une requête DNS est petite, mais des milliards de requêtes atteignent des systèmes faisant autorité qui varient de grandes plateformes anycast à des serveurs modestes. Les contrôles de débit et la planification réduisent l’impact; ils ne rendent pas le coût nul. La base éthique du travail inclut donc la transparence et un chemin pratique pour que les opérateurs puissent s’opposer.
Une plateforme responsable utilise des adresses sources identifiables, publie une description de son trafic et surveille les canaux de contact. Elle doit honorer les demandes justifiées de réduction ou de blocage de la mesure et enquêter sur les signalements de charge inhabituelle. Ces mesures ne créent pas un consentement universel. Elles rendent le projet responsable d’une activité qui est techniquement possible sans autorisation préalable.
La charge n’est pas répartie uniformément. Un fournisseur fortement délégué peut recevoir des requêtes pour des millions de noms, tandis qu’un petit opérateur n’en voit que quelques-unes. Certains serveurs sont configurés pour limiter le débit du trafic inconnu, provoquant un échec de mesure apparent. D’autres peuvent renvoyer des réponses délibérément génériques. Un analyste doit reconnaître que la défense de l’opérateur modifie le jeu de données observé.
Le risque de confidentialité est différent de la journalisation passive des résolveurs. OpenINTEL génère des requêtes à partir de listes cibles et ne surveille pas les utilisateurs individuels. Cela limite fortement l’exposition au comportement des utilisateurs. L’archive peut néanmoins contenir des noms qui identifient des organisations, des appareils ou des services, y compris des sous-domaines dérivés des journaux de certificats. La publication d’enregistrements historiques détaillés peut rendre une infrastructure oubliée plus facile à trouver.
Les contrôles d’accès et les licences peuvent réduire les abus sans transformer chaque observation DNS en donnée confidentielle. La frontière appropriée dépend de la source, de la granularité et du risque. Des agrégats larges et des jeux de données de recherche peuvent être publiés en toute sécurité, tandis que les enregistrements bruts dérivés de zones restent contractuellement contrôlés. Un projet engagé en faveur de la science ouverte doit expliquer ces distinctions plutôt que de présenter l’accès comme tout ou rien.
L’examen éthique doit également tenir compte des affirmations en aval. Un article de recherche qui qualifie un domaine ou un pays d’insécurisé peut causer un préjudice de réputation alors que la mesure a en réalité capturé une erreur transitoire. Le projet ne peut pas contrôler chaque utilisateur, mais des avertissements clairs, des conditions et des exemples peuvent façonner de meilleures pratiques.
La légitimité d’OpenINTEL repose en partie sur le fait que les opérateurs mesurés peuvent voir qui demande. Cette visibilité doit rester une exigence de conception à mesure que les produits deviennent plus rapides et plus variés. Un observatoire gagne la tolérance du système qu’il observe en rendant son propre comportement ouvert à l’inspection.
DNS actif, DNS passif et scan général répondent à des questions différentes
OpenINTEL est parfois comparé aux bases de données DNS passives, aux scanners à l’échelle de l’Internet et aux systèmes de sondes distribuées. La comparaison n’est utile qu’après avoir séparé le modèle d’observation.
Le DNS passif recueille des enregistrements vus dans le trafic de requêtes réel au niveau des résolveurs récursifs ou d’autres points d’observation. Il peut révéler ce que les utilisateurs ou les systèmes ont demandé et quelles réponses ont été renvoyées par ces chemins. La couverture dépend des capteurs entités et soulève des problèmes de confidentialité et de contrat. Une base de données passive peut voir rapidement un domaine malveillant populaire tout en manquant un domaine discret qu’aucun utilisateur observé ne demande.
OpenINTEL choisit ses cibles et pose lui-même les questions. Il peut mesurer la même population chaque jour même lorsqu’aucun utilisateur ne visite les noms. Cette régularité soutient la comparaison longitudinale. Il ne peut pas inférer la popularité ou le comportement de cache à partir des requêtes actives. Les deux méthodes sont complémentaires: l’une reflète la demande observée chez des résolveurs sélectionnés, l’autre reflète les réponses configurées pour des cibles sélectionnées depuis des points de vue de mesure.
Un scanner tel que ZMap commence par des adresses et demande si un service répond, souvent suivi d’une poignée de main protocolaire. Il peut cartographier les services exposés sans dépendre de listes de domaines. La mesure DNS peut identifier des noms et des délégations qui pointent vers une infrastructure partagée, y compris des enregistrements dont les services sont inaccessibles. Là encore, les méthodes voient des surfaces différentes.
Une plateforme de sondes distribuées telle que RIPE Atlas peut poser des questions DNS depuis de nombreux réseaux et emplacements, révélant des différences géographiques et dépendantes du résolveur. OpenINTEL met l’accent sur l’ampleur, la répétition et l’échelle d’archive de son infrastructure de mesure. Une population plus petite depuis de nombreux points de vue peut répondre à une question qu’un vaste scan quotidien unique ne peut pas.
Ces distinctions évitent une erreur courante: traiter tous les grands jeux de données Internet comme des preuves interchangeables. Un domaine absent du DNS actif, invisible dans les données passives et inaccessible dans un scan d’adresses peut encore exister derrière un contrôle d’accès ou un nommage à horizon divisé. Un domaine observé par les trois méthodes a des preuves plus fortes de fonctionnement public, mais même cela n’établit pas qui l’a utilisé ni pourquoi.
L’opportunité stratégique n’est pas de construire une base de données universelle. C’est de relier les méthodes par des horodatages, des populations et des incertitudes explicites. OpenINTEL peut fournir la couche de nommage longitudinale dans ce système de preuves plus large. Sa valeur croît lorsque les analystes savent quelles questions nécessitent un autre instrument.
L’adoption de DNSSEC ne devient lisible que par des mesures répétées
DNSSEC est un exemple utile de la raison pour laquelle une archive quotidienne compte. Une zone peut publier des éléments de délégation, les serveurs faisant autorité peuvent servir des enregistrements signés et les validateurs peuvent décider si la chaîne résultante est sécurisée. Ces étapes n’évoluent pas nécessairement ensemble. Un registre de code pays peut activer les délégations signées tandis que de nombreux détenteurs de domaines restent non signés. Un domaine peut publier des clés mais échouer à la validation parce que les signatures expirent ou qu’un enregistrement parent est erroné.
Un scan d’une journée peut compter les états; il ne peut pas montrer comment les opérateurs y sont entrés, en sont sortis ou les ont réparés.
OpenINTEL peut suivre l’apparition et la disparition des enregistrements pertinents sur une population définie. Les chercheurs peuvent séparer les domaines qui restent non signés de ceux qui sont configurés par intermittence, identifier les changements autour des transitions d’algorithmes ou de clés et mesurer combien de temps les états brisés persistent. La méthode répétée transforme un pourcentage d’adoption en un ensemble de chemins opérationnels.
L’interprétation dépend toujours de la conception de la mesure. Voir des enregistrements DNSKEY ou DS n’est pas identique à effectuer chaque étape de validation exactement comme le ferait le résolveur récursif d’un utilisateur. Les réponses peuvent différer selon le point de vue, et un domaine peut être signé alors que son application reste indisponible. Un projet étudiant DNSSEC doit indiquer quels enregistrements, quelle logique de validation et quelles catégories d’erreurs il a utilisés. Les comparaisons entre années doivent tenir compte de la croissance des listes et des changements logiciels.
Ces qualifications rendent le résultat plus utile, et non moins. Les discussions sur les normes s’appuient souvent sur des chiffres d’adoption globaux qui masquent le coût de la maintenance. Les données longitudinales peuvent montrer si un changement produit une configuration durable, une poussée d’expérimentation ou un schéma d’échec récurrent. Elles peuvent distinguer un déploiement lent de celui qui a atteint un plateau parce que la population restante a des incitations différentes.
La même logique s’applique aux enregistrements IPv6, à la sécurité de la messagerie et à d’autres pratiques d’infrastructure. Une technologie n’est pas déployée simplement parce qu’un enregistrement est apparu une fois. Elle devient une infrastructure lorsque la configuration persiste, que les défaillances sont réparées et que les systèmes dépendants se comportent de manière cohérente. L’archive d’OpenINTEL peut révéler ces transitions parce qu’elle préserve suffisamment de preuves quotidiennes pour distinguer un événement d’une habitude.
Pour les opérateurs, cet historique peut être inconfortable. Un long enregistrement rend une mauvaise configuration répétée visible. Il peut également établir qu’un problème a été corrigé avant un incident ou une intervention politique. La mesure n’attribue pas d’intention, mais elle change la qualité de l’argument. La discussion passe du souvenir à des preuves datées.
La concentration des fournisseurs apparaît dans les schémas, tandis que la causalité reste en dehors du jeu de données
Le DNS peut exposer où l’infrastructure est concentrée. De nombreux domaines peuvent déléguer au même fournisseur faisant autorité, pointer la messagerie vers le même service ou résoudre des noms web dans un espace d’adressage associé à un petit ensemble de plateformes. Le suivi de ces relations au fil du temps peut montrer la consolidation, la migration et la dépendance qu’il serait difficile de reconstituer après un changement de marché.
OpenINTEL est bien adapté à la partie descriptive de ce travail. Des enregistrements répétés peuvent révéler que les domaines de serveurs de noms d’un fournisseur apparaissent dans une part croissante d’une population mesurée, qu’une acquisition est suivie d’un changement dans les schémas de nommage ou que des domaines s’éloignent après une panne. L’enrichissement par les adresses et les systèmes autonomes peut relier les noms à l’infrastructure réseau, sous réserve de l’exactitude et de la fraîcheur des données de routage.
L’archive ne peut pas expliquer chaque raison d’un déménagement. Un domaine peut utiliser un fournisseur en raison du prix, des performances, de la sécurité, d’un lot de bureau d’enregistrement ou d’une fusion organisationnelle. Une image de marque de serveurs de noms partagée peut masquer plusieurs infrastructures indépendantes. Une grande plateforme peut utiliser de nombreux systèmes autonomes, tandis qu’un système autonome peut héberger des clients sans lien. Les données DNS soutiennent une mesure de concentration; elles ne prouvent pas le pouvoir de marché ni la satisfaction des clients.
La conséquence politique est directe. Un régulateur peut être tenté de traiter une part mesurée élevée comme une preuve de contrôle nuisible. Un opérateur peut traiter la même part comme une preuve qu’un service a gagné la confiance. Le jeu de données peut établir le schéma et la date. Les conclusions économiques et juridiques nécessitent des contrats, des registres de propriété, des preuves de panne et des coûts de changement pour les utilisateurs.
La mesure longitudinale ajoute deux perspectives qu’un instantané de marché manque. Premièrement, elle peut montrer la vitesse de la concentration. Un lent mouvement décennal a des causes et des remèdes différents d’un changement soudain causé par le retrait d’un produit. Deuxièmement, elle peut montrer la réversibilité. Si les domaines changent fréquemment de fournisseur, un marché concentré peut encore avoir une mobilité pratique. Si les délégations persistent malgré des échecs répétés, la dépendance peut être plus profonde que ne le suggère la part globale.
L’historique peut également révéler un risque de mode commun caché. Les organisations peuvent croire qu’elles utilisent divers hébergeurs d’applications tout en déléguant le DNS, la messagerie et les certificats par la même famille de fournisseurs. Une défaillance dans cette couche partagée peut affecter des systèmes par ailleurs séparés. OpenINTEL ne modélise pas toute la chaîne de dépendance, mais il peut fournir la preuve de nommage à partir de laquelle une carte plus complète commence.
L’usage le plus responsable de l’archive est donc de traiter la concentration comme une structure observée puis d’enquêter sur le mécanisme. Une plateforme de mesure devrait rendre la dépendance visible sans prétendre qu’une liste d’enregistrements contient toute l’économie politique de l’Internet.
Certificats, enregistrements de messagerie et noms peuvent être reliés sans devenir un système unique
Le DNS n’opère pas de manière isolée. Les journaux de transparence des certificats exposent les noms soumis pour des certificats publics. Les enregistrements de messagerie identifient l’infrastructure d’échange et la politique. Les enregistrements d’adresse pointent vers les réseaux d’hébergement. Les noms inverses peuvent fournir des indices administratifs. Les produits sources d’OpenINTEL et ses requêtes répétées permettent d’examiner comment ces systèmes s’alignent au fil du temps.
Les noms dérivés des certificats élargissent la population observable au-delà des domaines apex disponibles dans une liste de zone. Ils peuvent révéler des sous-domaines de service et des noms temporaires qui comptent pour la recherche sur les PKI. La source est sélective: elle favorise les certificats enregistrés publiquement et inclut des noms qui n’ont peut-être jamais servi de trafic. Un certificat peut rester dans un journal après la disparition du service associé. La mesure DNS active ajoute une observation de configuration actuelle, pas une preuve que le certificat est installé ou approuvé par un navigateur.
Les enregistrements de messagerie créent une carte différente. Les cibles MX et les enregistrements TXT associés peuvent montrer le mouvement vers des fournisseurs de messagerie hébergés, l’adoption de politiques d’authentification et des erreurs de configuration. Des observations répétées peuvent identifier si une politique a été maintenue ou brièvement testée. Elles ne montrent pas le volume de messages, le succès de la livraison ni comment les systèmes récepteurs ont appliqué la politique.
Les enregistrements d’infrastructure peuvent également soutenir la reconstitution d’incidents. Si un domaine a changé de serveurs de noms, d’hôtes de messagerie et d’adresses dans une période étroite, les enquêteurs obtiennent une chronologie. La séquence peut refléter une migration légitime, une récupération après compromission ou une prise de contrôle. L’historique DNS réduit les questions; il n’étiquette pas l’événement.
La valeur vient de la jonction des preuves tout en préservant leur origine. Un journal de certificats, une zone, une réponse active et une table de routage ont chacun des horaires et des autorités différentes. Leur combinaison dans une analyse peut révéler une relation, mais la conclusion n’est aussi solide que la jonction la plus faible. Un nom réutilisé par plusieurs services, une adresse derrière une plateforme partagée ou un certificat obsolète peut créer une fausse association.
Le rôle d’OpenINTEL est le plus fort lorsqu’il garde ces jeux de données distinguables. Les chercheurs doivent pouvoir dire qu’un nom est entré dans la liste cible par un journal de certificats, a renvoyé un enregistrement particulier pendant la mesure active et a été mappé à un préfixe réseau sous une vue de routage datée séparément. Cette phrase est moins spectaculaire que de dire que la plateforme « connaît l’Internet », mais elle est reproductible.
Cette discipline multi-sources est aussi une défense contre la certitude rétrospective. Après un incident, les analystes cherchent naturellement une histoire dans les données. Une piste de mesure versionnée force l’histoire à respecter ce qui était observable à l’époque. Elle peut montrer que deux événements étaient corrélés sans prétendre que l’un a causé l’autre.
Les classements de préfixes étendent l’archive des noms vers les réseaux
Les listes temporelles de préfixes du projet illustrent comment OpenINTEL peut produire des produits dérivés plutôt que de simples réponses DNS brutes. Un classement de préfixes agrège des preuves au niveau du réseau et suit l’évolution de la proéminence au fil du temps. Cela peut aider les chercheurs à sélectionner des réseaux représentatifs, à étudier la concentration de l’infrastructure ou à comparer des cibles de mesure sans reconstruire les mêmes jointures pour chaque article.
Un préfixe n’est pas une organisation. Les annonces de routage peuvent changer, l’espace d’adressage peut être loué et un réseau peut héberger de nombreux services sans lien. Les classements dépendent des noms et des types d’enregistrements inclus, de la date des données de routage et de la métrique utilisée pour compter la proéminence. Une position élevée peut signifier un hébergement large, une infrastructure partagée ou un effet de sélection de liste.
La conception temporelle est la partie utile. Une liste statique devient rapidement obsolète à mesure que les services se déplacent et que le routage change. Des classements répétés peuvent montrer quand un réseau entre ou sort d’une position proéminente et permettent aux chercheurs de reproduire une population appropriée à une date antérieure. Ils exposent également l’instabilité qu’une liste unique de « meilleurs réseaux » dissimulerait.
Les jeux de données dérivés réduisent le coût de la recherche. Ils peuvent rendre une analyse d’infrastructure sophistiquée accessible à des équipes sans le stockage et le calcul nécessaires pour traiter l’archive complète. Cet avantage augmente la responsabilité du projet de publier la méthodologie et le versionnage. Les utilisateurs peuvent traiter un classement pratique comme une vérité de terrain objective alors qu’il s’agit d’une vue produite à partir d’entrées sélectionnées.
L’expansion vers des produits au niveau du réseau ne transforme pas OpenINTEL en observatoire de routage ni en RIR. Il utilise le contexte public de registre et de routage pour enrichir les observations DNS. La validité des routes, les litiges de propriété et la performance opérationnelle restent des questions distinctes.
Cette frontière est stratégiquement saine. Le projet peut offrir des preuves dérivées communes sans revendiquer d’autorité sur les entités qu’il classe. Le produit est le plus précieux lorsqu’il économise du travail de calcul tout en laissant le jugement analytique visible.
La recherche en sécurité gagne une chronologie plutôt qu’un verdict sur la malveillance
Les données DNS historiques attirent les équipes de sécurité car l’infrastructure d’abus se déplace souvent. Un domaine peut faire tourner des adresses, des serveurs de noms ou des systèmes de messagerie; une campagne peut réutiliser des fournisseurs; un incident peut être découvert après que la configuration pertinente a changé. OpenINTEL peut fournir des observations datées qui rendent ces transitions récupérables.
Ces preuves sont particulièrement utiles pour la délimitation. Les enquêteurs peuvent demander quand un domaine suspect est apparu pour la première fois dans une liste mesurée, si son service faisant autorité a changé autour d’un événement et quels autres noms partageaient la même infrastructure à ce moment-là. Un chercheur en sécurité peut utiliser ces relations pour générer des hypothèses et choisir les systèmes qui nécessitent un examen plus approfondi.
Aucun des enregistrements n’établit la malveillance par lui-même. Des changements rapides peuvent être un signe d’évasion, mais ils se produisent également dans les réseaux de diffusion de contenu, la reprise après sinistre et les migrations légitimes. L’hébergement partagé place des domaines bénins et nuisibles sur la même adresse. Une association de serveurs de noms peut refléter un défaut de bureau d’enregistrement plutôt qu’un contrôle commun. Même un schéma qui ressemble fortement à une campagne connue nécessite une corroboration par le contenu, l’enregistrement, les logiciels malveillants, la télémétrie ou des preuves juridiques.
Cette distinction compte parce que les jeux de données historiques peuvent faire paraître les associations plus durables qu’elles ne l’étaient. Un domaine qui a partagé une adresse pendant un jour peut être regroupé avec un autre pendant des années dans la base de données dérivée d’un analyste. Les fenêtres temporelles et la confiance devraient voyager avec la relation. Il en va de même pour la population source: un sous-domaine dérivé d’un certificat et un nom apex de zone de registre ne sont pas entrés dans l’archive de la même manière.
Le rôle d’OpenINTEL est de préserver les faits d’infrastructure qui pourraient autrement disparaître. L’étiquetage, l’attribution et la réponse relèvent de processus distincts. Le travail de sécurité est le plus fort lorsque l’archive réduit l’incertitude sans qu’on lui demande de résoudre l’intention.
L’archive rend le changement d’infrastructure contestable
Chaque jour de mesure ajoute de la valeur opérationnelle et une obligation de stockage. Le projet doit maintenir la capacité d’interrogation, remplacer le matériel, migrer les bases de données et garder des spécialistes qui comprennent à la fois le DNS et l’historique du système. Aucune de ces tâches n’est garantie simplement parce que l’archive est devenue importante.
Le modèle à quatre partenaires répartit le risque, mais il rend aussi la durabilité plus difficile à lire de l’extérieur. Une institution peut financer le personnel, une autre le calcul et une autre l’accès aux données sources. Un changement dans n’importe quel composant peut réduire la couverture sans annonce d’entreprise conventionnelle. Les comptes financiers publics du projet dans son ensemble ne sont pas disponibles, donc les utilisateurs doivent surveiller les signaux techniques et institutionnels plutôt que supposer la continuité.
La gestion de l’archive exige une redondance au-delà des sauvegardes. Une copie répliquée doit inclure les schémas, les enregistrements de méthodes, les versions des listes de sources et les connaissances nécessaires pour interpréter les anomalies. Un tas de fichiers sur un autre site n’est pas un instrument historique fonctionnel. La collaboration avec des organisations telles que CAIDA peut améliorer la résilience et la comparaison méthodologique, bien que les données contractuelles puissent limiter ce qui peut être copié.
Le modèle de licence façonne également l’avenir. L’accès ouvert non commercial soutient la réutilisation académique mais restreint certaines applications commerciales. Les données de zone contrôlées ne peuvent pas simplement être publiées sous une licence plus large. Les partenaires peuvent avoir besoin d’accords de financement qui préservent l’accès à la recherche tout en récupérant le coût réel du stockage et du support. Une voie commerciale, si elle est développée, ne devrait pas rétrécir silencieusement l’enregistrement public sur lequel repose la légitimité du projet.
Le succès lui-même peut créer de la fragilité. À mesure que davantage d’articles et d’affirmations politiques dépendent d’OpenINTEL, une période manquante ou un jeu de données modifié affecte une communauté plus large. Le projet peut avoir besoin d’enregistrements de publication plus formels, d’attentes de service et d’une politique de préservation qu’un système de recherche ne publie normalement pas. Ce ne sont pas des signes qu’il devrait devenir une entreprise. Ce sont des signes qu’il est devenu une infrastructure.
Le jalon futur le plus précieux pourrait être celui qui ne produit aucun titre: une migration transparente vers un nouveau stockage avec les anciens résultats, avertissements et chemins d’accès intacts. OpenINTEL a déjà montré qu’il peut mesurer à une échelle remarquable. Le test le plus difficile est de savoir si les organisations qui le soutiennent peuvent préserver les conditions qui rendent dix ans de mesures comparables aux dix prochaines.
OpenINTEL ne peut pas raconter toute l’histoire du DNS. Il peut montrer qu’un nom défini a renvoyé une réponse définie depuis son point de vue à une date, et il peut répéter cette observation sur d’énormes populations. Cela suffit à transformer de nombreuses affirmations.
Un fournisseur peut dire que l’adoption de DNSSEC a augmenté; l’archive peut montrer la transition mesurée et la population. Un chercheur peut affirmer que l’hébergement faisant autorité s’est concentré; les données peuvent révéler quelles listes et périodes le soutiennent. Un enquêteur d’incident peut reconstituer quand un enregistrement a changé. Un autre analyste peut contester la méthodologie plutôt que d’accepter une capture d’écran.
L’échelle du projet est frappante: des centaines de millions de domaines, des milliards de points quotidiens et des billions d’observations cumulées selon ses propres métriques actuelles. La réalisation la plus importante est la continuité à travers les changements institutionnels et techniques. L’archive rend le passé du DNS disponible comme preuve plutôt que comme mémoire.
Cette preuve reste délimitée par les listes, les contrats, les points de vue et les méthodes. La crédibilité d’OpenINTEL vient de la préservation de ces frontières. Le qualifier de copie complète du DNS surestimerait le projet et affaiblirait l’utilité de son véritable enregistrement.
Un observatoire historique n’a pas besoin de tout voir. Il doit indiquer ce qu’il a vu, préserver les conditions et rester disponible assez longtemps pour que le changement soit mesuré. OpenINTEL a construit ce type d’instrument pour l’infrastructure de nommage. Son prochain défi est de s’assurer que l’archive et les institutions qui la soutiennent restent aussi durables que les tendances que les chercheurs espèrent étudier.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance