
Résumé
- Cloudflare a attribué la panne du 21 juin 2022 à une modification de configuration de son réseau central et a indiqué que 19 centres de données avaient été touchés ; ce nombre reste une déclaration de l’entreprise, non une vérification indépendante.
- Le rollback a restauré le service, tandis que les mesures ultérieures de redondance, de validation, de test et de déploiement progressif sont décrites comme des travaux destinés à réduire le rayon d’explosion, sans que les sources examinées établissent leur achèvement.
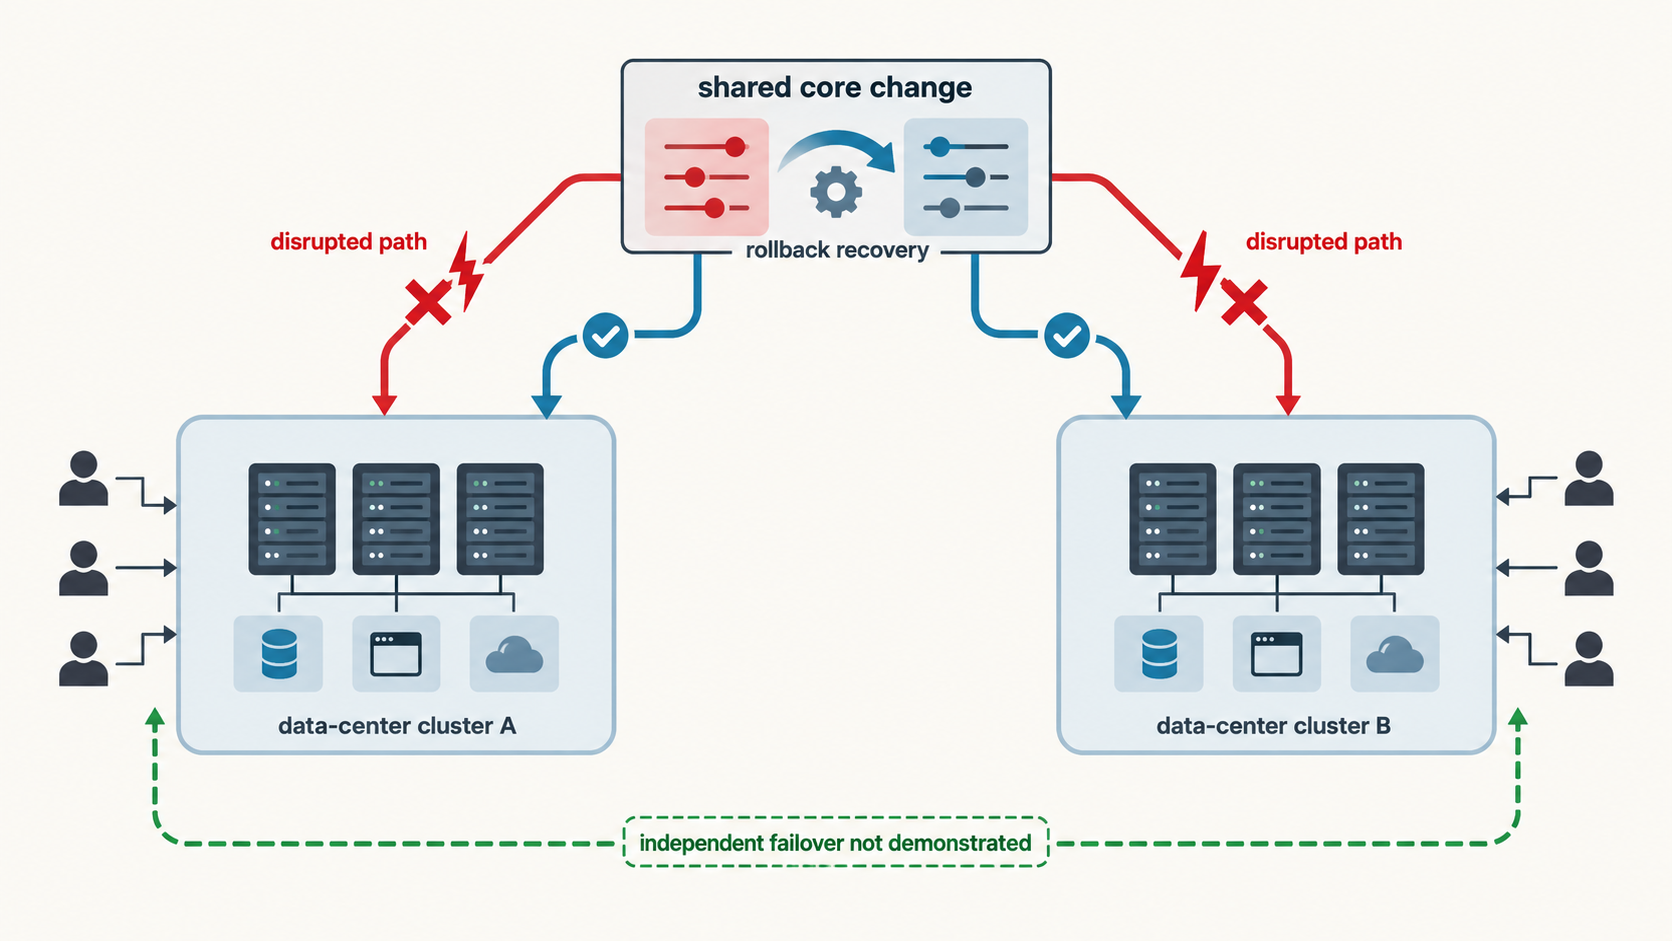
Le problème à retenir n’est pas seulement qu’une modification a mal tourné. C’est qu’une modification située sur une surface commune peut traverser des frontières géographiques que les utilisateurs considèrent comme des séparations. La récupération peut alors être rapide dès que l’opérateur connaît la cause et sait annuler le changement ; elle ne prouve pas que les sites auraient continué à fonctionner par une voie indépendante.
Une panne locale dans son déclencheur, commune dans sa portée
Dans son postmortem sur la panne du 21 juin 2022, Cloudflare attribue la perturbation à une modification de configuration de son réseau central. Le même document indique que 19 centres de données ont été affectés. Le dossier public disponible ne permet pas de vérifier séparément ce décompte, ni de reconstruire avec précision la chronologie technique de chaque site. Il faut donc présenter ces éléments comme le récit et le périmètre rapportés par Cloudflare, plutôt que comme une mesure indépendante.
La distinction est importante. Un centre de données est une localisation physique ; il ne constitue pas automatiquement un domaine de défaillance indépendant. Plusieurs sites peuvent partager une politique, une chaîne de validation, un transport ou une autre fonction de contrôle. Si cette fonction commune est modifiée de façon erronée, la distance entre les sites ne suffit plus à contenir l’incident.
Cette conclusion ne permet pas d’affirmer que Cloudflare ne possédait aucune séparation entre ses sites. Elle établit une question plus précise : la séparation pertinente se trouvait-elle au même endroit que la modification qui a propagé le défaut ? Le compte rendu public ne fournit pas, dans les éléments cités ici, la preuve d’un chemin de contrôle entièrement indépendant qui aurait continué à servir le trafic.
L’impact vu depuis les services dépendants
La panne n’est pas restée une anomalie interne. Le compte rendu contemporain de BleepingComputer décrit une perturbation étendue touchant Discord, Shopify et d’autres services dépendants de Cloudflare. Cette source confirme la visibilité de l’incident pour les utilisateurs et les applications, mais elle ne permet pas d’établir le mécanisme interne décrit par Cloudflare ni l’état ultérieur de ses mesures de résilience.
Pour un client, la différence entre une panne dans un produit et une panne sur une couche partagée est opérationnelle. Le premier cas peut appeler un contournement limité à ce service. Le second peut rendre simultanément indisponibles plusieurs applications qui avaient pourtant réparti leurs requêtes entre des lieux ou des composants différents. La géographie déclarée dans une architecture client ne vaut donc pas, à elle seule, preuve d’une indépendance de fournisseur.
Le rollback est une récupération, pas un test de basculement
Cloudflare indique que ses ingénieurs ont restauré le service en revenant sur la configuration à l’origine de la panne. Cette action est cohérente avec une défaillance causée par un changement identifié : elle retire la nouvelle condition et rétablit le comportement antérieur. Elle montre que l’organisation conservait un moyen d’action sur la surface commune et qu’elle a pu l’utiliser pour récupérer le service.
Mais un rollback répond à une question différente de celle d’un basculement indépendant. Il demande si l’état précédent peut être réinstallé. Un basculement demande si une autre voie, un autre contrôle ou une autre équipe peut prendre le relais sans dépendre de l’élément défaillant. Dans le premier cas, l’opérateur restaure le centre de gravité existant ; dans le second, il doit démontrer qu’un centre de gravité distinct peut fonctionner.
Le récit de BleepingComputer rend cette distinction concrète du point de vue des services affectés : une reprise du réseau commun peut faire revenir de nombreuses applications en même temps, mais cela ne dit pas si ces applications auraient pu continuer sans cette reprise. La restauration observée est donc une preuve de récupération par correction, non une preuve de continuité par indépendance.
Ce qui était annoncé, et ce qui n’est pas démontré
Cloudflare décrit ensuite des travaux visant à accroître la redondance du réseau central, à renforcer la validation et les tests, et à déployer les changements par étapes afin de réduire leur rayon d’explosion. Ces mesures sont pertinentes parce qu’elles s’attaquent à trois surfaces différentes : le nombre de chemins disponibles, la détection avant mise en production et la taille de la population exposée par un changement.
Le langage de la source les présente toutefois comme des actions de suivi destinées à améliorer le système. Il ne suffit pas à prouver qu’elles ont toutes été mises en œuvre, testées en production ou démontrées efficaces dans un incident ultérieur. Le postmortem de Cloudflare soutient donc une distinction que les opérateurs devraient conserver : le rollback est décrit comme l’action de récupération ; la redondance, la validation, les tests et le déploiement progressif relèvent de mesures annoncées ou planifiées dont l’achèvement n’est pas établi par le dossier cité.
Cette limite n’est pas une réserve de forme. Elle sépare une capacité observée d’une promesse de réduction du rayon d’explosion. Pour conclure à la résilience, il faudrait pouvoir montrer quels contrôles étaient effectivement en place, quelles dépendances ils évitaient et comment ils avaient été testés face à une modification commune.
Ce que cette panne change dans le diagnostic
La bonne question n’est pas seulement : combien de centres de données sont tombés ? Il faut aussi demander quelle fonction les reliait au moment du changement, qui pouvait la modifier, qui pouvait l’annuler et quelle partie du système restait indépendante pendant l’incident.
Pour Cloudflare, le contrôle direct portait sur la configuration de son réseau central, la décision de revenir en arrière et les garde-fous décrits dans son postmortem. Pour les clients, le contrôle portait sur les reprises applicatives, la surveillance de leurs dépendances et la possibilité de prévoir un autre fournisseur ou un autre chemin. Aucun de ces contrôles ne remplace l’autre : une entreprise peut améliorer son rollback tout en restant dépendante du rétablissement du fournisseur, et un client peut prévoir un fournisseur secondaire sans savoir si son trafic de secours empruntera une dépendance commune.
La leçon du 21 juin 2022 est ainsi bornée mais utile. Une configuration commune peut donner à une architecture distribuée une portée de panne supérieure à celle que suggèrent ses cartes géographiques. Le rollback peut faire disparaître rapidement le symptôme. La résilience, elle, commence seulement lorsque l’on peut montrer que le prochain changement ne pourra pas atteindre tous les chemins par la même surface de contrôle.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance