
Résumé
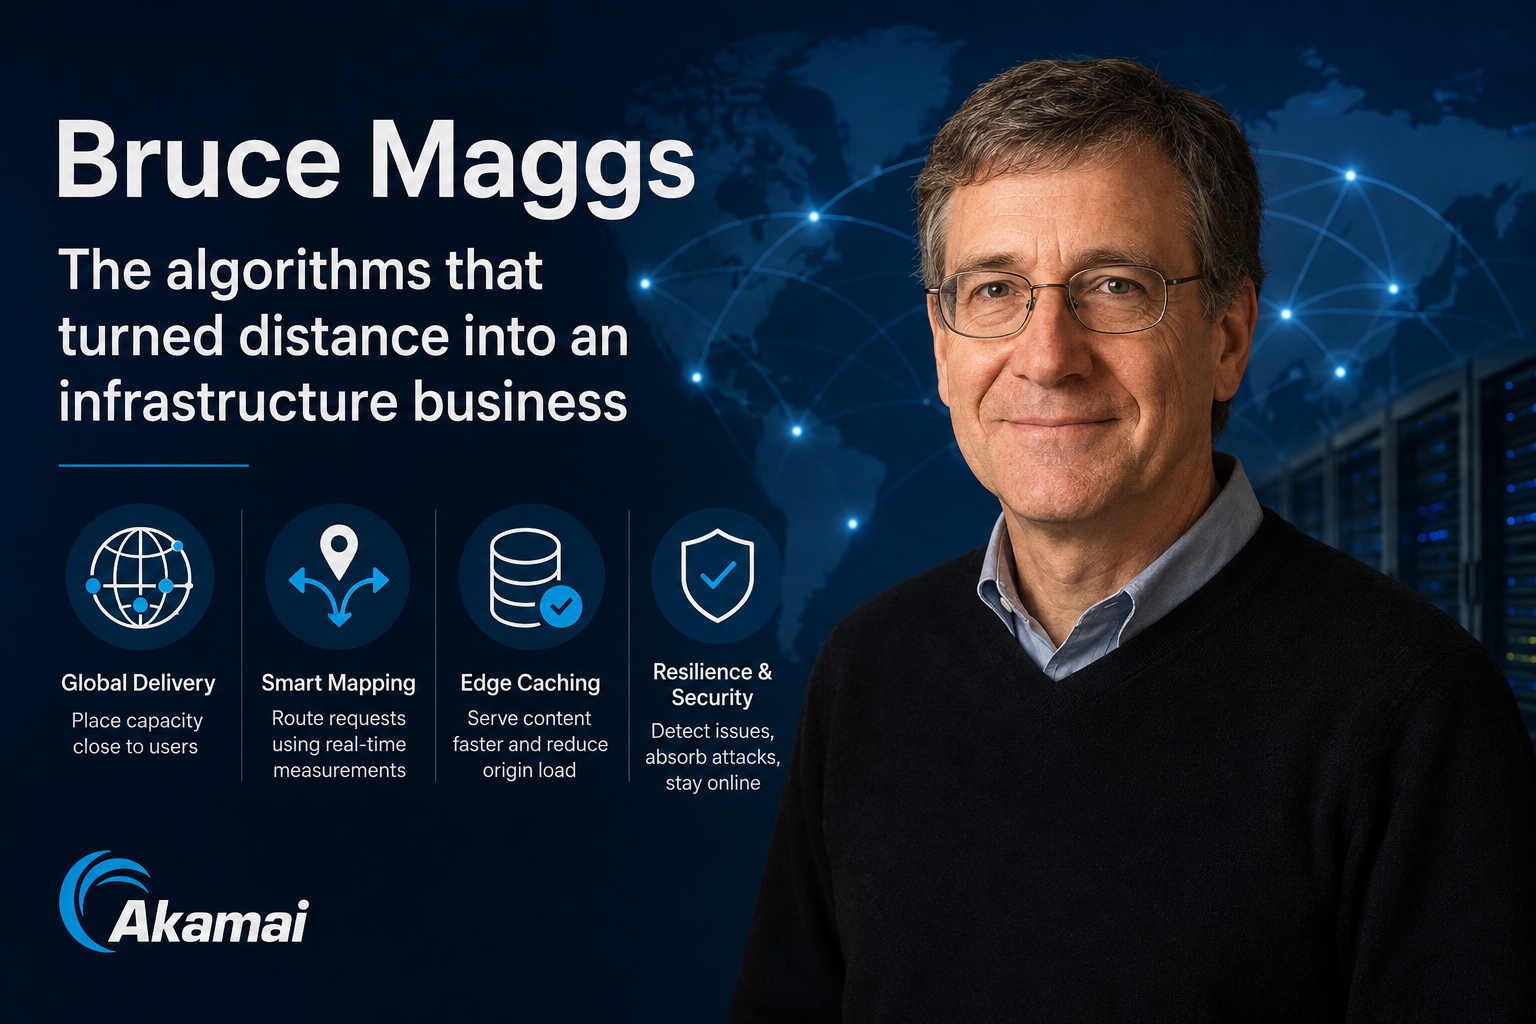
- Bruce Maggs a été un employé fondateur d’Akamai et vice-président de la recherche et du développement au sein de l’équipe qui a transformé la diffusion distribuée en infrastructure commerciale.
- Le problème d’Akamai consistait à placer la capacité, à mapper les requêtes, à maintenir des affectations stables, à protéger les serveurs d’origine et à contourner les pannes sur des réseaux qu’elle ne possédait pas.
- Les travaux de recherche menés en collaboration par Maggs ont relié le hachage cohérent et l’affectation stable aux afflux massifs, à la mesure, à l’efficacité du cache, à la sécurité et au traitement des pannes en périphérie.
- Ses rôles ultérieurs à Duke et chez Emerald Innovations prolongent le modèle des systèmes distribués, tandis que les allégations actuelles concernant les produits, la propriété et les aspects cliniques restent distinctes de sa contribution individuelle.
Les sites populaires n’avaient nulle part où se cacher face à leur propre succès
Le web commercial naissant a révélé une faiblesse structurelle dans la manière dont le contenu était servi. Un éditeur ou un éditeur de logiciels pouvait exploiter un site d’origine performant et échouer malgré tout lorsque la demande provenait de trop d’endroits à la fois. Chaque requête voyageait vers un ensemble relativement restreint de serveurs. Les longs trajets ajoutaient de la latence. La congestion et la perte de paquets réduisaient le débit. Un événement d’actualité soudain ou la sortie d’un logiciel pouvait créer un afflux massif qui épuisait le serveur d’origine précisément au moment où le contenu importait le plus.
L’achat d’un serveur plus puissant ne résolvait qu’une partie du problème. Le chemin réseau entre l’utilisateur et le serveur d’origine restait long et variable. Un site unique concentrait les pannes. La réplication manuelle du site entre plusieurs régions soulevait des questions de cohérence, de nommage, de capacité et d’exploitation. Le système de routage de l’internet pouvait acheminer les paquets, mais il ne choisissait pas une copie applicative en fonction de la charge actuelle, des performances observées ou des besoins d’un objet particulier.
Un réseau de diffusion de contenu insérait une couche d’exploitation entre le serveur d’origine et l’utilisateur. Des copies pouvaient être placées dans de nombreux réseaux. Un système de mappage pouvait orienter une requête vers un serveur approprié. Les caches pouvaient absorber la demande répétée et réduire le travail à l’origine. La mesure pouvait identifier les pannes et les chemins changeants. L’opportunité économique tenait à la latence et à la résilience, mais le produit était un système de contrôle distribué.
Bruce Maggs a abordé ce problème depuis l’informatique théorique et les systèmes distribués. Il n’a pas été le seul inventeur du CDN, et Akamai n’a pas été bâtie par une seule personne. Tom Leighton et Danny Lewin ont fondé l’entreprise. Les premiers articles d’architecture citent John Dilley, Jay Parikh, Harald Prokop, Ramesh Sitaraman, William Weihl et d’autres collaborateurs. Les ventes, l’exploitation, le financement et les relations clients étaient tout aussi collectifs.
L’importance de Maggs tient à un rôle plus précis: il a été un employé fondateur et un des premiers responsables de la recherche-développement à l’époque où les algorithmes ont dû devenir un service fonctionnant en continu sur des réseaux qu’Akamai ne possédait pas.
Cette transformation a changé ce qui comptait comme un algorithme réussi. Un schéma de placement pouvait être élégant sur le papier et échouer s’il exigeait trop d’état, déplaçait les objets constamment ou ne tolérait pas des mesures incomplètes. Une décision de mappage pouvait minimiser la distance estimée et surcharger un cluster. Une politique de cache pouvait améliorer le taux de succès tout en servant un contenu obsolète ou en augmentant la complexité à l’origine. La production exigeait des mécanismes qui restaient stables pendant que la demande, le routage et l’état des machines changeaient sous eux.
Cette histoire est utile parce que les infrastructures modernes connaissent toujours la même conversion. Les prototypes de recherche optimisent un objectif défini. Les systèmes commerciaux fonctionnent avec des objectifs contradictoires, des entrées incertaines et des clients qui vivent la panne comme une défaillance du service. La carrière de Maggs appartient à la génération qui a appris à faire de ces contraintes une partie de l’algorithme plutôt qu’un détail d’implémentation.
La recherche sur les systèmes partagés a préparé Maggs à une infrastructure sans centre unique
Maggs a obtenu trois diplômes au Massachusetts Institute of Technology et a ensuite occupé des postes de recherche et d’enseignement au NEC Research Institute et à Carnegie Mellon University. Ses premiers travaux portaient notamment sur les systèmes multijoueurs et distribués, dont l’environnement Avatar. Ces travaux ne sont pas un ancêtre direct de la plateforme d’Akamai, mais ils l’ont placé dans des systèmes où de nombreux entités agissent sur un état partagé et où la latence, la cohérence et les pannes façonnent l’expérience utilisateur.
La théorie de l’informatique distribuée demande souvent où doit vivre l’état, comment les entités le trouvent et ce qui se passe lorsque les composants changent. Ces questions deviennent opérationnellement aiguës dans une plateforme de diffusion mondiale. Aucun contrôleur central ne peut inspecter chaque chemin en temps réel. Les serveurs tombent en panne et récupèrent. La demande se déplace entre les objets et les régions. Les caches DNS conservent des décisions antérieures. Le système doit continuer à servir alors que sa propre vision est incomplète.
Le parcours universitaire de Maggs comptait aussi parce que la proposition initiale d’Akamai reposait sur la confiance algorithmique. L’entreprise devait convaincre clients et investisseurs qu’une plateforme dispersée pouvait se comporter de manière cohérente plutôt que comme un ensemble de miroirs gérés de façon lâche. Les modèles formels et les résultats expérimentaux ne remplaçaient pas l’exploitation, mais ils offraient un moyen de raisonner sur l’échelle avant que chaque mode de défaillance ne soit apparu en production.
Le passage du travail universitaire à une start-up a changé l’unité de responsabilité. Un article peut énoncer des hypothèses et rapporter des résultats dans un environnement de test. Un service doit détecter quand les hypothèses ne tiennent plus. Il doit exposer suffisamment de télémétrie pour que les ingénieurs sachent si le mappage, le cache, les conditions réseau ou les serveurs d’origine sont en cause. Il doit déployer des changements sans déstabiliser le trafic. Il doit expliquer une panne à un client dont l’application peut générer la demande même qui l’a déclenchée.
Maggs a rejoint Akamai en 1998, près du début du développement commercial de l’entreprise, et a exercé les fonctions de vice-président de la recherche et du développement. « Employé fondateur » est la description exacte; elle ne doit pas être confondue avec celle de fondateur de l’entreprise. Cette distinction préserve à la fois son rôle et les contributions de Leighton, Lewin et de l’équipe élargie.
L’environnement des premières années de l’entreprise mettait en contact étroit la recherche et l’exploitation. Un algorithme pouvait être testé sur un internet réel et changeant. Les données de production révélaient des schémas qu’une charge de laboratoire manquait. Les exigences des clients créaient de nouvelles contraintes. Cette boucle de rétroaction est devenue l’un des avantages d’Akamai et l’une des raisons pour lesquelles ses publications techniques restent utiles: elles documentent des mécanismes développés sous la pression opérationnelle plutôt qu’un simple CDN conceptuel.
La première architecture d’Akamai était un système de contrôle réparti sur les réseaux d’autrui
Un CDN mondial exige une portée physique, mais la portée seule ne crée pas un service. Akamai a placé des grappes de serveurs dans de nombreux réseaux et installations. Ces machines stockaient ou allaient chercher le contenu des clients. La tâche la plus difficile consistait à décider quelle grappe devait répondre à chaque requête et à maintenir cette décision utile à mesure que les conditions changeaient.
La première architecture décrite dans les publications communes séparait plusieurs fonctions. Une plateforme distribuée surveillait les serveurs et les réseaux. Un système de mappage utilisait le DNS et d’autres signaux pour orienter les clients. Les mécanismes de cache et de gestion des objets décidaient ce qui devait être stocké et quand le serveur d’origine devait être contacté. Les systèmes de gestion de charge évitaient d’envoyer trop de demande vers un seul emplacement. Le contrôle opérationnel distribuait les logiciels et la configuration sur l’ensemble du parc.
Cette architecture se situe au-dessus du routage internet plutôt que de le remplacer. BGP détermine les chemins réseau disponibles selon la politique des opérateurs. Un CDN peut choisir parmi des emplacements déployés et influencer la destination qu’un utilisateur résout, mais les paquets circulent toujours sur des routes choisies par les réseaux. Akamai devait donc travailler avec des informations incomplètes sur des chemins qu’elle ne contrôlait pas.
Le DNS était une surface de contrôle pratique parce que les applications s’appuyaient déjà sur lui. Le système de mappage pouvait renvoyer des adresses associées à un emplacement périphérique choisi. Les résolveurs récursifs représentaient cependant parfois de nombreux utilisateurs et pouvaient en être éloignés. La mise en cache signifiait qu’une décision persistait un certain temps. L’anycast, les changements de route et l’espace d’adressage partagé compliquaient l’inférence de localisation. Le système devait prendre des décisions suffisamment bonnes de manière répétée plutôt que de supposer des coordonnées client parfaites.
Les serveurs devaient aussi rester suffisamment interchangeables sur le plan opérationnel pour que le système de contrôle puisse déplacer le trafic. Les versions logicielles, les configurations clients et l’état du contenu exigeaient une coordination. Un cluster géographiquement proche mais surchargé ou en mauvaise santé n’était pas une destination utile. Un cluster un peu plus éloigné mais doté de capacité disponible et d’un meilleur chemin pouvait livrer plus vite. « Le plus proche » était un résultat de la mesure et de la politique, pas un simple calcul de distance.
La nature distribuée de la plateforme améliorait la résilience mais créait une nouvelle concentration. Les clients dépendaient du mappage, des logiciels et du jugement opérationnel d’Akamai. Le CDN devenait un intermédiaire avec une visibilité sur les requêtes et le pouvoir de rediriger le trafic. Ce rôle s’élargirait plus tard aux services de sécurité. L’architecture réduisait la dépendance à une origine unique tout en augmentant la dépendance à la couche de diffusion.
La contribution de recherche de Maggs se comprend mieux dans cet ensemble. Il a contribué à expliquer et à développer les algorithmes qui permettaient au placement et au mappage de se comporter de manière prévisible. Le système commercial exigeait beaucoup plus de fonctions, mais ces algorithmes déterminaient si une large empreinte se traduisait en capacité utile ou simplement en machines éparpillées sur l’internet.
Le placement transforme un algorithme en décision d’investissement
Un CDN ne peut pas déployer un serveur dans chaque réseau ou emplacement possible. Il doit choisir où une capacité supplémentaire réduira suffisamment la latence, la charge d’origine et les coûts de transit pour justifier l’équipement et l’exploitation. Le placement combine donc des problèmes de graphes, de prévision du trafic et de négociation commerciale.
Une formulation théorique peut demander quel ensemble d’emplacements minimise la distance jusqu’à la demande sous une contrainte de capacité. La production complique chaque terme. La demande change selon le moment et l’objet. La distance réseau n’est pas la distance géographique. Une installation peut offrir une bonne connectivité mais une économie ou un support médiocres. Un serveur peut être proche des utilisateurs tout en étant atteint par un chemin politique indirect. Un déploiement dans un réseau d’accès peut améliorer les performances tout en créant une dépendance à l’alimentation, au routage et à la maintenance de cet opérateur.
Maggs et ses collaborateurs ont travaillé sur les questions de placement et d’affectation dans le cadre plus large du programme de recherche d’Akamai. La leçon durable est que l’empreinte d’un CDN doit être traitée comme un portefeuille plutôt que comme une carte statique. La capacité doit absorber les événements régionaux et les afflux massifs. La redondance doit tenir compte des pannes corrélées. Un emplacement de serveur n’a de valeur que si le système de mappage peut identifier quand l’utiliser et si le réseau peut l’atteindre de manière fiable.
Le placement modifie aussi l’économie de l’interconnexion. Le trafic servi depuis l’intérieur ou près d’un réseau d’accès peut réduire le transit amont. Un fournisseur de contenu gagne en performance et en avantages de coût. Le réseau d’accès réduit le trafic externe mais héberge des équipements et donne au CDN une position plus profonde dans son infrastructure. L’accord peut profiter aux deux parties tout en déplaçant le pouvoir de négociation vers les grandes plateformes de diffusion capables de fournir du contenu populaire et un soutien opérationnel.
L’algorithme ne peut pas décider de ces contrats. Il peut montrer où un cluster serait utile selon des hypothèses mesurées. Les équipes commerciales sécurisent les installations et les relations réseau. L’exploitation maintient le site en vie. L’empreinte finale est façonnée par l’optimum technique, le capital, la présence sur le marché et la confiance institutionnelle.
C’est l’une des raisons pour lesquelles un CDN ne peut pas être évalué au seul nombre de serveurs. Un grand parc peut contenir des clusters petits ou spécialisés. La capacité peut être concentrée. Les sites peuvent servir des produits différents. La mesure utile est la façon dont les systèmes de placement, de mappage et de contrôle transforment le parc en service dans des conditions normales et en cas de panne.
Le rôle de Maggs à la frontière entre recherche et production illustre comment un résultat algorithmique acquiert des conséquences économiques. Une meilleure méthode de placement ou d’affectation peut réduire les machines, le transit et le travail d’origine. L’économie appartient au système et à l’entreprise, pas à un seul auteur. Elle dépend aussi de la capacité de l’exploitation à mettre en œuvre la méthode sans créer d’instabilité.
L’expression « serveur proche » suggère la géographie. Une machine dans la même ville peut être atteinte par un chemin encombré ou détourné; un serveur plus éloigné peut être plus performant parce que le peering et la capacité sont plus forts. L’ingénierie des premiers CDN a dû traiter la proximité comme un comportement réseau observé.
Ce changement a intégré la mesure au mappage. La plateforme pouvait comparer la latence, la perte, la joignabilité et la charge, puis choisir parmi les clusters réalisables. La décision était probabiliste et temporaire. Un changement de routage ou de demande pouvait rendre le meilleur choix de la veille erroné.
Le travail algorithmique de Maggs relève de cette distinction. Le placement décide où la capacité existe sur des périodes plus longues. Le mappage décide quelle capacité disponible doit servir une requête maintenant. L’affectation stable empêche l’oscillation et préserve la valeur du cache; la réactivité évite d’envoyer les utilisateurs dans une région dégradée.
L’équilibre est opérationnel plutôt que purement mathématique. Trop de réaction peut créer des boucles de rétroaction lorsque le trafic poursuit une capacité apparente. Trop peu de réaction peut laisser les utilisateurs sur un chemin défaillant. Le CDN est devenu une infrastructure en mesurant la distance comme une performance et en contrôlant la vitesse à laquelle cette mesure pouvait changer la réalité.
Le hachage cohérent a permis aux caches de changer de membres sans tout oublier
L’un des problèmes classiques de la mise en cache distribuée est ce qui se passe lorsque des serveurs sont ajoutés ou retirés. Un hachage simple qui mappe chaque objet sur un nombre fixe de compartiments peut réaffecter une grande partie du cache lorsque le nombre de serveurs change. Cela détruit la localité, crée des échecs de cache et renvoie une vague de requêtes vers les serveurs d’origine. Dans une plateforme où les machines tombent en panne et où la capacité change continuellement, un tel remappage est coûteux.
Le hachage cohérent réduit la quantité de réaffectation. Les clés et les serveurs sont placés dans un espace d’identifiants abstrait, souvent décrit comme un anneau. Un objet est mappé vers une position de serveur appropriée. Lorsqu’un serveur rejoint ou quitte le système, seule une partie limitée de l’espace de clés se déplace, et non l’ensemble du cache. La réplication et la pondération peuvent adapter l’idée à la capacité et à la résilience.
Le mécanisme est devenu important dans l’histoire algorithmique d’Akamai, mais il ne faut pas le présenter comme une invention d’une seule personne appliquée partout sans changement. Le hachage cohérent a sa propre histoire de recherche à plusieurs auteurs, et la mise en cache en production utilise plusieurs couches d’affectation et de politique. L’importance de Maggs tient à la manière dont l’équipe d’Akamai a relié ces outils aux exigences d’exploitation.
La stabilité compte au-delà du taux de succès du cache. Chaque mouvement consomme des ressources réseau et disque. Les réaffectations peuvent être corrélées à une panne, créant une charge supplémentaire alors que le système est déjà sous tension. Un mappage stable donne aux ingénieurs une relation prévisible entre la demande d’objets et l’état des serveurs. Il rend les changements de capacité moins visibles pour les utilisateurs et les serveurs d’origine.
La stabilité est aussi en conflit avec la réactivité. Si le système s’accroche trop à une affectation antérieure, un objet chaud ou un cluster surchargé peut rester au mauvais endroit. S’il remappe de manière agressive, le renouvellement du cache et l’oscillation s’ensuivent. Le contrôleur a besoin de seuils et de rétroaction qui réagissent à un changement important sans poursuivre le bruit. C’est un problème de contrôle, pas seulement un problème de hachage.
Les premières recherches d’Akamai sur l’affectation stable et l’équilibrage de charge ont abordé ce compromis plus large. Le système de mappage devait répartir la demande tout en préservant l’efficacité du cache. Il devait intégrer une capacité et des pannes hétérogènes. Il devait fonctionner à une échelle où une petite instabilité pouvait affecter de nombreuses requêtes.
Les infrastructures modernes répètent le même schéma dans le stockage distribué, les bases de données et le placement de services. La valeur de l’histoire d’Akamai n’est pas d’affirmer qu’un algorithme a résolu la diffusion de contenu. Elle montre comment une propriété mathématique — un mouvement limité lors d’un changement de membres — est devenue une partie d’une discipline opérationnelle plus large.
Le mappage des requêtes devait rester stable sans ignorer les conditions actuelles
Chaque requête de CDN arrive avec un problème d’optimisation implicite. Quel serveur disponible peut livrer l’objet avec des performances acceptables tout en préservant la capacité pour les autres utilisateurs? La réponse dépend de la localisation du client ou du résolveur, du chemin réseau, de l’état du serveur, de la disponibilité de l’objet, de la politique du client et de la charge actuelle.
Un système de mappage ne peut pas recalculer tout l’internet pour chaque requête. Il s’appuie sur des mesures, des modèles et des décisions hiérarchiques. Il peut d’abord choisir une région ou un cluster, puis un serveur. Il peut mettre en cache des décisions via le DNS. Il peut retirer des ressources en mauvaise santé et déplacer la demande. Il doit le faire assez rapidement pour que le système de contrôle ne devienne pas le goulot d’étranglement.
Les signaux d’entrée sont imparfaits. Les mesures de latence peuvent être obsolètes. Un résolveur récursif peut regrouper des utilisateurs sur une vaste zone. Les changements BGP peuvent modifier les chemins entre les observations. L’anycast peut changer l’emplacement de service qui reçoit le trafic. Un client derrière un réseau d’entreprise peut sortir dans une autre ville. L’avantage du système vient de la combinaison de nombreux signaux et de l’apprentissage sur de grands volumes de trafic, pas de la possession d’une carte internet faisant autorité.
Maggs et ses collaborateurs ont décrit des algorithmes pour équilibrer la stabilité et la charge. Un mappage qui change trop souvent peut créer une oscillation: le trafic quitte un cluster, en surcharge un autre puis revient. Les caches DNS signifient que les changements se propagent de manière inégale. Une affectation stable réduit le renouvellement mais risque de laisser la demande sur un chemin dégradé. Le système a besoin d’amortissement, de conscience de la capacité et de règles de bascule.
La politique client complique encore l’objectif. Certains contenus doivent rester dans certaines régions. La sécurité ou les licences peuvent limiter les destinations. Un flux en direct et un téléchargement de logiciel ont des besoins de cache et de latence différents. La plateforme doit optimiser à l’intérieur de ces contraintes plutôt que de poursuivre un seul « serveur le plus proche » universel.
L’échelle de production produit aussi un avantage de données. Un grand CDN observe le succès des requêtes, la latence, la charge des serveurs et les pannes sur de nombreux réseaux. Les données peuvent améliorer les décisions et identifier des schémas. Elles donnent aussi à l’intermédiaire une vision puissante du comportement de l’internet. Les clients et les réseaux dépendent de la mesure de la plateforme sans voir le modèle complet.
Le système de mappage est devenu le cœur commercial de la diffusion de contenu parce qu’il transformait un parc distribué en un service cohérent. Son influence était discrète: les utilisateurs voyaient une page rapide, pas la décision politique qui avait sélectionné la périphérie. La carrière de Maggs a rendu cette décision cachée lisible par la recherche, tandis que la plateforme propriétaire continuait d’évoluer au-delà de ce que décrivent les articles publics.
La mise en cache protégeait les serveurs d’origine et faisait de l’invalidation un problème de coordination
L’avantage le plus évident d’un cache est d’éviter le transfert répété du même objet depuis l’origine. À l’échelle d’un CDN, cet avantage devient un mécanisme économique et de fiabilité. Le contenu populaire peut être servi depuis de nombreux emplacements périphériques. Le serveur d’origine gère les échecs de cache, les mises à jour et les requêtes personnalisées au lieu de chaque octet. La demande de transit diminue. Un afflux massif devient un travail distribué.
Le mécanisme dépend de l’exactitude. Le CDN doit savoir si un objet est mettable en cache, combien de temps il reste frais et quoi faire lorsque l’origine le modifie. Les en-têtes et la configuration du client façonnent la réponse. Servir un contenu obsolète ou privé peut être plus dommageable qu’une panne. Un cache conservateur protège l’exactitude mais peut moins délester. Un cache agressif améliore les performances tout en augmentant le risque politique.
L’efficacité du cache dépend aussi de l’affectation. Si les requêtes pour le même objet sont dispersées sur trop de serveurs, chaque cache voit moins de réutilisation. Si toute la demande est concentrée, la capacité et le risque de panne augmentent. Les objets volumineux, les médias en direct et les pages personnalisées créent des compromis différents. Le système de contrôle de la plateforme relie la politique de cache au mappage et au placement.
La protection des serveurs d’origine est devenue de plus en plus importante à mesure que les attaques et les pics de trafic ont augmenté. Un CDN peut absorber la demande en périphérie et masquer ou protéger l’origine contre un accès direct. Il peut limiter le débit, filtrer et interroger le trafic avant de transmettre les requêtes légitimes. Ces fonctions dépassent la mise en cache pour entrer dans la sécurité, mais elles reposent sur la même position distribuée.
Le rôle d’intermédiaire change les modes de défaillance. Si un CDN configure mal le cache ou le mappage, de nombreux clients peuvent être touchés en même temps. Une périphérie performante peut masquer une origine en mauvaise santé jusqu’à l’expiration du contenu. La dépendance des clients à une configuration et à des journaux propriétaires peut créer des coûts de changement. La plateforme réduit le fardeau d’infrastructure tout en accumulant le contrôle opérationnel.
Les premiers travaux de Maggs doivent être replacés dans ce contexte évolutif sans relire les produits actuels à travers 1998. Le portefeuille moderne de sécurité et de calcul de l’entreprise n’est pas le même que la première architecture de diffusion. La continuité réside dans la valeur opérationnelle d’une périphérie distribuée, pas dans une liste de produits inchangée.
La mise en cache a fait de la réduction de latence une activité parce qu’elle liait la performance utilisateur à des économies mesurables de serveurs, de bande passante et de résilience. Les algorithmes comptaient parce qu’une mauvaise affectation pouvait effacer ces gains. Le modèle commercial comptait parce que quelqu’un devait financer et exploiter l’empreinte. Aucune couche seule n’a créé le marché.
Servir un objet près de l’utilisateur n’est utile que tant que l’objet reste valide. Les éditeurs changent les pages, révoquent des fichiers et personnalisent les réponses. Un CDN doit décider ce qui peut être mis en cache, combien de temps il doit le rester et comment une purge urgente atteint des milliers de serveurs.
Le problème de contrôle se situe entre la vitesse et la fraîcheur. Des durées de vie courtes réduisent le contenu obsolète et diminuent l’efficacité du cache. Des durées de vie longues protègent les origines et augmentent les conséquences d’un objet erroné. Les purges doivent se propager rapidement sans submerger le système de contrôle ni créer un état incohérent.
C’est une autre raison pour laquelle la première diffusion de contenu était plus que la copie de fichiers. La plateforme avait besoin de gestion de versions, de validation et de repli lorsqu’un serveur périphérique et l’origine étaient en désaccord. Les clients avaient besoin d’un moyen d’exprimer une politique que le cache distribué pouvait appliquer.
La contribution plus large de Maggs aux systèmes est pertinente parce que l’invalidation expose le coût de l’état distribué. Le placement et le mappage décident où un objet peut être servi. L’invalidation décide si tous ces emplacements peuvent cesser de le servir au bon moment. Un cache rapide avec un contrôle faible aurait été un fardeau plutôt qu’une infrastructure.
La mesure était la boucle de rétroaction qui gardait les algorithmes utiles
Un système de mappage ne peut pas s’améliorer s’il observe seulement si un serveur est vivant. Il a besoin de preuves sur le délai réseau, la perte de paquets, la charge, le comportement du cache et le succès des décisions précédentes. La première plateforme d’Akamai traitait la mesure comme une partie du contrôle plutôt que comme un produit de reporting distinct. La vision que le système avait de l’internet était assemblée à partir de sondes et d’interactions de production, puis utilisée pour choisir parmi des alternatives imparfaites.
Cette boucle de rétroaction distingue un CDN de production d’un réseau de miroirs statique. Une liste de miroirs demande aux utilisateurs de choisir ou applique une règle géographique approximative. Un système de diffusion dynamique observe les conditions et met à jour les affectations. L’avantage dépend de la qualité et de la fraîcheur des observations. Une mesure peut être erronée parce que le client est représenté par un résolveur récursif éloigné, parce que le chemin change après l’échantillon ou parce que le trafic de sonde diffère de la requête réelle.
Le contrôleur a donc besoin de confiance plutôt que de certitude. Il peut combiner plusieurs signaux faibles, comparer les tendances et éviter d’effectuer un grand mouvement de trafic sur un seul échantillon anormal. Il peut utiliser le succès et l’échec de production comme preuve, mais cela risque de créer une boucle de rétroaction dans laquelle un choix antérieur façonne les données utilisées pour justifier le choix suivant. Si un cluster reçoit peu de trafic, le système peut avoir moins d’informations sur ses performances sous charge.
La mesure à cette échelle devient un actif concurrentiel. Un fournisseur avec un trafic large voit des schémas de chemin et de demande qu’un nouvel entrant ne peut pas reproduire immédiatement. Les données améliorent le mappage et la planification des capacités. Elles soulèvent aussi des questions de gouvernance. Les clients peuvent ne pas savoir quels signaux affectent leurs utilisateurs. Les réseaux peuvent voir le trafic bouger en réponse à des modèles privés. Les régulateurs peuvent se demander si l’avantage de données de l’intermédiaire renforce la concentration du marché.
La discipline opérationnelle consiste à séparer la performance observée de l’explication causale. Un cluster avec de mauvais résultats peut être surchargé, atteint par un chemin dégradé ou servir un objet qui neutralise la mise en cache. Un système de contrôle peut détourner rapidement le trafic pendant que les ingénieurs enquêtent. L’action immédiate et le diagnostic ultérieur n’ont pas besoin d’être identiques.
Les travaux publiés par Maggs avec ses collègues ont contribué à exposer ce modèle de rétroaction sans divulguer chaque détail de production. La leçon plus large est qu’un algorithme mondial n’est jamais terminé. Ses entrées, seuils et modes de défaillance sont maintenus comme partie du service. L’« intelligence » de la plateforme réside autant dans une mesure et une révision disciplinées que dans la formulation mathématique initiale.
Le routage par surcouche contournait les pannes sans posséder l’internet sous-jacent
Un CDN peut améliorer la diffusion même lorsque le chemin internet direct entre la périphérie et l’origine est médiocre. En exploitant des serveurs et des liens sur de nombreux emplacements, il peut mesurer des routes alternatives à travers sa propre surcouche et choisir un chemin intermédiaire. Les paquets traversent toujours les réseaux et les liens contrôlés par BGP, mais la couche applicative peut choisir où le trafic entre et sort du système de routage public.
Le routage par surcouche est utile parce que le routage internet optimise la politique des opérateurs et la joignabilité, pas l’objectif de performance d’une application. Une route valide peut être encombrée ou instable. Une alternative passant par un autre nœud du CDN peut éviter le problème. La mesure et un contrôle rapide permettent à la plateforme de réagir plus vite que la convergence du routage mondial dans certains cas.
La technique a des limites. Les chemins alternatifs peuvent partager une infrastructure physique. Une panne près de la destination peut affecter toutes les surcouches. Le tunnelling ou le relais ajoute une surcharge. La vision du CDN reste partielle. Il ne peut pas non plus ignorer les politiques et l’économie des réseaux qui transportent le trafic.
Les recherches d’Akamai sur les systèmes distribués ont exploré la résilience et les mécanismes de surcouche dans le cadre plus large du service. Pour Maggs, c’était un autre exemple d’algorithmes gérant une information incomplète. Le contrôleur devait décider quand une route alternative améliorait les performances et quand changer de chemin créerait de l’instabilité.
Le contrôle par surcouche renforce aussi la position stratégique du CDN. La plateforme ne stocke plus seulement du contenu; elle prend des décisions de chemin pour le trafic des clients. Cela peut améliorer la sécurité et la fiabilité tout en faisant du fournisseur un intermédiaire plus lourd de conséquences. Les pannes ou les erreurs de politique du CDN peuvent affecter des services sur de nombreux réseaux sous-jacents.
La leçon n’est pas que les CDN ont remplacé BGP. Ils ont créé une couche de contrôle sensible aux applications au-dessus de lui. Cette couche pouvait exploiter une large empreinte et une télémétrie privée tout en restant dépendante de l’internet public. Les dorsales cloud modernes, les maillages de services et les systèmes multirégions poursuivent le même schéma: le contrôle par surcouche ajoute des options sans éliminer le réseau physique et institutionnel sous-jacent.
La diffusion en continu a contraint la périphérie à gérer le temps, la continuité et la popularité
Les objets web statiques rendaient facile à décrire la valeur de base de la mise en cache. La diffusion en continu ajoutait une charge plus exigeante. Les utilisateurs attendaient une lecture continue, pas seulement une réponse initiale rapide. La popularité pouvait monter en flèche autour d’événements en direct. Les objets étaient volumineux ou segmentés dans le temps. Une brève erreur de mappage ou une insuffisance de capacité pouvait devenir visible sous forme de mise en mémoire tampon plutôt que d’une page légèrement plus lente.
Une plateforme de diffusion devait gérer plusieurs échelles de temps. Elle sélectionnait une périphérie avant ou pendant une session. Elle avait besoin de suffisamment de capacité proche pour les spectateurs simultanés. Elle mettait en cache des segments dont l’utilité pouvait être brève. Elle répondait aux pannes sans forcer le lecteur à redémarrer. Les serveurs d’origine et les encodeurs devaient alimenter le système de distribution de manière fiable. La qualité ressentie par l’utilisateur dépendait de la logique applicative autant que du réseau.
Maggs et ses collaborateurs ont étudié les charges de diffusion en continu dans le cadre plus large du programme de diffusion de contenu. La recherche illustrait pourquoi les moyennes sont inadéquates. Un système peut offrir un débit agrégé élevé tandis qu’une minorité de sessions échoue gravement. Les objets populaires améliorent l’efficacité du cache mais concentrent la demande. Les longues sessions rendent la stabilité précieuse parce qu’un remappage peut perturber l’état, alors que rester sur un chemin dégradé peut être pire.
L’économie diffère aussi des fichiers ordinaires. Un événement en direct a un moment de valeur fixe. La capacité achetée après l’événement ne peut pas récupérer l’expérience. Le CDN doit provisionner pour les pics ou les répartir sur une empreinte. Cela crée une fonction d’assurance: les clients paient pour la capacité du fournisseur à absorber une demande qu’ils ne peuvent pas prévoir précisément.
La diffusion en continu a fait de la périphérie un entité applicatif. Le fournisseur pouvait optimiser la distribution des segments, le comportement des connexions et la bascule. La frontière entre transport neutre et logique de service est devenue moins nette. Cette évolution a amélioré les performances mais a aussi rendu plus difficile le changement de fournisseur et la reproduction du comportement.
Le marché moderne comprend des protocoles, des lecteurs et des services cloud qui n’existaient pas à la période fondatrice. La leçon historique doit rester bornée. Les premières recherches d’Akamai ne décrivent pas tous les systèmes de diffusion actuels. Elles montrent le problème de contrôle récurrent: utiliser des preuves incomplètes et rapidement changeantes pour placer un travail sensible au temps avant que les utilisateurs ne remarquent la décision d’infrastructure.
La résilience dépend des pannes corrélées, pas du nombre de réplicas
Les systèmes distribués reposent en partie sur l’hypothèse que les composants tomberont en panne, mais toutes les pannes ne sont pas indépendantes. Un incident électrique peut retirer une installation. Un incident de routage peut affecter plusieurs clusters. Un déploiement logiciel peut introduire le même défaut sur tout le parc. Une erreur du plan de contrôle peut détourner un trafic sain de serveurs sains. La résilience du CDN dépend de la compréhension des pannes corrélées, plus que du comptage des réplicas.
L’architecture d’Akamai utilisait des informations de santé et le contrôle de mappage pour retirer les ressources défaillantes et déplacer la demande. Cette réponse doit tenir compte de la capacité. Envoyer tout le trafic d’un cluster indisponible vers l’alternative la plus proche peut la surcharger et créer une cascade. Le contrôleur peut devoir répartir la charge plus loin, accepter une latence plus élevée ou réduire des fonctions de service. La résilience est un problème d’allocation en conditions dégradées.
Le système a aussi besoin d’une récupération stable. Lorsqu’un cluster revient, ramener le trafic immédiatement peut créer une oscillation ou exposer une réparation incomplète. Une réintroduction progressive et l’observation sont plus sûres. L’état du cache peut être froid. La configuration client peut ne pas avoir atteint le site. Les routes réseau peuvent encore converger. Le système de contrôle doit traiter « joignable » comme plus faible que « prêt pour la pleine demande ».
Les déploiements logiciels ajoutent une autre dimension. Une plateforme mondiale a besoin de contrôle de version, de déploiement progressif et de retour en arrière. Une fonction qui améliore le mappage dans un réseau peut mal se comporter ailleurs. Les résultats de recherche ne deviennent une production qu’après avoir survécu à des environnements hétérogènes. Cette porte opérationnelle fait partie de la contribution d’ingénierie, même lorsqu’elle n’apparaît pas dans un article d’algorithme.
Les clients vivent le CDN comme un seul service, donc la redondance interne n’excuse pas une défaillance du plan de contrôle. Un fournisseur peut exploiter des milliers de serveurs et créer malgré tout une panne large par un seul système de configuration ou de certificats. L’architecture doit éviter les dépendances communes qui annulent la distribution physique.
Le leadership précoce de Maggs appartient à la période où ces pratiques étaient établies autour d’une plateforme en expansion rapide. L’idée durable est que la redondance doit être gouvernée. Plus d’emplacements créent des options; un contrôleur discipliné décide si ces options restent indépendantes et comment les utiliser sans amplifier la panne d’origine.
La sécurité en périphérie a multiplié la valeur et concentré la confiance
Dès qu’une plateforme de diffusion s’est interposée entre les utilisateurs et les serveurs d’origine, elle était en position d’observer et de filtrer les attaques. Une capacité distribuée pouvait absorber de grandes inondations. Le logiciel en périphérie pouvait inspecter les requêtes, appliquer des règles et bloquer des motifs connus. Les certificats et les sessions chiffrées pouvaient se terminer au CDN, permettant la protection des applications et l’optimisation des performances.
Cette évolution avait un sens commercial. Les clients faisaient déjà confiance à la plateforme pour l’orientation du trafic. Les services de sécurité pouvaient protéger l’origine et réduire le besoin pour chaque client de construire une capacité mondiale d’atténuation. L’échelle du CDN fournissait des données sur les attaques sur de nombreux sites.
Le coût de confiance augmentait aussi. Le fournisseur pouvait voir le trafic et les journaux, détenir des éléments liés aux certificats et influencer l’accès. Une erreur de configuration ou une compromission chez l’intermédiaire pouvait affecter plusieurs clients. Les gouvernements et les régulateurs pouvaient traiter le CDN comme un point de levier. La concentration du marché signifiait que les défaillances d’un petit nombre de grands fournisseurs avaient des conséquences larges.
Les travaux ultérieurs menés en commun par Maggs incluaient des thèmes de réseaux de diffusion sécurisés, mais l’ensemble de l’activité sécurité d’Akamai ne peut pas lui être attribué. L’expansion des produits d’Akamai a mobilisé de nombreuses équipes et des années de développement après la période fondatrice. La continuité pertinente est architecturale: une périphérie distribuée crée des possibilités de performance et de sécurité, tout en consolidant le contrôle entre les mains de l’opérateur de cette périphérie.
L’expansion de la sécurité a aussi affecté la recherche. Les attaques en production révèlent des charges et des modes de défaillance que les jeux de données académiques peuvent ne pas contenir. Publier des mécanismes peut améliorer le domaine plus large, mais les détails les plus sensibles restent propriétaires. La carrière de Maggs à la frontière entre l’entreprise et l’université illustre à la fois l’opportunité et l’asymétrie d’information.
Les recherches ultérieures de Maggs reflètent cette expansion. Le travail sur la diffusion de contenu ne pouvait plus traiter la performance, la disponibilité et la sécurité comme des produits séparés. Une plateforme périphérique devait authentifier la configuration des clients, protéger les clés privées, isoler les locataires, valider les changements logiciels et continuer à fonctionner pendant que des serveurs ou des réseaux individuels tombaient en panne. Des décisions qui amélioraient l’efficacité du cache pouvaient modifier la vie privée ou l’intégrité.
Une surcouche de routage qui trouvait un meilleur chemin pouvait créer une nouvelle dépendance à l’exactitude des mesures et à la sécurité du plan de contrôle.
C’est une raison pour laquelle la première architecture d’Akamai ne doit pas être lue comme un plan fini. L’article systèmes de 2002 explique des mécanismes et des choix de conception importants de son époque. Il ne documente pas toutes les fonctions modernes de chiffrement, de gestion des robots, de calcul ou de confiance zéro. La plateforme de production a changé à mesure que l’environnement des menaces et les attentes des clients changeaient. Un contributeur historique peut éclairer l’architecture sans prétendre qu’un ancien article décrit le service actuel.
La contribution de Maggs est utile ici parce que son travail traite la fiabilité comme une propriété du système. Aucun algorithme de placement ne rend une périphérie digne de confiance. La confiance naît de l’interaction du mappage, du déploiement logiciel, des contrôles cryptographiques, de la surveillance, de la revue organisationnelle et de la récupération. C’est le même problème de traduction qui a façonné le CDN d’origine: un algorithme élégant ne compte qu’après qu’une grande organisation d’ingénierie l’a rendu sûr sous une charge et des pannes changeantes.
Le modèle économique des CDN échangeait des gains de performance contre une dépendance opérationnelle
La diffusion de contenu créait de la valeur pour plusieurs parties à la fois. Un éditeur évitait de construire un parc mondial de serveurs et réduisait la charge d’origine. Les utilisateurs obtenaient une latence plus faible et une meilleure disponibilité. Les réseaux d’accès pouvaient servir le trafic populaire localement ou par une interconnexion proche, réduisant une partie du transit. Le CDN gagnait des revenus en exploitant la couche de placement, de mappage et de sécurité comme un service.
Cet alignement a fait croître le marché, mais il n’était pas automatique. Les clients avaient besoin d’un moyen simple de déléguer le trafic sans reconcevoir chaque application. Les partenaires réseau avaient besoin d’une raison d’héberger ou d’interconnecter avec la plateforme. Le fournisseur avait besoin de contrats et d’un soutien opérationnel suffisants pour justifier des investissements dans de nombreux emplacements. Les algorithmes réduisaient le coût du service; les relations commerciales rendaient l’empreinte possible.
Le modèle changeait aussi le coût du client, passant d’une infrastructure possédée à une dépendance continue. Une entreprise pouvait évoluer rapidement sans acheter de serveurs dans de nombreuses régions, mais elle devenait tributaire de la configuration propriétaire, des systèmes de compte et du soutien opérationnel. Les attentes de performance augmentaient. Ramener le trafic directement vers l’origine pouvait être techniquement possible et commercialement douloureux parce que l’origine n’était plus dimensionnée pour la pleine demande.
C’est un schéma familier des services cloud avant que le terme cloud ne domine les discussions sur l’infrastructure. Le fournisseur convertit un capital et une expertise complexes en un service accessible. Le client gagne en flexibilité et perd une partie du contrôle direct. Les coûts de changement s’accumulent dans la configuration, les données, les flux de travail et la différence entre des plateformes nominalement similaires.
Le succès d’Akamai ne peut pas être attribué aux seuls algorithmes de Maggs. L’entreprise avait besoin de ventes, de finance, de support et de relations réseau. L’effet économique d’une meilleure méthode de mappage ne peut pas non plus être séparé proprement de la croissance du trafic et des conditions de marché qui l’entourent. L’affirmation responsable est plus étroite: la recherche et l’ingénierie ont amélioré l’efficacité et la fiabilité d’un service dont l’économie reposait sur la capacité à effectuer un travail distribué mondialement mieux que chaque client ne pouvait le faire seul.
Pour les responsables d’infrastructure actuels, cette histoire est un avertissement contre l’évaluation d’une plateforme gérée au seul prix unitaire. Le coût stratégique inclut qui contrôle les décisions de trafic, la facilité avec laquelle le service peut être reproduit et ce qui arrive à la capacité opérationnelle du client après des années de délégation. Les mêmes questions s’appliquent aux bases de données cloud, aux plateformes d’observabilité et aux services d’exécution d’IA.
L’équipe compte plus que la recherche d’un inventeur unique
Les histoires des technologies compriment souvent une réalisation distribuée en un petit nombre d’acteurs parce qu’une biographie est plus facile à raconter que l’ingénierie des systèmes. Akamai résiste à ce traitement. Leighton et Lewin ont fondé l’entreprise. Une large équipe initiale a construit le mappage, la mise en cache, l’exploitation, la distribution logicielle, l’intégration client et les fonctions commerciales. Les articles d’architecture publiés nomment de nombreux coauteurs. Les partenaires de réseau et d’installations ont rendu l’empreinte possible.
Maggs mérite une place substantielle dans le récit. Il a rejoint l’entreprise tôt, a exercé un leadership en recherche-développement et a coécrit des explications influentes de la plateforme et de ses algorithmes. Ces faits établissent son importance. Ils ne soutiennent pas l’affirmation selon laquelle il aurait créé à lui seul le CDN, fondé Akamai seul ou créé chaque mécanisme décrit dans les articles communs.
L’attribution collective n’est pas une note de bas de page polie. Elle explique comment l’infrastructure devient réelle. Un chercheur en algorithmes identifie une méthode. Des ingénieurs l’implémentent et la testent. Les opérateurs découvrent les modes de défaillance. Les équipes produit la rendent configurable. Les ventes et le support la traduisent en obligations clients. Les dirigeants allouent le capital. Les partenaires réseau hébergent les systèmes. Une entreprise qui perd l’une de ces fonctions n’a pas de CDN commercial.
Le récit centré sur le fondateur peut aussi fausser les décisions techniques. Un système peut sembler suivre une vision cohérente alors qu’il a en réalité émergé d’une négociation entre contraintes concurrentes. Comprendre ces contraintes rend l’architecture plus utile aux lecteurs actuels. Cela montre pourquoi la stabilité, la mesure et la simplicité opérationnelle l’emportent souvent sur une conception théoriquement plus forte mais fragile.
Les documents historiques de la SEC enregistrent des activités précoces d’actions ou d’options impliquant Maggs, mais ils n’établissent pas une participation actuelle importante. La valeur d’Akamai ne peut pas être répartie entre chercheurs à partir de descriptions de rôles publiques. Les résultats de l’entreprise reflètent la technologie collective, le capital, les clients et les conditions de marché. Une estimation de la valeur nette personnelle ajouterait de la spéculation plutôt que de la perspicacité.
Le récit exact est plus riche. Maggs a été l’une des personnes qui ont fait fonctionner une entreprise algorithmiquement ambitieuse. Son travail aide à expliquer le mécanisme. Le succès de l’entreprise démontre la valeur du système entier, pas un score privé pour un contributeur.
L’architecture fondatrice ne peut pas remplacer la plateforme actuelle d’Akamai
Les récits publics les plus détaillés de la conception initiale d’Akamai sont précieux parce qu’ils décrivent des mécanismes plutôt que des slogans. Ce sont aussi des documents historiques. Le réseau, les produits, les logiciels et les responsabilités de sécurité de l’entreprise ont changé pendant plus de deux décennies. Traiter un article d’architecture de 2002 comme une spécification technique actuelle transformerait une preuve inhabituellement bonne en une affirmation trompeuse.
Certains principes sont probablement durables parce que le problème persiste: répartir la capacité, mesurer les conditions, mapper la demande, protéger les origines et récupérer des pannes. L’implémentation peut changer radicalement pendant que ces fonctions restent. Le contrôle DNS peut être complété par d’autres techniques. Les protocoles de transport, le chiffrement, l’anycast et les systèmes de confidentialité modifient les signaux disponibles. Les coûts du matériel et du cloud changent l’emplacement de la capacité. Les services de sécurité ajoutent une analyse et une politique que les premiers caches n’effectuaient pas.
Le dossier historique doit donc servir à expliquer comment l’activité est devenue possible. Il montre les contraintes que les premiers ingénieurs ont reconnues et les outils algorithmiques qu’ils ont utilisés. Il établit le rôle documenté de Maggs et la paternité collective du système. Il ne soutient pas les affirmations sur le nombre exact de serveurs actuels, la logique actuelle de routage des requêtes ou la conception de chaque produit moderne.
Cette séparation protège aussi l’entreprise d’une mythologie rétrospective. Un succès ultérieur peut faire paraître chaque choix initial inévitable. En réalité, l’équipe a travaillé dans l’incertitude, a rivalisé avec d’autres approches de diffusion et a révisé la plateforme à mesure que le trafic changeait. Les articles contemporains capturent certaines décisions avant que le résultat commercial ne soit connu.
Une histoire future plus solide combinerait ces articles avec les premiers enregistrements opérationnels, des cas clients et des entretiens dans l’ingénierie et le commerce. Elle identifierait quels mécanismes ont survécu, lesquels ont été remplacés et lesquels ne semblent importants qu’a posteriori. D’ici là, les preuves soutiennent un récit de continuité architecturale avec changement d’implémentation.
L’argument est plus fort avec cette retenue. Son influence ne dépend pas de l’affirmation selon laquelle l’Akamai actuel exécute sans changement le système décrit dans ses premiers articles. La réussite a été d’aider à établir le raisonnement et la discipline d’ingénierie par lesquels une plateforme de diffusion mondiale pouvait s’adapter. La durabilité réside dans la méthode, pas dans un code figé.
Duke a retransformé l’expérience de production en recherche
Après l’expansion initiale d’Akamai, Maggs a combiné un travail universitaire à Duke University avec des recherches continues sur la diffusion de contenu, les algorithmes, la sécurité des réseaux, la diffusion en continu et les systèmes distribués. Duke l’identifie désormais comme professeur émérite. Ses publications et son enseignement ont permis aux questions opérationnelles de revenir à la communauté de recherche sous des formes pouvant être étudiées en dehors de l’entreprise.
Ce mouvement entre l’entreprise et l’université compte parce que les systèmes de production génèrent des preuves difficiles à reproduire. Un CDN mondial voit la diversité du trafic, les pannes et les conditions adverses à grande échelle. Le travail universitaire peut abstraire des mécanismes et les tester, mais l’accès est limité par les données propriétaires. Les articles communs offrent un pont partiel: assez de détails pour expliquer des idées importantes sans exposer toute la plateforme.
Maggs a été élu Fellow de l’ACM en 2018 pour ses contributions aux réseaux de diffusion de contenu et à la théorie des réseaux informatiques. La reconnaissance reflète la combinaison plutôt qu’un produit unique. Sa carrière joint les algorithmes théoriques, l’ingénierie de production et l’explication savante.
Le rôle universitaire crée aussi une responsabilité de préserver l’attribution. Les étudiants, les coauteurs et les collaborateurs industriels génèrent la recherche. La direction d’un laboratoire par un professeur n’est pas la propriété de chaque idée. L’histoire de Maggs chez Akamai rend cette distinction particulièrement pertinente.
Un discours d’ouverture de 2026 sur les leçons d’ingénierie d’Akamai et d’Emerald Innovations montre qu’il reste un interprète de la transition de la recherche vers les systèmes. De tels discours sont des preuves historiques précieuses mais peuvent simplifier une période initiale compliquée. Les articles et les dossiers contemporains doivent rester l’ancre pour les dates et les rôles.
Le chapitre universitaire empêche le récit de devenir une histoire d’origine d’entreprise. Il montre comment le savoir d’infrastructure circule: la recherche informe une entreprise, l’exploitation change les questions de recherche et l’enseignement ultérieur façonne une autre génération d’ingénieurs systèmes. La valeur est cumulative, et aucune institution ne contrôle tout.
Emerald Innovations applique la détection distribuée sous une charge de preuve différente
Le rôle officiel actuel de Maggs est directeur de l’ingénierie chez Emerald Innovations, selon l’entreprise et Duke. Une source personnelle a utilisé le titre de directeur scientifique, de sorte que la désignation actuelle de l’entreprise est plus sûre. Cet écart rappelle que les titres changent et doivent être datés plutôt qu’harmonisés par hypothèse.
Emerald développe une technologie de détection sans contact destinée à déduire des mouvements, la respiration, le sommeil ou d’autres schémas liés à la santé à partir de signaux sans fil dans un environnement. La ressemblance architecturale avec un CDN est limitée mais réelle. Les deux systèmes recueillent des observations bruitées depuis des emplacements distribués et les transforment en décisions de service. Les deux exigent un étalonnage, une inférence, une fiabilité et une confidentialité. Les sujets et les obligations de validation sont très différents.
Une plateforme de diffusion peut mesurer si un objet a atteint un utilisateur et combien de temps cela a pris. Un système de détection lié à la santé fait des affirmations qui peuvent affecter les soins et les décisions personnelles. La performance du produit, la validation clinique, le statut réglementaire et la confidentialité exigent donc des preuves indépendantes. Une déclaration d’entreprise sur un déploiement ou un bénéfice n’est pas la même chose qu’un résultat clinique évalué par des pairs.
Emerald se décrit comme détenue par ses salariés, autofinancée et à flux de trésorerie positif. Ce sont des affirmations de l’entreprise. Elles n’établissent pas la propriété individuelle, le contrôle du vote ou la situation financière de Maggs. Aucune table de capitalisation publique ne soutient une telle inférence.
Le chapitre actuel est important parce qu’il montre Maggs continuant à travailler sur les systèmes distribués plutôt que se contentant de raconter l’histoire d’Akamai. Il démontre aussi le danger de transférer le prestige entre domaines. Le succès dans la diffusion de contenu ne valide pas un produit de santé. La contribution pertinente est le leadership d’ingénierie dans l’entreprise actuelle, borné par les preuves disponibles.
Ce mouvement élargit la question centrale de la carrière. Comment un système peut-il agir sur des mesures recueillies dans des environnements qu’il ne contrôle pas entièrement? Dans la diffusion de contenu, les entrées incertaines sont les chemins réseau, la demande et l’état des serveurs. Dans la détection sans contact, elles incluent les réflexions radio, l’activité humaine et la variation environnementale. La méthode — mesure distribuée et inférence robuste — voyage plus facilement que l’affirmation d’assurance.
Les institutions ont changé ce que Maggs pouvait construire et prouver
Une histoire familière de pionnier technologique part d’une idée académique vers une entreprise prospère puis traite l’échelle commerciale comme une preuve de génie individuel. Le parcours de Maggs est plus instructif lorsque les institutions restent visibles. Le MIT et Carnegie Mellon ont fourni des communautés de recherche. Le NEC Research a soutenu des travaux qui n’avaient pas besoin de produit immédiat. Akamai a fourni du capital, des clients et une urgence opérationnelle chaque fois que la demande ou la panne dépassait le modèle. Duke a offert la liberté de continuer à étudier les systèmes après le premier chapitre commercial.
Chaque environnement récompense un type de contribution différent. Un article peut isoler un mécanisme et établir pourquoi il fonctionne. Une start-up doit intégrer ce mécanisme avec la facturation, le support, le déploiement et la sécurité. Une entreprise mature doit préserver le service tout en remplaçant les hypothèses initiales. Une université peut revoir la conception avec des données et du recul. Maggs a circulé entre ces cadres, mais il n’avait pas la même autorité ni le même objectif dans chacun.
Ce parcours institutionnel aide à expliquer pourquoi l’attribution doit être précise. Il peut être décrit comme un employé fondateur d’Akamai, un des premiers vice-présidents de la recherche-développement, un coauteur d’articles d’architecture et d’algorithmes importants et un professeur qui a poursuivi des travaux sur la diffusion de contenu et les systèmes distribués. Ces rôles sont substantiels sans faire de lui l’inventeur solitaire d’un marché.
Cela explique aussi pourquoi les leçons les plus précieuses ne sont pas des anecdotes sur un lancement célébré. Elles concernent les disciplines qui survivent après l’ère des fondateurs: mesurer le réseau plutôt que le supposer, séparer l’affectation stable de la réaction rapide, concevoir pour la panne partielle et traiter le retour opérationnel comme une preuve de recherche. Ces pratiques sont transférables même lorsque l’entreprise, le trafic et le matériel sous-jacents ont changé.
Les CDN ont fait d’une couche de contrôle privée une partie ordinaire de la diffusion internet
La diffusion de contenu a résolu un problème visible: des origines éloignées et une demande concentrée. Son effet plus large fut institutionnel. Une plateforme privée est devenue une partie du chemin entre de nombreux éditeurs et utilisateurs. Elle a influencé les flux de trafic, l’interconnexion, la sécurité et l’économie de l’hébergement. L’internet est resté décentralisé au niveau du réseau tandis que la diffusion applicative s’est consolidée autour de grands intermédiaires.
Cet arrangement a produit de réels gains. Les utilisateurs ont reçu un contenu plus rapide et plus fiable. Les serveurs d’origine ont évité certains coûts de capital et de bande passante. Les réseaux d’accès ont réduit le trafic amont. Les attaques pouvaient être absorbées à des périphéries distribuées. Les petits éditeurs ont gagné une infrastructure qu’ils ne pouvaient pas construire seuls.
Les gains sont venus avec des coûts de changement et une concentration. Les configurations client, les certificats, les journaux et les attentes de performance sont devenus liés à un fournisseur. Reproduire une empreinte mondiale était coûteux. Une panne CDN pouvait toucher des services non liés en même temps. La télémétrie et les algorithmes privés de la plateforme étaient difficiles à auditer pour les observateurs extérieurs.
Les premiers travaux algorithmiques de Maggs s’inscrivent dans ce changement. Le placement, le mappage et l’affectation stable ont rendu l’intermédiaire assez efficace pour devenir une infrastructure normale. Les algorithmes n’ont pas déterminé la structure du marché, mais ils ont permis un service dont l’échelle a ensuite porté un pouvoir de marché.
C’est la conclusion la plus solide de son parcours. La réalisation d’ingénierie importante n’a pas été de faire disparaître la distance. Elle a été de gérer la distance, la demande et les pannes assez bien pour que les clients acceptent une nouvelle couche de dépendance. Le résultat illustre un compromis récurrent des infrastructures: une abstraction réduit la complexité pour les utilisateurs en concentrant l’expertise et le contrôle ailleurs.
La carrière de Bruce Maggs donne à ce compromis une histoire technique. Les travaux sur les systèmes montrent comment l’abstraction a été construite. Le dossier collaboratif montre pourquoi aucun récit d’inventeur unique n’est adéquat. Les chapitres académique ultérieur et Emerald montrent que la méthode continue de se déplacer vers de nouveaux domaines, où ses affirmations doivent être testées à nouveau.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance