
Résumé
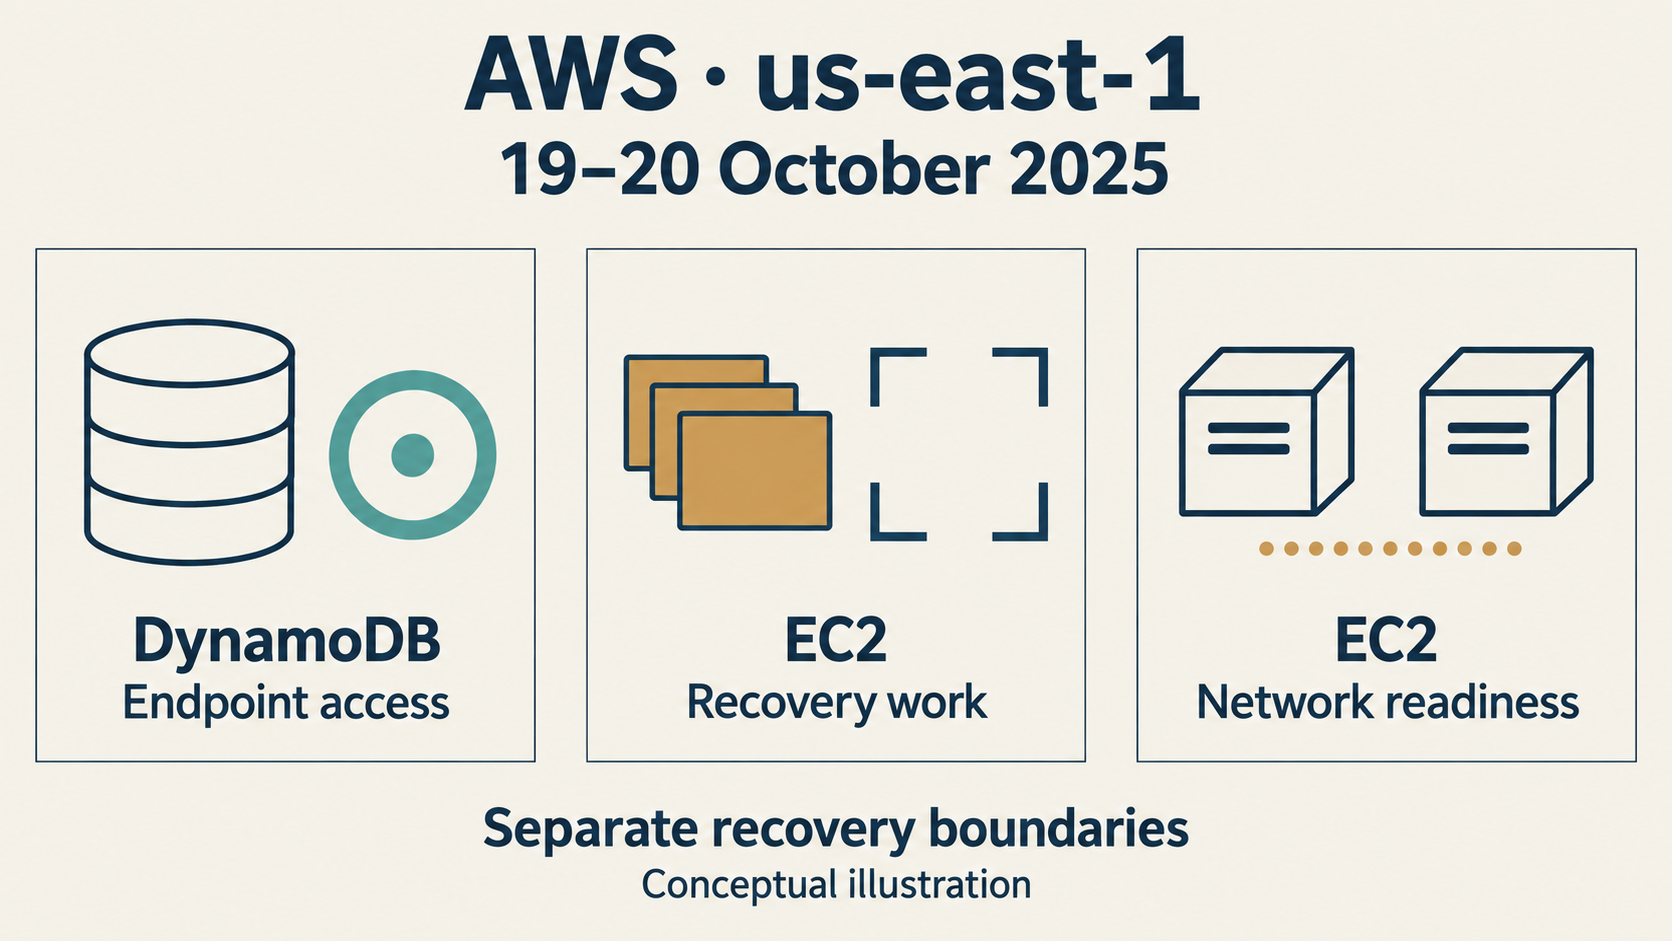
- La chronologie de ThousandEyes sépare le rétablissement des informations DNS de DynamoDB, le 20 octobre 2025 à 09 h 25 UTC, de la fin des difficultés de lancement ou de connectivité des nouvelles instances EC2, à 20 h 50 UTC.
- Les explications techniques examinées décrivent deux obstacles supplémentaires : la reprise de la gestion des serveurs physiques et un retard de propagation de leur état réseau. Une instance lancée, une instance joignable et une application opérationnelle ne constituent pas la même preuve de reprise.
Une dépendance réparée peut remettre du travail en circulation
Le retour d’une base de données est une bonne nouvelle pour les systèmes qui en dépendent. Ce n’est pourtant pas la garantie qu’ils retrouvent immédiatement leur fonctionnement normal. Les opérations interrompues restent à accomplir ; leur reprise peut elle-même saturer le système chargé de les exécuter. C’est le mécanisme qui rend instructif l’incident des 19 et 20 octobre 2025 chez Amazon Web Services, dans la région de Virginie du Nord, us-east-1.
Dans son récit technique publié sur Medium, Dipak Kr das attribue le défaut initial de résolution du point d’accès DynamoDB à une condition de concurrence dans la gestion automatisée du DNS. Autrement dit, des opérations concurrentes de ce dispositif auraient produit un état incorrect. Il s’agit ici de l’explication de cet auteur, non d’une expertise indépendante des systèmes internes d’AWS.
L’intérêt de revenir sur cet épisode ne tient pas seulement à son déclencheur. Il réside dans le décalage entre réparer ce déclencheur et retrouver la faculté de créer de la capacité utilisable. Le DNS répond à la question de l’accès à un service par son nom. Il ne dit pas, à lui seul, si les systèmes dépendants ont achevé leur propre remise en état.
Deux jalons séparés de 11 heures et 25 minutes
ThousandEyes situe le rétablissement des informations DNS au 20 octobre 2025, à 09 h 25 UTC. Son analyse distingue ensuite un intervalle allant de 09 h 25 à 09 h 40 UTC, pendant lequel l’expiration des enregistrements en cache permet de nouveau la résolution du point d’accès et des connexions réussies. Ce sont déjà deux observations différentes : corriger l’information et voir cette correction produire son effet sur les connexions.
La même analyse place à 20 h 50 UTC, ce jour-là, la fin des difficultés affectant le lancement de nouvelles instances EC2 ou leur connectivité. Entre 09 h 25 et 20 h 50, le calcul donne 11 heures et 25 minutes. Cet écart relie deux jalons de nature différente. Il ne mesure ni une panne uniforme pour tous les clients, ni une période pendant laquelle chaque tentative de lancement aurait échoué.
Cette précision change la lecture opérationnelle. Dire que le DNS est rétabli peut être exact alors que déclarer toute la capacité revenue serait prématuré. Inversement, constater des difficultés persistantes de création d’instances ne signifie pas que toutes les machines déjà en fonctionnement sont arrêtées. Le compte rendu doit conserver ces périmètres plutôt que chercher une seule heure qui résumerait tous les services et toutes les applications.
La gestion des machines devait, elle aussi, repartir
La dépendance passait par un composant de gestion d’EC2, le Droplet Workflow Manager, ou DWFM. ThousandEyes explique que l’indisponibilité de DynamoDB empêchait ce composant d’effectuer les vérifications d’état nécessaires, perturbant sa gestion des baux internes. Un bail désigne ici une relation de gestion limitée dans le temps avec un serveur physique, pas le contrat commercial de location conclu par un client.
Le récit de Dipak Kr das précise que DWFM s’appuie sur DynamoDB pour des vérifications d’état concernant les serveurs physiques qui hébergent les instances. Après le retour de DynamoDB, la quantité de travail nécessaire pour rétablir ces relations de gestion aurait submergé DWFM, au point de bloquer sa progression. L’auteur rapporte une limitation du travail entrant et des redémarrages sélectifs d’hôtes DWFM pour débloquer la situation.
La conséquence est plus précise qu’une simple propagation de panne. Le système n’était pas seulement empêché d’avancer par une dépendance absente ; une fois celle-ci revenue, il devait absorber le travail accumulé. En termes de conception, la vitesse de reprise devient alors un problème propre, distinct de la disponibilité du service dont dépend la reprise.
Les interventions décrites portent sur des composants internes d’AWS. Elles ne constituent donc pas une procédure qu’un client EC2 ordinaire pourrait reproduire dans son compte. Pour le client, la question est plutôt de savoir quelles opérations restent possibles pendant que le fournisseur remet ces composants en état, et quelles preuves permettent de constater que cette remise en état produit enfin de la capacité utilisable.
Le lancement ne prouvait pas la disponibilité du réseau
Un deuxième obstacle apparaît dans le même compte rendu de Dipak Kr das : le Network Manager avait accumulé du retard dans la propagation de l’état réseau vers les nouvelles instances. Certaines pouvaient ainsi manquer de connectivité ou échouer aux contrôles de santé. Ce retard est distinct du travail de rétablissement des baux ; il ne décrit pas une panne générale du routage sur Internet.
Une réponse positive au lancement ne suffit donc pas à accepter une machine comme capacité de remplacement. Il faut encore qu’elle communique sur les chemins nécessaires à son rôle. Puis il faut que l’application puisse effectuer une opération représentative. Ces étapes peuvent être liées sans devenir interchangeables : obtenir une instance ne prouve pas que cette instance peut déjà servir des utilisateurs.
Gremlin distingue pour sa part les instances démarrées avant l’événement, qu’il décrit comme restées saines, des difficultés rencontrées pour en lancer de nouvelles après la résolution du problème DynamoDB. Cette distinction ne prouve pas la disponibilité de bout en bout des applications hébergées sur les machines existantes. Leur exécution pouvait se poursuivre sans que toutes leurs dépendances soient, elles aussi, disponibles.
La portée de cette analyse reste délimitée. Elle repose sur la chronologie de ThousandEyes, l’explication publiée par Dipak Kr das et le retour de Gremlin, et non sur une inspection des journaux internes d’AWS. Elle ne chiffre ni les clients touchés ni leurs pertes, et ne mesure pas l’efficacité actuelle des corrections. Elle examine un épisode historique, pas une panne en cours.
La leçon étayée est néanmoins concrète : le rétablissement d’une dépendance, la progression de la gestion des machines, leur connectivité et le succès d’une transaction applicative doivent conserver leurs critères de réussite respectifs. Une architecture redondante mérite d’être évaluée sur ce qu’elle permet effectivement de maintenir ou de reconstruire, sans déduire de cet épisode que toute redondance aurait échoué.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance