
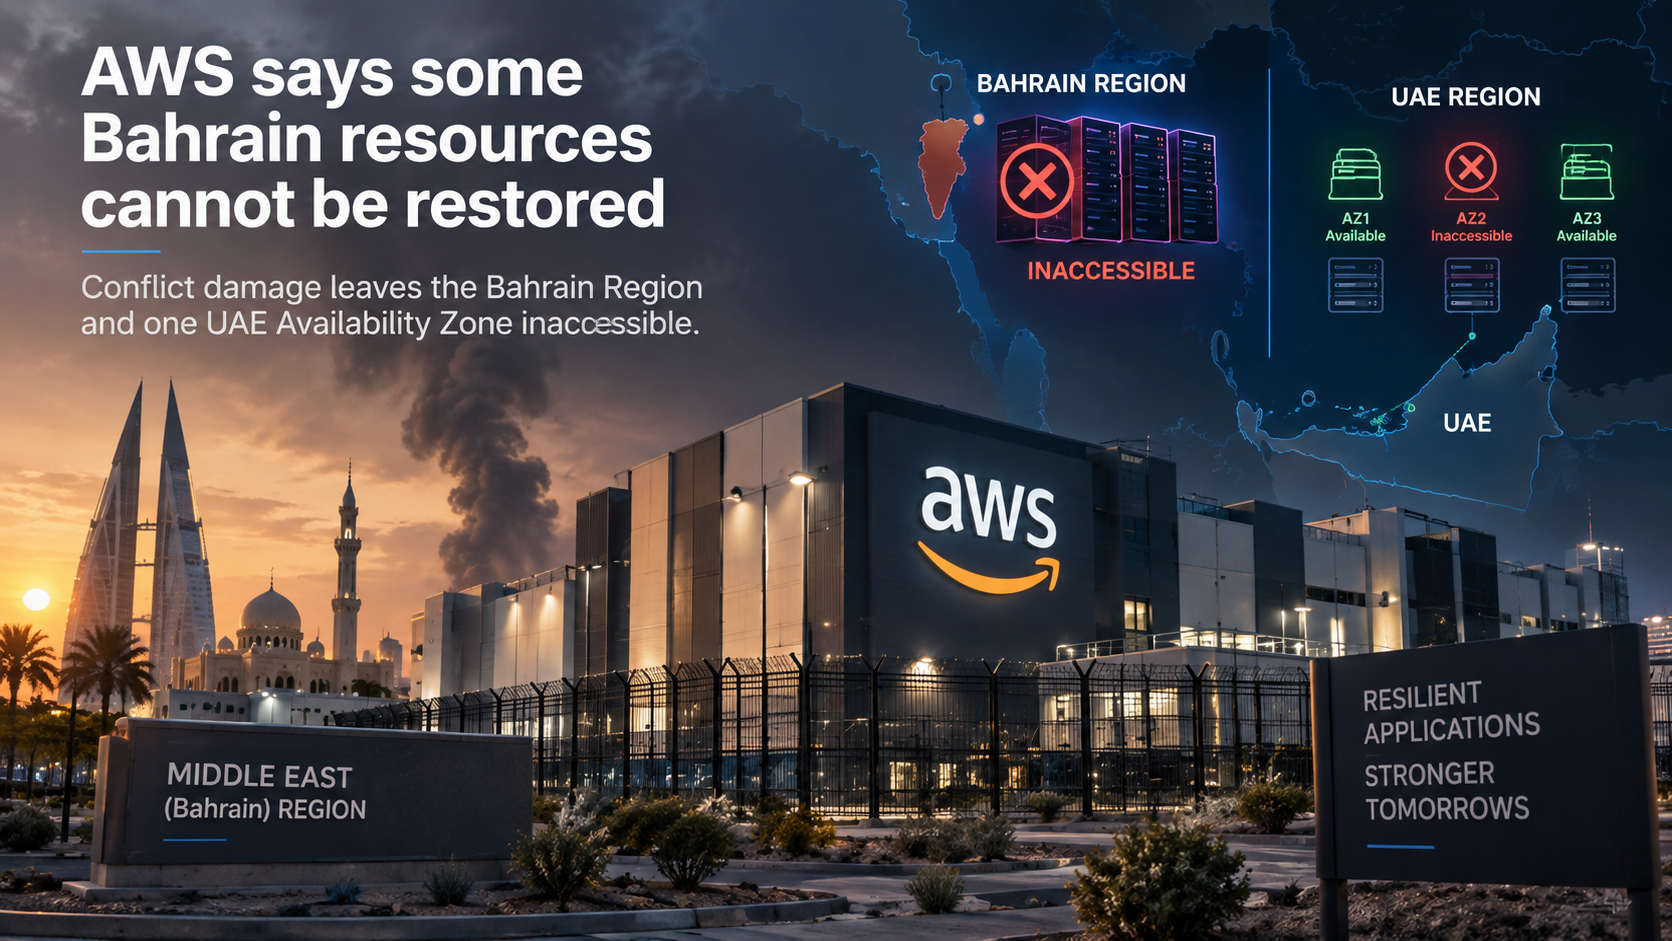
- AWS indique que certaines ressources hébergées uniquement à Bahreïn ou dans une zone de disponibilité touchée aux Émirats arabes unis ne peuvent pas être restaurées après des dommages aux infrastructures liés au conflit
- À Bahreïn, les dommages se sont étendus à plusieurs zones de disponibilité, privant les clients de toute voie de reprise dans la région lorsque celle-ci est devenue indisponible
Les faits
Amazon Web Services a indiqué le 15 septembre qu’elle ne pouvait pas rétablir l’accès à certaines ressources et données hébergées exclusivement dans sa région Moyen-Orient (Bahreïn) ou dans une zone de disponibilité touchée aux Émirats arabes unis. À Bahreïn, AWS a indiqué que les dommages physiques s’étaient étendus à plusieurs zones de disponibilité et avaient dépassé ce que ses services régionaux et multi-AZ étaient conçus pour supporter.
L’entreprise avait conseillé à ses clients de migrer les charges de travail critiques après de précédents dommages, et la plupart d’entre eux l’avaient fait avant qu’une nouvelle perturbation ne rende la région indisponible en avril.
Aux Émirats arabes unis, les ressources et données stockées exclusivement dans la zone de disponibilité touchée restent inaccessibles, tandis que les travaux de reprise se poursuivent ailleurs dans la région. AWS a indiqué que la plupart des clients concernés avaient rétabli leurs activités à l’aide de sauvegardes ou de ressources disponibles en dehors de l’infrastructure endommagée. L’entreprise prévoit de fournir de nouvelles informations sur la reprise aux Émirats arabes unis dans les prochains mois et sur Bahreïn au début de 2027.
L’analyse
La panne à Bahreïn montre où s’arrête la redondance au sein d’une même région cloud. Répartir une application entre plusieurs zones de disponibilité peut la protéger contre de nombreuses défaillances locales, mais n’offre aucune voie de reprise lorsque les dommages touchent plusieurs zones et que la région elle-même devient indisponible.
Les charges de travail qui doivent survivre à une telle défaillance ont besoin de copies utilisables ailleurs avant que la panne ne se produise. Une région secondaire nécessite davantage que des capacités de calcul de secours: les données, les identifiants, la configuration réseau et les autres dépendances doivent également être disponibles et faire l’objet de tests afin que l’application puisse redémarrer.
Pour les lecteurs de BTW, la distinction pratique oppose la redondance au sein d’une région à la reprise en dehors de celle-ci. Une architecture multi-AZ ne permet pas de savoir si une charge de travail peut survivre à la perte d’une région; cela dépend de ce qui a déjà été répliqué, sauvegardé et testé ailleurs.
Points à surveiller
Suivez les prochaines communications d’AWS sur Bahreïn et les Émirats arabes unis pour suivre les progrès du rétablissement des services régionaux. Les retours d’expérience des clients après incident, portant sur les délais de reprise, les copies hors région et les dépendances qui ont retardé le basculement, fourniront les éléments les plus probants sur la manière dont les différentes architectures de résilience se sont comportées lorsqu’une région entière est devenue indisponible.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance