
Resumen
- El incidente de YouTube de 2008 no fue solo la historia de un sitio web bloqueado. La evidencia de recolectores de rutas de RIPE NCC muestra que Pakistan Telecom AS17557 anunció un prefijo más específico de YouTube, PCCW Global AS3491 lo aceptó y propagó, YouTube respondió con anuncios más específicos, y PCCW retiró las rutas después de identificar el problema.
- El problema de rendición de cuentas es el filtrado delegado. Un error local de origen de ruta puede volverse global solo cuando los controles de aceptación y propagación ascendente permiten que escape de su alcance previsto.
- Pakistan Telecom tenía control práctico sobre el anuncio de ruta doméstico y el límite de exportación. PCCW tenía control práctico sobre el filtrado de prefijos ascendente y la propagación. YouTube tenía opciones de mitigación de emergencia, pero no debe ser tratado como la parte principalmente responsable de prevenir anuncios de origen no autorizados de terceros.
- Controles posteriores como la validación de origen RPKI, las acciones de operadores MANRS y las guías de filtrado BGP deben discutirse como contexto de prevención moderna, no como controles que estuvieran maduros o ampliamente desplegados durante febrero de 2008.
- El estándar de reparación duradero es simple de enunciar y difícil de operar: una ruta de control doméstico debe permanecer doméstica, los anuncios no autorizados más específicos deben ser rechazados aguas arriba, y la evidencia de ruta pública debe hacer que tanto el fallo como la recuperación sean verificables.
Una ruta doméstica se convirtió en una interrupción global
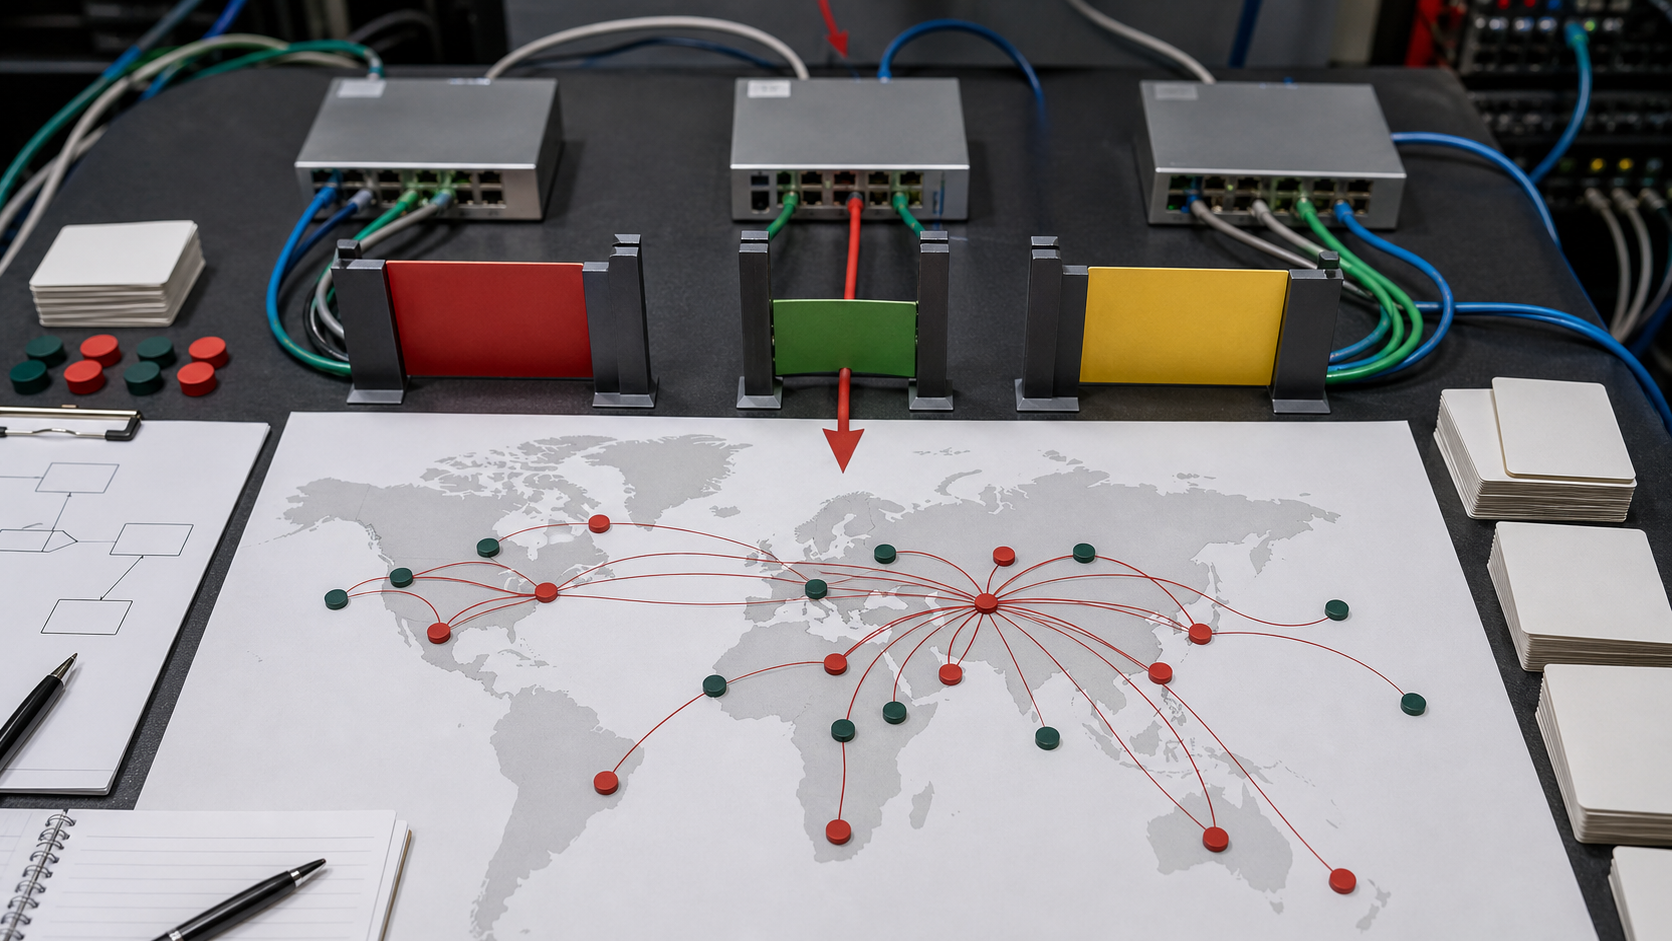
El estudio de caso de RIPE NCC, YouTube hijacking: A RIPE NCC RIS case study, es el registro público principal de evidencia de ruta. Explica que Pakistan Telecom, AS17557, comenzó a anunciar una ruta más específica para el prefijo 208.65.153.0/24 de YouTube, que PCCW Global, AS3491, propagó el anuncio, y que muchas redes prefirieron la ruta más específica sobre el anuncio existente de YouTube. El resultado fue una interrupción global de la accesibilidad de YouTube.
El evento se describe a menudo como un secuestro porque el tráfico hacia un prefijo de YouTube siguió una ruta de origen no autorizada. El trasfondo político fue un intento doméstico de restringir el acceso a YouTube dentro de Pakistán, pero el registro de rendición de cuentas debe ser cuidadoso. El fallo global crucial no fue la existencia de un objetivo de bloqueo doméstico por sí mismo. Fue la exportación de la ruta y la propagación ascendente que permitieron que la ruta doméstica saliera de su límite previsto.
La presentación de RIPE en MENOG, YouTube hijacking case study, y la página de publicación de Google Research, YouTube Hijacking: February 24th, 2008 analysis of BGP routing dynamics, muestran por qué el caso se volvió perdurable en la comunidad de enrutamiento. No fue solo una anécdota. Los recolectores de rutas capturaron una línea de tiempo, caminos AS, especificidad de prefijos y respuesta de emergencia. El artículo técnico de Roma Tre/RIPE, Analysis of BGP routing dynamics, ofrece más detalles sobre las vistas del recolector y el comportamiento de mitigación.
Esa evidencia es infraestructura de rendición de cuentas. Sin ella, el público sabría solo que YouTube dejó de ser accesible y que se culpó a Pakistán. Con ella, el público puede hacer mejores preguntas: ¿Quién anunció la ruta más específica? ¿Quién la aceptó? ¿Quién la propagó? ¿Qué redes la prefirieron? ¿Cómo respondió YouTube? ¿Cuándo ocurrió la retirada ascendente? ¿Qué controles habrían detenido el anuncio más cerca de su origen?
La respuesta es distribuida pero no vaga. Pakistan Telecom controló la originación de la ruta y el alcance de exportación. PCCW controló la aceptación y propagación hacia el internet más amplio. Otras redes controlaron sus propias preferencias de ruta y filtros. YouTube controló la desagregación de emergencia y la coordinación, pero no controló el anuncio no autorizado original. Los usuarios y creadores no controlaron ninguna de las decisiones de enrutamiento.
Rutas más específicas convirtieron la confianza en daño
Los mecanismos básicos de BGP se describen en RFC 4271. Una red anuncia prefijos a los que puede llegar, los vecinos aceptan o rechazan esos anuncios según la política, y la selección de ruta a menudo prefiere prefijos más específicos porque describen un bloque de destino más estrecho. Ese diseño es útil para la ingeniería de tráfico y la conmutación por error. Es peligroso cuando se acepta y propaga un anuncio no autorizado más específico.
En el incidente de YouTube, la ruta más específica fue poderosa porque atrajo tráfico lejos de la ruta legítima más amplia. El estudio de caso de RIPE describe la respuesta de emergencia de YouTube como el anuncio de rutas /25 más específicas para que el tráfico volviera a preferir el origen de YouTube. Esa fue una mitigación efectiva, pero no debe convertirse en la moraleja de la historia. La capacidad de la víctima para combatir un secuestro con desagregación no absuelve a la cadena de origen y ascendente.
El análisis más antiguo de Renesys, preservado en Pakistan hijacks YouTube, y el análisis de CircleID, Pakistan hijacks YouTube: a closer look, ayudaron a explicar el evento a la comunidad más amplia de operaciones de internet. Describen la debilidad de confianza en el enrutamiento entre dominios: las redes a menudo aceptan lo que anuncian los vecinos a menos que los filtros o la validación digan lo contrario. Ese modelo de confianza es operativamente eficiente y estructuralmente frágil.
El fallo de filtrado ascendente es el punto central de rendición de cuentas. Si el anuncio de ruta de Pakistan Telecom hubiera permanecido dentro del entorno doméstico previsto, la interrupción global no habría ocurrido. Si PCCW hubiera rechazado un anuncio de cliente no autorizado para el espacio de direcciones de YouTube, la ruta no se habría propagado globalmente a través de ese camino. El daño público requirió tanto un error de origen como un fallo de aceptación ascendente.
Esto importa porque los errores de enrutamiento a menudo se diluyen a través de muchas redes. Cada operador puede decir que BGP es complejo, que los ascendentes eran de confianza, que los objetos de ruta estaban incompletos o que los filtros eran difíciles. Esas afirmaciones pueden ser ciertas en parte. Pero los clientes y usuarios necesitan un estándar operativo: los proveedores no deben propagar rutas de clientes para espacio de direcciones que el cliente no está autorizado a originar. Si ese estándar no se cumple, una política local puede dañar la accesibilidad global.
Nota de tipografía
Los reportajes capturaron la confusión pública
La evidencia técnica de rutas cuenta la historia de ingeniería. Los reportajes muestran cuán confuso fue el evento para los usuarios comunes. El artículo de Ars Technica Insecure routing redirects YouTube to Pakistan, el de Wired Pakistan's accidental YouTube re-routing, y el de centros de datos Knowledge YouTube offline, Pakistan Telecom blamed describieron la interrupción como un evento de disponibilidad pública más que como un ejercicio interno de enrutamiento.
Ese marco público importa. Los usuarios vieron fallar a YouTube. Los creadores perdieron acceso a una plataforma de distribución. Los anunciantes y editores no pudieron confiar en el servicio. Los operadores de red vieron una ruta no autorizada. Los reguladores y formuladores de políticas vieron las consecuencias de un mecanismo de restricción doméstico que escapaba. Todas esas perspectivas son válidas, pero se adjuntan a diferentes controles.
La rendición de cuentas de Pakistan Telecom no es meramente que la ruta fuera incorrecta. Es que se permitió que una ruta destinada al control doméstico ingresara al sistema de enrutamiento global. Un operador de telecomunicaciones nacional tiene el deber de entender que la exportación BGP no es un interruptor local. Anunciar una ruta a un proveedor ascendente puede invitar a la propagación global a menos que las políticas lo impidan. Si la ruta es un mecanismo de bloqueo en lugar de un origen legítimo, el límite de exportación es un control de seguridad pública.
La rendición de cuentas de PCCW es el filtrado ascendente. Un proveedor de tránsito se encuentra en un límite de confianza poderoso. Puede evitar que una ruta errónea o no autorizada de un cliente se propague. Puede mantener filtros de prefijos explícitos, verificaciones de objetos de ruta, límites máximos de prefijos, contratos de clientes y rutas de contacto de emergencia. También puede fallar en hacerlo, en cuyo caso el error del cliente se convierte en un evento de internet. El incidente de 2008 muestra por qué los proveedores ascendentes no son tuberías pasivas.
La rendición de cuentas de YouTube es diferente. La plataforma tuvo que monitorear la accesibilidad, coordinar con redes y mitigar mediante anuncios más específicos. Pero no se debe esperar que la plataforma víctima defienda continuamente contra cada origen no autorizado desagregando cada vez que un ascendente acepta una ruta incorrecta. Esa estrategia es respuesta de emergencia, no un modelo de gobernanza. El control más limpio es rechazar anuncios no autorizados antes de que se propaguen.
Herramientas posteriores de seguridad de rutas explican la dirección de reparación
El incidente de 2008 precedió al despliegue operativo amplio de muchas herramientas posteriores de seguridad de rutas. RFC 6811, BGP Prefix Origin Validation, y RFC 6480, An Infrastructure to Support Secure Internet Routing, proporcionan contexto de RPKI y validación de origen. Estos estándares no deben leerse retrospectivamente en 2008 como si el despliegue maduro estuviera disponible en todas partes. Son útiles porque definen una pregunta de evidencia moderna: ¿está el AS anunciante autorizado a originar este prefijo?
La validación de origen no resolvería todos los problemas de enrutamiento. Ayuda con anuncios de origen no autorizados cuando las redes crean Autorizaciones de Origen de Ruta y cuando otras redes validan y rechazan rutas inválidas. No resuelve completamente las filtraciones de política, las violaciones valley-free ni todos los errores de ingeniería de tráfico. Pero el caso de YouTube es un fuerte ejemplo de por qué la evidencia de origen importa. Una red no debe aceptar un prefijo originado por un cliente para una plataforma global a menos que haya evidencia de autorización.
RFC 7454, BGP Operations and Security, y RFC 7908, Problem Definition and Classification of BGP Route Leaks, ayudan a enmarcar los controles operativos. Filtrar prefijos de clientes, mantener datos precisos de política de rutas, limitar la propagación de rutas, coordinar durante incidentes y comprender los patrones de filtraciones de rutas son deberes rutinarios del operador. Documentos posteriores dieron un vocabulario más preciso a los problemas que el evento de YouTube hizo visibles.
Las acciones de operadores de red de MANRS y la guía Securing Internet Routing de CISA muestran la dirección moderna de rendición de cuentas: filtrado, anti-suplantación, coordinación y validación. Estos programas y guías no son hallazgos de incidentes. Son evidencia de que la comunidad de internet y las agencias públicas ahora tratan la seguridad del enrutamiento como una obligación de infraestructura compartida.
La dirección de reparación es, por lo tanto, en capas. Las redes de origen como Pakistan Telecom deben mantener las rutas de control doméstico con alcance y prevenir la exportación no autorizada. Los ascendentes deben filtrar a los clientes contra la autorización explícita de prefijos. Otras redes deben validar orígenes cuando sea posible. Las plataformas deben mantener registros de enrutamiento precisos y monitorear anomalías de rutas. Los organismos de medición deben preservar la evidencia de rutas. Las agencias públicas deben fomentar la adopción para servicios críticos. Ninguna capa es suficiente;
el evento de 2008 requirió que múltiples capas fallaran.
Los recolectores de rutas hicieron revisable el evento
El Routing Information Service de RIPE NCC explica el sistema de recolectores de rutas detrás de la evidencia pública. RIS y sistemas similares recopilan anuncios BGP desde muchos puntos de observación, permitiendo a los analistas reconstruir cómo se propagan las rutas. En el incidente de YouTube, esa evidencia mostró la sincronización, los caminos AS y el cambio de la ruta más específica de Pakistan Telecom a los anuncios de emergencia de YouTube y la eventual retirada.
Esta capa de medición no es solo académica. Apoya la rendición de cuentas en un sistema donde muchos actores pueden negar visibilidad. Un usuario no puede inspeccionar BGP. Una plataforma puede ver pérdida de tráfico pero no todos los caminos de propagación. Un ascendente puede ver su propia decisión pero no la preferencia global. Los recolectores de rutas proporcionan un registro compartido que permite a la comunidad identificar lo que sucedió y aprender de ello.
La evidencia pública de rutas también cambia los incentivos. Si las filtraciones y secuestros de rutas son visibles, los operadores tienen razones reputacionales para mejorar. Si las fallas de propagación son oscuras, el costo recae principalmente en los usuarios y las plataformas víctimas. La visibilidad no reemplaza la regulación formal o los contratos, pero crea disciplina pública. El caso de YouTube se hizo famoso en parte porque la evidencia fue lo suficientemente sólida para enseñar.
Para Pakistan Telecom, la evidencia pública dejó claro que la ruta se originó dentro de su AS. Para PCCW, la evidencia mostró propagación ascendente. Para YouTube, mostró respuesta de emergencia. Para otras redes, mostró cómo se extendió la preferencia de ruta. Esa claridad es rara y valiosa. Permite que la rendición de cuentas sea específica sin pretender que un solo actor controlara todo el internet.
La lección para incidentes modernos de rutas es preservar y publicar evidencia rápidamente. Los operadores deben mantener registros BGP, registros de cambios de rutas, datos de autorización de clientes y comunicación de incidentes. Cuando aparece una ruta incorrecta, la pregunta no debe resolverse mediante rumores. Debe resolverse mediante evidencia de ruta, decisiones con marca de tiempo y registros de retirada claros.
Las políticas de filtrado doméstico necesitan salvaguardas de exportación
El contexto político del evento de YouTube es sensible porque involucró restricción de contenido. El análisis de rendición de cuentas no necesita respaldar o reabrir la política doméstica para llegar a una conclusión clara de control de red. Cualquier ruta de filtrado doméstico, ruta de agujero negro o medida local de ingeniería de tráfico debe evitar la exportación global si no es una ruta global legítima. La intención doméstica no es una defensa contra la propagación global.
Los operadores de telecomunicaciones a menudo operan en el límite entre la política nacional y las redes globales. Eso les otorga deberes especiales. Un cambio de ruta realizado con un propósito doméstico puede afectar a usuarios extranjeros, empresas extranjeras, proveedores de tránsito, anunciantes y creadores si ingresa al BGP global. Los operadores deben tratar el control de exportación como un control de gobernanza, no solo una configuración de enrutador.
Las salvaguardas prácticas incluyen mapas de ruta que bloquean la publicidad de prefijos solo domésticos hacia el ascendente, verificaciones explícitas de prefijo máximo y lista de prefijos, flujos de trabajo internos de aprobación para rutas de agujero negro o bloqueo, simulación de exportación de ruta antes de la activación, monitoreo de propagación ascendente no intencionada y procedimientos de retirada de emergencia con contactos ascendentes. Estos son controles de ingeniería ordinarios, pero el incidente de YouTube muestra su importancia pública.
Los proveedores ascendentes necesitan controles de clientes correspondientes. Un proveedor de tránsito no debe aceptar la ruta más específica de un cliente hacia un prefijo importante de un tercero a menos que haya una relación de cliente clara y autorización. Eso implica mantener listas de prefijos de clientes, validar objetos de ruta, usar RPKI cuando esté disponible, monitorear anuncios más específicos sospechosos y responder rápidamente cuando una ruta originada por un cliente cause anomalías globales de accesibilidad.
La parte más difícil es la disciplina operativa en el tiempo. Los filtros pueden volverse obsoletos. Los clientes pueden cambiar prefijos. Los objetos de ruta pueden ser incorrectos. El personal puede eludir los controles durante emergencias. La presión comercial puede favorecer el aprovisionamiento rápido sobre la validación estricta. El estándar de reparación debe incluir auditorías y simulacros, no solo políticas escritas. Un filtro de prefijos que existe pero no se mantiene no es un control.
La desagregación de emergencia no debe convertirse en la defensa normal
Los anuncios de emergencia más específicos /25 de YouTube fueron una respuesta efectiva en el registro público de rutas. Cambiaron la preferencia de ruta de vuelta hacia YouTube para muchas redes. Pero la desagregación de emergencia tiene costos y límites. Agrega rutas más específicas a la tabla global, puede no ser aceptada uniformemente y requiere que la víctima reaccione rápidamente a un fallo que no originó. Es una mitigación, no prevención.
Las plataformas víctimas aún deben prepararse. Deben monitorear los cambios de origen de ruta, mantener datos precisos de IRR y RPKI, conocer los contactos de emergencia en los principales proveedores de tránsito y tener opciones de ingeniería de tráfico. Una plataforma importante tiene responsabilidades prácticas porque los usuarios dependen de la accesibilidad. Pero esas responsabilidades son secundarias a los controles de origen y ascendente que deberían prevenir la propagación no autorizada.
Esta distinción importa para la asignación de costos. Si la plataforma víctima debe defender continuamente sus propios prefijos contra rutas incorrectas aceptadas por ascendentes, el internet ha desplazado el costo del filtrado hacia la parte perjudicada. El control más eficiente se encuentra más cerca del anuncio del cliente: las redes de origen no deben exportar rutas no autorizadas, y los ascendentes no deben aceptarlas. Ese es el principio de filtrado delegado.
La respuesta de emergencia también debe medirse. ¿Qué tan rápido detectó la víctima el secuestro? ¿Qué tan rápido coordinó? ¿Qué redes aceptaron los anuncios de emergencia? ¿Cuándo ocurrió la retirada ascendente? ¿Qué usuarios permanecieron afectados después de la mitigación? Estas preguntas ayudan a mejorar la respuesta sin excusar el fallo inicial de filtrado.
El incidente de YouTube sigue siendo útil porque muestra ambos lados: los controles ascendentes fallaron, y la desagregación de emergencia de la víctima ayudó a la recuperación. Una cultura madura de seguridad de enrutamiento aprende de ambos sin confundirlos. La prevención pertenece a los filtros de origen y ascendente. La mitigación pertenece a la coordinación de la víctima y el operador. La evidencia pertenece a los sistemas públicos de medición.
Incógnitas residuales y la pregunta de rendición de cuentas
Varios hechos permanecen incompletos. El registro público no expone cada decisión interna dentro de Pakistan Telecom o cualquier regulador involucrado en la orden de bloqueo doméstico. No muestra cada configuración de filtro de PCCW o justificación de aprovisionamiento. No cuantifica la pérdida económica de usuarios, creadores, anunciantes o plataformas por región. No puede probar exactamente cómo la adopción posterior de filtrado de rutas, RPKI o prácticas MANRS cambió riesgos comparables.
Esas incógnitas no debilitan la cadena central de rendición de cuentas. Pakistan Telecom originó una ruta no autorizada más específica para el espacio de direcciones de YouTube. PCCW la propagó. Otras redes prefirieron la ruta. YouTube mitigó con anuncios más específicos. PCCW retiró rutas. RIPE y otros analistas preservaron evidencia. Los usuarios de todo el mundo sufrieron la interrupción.
La pregunta de rendición de cuentas es si los mecanismos de control de ruta domésticos se evitan que se conviertan en anuncios de ruta globales. Para un operador de origen, la respuesta depende del alcance de exportación y los controles internos. Para un proveedor ascendente, la respuesta depende del filtrado de prefijos y la validación. Para otras redes, la respuesta depende de la validación de origen y la higiene de seguridad de rutas. Para las plataformas, la respuesta depende del monitoreo y la coordinación de emergencia. Para las agencias públicas, la respuesta depende de tratar la seguridad de rutas como política de infraestructura.
El incidente de febrero de 2008 es antiguo, pero el problema de incentivos es actual. Los operadores locales pueden tener razones para manipular rutas con fines domésticos. Los ascendentes pueden tener razones comerciales para aprovisionar clientes rápidamente. Las plataformas víctimas pueden tener presión pública para restaurar el servicio instantáneamente. Los usuarios casi no tienen poder sobre nada de eso. La rendición de cuentas requiere controles en los puntos de poder práctico, no en el punto de la frustración del usuario.
El estándar más simple sigue siendo el más fuerte: no anuncies lo que no posees, no exportes controles domésticos al internet global, no aceptes rutas de clientes sin evidencia de autorización, y preserva los datos de ruta para que el público pueda ver lo que sucedió. El secuestro de YouTube por Pakistan Telecom mostró lo que sucede cuando ese estándar falla. El registro de reparación es la prueba continua de que los operadores aprendieron a mantener las decisiones de enrutamiento doméstico como domésticas.
El filtrado ascendente es un deber comercial, no solo una cortesía
Los proveedores de tránsito venden accesibilidad. Eso les da un incentivo comercial para aceptar y propagar rutas de clientes rápidamente. Pero la accesibilidad sin verificaciones de autorización puede dañar a todos los demás. El incidente de YouTube mostró que el filtrado ascendente no es meramente una cortesía hacia la plataforma víctima. Es parte de la calidad del producto del servicio de tránsito. Un proveedor que acepta rutas de clientes no autorizadas puede exportar errores de clientes al internet.
Este deber es más fuerte en el límite del cliente. Un proveedor de tránsito tiene una relación definida con su cliente. Puede saber qué prefijos el cliente está autorizado a anunciar. Puede mantener listas de prefijos, objetos de ruta, validación RPKI y verificaciones de incorporación de clientes. Puede limitar prefijos máximos. Puede requerir aviso previo para anuncios más específicos inusuales. Puede rechazar rutas que no coincidan con la autorización. Estos controles son más prácticos en el borde del cliente que después de que una ruta se haya propagado.
El costo del filtrado débil se externaliza. El ascendente puede recibir el pago del cliente, pero la plataforma víctima y los usuarios globales absorben la interrupción. Ese es el problema de incentivos. El filtrado estricto requiere trabajo operativo y puede retrasar ocasionalmente los cambios del cliente. El filtrado laxo es más fácil hasta que causa un evento global. La rendición de cuentas debería recompensar al proveedor que hace el trabajo aburrido de validación antes de la propagación.
El incidente de YouTube también muestra por qué los proveedores ascendentes deben tener rutas de retirada de emergencia. Una vez que una ruta incorrecta se propaga, la velocidad importa. El ascendente debe ser accesible por los operadores de la plataforma víctima y por las comunidades de seguridad de rutas. Debe tener autoridad para retirar o filtrar la ruta rápidamente. Debe preservar registros para que el incidente pueda revisarse. Un proveedor que carece de contactos de emergencia extiende el daño incluso después de que se conoce la causa.
Los contratos comerciales pueden reforzar este deber. Los acuerdos de tránsito pueden requerir autorización precisa de prefijos, cooperación del cliente con la validación de rutas, mantenimiento de contactos de emergencia y aceptación de filtros cuando las rutas parezcan no autorizadas. Los contratos no deben permitir que un cliente trate la propagación global como un efecto secundario sin consecuencias. Si una red doméstica anuncia una ruta que no posee, el ascendente debe tener autoridad tanto técnica como contractual para detenerla.
Las herramientas de política doméstica deben separarse del enrutamiento global
El contexto de 2008 involucró una restricción de contenido doméstico. Eso hace que el incidente sea relevante para cualquier estado u operador de telecomunicaciones que utilice controles de red con fines políticos. Un bloqueo doméstico, sumidero, agujero negro o ruta de filtrado debe diseñarse para que no pueda filtrarse más allá del entorno doméstico. El deber del operador no es solo implementar la política. Es evitar que la implementación dañe a usuarios globales no relacionados.
Los diseños más seguros evitan la exposición BGP global para controles domésticos. El filtrado puede aplicarse más cerca de los usuarios a través de mecanismos de política local, controles DNS, controles de proxy o enrutamiento interno que esté explícitamente bloqueado para exportación ascendente. Si se usa BGP internamente, los mapas de ruta y los filtros de exportación deben evitar cualquier anuncio a proveedores de tránsito. El monitoreo debe alertar si los prefijos solo domésticos aparecen en puntos de observación externos.
Esta separación debe gobernarse. Una ruta utilizada para restricción doméstica debe requerir revisión por parte de los equipos de ingeniería de red, seguridad y riesgo operativo. La revisión debe preguntar si el prefijo es propiedad del operador, si la ruta se exportará, qué filtros ascendentes existen, cómo verificar el confinamiento y cómo retirar la ruta. El proceso no debe ser un cambio informal en un enrutador de producción.
Las autoridades públicas deben preocuparse por esto porque los errores domésticos pueden crear daños extranjeros. Un regulador puede tener la intención de afectar a usuarios dentro de un país; una filtración de ruta afecta a usuarios en otros lugares y puede dañar la credibilidad de telecomunicaciones del país. El enrutamiento es una dependencia internacional. Los operadores nacionales que participan en BGP global tienen obligaciones más allá del cumplimiento de políticas domésticas.
El caso de YouTube es poderoso porque colapsó el límite entre la política doméstica y la infraestructura global. La ruta no era simplemente un bloqueo local. Se convirtió en una preferencia de ruta global. El estándar de reparación es, por lo tanto, institucional: los sistemas de control doméstico deben diseñarse, revisarse y monitorearse para que no puedan usar la tabla de enrutamiento global como un mecanismo de aplicación accidental.
RPKI cambia la evidencia, pero no la responsabilidad
Las discusiones modernas a menudo saltan a RPKI, y por una buena razón. Si YouTube hubiera tenido autorización de origen válida y las redes hubieran rechazado ampliamente los orígenes inválidos, un anuncio no autorizado de Pakistan Telecom habría sido más fácil de filtrar. Pero RPKI no elimina la responsabilidad humana y contractual. Las redes de origen aún no deben anunciar espacio no autorizado. Los ascendentes aún deben validar y filtrar. Las plataformas aún deben publicar datos de autorización precisos. Los operadores aún deben monitorear.
RPKI también depende de la adopción. Una ROA válida ayuda solo si las rutas se validan y los anuncios inválidos son rechazados por las redes en el camino. Algunas redes pueden monitorear pero no rechazar. Algunos prefijos pueden carecer de ROAs. Algunos incidentes involucran filtraciones de rutas donde el origen es válido pero la política de propagación es incorrecta. Por lo tanto, RPKI es infraestructura de evidencia necesaria, no un escudo mágico.
El incidente de 2008 sigue siendo útil porque explica la necesidad de evidencia de origen en términos humanos. Los usuarios no sabían ni les importaban las ROAs. Les importaba que YouTube no estuviera accesible. Los operadores vieron que un cliente podía originar una ruta para el prefijo de otra persona y que la propagación ascendente podía hacerla global. RPKI responde a parte de ese problema dando a las redes una forma criptográfica de verificar la autorización de origen.
El uso responsable de RPKI después de tales incidentes es específico. Los titulares de prefijos deben crear y mantener ROAs precisas. Los proveedores de tránsito deben validar a los clientes y rechazar inválidos donde la política lo permita. Los sistemas de monitoreo deben alertar a los titulares de prefijos cuando aparezcan orígenes inválidos o sospechosos. Los programas del sector público deben fomentar la adopción para servicios críticos. Los clientes deben preguntar a los proveedores sobre la validación de origen. El estándar se convierte en "usa la evidencia disponible antes de aceptar la ruta".
La responsabilidad aún sigue al control. Si una ruta es inválida y un ascendente la acepta a pesar de la validación disponible, el ascendente no puede culpar solo al protocolo. Si un titular de prefijo no mantiene datos de autorización, debilita la evidencia que otros necesitan. Si una red de origen exporta rutas no autorizadas, sigue siendo responsable de la primera mala acción. RPKI aclara la responsabilidad; no la disuelve.
La plataforma orientada al usuario debe explicar sin asumir culpas falsas
YouTube fue la plataforma afectada. Los usuarios experimentaron YouTube como caído. Eso crea un deber de comunicación para la plataforma, incluso cuando no originó la ruta incorrecta. La plataforma debe informar a los usuarios que la accesibilidad está afectada, aclarar cuándo el registro público respalda una causa de enrutamiento y evitar implicar una violación de datos si la evidencia respalda solo una interrupción de disponibilidad.
Al mismo tiempo, la plataforma no debe absorber una responsabilidad falsa por el fallo de enrutamiento. Si una red externa originó y propagó una ruta no autorizada, el público debe entender que el camino de control estaba fuera de la plataforma. El mensaje correcto es equilibrado: los usuarios están afectados, la plataforma está respondiendo, está involucrada la propagación de rutas externas, la pérdida de disponibilidad no implica violación de datos, y se está coordinando con los operadores de red.
Esta distinción importa para la confianza. Si la plataforma dice demasiado poco, los usuarios pueden suponer que la aplicación falló o que la plataforma censuró contenido. Si dice demasiado antes de que la evidencia esté confirmada, puede identificar incorrectamente a las partes responsables. Si evita explicar la capa de enrutamiento por completo, el público pierde la lección estructural. Una buena comunicación enseña suficiente del modelo de dependencia de internet para reducir la confusión.
Las plataformas también deben usar tales incidentes para mejorar su propia higiene de rutas. Pueden mantener objetos IRR precisos, ROAs, contactos de peering, monitoreo de rutas y planes de desagregación de emergencia. Pueden participar en foros de operadores y fomentar el filtrado ascendente. Estos pasos no hacen que la plataforma sea responsable del secuestro, pero reducen el daño y mejoran la evidencia.
El incidente de YouTube asigna, por lo tanto, un deber de respuesta a la plataforma en lugar de una carga de prevención por el error de origen. Esa distinción es importante en el trabajo de rendición de cuentas. La parte con control práctico sobre la ruta incorrecta debe tener la responsabilidad principal. La plataforma afectada debe comunicar, coordinar y mitigar. El usuario no debe quedarse adivinando.
La evidencia de rutas debe alimentar la educación y las adquisiciones
La comunidad de enrutamiento aprendió del incidente de YouTube porque la evidencia era enseñable. Prefijos, ASN, marcas de tiempo y recolectores de rutas convirtieron una interrupción pública en un estudio de caso. Ese valor educativo debe preservarse en la capacitación de operadores. Los ingenieros que aprenden BGP deben estudiar no solo la sintaxis del protocolo sino las consecuencias sociales de los errores de exportación de rutas. Un anuncio de ruta puede convertirse en un acto público.
Las adquisiciones también deben aprender. Las empresas, agencias públicas y plataformas que compran tránsito deben preguntar a los proveedores sobre el filtrado de prefijos, la validación RPKI, la autorización de rutas de clientes, los contactos de emergencia y la participación en programas de seguridad de enrutamiento. Estas preguntas convierten un incidente famoso en presión de mercado. Los proveedores que pueden demostrar controles sólidos deben tener una ventaja. Los proveedores que tratan el filtrado como opcional deben enfrentar preguntas más difíciles.
Las redes más pequeñas también necesitan orientación utilizable. No todos los ISP locales tienen un gran equipo de seguridad de enrutamiento. Los programas comunitarios, los registros regionales de internet y las agencias públicas pueden proporcionar plantillas, capacitación y herramientas de medición. El objetivo no es avergonzar a los pequeños operadores por la complejidad. Es hacer que el camino más seguro sea más fácil de operar que el camino inseguro.
El caso de YouTube sigue siendo relevante porque internet todavía depende de que muchas redes tomen decisiones disciplinadas. Un solo operador doméstico y un ascendente fueron suficientes para afectar a una plataforma global en 2008. Hoy, la red de dependencias es más grande, y muchos más servicios se consideran esenciales. El costo del filtrado laxo es, por lo tanto, mayor, no menor.
La evidencia de reparación que el público debe esperar es acumulativa: autorización de ruta más precisa, más rechazo de orígenes inválidos, mejores filtros de prefijos de clientes, contactos de incidentes más rápidos, mejor medición pública y menos filtraciones a gran escala de rutas domésticas o de clientes. Un solo control no eliminará el riesgo. Una cultura de filtrado ascendente puede hacer que el próximo error sea más pequeño.
La disciplina de filtrado necesita un circuito de retroalimentación
Los controles de seguridad de enrutamiento se degradan a menos que se mantengan. Una lista de prefijos que era correcta cuando se incorporó un cliente puede volverse obsoleta después de fusiones, renumeraciones, nuevos servicios o cambios de emergencia. Un objeto de ruta puede faltar o ser incorrecto. Una ROA puede estar ausente, ser demasiado amplia o invalidar accidentalmente. Un cliente puede solicitar un cambio bajo presión de tiempo. Un proveedor puede hacer una excepción y olvidarse de cerrarla. El incidente de YouTube debe leerse como una advertencia sobre este problema de mantenimiento, no solo como un error de un día.
El circuito de retroalimentación comienza con la autorización del cliente. Los proveedores de tránsito deben saber qué están autorizados a anunciar sus clientes y deben tener un proceso para actualizar esa lista. El siguiente paso es la validación en el momento de la aceptación: ¿coincide esta ruta con el registro del cliente, los datos del registro de ruta o el estado RPKI? El siguiente paso es el monitoreo después de la aceptación: ¿la ruta del cliente se volvió repentinamente visible globalmente de manera sospechosa, o atrajo tráfico para un tercero de alto perfil?
El paso final es la corrección posterior al incidente: si se aceptó una ruta incorrecta, ¿por qué el control no la detectó?
Los organismos de medición y los recolectores públicos de rutas ayudan a cerrar ese circuito. Los operadores pueden comparar su propia vista con puntos de observación externos. Si una ruta solo doméstica aparece fuera de la región prevista, deben activarse alarmas. Si un cliente comienza a anunciar prefijos más específicos para otra organización, el evento debe escalarse. La visibilidad externa convierte la seguridad de enrutamiento de confianza en evidencia.
El circuito también necesita gobernanza. Alguien debe ser responsable de la calidad del filtro. Alguien debe auditar las listas de prefijos de clientes. Alguien debe revisar las excepciones de emergencia. Alguien debe mantener las rutas de contacto con clientes y pares. Sin propiedad, el filtrado de rutas se convierte en un hábito de mejor esfuerzo. El evento de YouTube muestra por qué el mejor esfuerzo no es suficiente para redes cuyos errores pueden interrumpir plataformas importantes.
Para los operadores de telecomunicaciones nacionales, el circuito de retroalimentación debe incluir cambios de política. Si se utilizan medidas de bloqueo o control de tráfico doméstico, deben revisarse para detectar riesgo de exportación antes de la activación. Después de la activación, los recolectores de rutas externos deben verificarse para confirmar el confinamiento. Después de la desactivación, las tablas de rutas deben verificarse para asegurarse de que la ruta de control haya desaparecido. Esto no es burocracia excesiva. Es el costo de participar en el enrutamiento global mientras se aplican controles domésticos.
Para las plataformas, el circuito de retroalimentación incluye monitoreo de rutas y simulacros de contacto. La desagregación de emergencia de YouTube mostró que la respuesta de la víctima puede ayudar, pero las plataformas no deben esperar a que los usuarios informen fallos de accesibilidad. Las alertas de origen de ruta, el monitoreo del estado de validación y los contactos ensayados con los principales proveedores de tránsito pueden reducir el tiempo hasta la contención. Ese trabajo complementa el filtrado ascendente sin desplazar la culpa principal a la víctima.
El beneficio público de un circuito de retroalimentación es un radio de explosión más pequeño. Una ruta incorrecta aún puede anunciarse. Un filtro aún puede pasar algo por alto. Pero si el monitoreo detecta la ruta rápidamente, los contactos funcionan y la retirada está ensayada, el evento se convierte en un incidente operativo breve en lugar de una interrupción global de plataforma. El objetivo de rendición de cuentas no es un internet perfecto. Es un sistema de enrutamiento que detecta y contiene errores antes de que los usuarios de todas partes paguen por ellos.
El caso aún importa para la credibilidad de la red nacional
El incidente de Pakistan Telecom tuvo consecuencias reputacionales más allá de YouTube. Un operador nacional que participa en el enrutamiento global es confiado por ascendentes y pares. Cuando su anuncio de ruta doméstica interrumpe una plataforma global, otros operadores aprenden algo sobre su control de cambios, política de exportación y respuesta de emergencia. Esa capa reputacional puede ser constructiva si impulsa mejores controles.
La credibilidad de la red nacional depende de límites disciplinados. La política doméstica puede ser controvertida, pero el deber de enrutamiento es más claro: no permitir que una implementación doméstica escape a la accesibilidad global. Un operador que puede mostrar filtros de exportación estrictos, objetos de ruta validados, contactos de emergencia y aprendizaje transparente de incidentes gana confianza. Un operador que trata la propagación de rutas como un problema de otro debilita la confianza en toda la comunidad de operadores.
Las agencias públicas también tienen un papel en proteger esa credibilidad. Los reguladores que requieren o solicitan restricciones a nivel de red deben entender el radio de explosión técnico. Deben evitar instrucciones que fomenten un comportamiento inseguro de enrutamiento global. Deben pedir a los operadores que demuestren contención y reversión. Un objetivo político no excusa una mala ingeniería de red, especialmente cuando los usuarios globales pueden verse afectados.
Para la comunidad de enrutamiento en general, el caso sigue siendo un ejemplo de capacitación porque es legible. Los ASN, prefijos, camino de propagación, mitigación de emergencia y retirada son visibles en el registro público. Esa legibilidad hace que la lección de gobernanza sea duradera: el control práctico reside en los puntos de origen, ascendente, validación, monitoreo y coordinación. La rendición de cuentas debe seguir esos puntos, no el nombre de la marca que los usuarios ven en su navegador.