Resumen
- RIPE NCC registró errores intermitentes en las actualizaciones WHOIS a las 20:04 CET del 28 de octubre, devolvió la base a estado operativo a las 20:23 y cerró el incidente a las 20:32.
- El parte describe la recuperación del servicio, sin identificar las solicitudes ni los objetos cuyo resultado de escritura requiere comprobación.
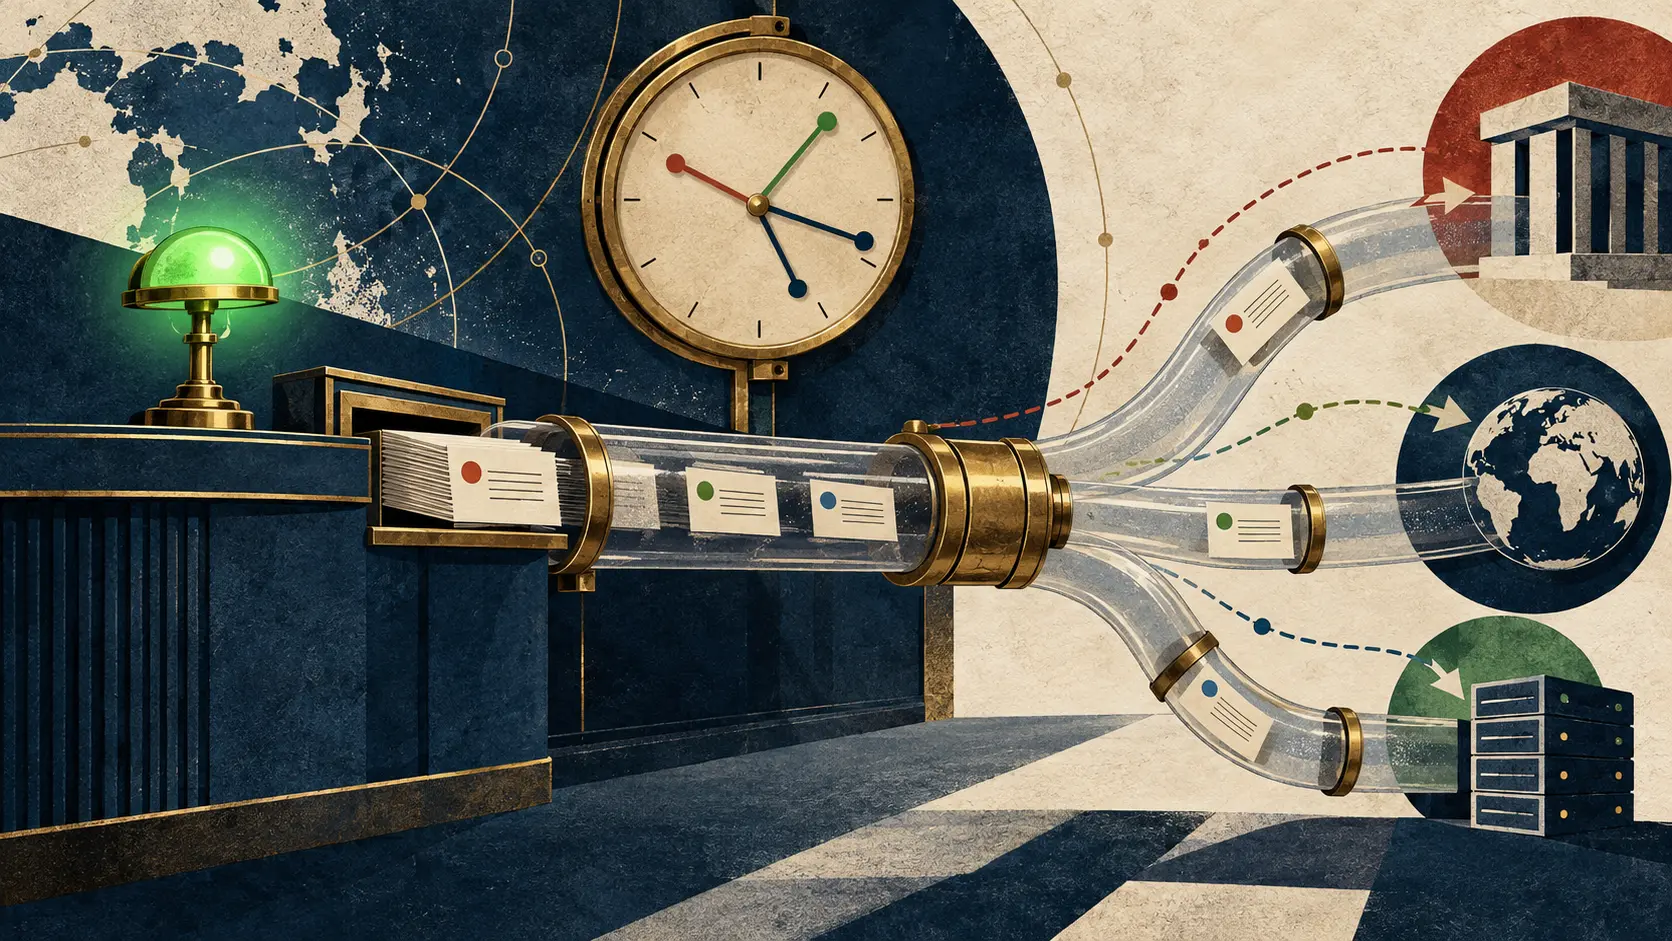
Un semáforo verde sirve para enviar la próxima modificación. Para la que salió antes, hace falta un recibo. Esa diferencia quedó expuesta el 28 de octubre, cuando RIPE NCC informó de fallos intermitentes al actualizar WHOIS.
El registro estructurado del incidente fija tres hitos en horario CET: investigación a las 20:04:48, corrección y vigilancia a las 20:23:24, resolución a las 20:32:00. El componente RIPE Database pasó a «interrupción parcial» y volvió a «operativo» al aplicarse la corrección. El incidente lleva además una etiqueta global de impacto «major». Ni la etiqueta ni las horas revelan cuándo falló la primera petición de un usuario, cuántas escrituras quedaron pendientes o cuál fue la causa. La ficha tampoco distingue los canales de actualización afectados.
Los canales importan porque no responden igual. La guía oficial de acuses indica que cada envío recibe un acuse con los resultados de los objetos que contiene. En Syncupdates, HTTP 200 puede significar que el mensaje se procesó aunque alguna operación individual fallara; hay que leer el resumen. REST devuelve XML o JSON. Esta regla describe el servicio habitual, no una explicación inventada para el incidente.
Hay otro caso que impide pulsar «reenviar» por reflejo. Según la documentación del procesamiento, los objetos de un mismo envío se tratan por separado. Si se cierra una conexión HTTP síncrona, el trabajo puede concluir en la base sin que el cliente reciba el acuse por esa conexión. Antes de repetir una petición, el titular necesita cotejar su respuesta y consultar el objeto autoritativo. El parte colectivo no puede hacer esa lectura individual.
RIPE NCC publicó la hora de la reparación y la del cierre. Falta una línea igualmente útil para quienes escribieron durante el incidente: qué métodos fueron afectados, qué clase de error se produjo y cómo reconciliar los envíos sin respuesta. Ese dato convertiría el verde del tablero en una instrucción de trabajo.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para el Círculo Estratégico
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance