
Zusammenfassung
- RFC 3066 vereinheitlichte Syntax, öffentliche Registrierung und die Zuordnung von Sprachbereichen zu Tags, überließ aber jedem Protokoll, welche Aussage das Tag über sein Informationsobjekt traf.
- Der RFC warnte ausdrücklich, dass eine gemeinsame Tag-Präfixfolge keine gegenseitige Verständlichkeit garantiert. Ein Treffer ist ein Auswahlresultat, kein Nachweis für eine korrekte Kennzeichnung, gute Darstellung oder tatsächliches Verstehen.
Ein kleines Tag für eine große menschliche Tatsache
Das Internet brauchte keine einheitliche Theorie der Sprache, um mehrsprachige Informationen auszutauschen. Es brauchte einen gemeinsamen Bezeichner, den Mail, Web, Markup, Dokumentensammlungen und Sprachwerkzeuge transportieren konnten, ohne jeweils ein eigenes Vokabular zu erfinden.
RFC 3066 erschien im Januar 2001 als BCP 47 und löste RFC 1766 ab. Ein Tag bestand aus einem primären Subtag und optionalen, durch Bindestriche getrennten weiteren Subtags. Groß- und Kleinschreibung änderte seine Bedeutung nicht. Zweistellige Primärwerte stammten aus ISO 639, dreistellige aus ISO 639-2; i eröffnete einen IANA-registrierten Bereich und x den privaten Gebrauch. Das regelte Schreibweise und Herkunft – nicht, ob ein Leser den Inhalt verstand.
Die Zuständigkeiten blieben verteilt. ISO-Gremien pflegten die Quellcodes, IANA verwaltete den Namensraum und öffentliche Registrierungen, der Absender wählte ein Tag, das jeweilige Protokoll definierte dessen Bezug zum Inhalt, und Anwendungen bestimmten, wie sie es verwendeten. Eine gemeinsame Präfixfolge machte die so bezeichneten Sprachen nicht automatisch gegenseitig verständlich.
Der Kontext bestimmte die Aussage
RFC 3066 gab dem Satz „Dieses Objekt trägt Tag X“ keine allgemeingültige Bedeutung. Bei einem einzelnen Dokument konnte die Tag-Menge Sprachen bezeichnen, die für ein vollständiges Verständnis nötig waren. Bei einer Sammlung konnte sie die Sprachen ihrer Bestandteile aufzählen. Bei mehreren Alternativen waren Tags Hinweise, die zur Prüfung der einzelnen Darstellungen aufforderten. In HTML oder XML ließ sich ein Tag sogar einem einzelnen Textabschnitt zuordnen, damit Wörterbuch oder Sprachsynthese passende Regeln anwendeten.
Die Zeichenfolge blieb gleich; die Behauptung änderte sich. Ein Metadatenfeld namens language kann den Text, eine Nutzerpräferenz, die Sprache der Oberfläche oder verfügbare Fassungen beschreiben. Der Standard, der es verwendet, muss festlegen, was gemeint ist.
Der Sender sollte das präziseste Tag verwenden, das er kennt und das im Anwendungskontext nützlich ist. Wenn es einen passenden zweistelligen ISO-639-1-Code gab, war dieser einem dreistelligen vorzuziehen. Wenn das Protokoll keinen Wert verlangte, sollte bei unbekannter Sprache das Weglassen meist besser sein als und. Kann ein Protokoll mehrere Tags tragen, sollen sie nicht ohne Not zu mul zusammengezogen werden. Unbekannt und mehrsprachig sind Zustände, keine Schönheitsfehler.
Ein Präfix ist ein Filter, kein Stammbaum
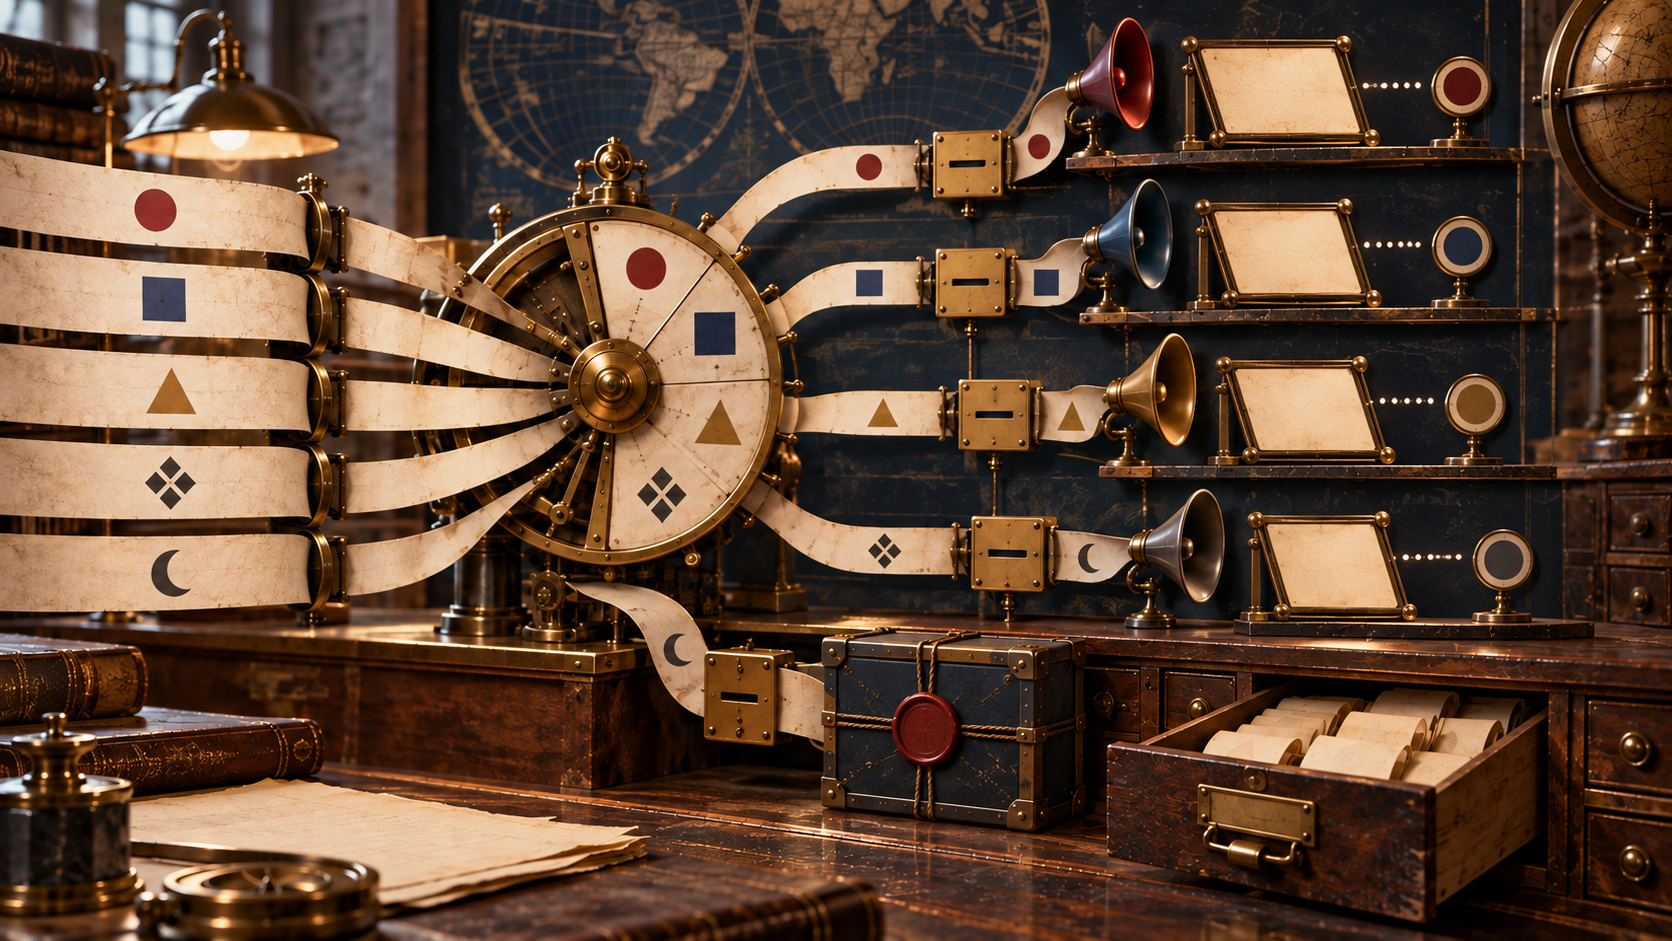
RFC 3066 führte language-range für eine Gruppe von Tags mit derselben Subtag-Folge ein. Ein Bereich traf ein Tag entweder exakt oder als Präfix, das an einer Bindestrichgrenze endete. * konnte jedes Tag treffen, wobei das Protokoll seine genaue Bedeutung festlegen durfte. Das gab Anwendungen ein einfaches Werkzeug, um genauer gekennzeichnete Fassungen zu finden.
Der RFC begrenzte sofort die Schlussfolgerung: Tags mit derselben Präfixfolge belegen keine gegenseitige Verständlichkeit. RFC 4647 benannte das Grundverfahren später als Basic Filtering und unterschied es von Extended Filtering und Lookup. Ein Filter kann eine Menge liefern, ein Lookup ein Tag auswählen. Keines davon fragt den Leser, ob er die Fassung lesen kann.
Darum braucht es getrennte Belege: die offengelegte Präferenz, verfügbare Tags, Matching-Verfahren und Priorität, gewähltes Objekt, tatsächliche Sprache, Darstellung oder Sprachausgabe, Nutzerkorrektur und Aufgabenergebnis. Ein einziges Feld wie language_match=true macht aus einem Zeichenkettenvergleich einen menschlichen Erfolg, den der RFC nie versprach.
Registrierung schuf Gedächtnis, kein Verstehen
Tags außerhalb der allgemeinen Regeln durchliefen eine öffentliche Prüfung auf der IETF-Sprachenliste. Nach zwei Wochen konnte ein ernannter Prüfer den Antrag an IANA weiterleiten oder bei erheblichen öffentlichen Einwänden ablehnen. Registrierungen wurden nicht gelöscht; wurde ein Tag überholt, konnte der Eintrag auf einen Ersatz verweisen. So blieb nachvollziehbar, wofür ein alter Bezeichner stand. Das bewies nicht, dass jedes damit markierte Dokument tatsächlich in dieser Sprache abgefasst war.
Der x--Zweig zeigte eine weitere Grenze: Parteien konnten private Tags vereinbaren, doch weder IANA noch der globale Standard gaben ihnen eine weltweite Bedeutung. Private Koordination war legitim, solange sie nicht als allgemeine Interoperabilität ausgegeben wurde.
RFC 4646 ersetzte den Katalog vollständiger Tags später durch ein strukturierteres Subtag-Register; RFC 5646 entwickelte dies weiter und bildet gemeinsam mit RFC 4647 das heutige BCP 47. Die Architektur wurde besser analysierbar und stabiler. Sie verwandelte Kennzeichnungen trotzdem nicht in Beobachtungen menschlichen Verstehens.
Eine offengelegte Präferenz hat einen Preis
RFC 3066 hielt fest, dass bei der Inhaltsverhandlung übertragene Sprachbereiche genutzt werden könnten, um die Nationalität des Absenders zu vermuten und mögliche Überwachungsziele zu identifizieren. Der RFC setzte Sprache nicht mit Nationalität gleich. Das Risiko lag in der Folgerung, die ein Beobachter aus der offengelegten Präferenz ziehen konnte.
Der Nutzer teilte eine Präferenz, damit ein Dienst besser auswählen konnte; der Empfänger erhielt zugleich ein protokollierbares Signal. Was für eine einmalige Auswahl nötig ist, muss nicht dauerhaft gespeichert oder mit einem Identitätsprofil verknüpft werden. RFC 3066 überließ die Bewertung und Gegenmaßnahmen dem jeweiligen Anwendungsprotokoll.
Quellen
- https://www.rfc-editor.org/rfc/rfc3066.html
- https://www.rfc-editor.org/info/rfc3066/
- https://datatracker.ietf.org/doc/rfc3066/
- https://www.rfc-editor.org/rfc/rfc1766.html
- https://www.rfc-editor.org/rfc/rfc2277.html
- https://www.rfc-editor.org/rfc/rfc4646.html
- https://www.rfc-editor.org/rfc/rfc4647.html
- https://www.rfc-editor.org/rfc/rfc5646.html
- https://www.iana.org/assignments/language-subtags-tags-extensions
- https://heng.lu/running-code-primary-the-patch-needed-to-preserve-the-internet-original-design/
- https://heng.lu/on-reality-layers-symbolic-power-and-why-clarity-feels-so-hostile/
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten