
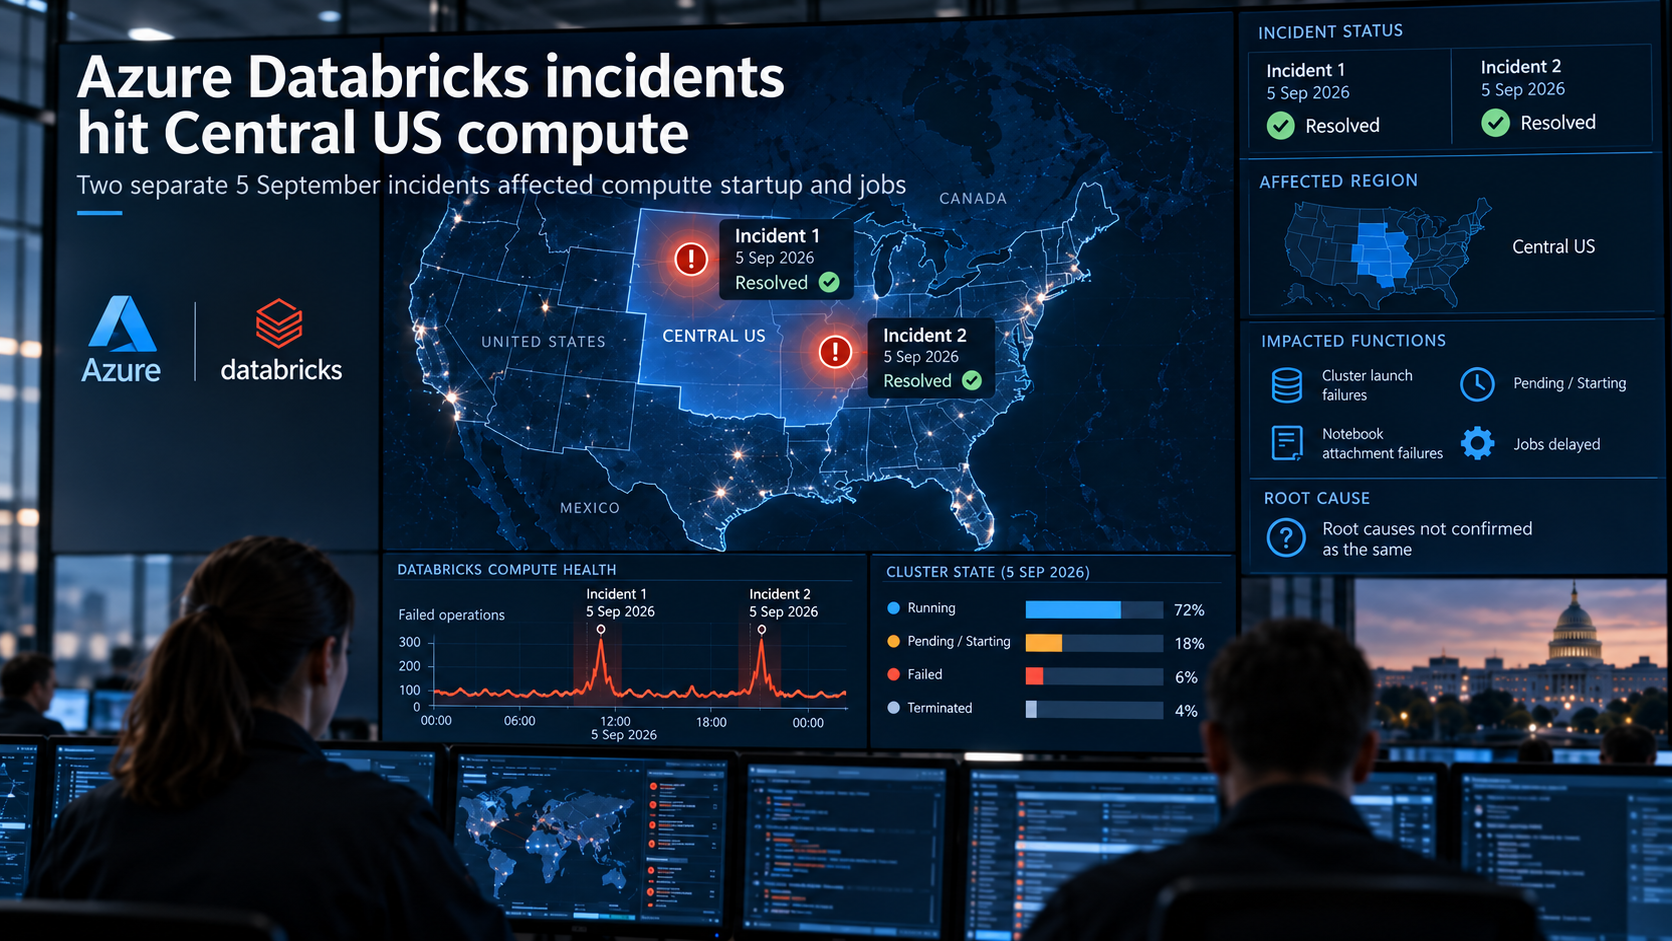
- Azure Databricks meldete am 5. September zwei getrennte Vorfälle in Central US, die beide den Start von Compute-Ressourcen und Jobs beeinträchtigten
- Beide Vorfälle wurden behoben; die verfügbaren Statusberichte belegen jedoch nicht, dass sie dieselbe Ursache hatten
Der Sachverhalt
Azure Databricks meldete am 5. September zwei getrennte Dienstvorfälle in der Region Central US. Der erste, ES-2194668, betraf Classic Compute, Declarative Pipelines und Jobs. Zu den gemeldeten Problemen gehörten fehlgeschlagene Clusterstarts, Cluster, die im Status Pending oder Starting festhingen, Fehler beim Anhängen von Notebooks sowie Jobs oder Verarbeitungsabläufe, die fehlschlugen oder weiterhin verzögert waren. In der Statusübersicht wurde der Vorfall mehr als zwei Stunden lang geführt.
Ein zweiter Vorfall, ES-2195009, betraf später Compute und Unity Catalog in Central US. Kunden stießen erneut auf fehlgeschlagene Clusterstarts, Fehler beim Anhängen von Notebooks und Jobs, die während des Starts der Compute-Ressourcen fehlschlugen oder ins Stocken gerieten. Der Vorfall wurde innerhalb einer Stunde behoben. Aus den Berichten geht nicht hervor, dass beide Vorfälle dieselbe Grundursache hatten. Beide wurden getrennt behoben und sollten als zwei getrennte Dienstvorfälle und nicht als ein durchgehender Ausfall betrachtet werden.
Die Einordnung
Bei beiden Vorfällen kam die Arbeit an dem Punkt zum Stillstand, an dem Databricks Compute-Ressourcen bereitstellen musste. Die Daten, der Code und die Notebooks eines Kunden konnten weiterhin vorhanden sein, doch ein geplanter Job konnte nicht ausgeführt werden, wenn sein Cluster im Status Pending oder Starting verblieb. Das macht den Clusterstart zu einer eigenständigen Abhängigkeit, die über die bloße Speicherung von Daten auf der Plattform hinausgeht.
Bei kurzen Unterbrechungen kann es ausreichen, einen Job erneut auszuführen. Workloads mit festen Fristen brauchen einen anderen Plan, wenn ihre Ausführung nicht warten kann, bis die regionalen Compute-Ressourcen wieder verfügbar sind. Das kann eine getestete Möglichkeit bedeuten, sie an anderer Stelle auszuführen, oder Jobs so zu gestalten, dass sie nach einem verzögerten Start fortgesetzt werden können. Es ist bislang nicht belegt, dass die beiden Vorfälle dieselbe Ursache haben; deshalb kann noch nicht davon ausgegangen werden, dass eine einzige technische Maßnahme beide behebt.
Für die Leserschaft von BTW müssen Teams, die verwaltete Compute-Ressourcen nutzen, wissen, welche Jobs warten können und welche nicht. Diese Entscheidung bestimmt, ob einfache Wiederholungsversuche ausreichen oder ob vorab eine andere Region vorbereitet werden muss.
Worauf zu achten ist
Zu beobachten sind gesonderte Angaben zu den jeweiligen Grundursachen von ES-2194668 und ES-2195009, weitere Compute-Vorfälle in Central US sowie mögliche Hinweise von Databricks zu Wiederholungsversuchen oder zur regionalen Wiederherstellung. Aussagekräftig ist für Kunden, ob kritische Jobs nach einer Unterbrechung ordnungsgemäß neu starten oder in eine andere Region verlagert werden können, wenn sich Compute-Ressourcen weiterhin nicht starten lassen.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten