
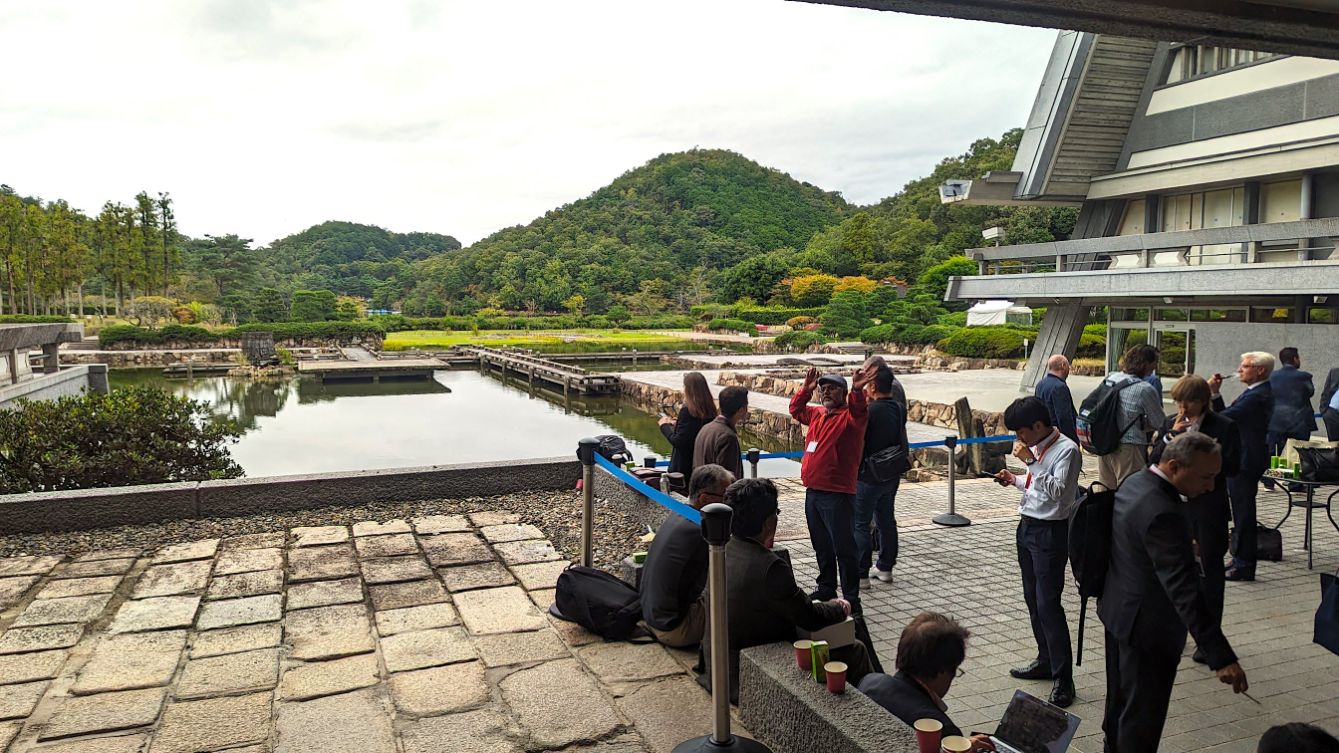
В огромном многоуровневом конференц-центре, возвышающемся над декоративным озером на фоне зелёной горы, недавно собрались тысячи делегатов, чтобы обсудить и осмыслить будущее интернета.
Пятидневное мероприятие было наполнено привычными для конференций такого уровня выражениями и обрывками речей — «многостороннее взаимодействие», «сотрудничество», «конфиденциальность, безопасность и защищённость» звучали чаще всего. Но некоторые сессии вышли за рамки шаблонного жаргона и обнажили две важные реальности. Во-первых, искусственный интеллект (ИИ), возможно, самое мощное технологическое достижение в истории человечества, — это колоссальная сила добра, но он же может стать и ещё более грозным противником.
Развитие этой сферы должно гарантировать, что человечество сохранит владение и контроль над ИИ; мы никогда не должны допустить, чтобы эти отношения перевернулись. Во-вторых, сбор, передача и обмен данными, особенно через международные границы, открывают столь же впечатляющие перспективы, прежде всего в сочетании с ИИ, — но несут и угрозы.
Вот лишь один пример:
Каждое землетрясение, например в Японии, даёт огромные массивы данных, которые можно анализировать с помощью моделей ИИ, чтобы прогнозировать будущие толчки и сделать следующий удар менее разрушительным, спасая жизни. Если этими данными делиться с другими странами, японские данные о сейсмической активности могут спасать жизни и за рубежом — и наоборот. Но способность ИИ «галлюцинировать» — то есть выдумывать — уже хорошо задокументирована: ложный прогноз неминуемой катастрофы, особенно с инструкциями об эвакуации, может вызвать невероятный хаос и потенциально опасен.
Кроме того, данные, на которых обучается ИИ, должны быть точными, надёжными и не создавать проблем с конфиденциальностью или кибербезопасностью; на более политическом уровне они должны оставаться доступными и технологически развитым, и развивающимся странам. Есть риск, что развитые страны смогут забирать и использовать данные других государств, не делясь затем выводами, полученными при анализе этих данных с помощью ИИ.
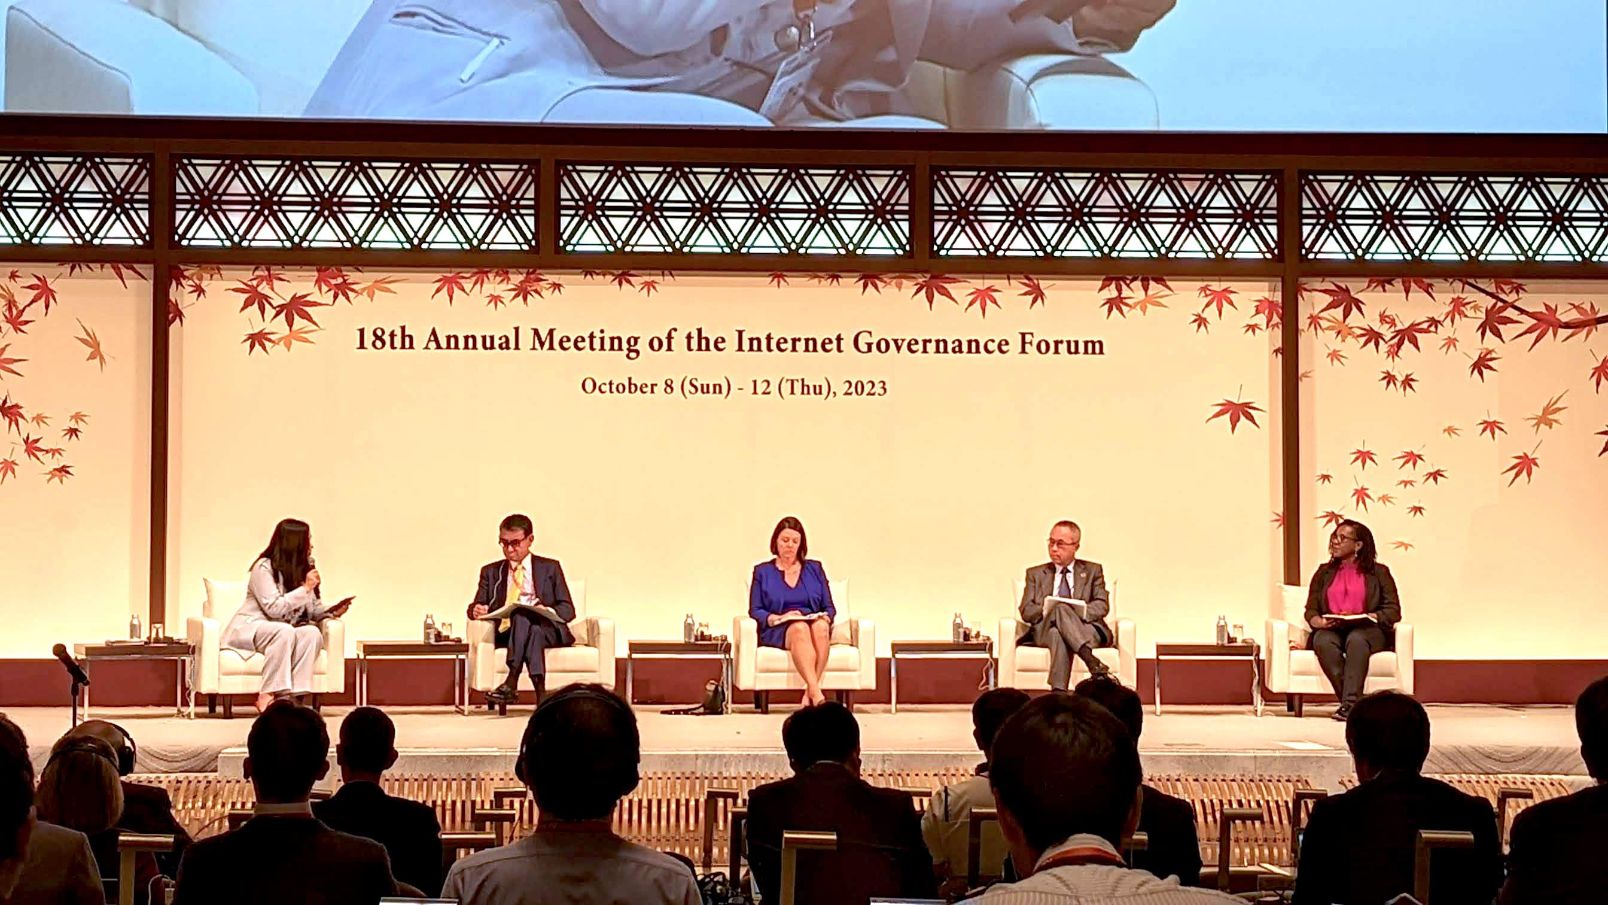
«Данные сегодня — это кровь многих экономик, — заявил Taro Kono, японский министр по цифровой трансформации и административным реформам, на одной из открывающих сессий. — Но они разрозненны, фрагментировано и управление ими; политики не всегда знают о новых технологиях, которые могут помочь, а широкая публика должна понимать угрозы, связанные с дезинформацией и достоверностью данных».
Читайте также:Китай ужесточил регулирование данных для обучения ИИ
Как ИИ и данные помогли во время COVID
Особенно наглядно выгоды такого сочетания ИИ и данных проявились приразработке вакцин от COVID-19. «Пандемия показала, как много данные значат для инноваций в здравоохранении, — заявила Courtney Gregoire, руководитель направления цифровой безопасности в Microsoft. — Хорошие данные рождают лучшие идеи, повышают продуктивность и помогают всем. Но люди должны чувствовать, что их данные защищены и находятся в безопасности, поэтому нам нужны механизмы доверия при передаче данных».
Moderna и Pfizer смогли создать вакцины от COVID в рекордные сроки и распространять их гораздо эффективнее благодаря методам ИИ. Каким бы долгим ни казался пандемический период, без развития ИИ и протоколов обмена данными, которые сделали возможной глобальную вакцинацию, всё было бы гораздо хуже.
Такие разработки, какDHIS2 Университета Осло, помогут и в будущих медицинских программах, и при эпидемиях. Это открытая информационная система управления здравоохранением, которая уже используется в 100 странах, согласившихся делиться данными через эту платформу.
А инициативаData Free Flow with Trust (DFFT), запущенная Японией в 2019 году, объединит представителей правительств, науки, частного сектора и гражданского общества (НПО, организации потребителей), чтобы попытаться закрыть часть пробелов в существующих руководствах (там, где они есть) по предоставлению и использованию данных.
Читайте также:Стоимость Worldcoin обрушилась на 50 % на фоне растущих опасений по поводу конфиденциальности данных
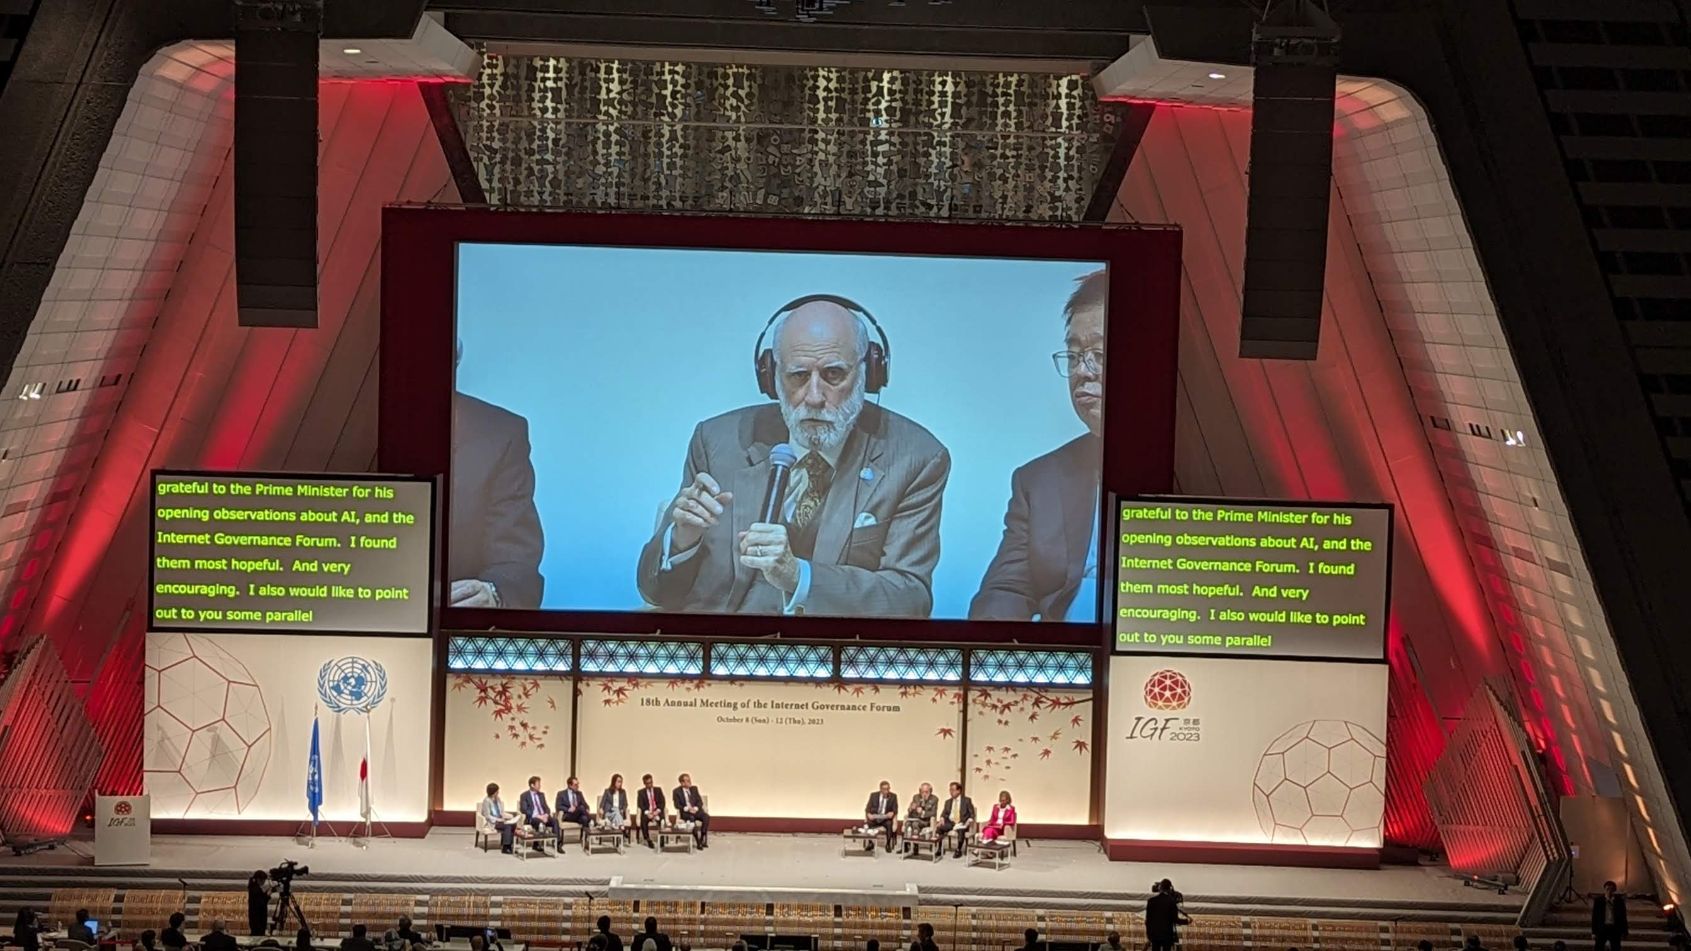
Предвзятость ИИ и как её устранить
Помимо невероятных достижений, которые даёт использование мировых данных и ИИ, есть и слабые места — по крайней мере сейчас. Небольшие дефекты в данных машина может усугубить. «Предвзятость в ИИ вполне реальна, — заявила Ivana Bartoletti, глобальный директор по защите конфиденциальности в Wipro. — Мы знаем, что ИИ предлагает женщинам менее оплачиваемую работу, например. Автоматизированные решения и такая предвзятость будут влиять на жизни людей».
Однако проблема не только технологическая: модели ИИ по-прежнему обучаются на существующих данных и информации, созданных людьми. «Эти вопросы можно решать технически, но проблема глубже, — добавила Bartoletti. — Она уходит корнями в общество».
В ближайшее время с этим надеется справитьсяХиросимский процесс. Он был создан на саммите G7 в Хиросиме в начале 2023 года. «Хиросимский процесс G7 по генеративному искусственному интеллекту» должен предложить кодекс поведения и перечень вопросов для всех, кто работает с моделями генеративного ИИ. Итоговый доклад будет представлен до конца 2023 года.
Недостоверная информация и дезинформация в генеративном ИИ
Одна из главных проблем генеративного ИИ — конечно, создание и распространение «фейков»: изображений, видео и историй, которые выглядят как документальное свидетельство реальности, но являются вымыслом и часто создаются с вредоносными целями. «Технологии взломали нашу биологию, чтобы обойти рациональное мышление, в то время как платформы борются за наше внимание, — заявила Maria Ressa, генеральный директор и основатель Rappler, лауреат Нобелевской премии мира 2021 года. — Семьдесят процентов мира сегодня живут при авторитарных режимах, а платформы социальных медиа продолжают отрицать, уклоняться и тянуть время. Мы должны действовать быстрее.
Для мира наступил переломный момент».
Читайте также:Дипфейк с Mr Beast, продающим iPhone за $2, завирусился в TikTok
Ressa подчеркнула, что «ложь распространяется в шесть раз быстрее правды», — эту статистикуполучила MIT Media Lab. Объясняется это тем, что выдумки почти всегда рассчитаны на наши эмоциональные реакции, тогда как сухие факты — нет.
Президент Meta по глобальным вопросам Nick Clegg рассказал о работе компании, которая использует сам ИИ для борьбы с негативными сторонами генеративного ИИ. «Язык вражды на Facebook встречается примерно в 0,01–0,02 % случаев, то есть на каждые 10 000 просмотренных публикаций одна-две могут считаться вредоносными. За последние 18 месяцев этот показатель снизился на 60 % благодаря нашему использованию ИИ для борьбы с таким контентом. Мы используем ИИ как инструмент, чтобы сводить к минимуму плохое и усиливать хорошее».
Президент Google по глобальным вопросам Kent Walker также рассказал о работе компании, например о SynthID, который пытается обнаруживать контент, созданный ИИ, и помечать его, и о Secure AI Framework (SAIF), нацеленном на снижение рисков при внедрении и использовании моделей ИИ, особенно в части данных. «Маркировка изображений и видео на уровне пикселей, чтобы мы могли подтверждать их происхождение, пометка ИИ-изображений в предвыборной рекламе — всё это призвано понять глубинный смысл контента и определить, чему можно, а чему нельзя доверять», — сказал он.
Слово «доверие» прозвучало в самом начале четырёхдневной встречи — и закономерно, что к нему возвращались снова и снова. Maria Ressa особенно настойчиво говорила, что доверие находится в центре и проблем, и возможностей, которые несёт ИИ, и что всё начинается с точности данных, на которых обучается ИИ. «Без фактов нет истины, без истины нет доверия, а без этих трёх вещей нет ни свободы, ни демократии».
Раз генеративный ИИ способен «мгновенно создавать цунами информации» — как выразился Tatsuhiko Yamamoto, профессор юридического факультета Университета Кэйо, — любая работа, которая помогает сдержать эпидемию фейков, оправдана.