
Resumo
- O Taegis XDR e o serviço de detecção gerenciada da Secureworks são mais fortes onde mantêm telemetria, julgamento do analista, estado do caso e autoridade do cliente unidos desde um sinal suspeito até uma decisão de resposta revisável.
- A justificativa econômica não é que mais detecções reduzem automaticamente o risco. É que melhor triagem, empacotamento de evidências, cobertura de analistas e orientação de resposta podem eliminar trabalho repetitivo de revisão suficiente para superar taxas de plataforma, custos de integração, falsos positivos, aprovações de clientes e opções substitutas.
A Secureworks está em um mercado concorrido de operações de segurança porque o trabalho que afirma reduzir é ao mesmo tempo caro e teimosamente humano. As empresas já possuem ferramentas de endpoint, sistemas de identidade, logs de nuvem, firewalls, filas de tickets e produtos de segurança de e-mail. Muitas também possuem um SIEM, uma plataforma de vulnerabilidades e um conjunto de hábitos informais de escalação que surgiram de incidentes passados. O problema usual não é a ausência total de sinais de segurança.
É que os sinais chegam de forma desigual, parcialmente duplicados, parcialmente desatualizados e exigem um analista escasso para decidir se uma ação real é justificada.
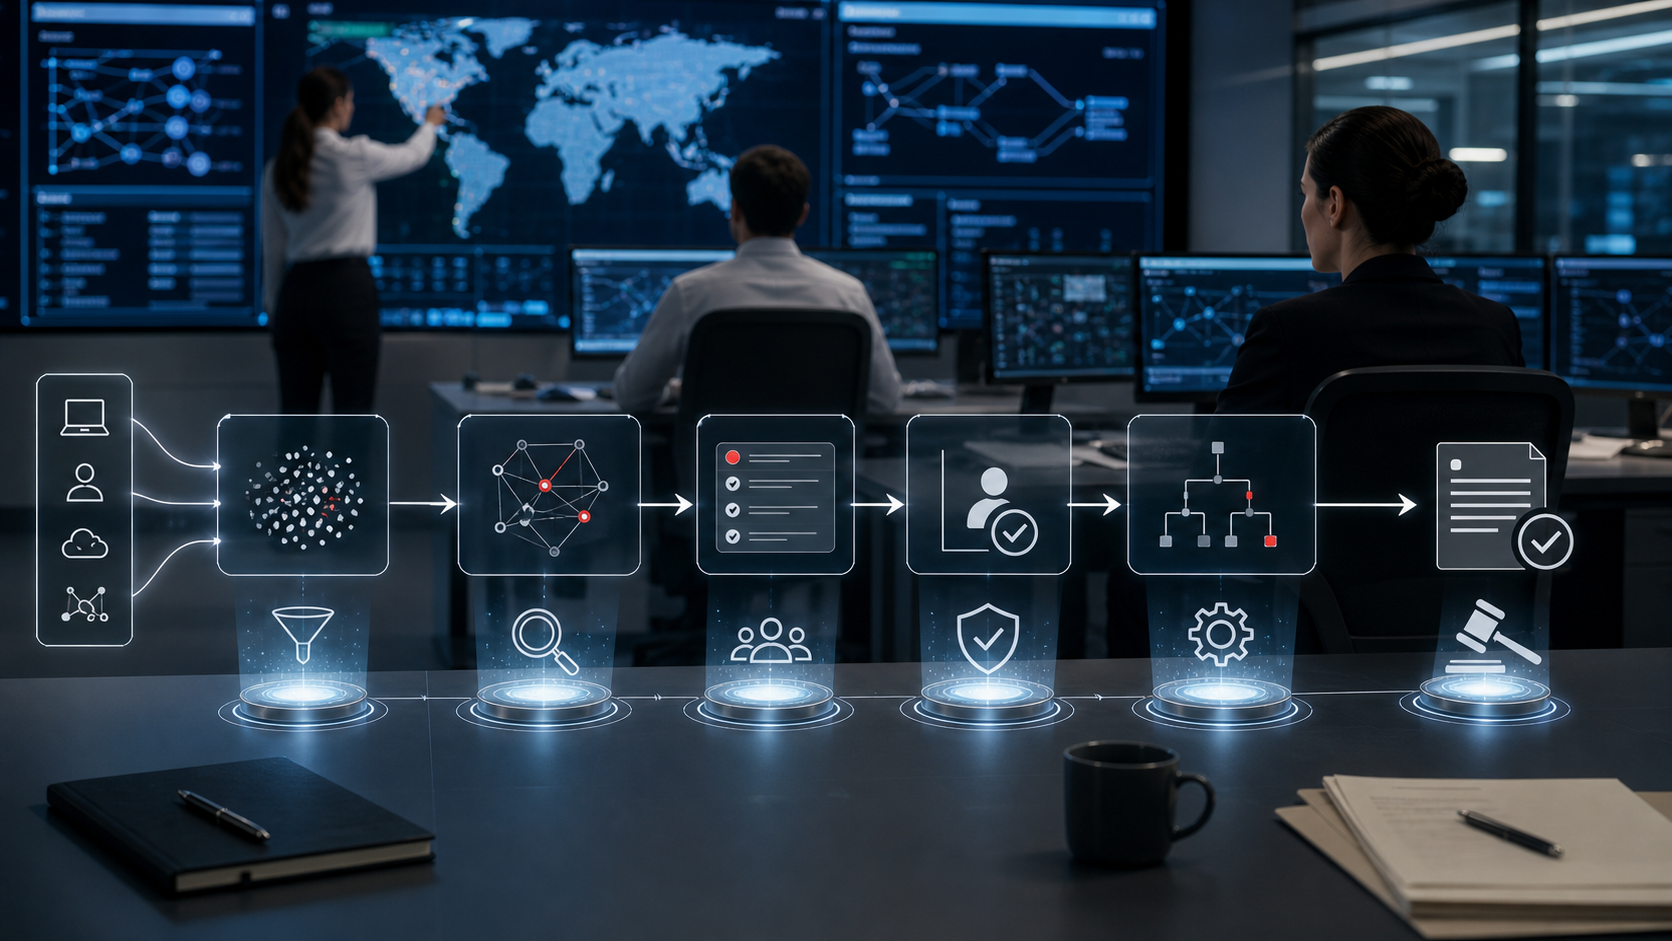
Esse é o ponto de partida certo para a Secureworks. O Taegis XDR não é meramente um banco de dados de alertas, e a detecção e resposta gerenciada da Secureworks não é meramente um grupo de analistas observando o console de outra pessoa. A proposta comercial é um sistema operacional combinado para triagem de segurança: coletar telemetria suficiente, correlacioná-la com inteligência de ameaças e lógica de detecção, organizá-la em casos, permitir que analistas a revisem e fornecer aos clientes orientação de resposta ou ação de resposta aprovada. Se essa sequência for quebrada, o cliente não comprou automação do trabalho de segurança.
Comprou outra caixa de entrada.
O principal teste, portanto, não é se o Taegis pode ver muitos eventos. É se pode preservar a cadeia entre evento, suspeita, escopo, evidência, incerteza, decisão e ação. Um comando PowerShell suspeito, um login de viagem impossível, uma chamada estranha de API de nuvem ou uma árvore de processos de endpoint só se tornam úteis quando o sistema pode explicar por que o sinal importa, quais ativos estão envolvidos, quais fontes de dados sustentam a alegação, quais suposições permanecem em aberto e qual ação é proporcional.
A ação pode ser tão modesta quanto abrir um ticket de investigação, pedir a um proprietário que valide uma atividade comercial ou solicitar mais telemetria. Pode ser tão séria quanto isolar um host ou desabilitar uma conta. Em ambos os casos, o valor está no registro, não no alerta.
A Secureworks tem uma longa linhagem de serviços de segurança, e essa história importa. A empresa construiu sua reputação em torno de pesquisa de ameaças, resposta a incidentes e operações de segurança gerenciada antes que o mercado se estabelecesse no XDR como um rótulo comum de produto. O Taegis é a plataforma em nuvem que agora carrega grande parte desse trabalho.
Ela ingere telemetria de endpoint, rede, identidade, nuvem e ferramentas de terceiros; aplica lógica de detecção e inteligência de ameaças; oferece aos analistas um ambiente de caso; e expõe APIs e integrações que permitem que os clientes a encaixem em processos de resposta mais amplos. O serviço gerenciado adiciona analistas da Secureworks que monitoram, investigam e aconselham dentro de limites de serviço definidos.
O limite é importante. A Secureworks não é mais uma empresa pública independente da mesma forma que era quando arquivava relatórios anuais com divulgações detalhadas de assinantes e receitas. A Sophos concluiu a aquisição da Secureworks em 2025, e a história combinada de produtos agora inclui ativos de endpoint e MDR da Sophos ao lado do Taegis. Isso pode expandir o alcance da telemetria e do serviço, mas também torna a atribuição do produto mais complicada. Os compradores não devem creditar à Secureworks toda capacidade da Sophos, nem tratar os clientes de endpoint da Sophos como prova de que o Taegis resolveu a confiabilidade do XDR.
A questão relevante permanece mais restrita: as operações centradas no Taegis da Secureworks podem preservar um registro de decisão confiável à medida que os sinais avançam em direção a uma ação de segurança aceita?
A primeira tarefa de produção é a ingestão. Uma ação de segurança não pode ser melhor do que a evidência que chega à plataforma. A documentação do Taegis descreve uma superfície de integração ampla, incluindo endpoint, nuvem, identidade, rede, e-mail, firewall e outras fontes de dados de terceiros. Também fornece APIs para consulta, investigações e fluxos de trabalho relacionados. Essa amplitude é necessária porque os atacantes se movem entre sistemas, enquanto muitas equipes de clientes são organizadas por proprietário de ferramenta. Uma única detecção de endpoint pode ser muito superficial. Uma linha de log de nuvem pode ser ambígua.
Um evento de identidade pode parecer rotineiro até ser combinado com comportamento de endpoint ou um destino de rede raro.
Mas a amplitude da integração não é o mesmo que qualidade da evidência. Cada conector adiciona seu próprio custo de manutenção. Credenciais expiram. Permissões de API mudam. Contas de nuvem são renomeadas, consolidadas ou divididas. Sensores de endpoint ficam desatualizados em laptops que raramente estão online. Logs de firewall chegam com campos inconsistentes. Logs de identidade podem omitir contexto necessário para distinguir um administrador legítimo de uma conta comprometida. Se o Taegis normaliza tudo isso em um caso organizado sem mostrar o que está faltando, pode criar confiança falsa.
Se preserva muita bagunça bruta, pode falhar em reduzir o trabalho do analista. O meio-termo útil é um caso que torne o escopo e a incerteza visíveis.
É por isso que o registro de ação aceito é uma unidade de análise melhor do que a redução de alertas. A redução de alertas pode ser alcançada suprimindo eventos ruidosos, agrupando sinais de forma mais agressiva ou alterando limites. Algumas dessas mudanças melhoram o trabalho de segurança. Outras apenas escondem o trabalho até que um incidente exponha a lacuna. Um registro de ação aceito exige mais. Deve mostrar que o sinal sobreviveu a escrutínio suficiente para justificar a ação e que uma parte responsável aceitou o próximo passo.
O registro de ação se torna o lugar onde a tecnologia, o serviço gerenciado e a autoridade do cliente se encontram.
As próprias descrições do serviço gerenciado da Secureworks tornam esse limite de responsabilidade visível. Os analistas gerenciados podem investigar, notificar, recomendar e, em alguns níveis de serviço, executar ou coordenar ações de resposta sob condições acordadas, mas o cliente ainda detém a autoridade do ambiente, o conhecimento dos ativos, as exceções de negócios e muitas decisões finais. Isso não é uma fraqueza. É a natureza da segurança gerenciada. Um provedor não pode isolar com segurança um sistema de produção, bloquear uma conta, limpar um dispositivo ou alterar uma política de firewall sem entender a consequência para o negócio.
A questão é se o design do serviço reduz o fardo da revisão o suficiente para que o cliente possa aprovar a ação mais rápido e com melhores evidências.
O custo operacional começa antes do primeiro incidente. Os clientes devem decidir quais fontes de telemetria importam, quais integrações valem a pena manter, como os casos devem ser roteados, quem recebe notificações de escalação, quais ações de resposta são pré-aprovadas e quais ativos exigem tratamento especial. Esse trabalho é frequentemente subestimado durante a aquisição porque uma demonstração de produto pode fazer a correlação parecer imediata. Ambientes reais de segurança são desiguais.
Incluem servidores legados, endpoints não gerenciados, experimentos em nuvem, subsidiárias regionais, infraestrutura terceirizada e sistemas que ninguém quer reinicializar. Um provedor de XDR gerenciado pode ajudar a organizar esse estado, mas não pode fazê-lo desaparecer.
Uma vez que a telemetria está conectada, a triagem se torna a tarefa repetida central. O sistema deve decidir quais sinais merecem um caso, como atividades semelhantes devem ser agrupadas, qual enriquecimento é útil e quando a revisão humana é necessária. É aqui que a combinação de lógica de detecção, inteligência de ameaças e fluxo de trabalho do analista do Taegis pode fazer diferença. Um cliente com capacidade limitada de analistas não precisa de cada evento bruto encaminhado com um selo de gravidade.
Precisa de uma explicação defensável: por que essa atividade é suspeita, por que pode afetar esses sistemas, quais eventos relacionados foram vistos, qual é o próximo passo recomendado e quão urgente deve ser a resposta.
A versão mais forte do argumento da Secureworks é que sua plataforma e analistas comprimem o ciclo inicial de investigação. Em vez de um analista do cliente gastar meia hora alternando entre console de endpoint, logs de identidade, busca em firewall, trilhas de auditoria em nuvem e relatórios de ameaças, o Taegis pode montar a evidência relevante e um analista gerenciado pode converter essa evidência em um caso. A economia não é apenas de tempo. É uma redução no atrito de decisão.
Um caso bem formado dá ao cliente uma pergunta menor e mais precisa: aceitamos esta ação recomendada, pedimos mais evidências, fechamos como comportamento esperado ou escalamos para resposta a incidentes?
A versão mais fraca é uma armadilha familiar do mercado de segurança. A plataforma pode gerar casos convincentes enquanto ainda transfere o trabalho de revisão de volta para o cliente. Se os casos contêm descrições genéricas, rótulos amplos de técnica MITRE, propriedade de ativos pouco clara ou evidências fracas de impacto, o cliente ainda tem que fazer a parte cara. Alguém deve perguntar se o usuário estava viajando, se o host é de produção, se a ferramenta é aprovada, se um desenvolvedor estava testando, se uma conta privilegiada tem uma função de break-glass, ou se a ação de contenção proposta quebraria um processo de negócios.
Nesse cenário, a Secureworks não removeu o trabalho. Ele o reempacotou.
A diferença entre esses dois resultados depende do custo de supervisão. A automação de segurança raramente é não supervisionada em ambientes maduros porque o lado negativo de uma ação errada pode ser grande. Um falso positivo que isola um laptop é inconveniente. Um falso positivo que desabilita um sistema de receita, bloqueia um processo de pagamento ou interrompe um fluxo de trabalho industrial pode ser muito mais caro do que o ataque que deveria prevenir. Mesmo quando a ação de resposta é leve, os clientes precisam de evidências suficientes para defender a decisão internamente.
O registro de ação aceito deve, portanto, apoiar a supervisão em vez de fingir que a supervisão é desnecessária.
As funções de caso e investigação do Taegis são centrais por essa razão. A documentação pública mostra um fluxo de trabalho de caso com estágios, tarefas, notas e evidências relacionadas, além de APIs que podem criar, atualizar ou consultar o estado da investigação. Isso sugere que a Secureworks entende o trabalho como um processo stateful, em vez de um único envio de alerta. O estado do caso importa porque as equipes de segurança geralmente são distribuídas entre fusos horários e fornecedores.
Um analista pode abrir o caso, outro pode adicionar evidências de endpoint, um proprietário do cliente pode pedir contexto de negócios, um respondedor pode agir, e um auditor pode depois perguntar por que a decisão foi tomada. Se o registro está incompleto, o cliente absorve o custo depois.
A retenção de evidências é mais do que um arquivo. É parte da autoridade. Um cliente pode aceitar uma ação de segurança quando o caso mostra suficiente da cadeia de raciocínio para tornar a decisão responsável. Isso inclui o sinal original, a janela de tempo, ativos afetados, enriquecimento, notas do analista, detecções relacionadas, comunicações com o cliente, ação tomada e ressalvas não resolvidas. Se uma investigação mantém apenas a conclusão, falha quando questionada. Se mantém todos os eventos brutos sem explicação, falha quando o cliente precisa agir rapidamente. O registro produtivo não é nem uma caixa preta nem um despejo.
É uma explicação comprimida com links de volta para os dados de suporte.
Esse registro também precisa viajar entre sistemas. Muitas equipes de segurança não fecham o trabalho apenas dentro da plataforma de detecção. Elas criam tickets de serviço, abrem canais de incidente, anexam evidências a registros de risco, briefam proprietários de sistemas, preservam notas legais e atualizam revisões pós-incidente. Um caso do Taegis que não pode ser conectado a esses registros downstream deixa o cliente redigitando manualmente os fatos mais importantes. A documentação pública de API e investigação sugere que a Secureworks entende essa necessidade de integração.
O teste prático é se o caso permanece inteligível depois de sair do console. Se o ticket diz apenas "atividade suspeita detectada", a integração moveu texto, não julgamento.
O conteúdo do registro de ação deve ser específico o suficiente para apoiar o desacordo. Um bom registro de segurança não é aquele que força um cliente a aceitar a conclusão do provedor. É aquele que permite que o cliente desafie a conclusão rapidamente. Qual conta estava envolvida? Qual host? Qual processo? Qual serviço de nuvem? Quais eventos anteriores estão relacionados e quais apenas compartilham um timestamp? Qual evidência veio da lógica de detecção da Secureworks, qual veio da telemetria do cliente e qual veio de inteligência externa?
Essa distinção é especialmente importante em um serviço gerenciado, porque o provedor pode ter expertise mais forte em ameaças enquanto o cliente tem conhecimento mais forte do propósito do negócio.
O registro também deve distinguir gravidade de confiança. Um resultado possível severo ainda pode se basear em evidências fracas. Uma descoberta de alta confiança ainda pode ter baixo impacto nos negócios. Os clientes frequentemente entram em problemas quando essas duas ideias colapsam em um único selo vermelho. O registro de ação aceito deve deixar claro se o analista está dizendo "isso é provavelmente malicioso", "isso pode ser danoso se malicioso", "isso deve ser verificado porque o ativo é sensível" ou "esta ação é segura o suficiente para ser tomada agora". Essas são alegações diferentes.
Implicam diferentes níveis de supervisão e diferentes escolhas de resposta.
O valor diário dessa disciplina é silencioso. Aparece quando um analista júnior pode entender por que o caso de ontem foi fechado, quando um proprietário de infraestrutura pode ver por que um servidor foi isolado, quando um gerente de risco pode explicar a resposta a um segurador, ou quando uma futura equipe de incidente pode pesquisar casos antigos em busca de um padrão repetido. As ferramentas de operações de segurança frequentemente vendem urgência, mas o valor duradouro vem da memória. Um sistema que torna cada caso mais fácil de entender na próxima semana e no próximo trimestre reduz mais do que a fadiga de alertas.
Reduz o esquecimento institucional.
Inteligência de ameaças é outra parte da proposta de valor, mas deve ser tratada com cuidado. A pesquisa da Counter Threat Unit da Secureworks tem sido há muito tempo uma parte visível da identidade da empresa. Os relatórios atuais da Sophos e Secureworks fornecem contexto útil sobre ransomware, abuso de credenciais, táticas de adversários e comportamentos comuns de atacantes. Isso pode melhorar a lógica de detecção e o julgamento do analista. No entanto, relatórios públicos de ameaças não provam que uma implantação específica de cliente pegará uma intrusão específica.
Eles mostram capacidade de pesquisa e consciência de ameaças, não cobertura de telemetria local, qualidade de ajuste local ou velocidade de resposta local.
A mesma cautela se aplica a avaliações independentes. As avaliações do MITRE ATT&CK e exercícios de serviços gerenciados podem ajudar os compradores a entender o comportamento de detecção e a reportagem contra cenários conhecidos, mas o MITRE tem enfatizado repetidamente os limites da metodologia em vez de classificação simples. Um produto XDR gerenciado que tem bom desempenho em uma avaliação estruturada pode ainda ter dificuldades em um ambiente de cliente com logs ausentes, processos de negócios únicos ou fluxos de aprovação ruins.
Por outro lado, um serviço com presença modesta em benchmarks públicos ainda pode produzir forte valor operacional para um cliente com telemetria disciplinada e design de escalação. Avaliações são evidência, não um substituto para prova de implantação.
A evidência de cliente da Secureworks é útil, mas também limitada. Estudos de caso publicados pelo fornecedor e histórias de clientes podem mostrar por que os compradores escolhem o Taegis ou MDR, quais pontos de dor eles relatam e que tipo de alegações operacionais a Secureworks pode apoiar publicamente. Eles não podem fornecer um denominador neutro. Eles não mostram os clientes que se desligaram, os incidentes que foram perdidos, os falsos positivos que consumiram tempo ou as integrações que demoraram mais do que o planejado.
Uma leitura justa trata as histórias de clientes como exemplos de possível benefício operacional, não como prova estatística de redução de risco.
A aquisição pela Sophos muda o conjunto de substitutos. Antes da aquisição, os compradores podiam comparar a Secureworks diretamente com outros provedores de MDR e XDR. Depois, a Secureworks se insere em um portfólio de segurança mais amplo da Sophos que inclui proteção de endpoint, segurança de rede, segurança de e-mail e serviços MDR. Isso pode tornar o Taegis mais atraente para clientes que já usam produtos Sophos ou que desejam um único fornecedor para mais telemetria.
Também pode levantar questões para clientes com ambientes heterogêneos: o Taegis permanecerá igualmente forte como uma camada de operações de segurança aberta ou a melhor experiência assumirá cada vez mais telemetria Sophos? A resposta afeta o fardo da integração e o lock-in.
Lock-in em XDR não é apenas contratual. É operacional. Depois que uma equipe de segurança constrói playbooks, caminhos de escalação, hábitos de caso, autorizações de resposta, dashboards, mapeamentos de dados e rotinas de auditoria em torno de uma plataforma, a troca se torna cara. O cliente pode exportar alguns dados e reter conhecimento interno, mas a memória muscular do dia a dia vive na ferramenta e no serviço. Isso torna a primeira decisão de implantação importante. Um comprador não deve perguntar apenas se o Taegis pode lidar com o volume de alertas deste ano.
Deve perguntar se a estrutura de registro, APIs, integrações e modelo de serviço gerenciado da plataforma ainda se encaixarão quando as contas de nuvem, provedores de identidade, ferramentas de endpoint e unidades de negócios mudarem.
A economia da unidade é, portanto, mista. Os custos óbvios são taxas de assinatura, taxas de serviço gerenciado, integração, trabalho de integração, tempo da equipe e possíveis ferramentas duplicadas. Os custos menos óbvios são supervisão, tratamento de exceções, coordenação de resposta, educação interna, manutenção de conectores e o custo da falsa confiança.
Os benefícios, se a Secureworks tiver bom desempenho, incluem menos sinais não revisados, triagem mais rápida, melhor cobertura após o expediente, melhor empacotamento de evidências, escalação mais consistente, menos dependência de um pequeno grupo interno de analistas e, potencialmente, melhores decisões de contenção durante os estágios iniciais do incidente.
Para organizações pequenas e médias, a proposta de valor pode ser mais forte porque a escassez de analistas é aguda. Uma equipe que não pode manter um SOC 24 horas pode se beneficiar materialmente da cobertura de detecção gerenciada e escalação estruturada. A alternativa geralmente não é um SOC interno totalmente maduro. É um mosaico de alertas de endpoint, e-mails de firewall, generalistas de TI e ajuda ocasional de consultores. Nesse cenário, o Taegis e os analistas gerenciados podem transformar sinais dispersos em um processo de segurança mais coerente.
O risco é que o cliente superestime o que o serviço pode fazer sem propriedade limpa de ativos e caminhos de aprovação definidos.
Para grandes empresas, o valor é mais seletivo. Elas já podem ter SIEM, SOAR, feeds de inteligência de ameaças, detecção de endpoint, análise de identidade e analistas internos. A Secureworks deve então provar que o Taegis adiciona correlação, expertise gerenciada ou disciplina de caso que a pilha interna não pode fornecer a custo comparável. Grandes clientes podem usar a Secureworks para lacunas específicas de cobertura, caça a ameaças, triagem após o expediente, ambientes subsidiários ou tratamento de sobrecarga, em vez de como o único sistema de operações de segurança.
A plataforma tem que coexistir com ferramentas e governança existentes, em vez de fingir substituí-las todas.
O primeiro modo de falha é a telemetria faltante. Se um endpoint não é coberto, uma conta de nuvem não está conectada, logs de identidade estão incompletos ou a visibilidade de rede está ausente, o Taegis ainda pode criar um caso confiante a partir de evidências parciais. Um bom analista pode sinalizar a lacuna. Um fluxo de trabalho ruim pode enterrá-la. A telemetria faltante importa porque muitos ataques só são claros quando múltiplos sinais fracos se reforçam mutuamente. Um login suspeito sem contexto de endpoint pode ser ambíguo. Um processo suspeito sem contexto de identidade pode ser ambíguo.
Uma ação suspeita em nuvem sem propriedade de ativo pode ser ambígua. O registro de ação aceito deve dizer quando a evidência está ausente.
O segundo modo de falha é a pressão de falso positivo. As equipes de segurança frequentemente desconfiam de ferramentas que criam casos urgentes repetidos que depois se resolvem em comportamento normal de negócios. Uma vez que essa confiança diminui, a resposta diminui. Os analistas começam a ler superficialmente. Os proprietários de negócios resistem à contenção. Os executivos questionam se o serviço vale a interrupção. A Secureworks pode reduzir esse risco através de ajuste, enriquecimento, revisão de analistas e ciclos de feedback do cliente, mas não pode eliminá-lo.
Todo ambiente tem atividade legítima que parece estranha para forasteiros. O serviço deve aprender a diferença sem se tornar tão permissivo que perca mudanças materiais.
O terceiro modo de falha é a inteligência de ameaças desatualizada ou excessivamente generalizada. Relatórios de ameaças e conteúdo de detecção podem guiar a triagem, mas o comportamento do atacante muda. Um rótulo que era significativo no trimestre passado pode ser muito amplo hoje. Um mapeamento de técnica pode explicar uma categoria de comportamento sem provar intenção maliciosa. Um indicador conhecido de maldade pode envelhecer rapidamente. O registro de ação deve, portanto, evitar transformar rótulos de inteligência de ameaças em veredictos.
O papel útil da inteligência é apoiar um julgamento de probabilidade, não substituir a evidência local.
O quarto modo de falha é o atraso na aprovação do cliente. A detecção gerenciada pode identificar um host suspeito às 2 da manhã, mas o provedor pode não saber se o isolamento é aprovado, quem é o dono do sistema, se o sistema faz parte de um processo crítico ou se o alerta corresponde a uma janela de manutenção ativa. Se a cadeia de aprovação não é clara, o tempo é perdido. A Secureworks pode fornecer um portal, contatos de escalação e orientação de resposta, mas o cliente deve definir a autoridade antes do incidente. Caso contrário, o registro de ação se torna um padrão de espera.
O quinto modo de falha é o excesso de resposta. Automação e resposta gerenciada se tornam perigosas quando o sistema trata comprometimento provável como certeza ou trata uma resposta genérica como segura em todos os ambientes. Isolar um host, matar um processo, revogar um token, bloquear um endereço IP ou desabilitar um usuário pode ser apropriado, mas cada ação tem raio de explosão. Quanto mais séria a ação, mais o caso deve mostrar por que a evidência a apoia, quais alternativas foram consideradas e como o rollback ocorreria. É aqui que um registro de ação aceito protege tanto o provedor quanto o cliente. Torna a decisão revisável.
O sexto modo de falha é a fraqueza da trilha de auditoria. Após um incidente, a organização pode precisar responder a reguladores, seguradoras, clientes, membros do conselho ou comitês internos de risco. Eles perguntarão quando o sinal apareceu, quando foi revisado, quem foi notificado, que evidência estava disponível, por que uma ação específica foi tomada e se a decisão foi razoável. Se a plataforma não pode reconstruir essa sequência, ela falhou em um dos trabalhos ocultos das operações de segurança. A resposta a incidentes não termina quando o host é limpo. Termina quando a organização pode se explicar.
A questão comercial segue a mesma lógica. Melhor detecção e cobertura de analistas gerenciados superam os custos de taxas de plataforma, ajuste, revisão do cliente, integração, falsos positivos e coordenação de resposta? Para muitos clientes, a resposta pode ser sim, mas é condicional. Depende da cobertura de telemetria, propriedade interna, disciplina de alertas, regras claras de escalação, saúde da integração e da disposição do cliente em deixar um provedor gerenciado se tornar parte das operações diárias.
Comprar a Secureworks sem essas fundações é como comprar uma torre de controle enquanto deixa o registro de aeronaves, status da pista e autoridade do piloto indefinidos.
O lado do custo também é desigual ao longo do tempo. A integração pode ser intensa porque o cliente tem que conectar sistemas, mapear contatos, definir políticas e concordar com expectativas de resposta. O período intermediário pode ser eficiente se os casos são claros e o ajuste melhora. Mais tarde, os custos podem aumentar novamente à medida que o ambiente do cliente muda. Uma fusão adiciona novos domínios de identidade. Uma migração para a nuvem altera fontes de log. Um novo produto de endpoint muda a qualidade da telemetria. Um programa de corte de custos remove funcionários que entendiam a propriedade dos ativos.
Cada mudança pode reabrir a questão de se o Taegis está vendo o suficiente e se os analistas da Secureworks têm contexto suficiente para recomendar ação.
É por isso que o desvio do conector é uma questão comercial, não meramente técnica. Uma integração quebrada ou degradada pode fazer o serviço gerenciado parecer pior do que é, mas o cliente ainda paga pelo resultado. Se um conector de nuvem perde uma permissão, se um sensor de endpoint para de reportar, se uma integração de rede muda campos, ou se uma integração de tickets falha silenciosamente, o registro de ação aceito se torna mais fino. O cliente pode descobrir esse problema apenas após um incidente ou uma escalação perdida. Os compradores devem, portanto, tratar a saúde dos conectores e a propriedade como parte do preço do serviço.
Os falsos positivos têm uma forma econômica semelhante. Um único falso positivo é tolerável. Um falso positivo recorrente se torna um imposto em cada reunião de revisão e contato de escalação. Treina os proprietários de negócios a resistir à próxima recomendação. Torna os analistas internos menos dispostos a confiar nas conclusões do serviço gerenciado. Também pode fazer com que executivos perguntem se o provedor está inflando a urgência para provar valor. A Secureworks pode combater isso com ajuste e ciclos de feedback do analista, mas o comprador deve medir a recorrência, não apenas o fechamento.
Um caso fechado como benigno não é inofensivo se continua retornando.
Os benefícios também são desiguais. A cobertura após o expediente pode valer mais do que a triagem diurna para uma organização sem SOC noturno. Um registro de caso de alta qualidade pode valer mais do que uma notificação mais rápida para um cliente regulado que deve explicar decisões. A orientação de resposta pode valer mais do que a ação automática para uma empresa com sistemas frágeis. A justificativa econômica é mais forte quando o serviço remove a tarefa repetida mais cara do cliente, não quando realiza a tarefa mais impressionante em uma demonstração.
Os substitutos se enquadram em vários grupos. Um cliente pode construir em torno de uma pilha SIEM e SOAR, com analistas internos escrevendo detecções e playbooks. Isso pode preservar controle e flexibilidade, mas requer pessoal qualificado e engenharia contínua. Um cliente pode confiar mais fortemente no serviço MDR de um fornecedor de endpoint, que pode fornecer resposta forte orientada a endpoint, mas neutralidade mais fraca entre ferramentas.
Um cliente pode usar as ferramentas de segurança nativas de um provedor de nuvem para cargas de trabalho em nuvem, o que pode ser eficiente dentro de uma nuvem, mas menos completo em ambientes híbridos. Um cliente pode terceirizar mais do SOC para um provedor de segurança gerenciada, o que pode reduzir a pressão de pessoal, mas criar dependência da qualidade do serviço e do design de escalação.
O substituto SIEM/SOAR interno é atraente para equipes maduras porque permite detecções personalizadas, modelos de dados personalizados e controle direto sobre playbooks de resposta. Também pode se tornar seu próprio poço de manutenção. Os engenheiros devem manter parsers funcionando, ajustar regras, gerenciar custo de armazenamento, normalizar campos, manter dashboards, escrever playbooks e staffar a fila de revisão. O comprador que compara a Secureworks com uma construção interna deve precificar o backlog de engenharia honestamente. Uma licença mais barata ainda pode ser cara se a organização não consegue manter o sistema atualizado.
O substituto MDR liderado por endpoint é atraente porque os endpoints são frequentemente a fonte mais rica de evidência precoce de comprometimento. A contenção de endpoint também pode ser mais fácil de automatizar do que resposta mais ampla de rede ou identidade. A fraqueza é que muitos incidentes não são apenas de endpoint. Abuso de plano de controle em nuvem, comprometimento de identidade, abuso de e-mail comercial e uso indevido de SaaS podem ir além da lente do endpoint. A alegação mais ampla de XDR da Secureworks é valiosa apenas se essas fontes estiverem conectadas e interpretadas bem.
Se o cliente quer principalmente resposta de endpoint, um serviço MDR de endpoint mais restrito pode ser mais simples.
O substituto nativo em nuvem é útil para organizações concentradas em um único provedor de nuvem. Ferramentas nativas podem entender recursos de nuvem, funções de identidade e eventos de serviço de uma forma que ferramentas genéricas podem ter dificuldade em igualar. O limite aparece em ambientes híbridos e operações multinuvem. Muitos ambientes reais incluem sistemas locais, múltiplos caminhos de identidade, aplicações SaaS, endpoints de terceiros e infraestrutura terceirizada. O Taegis tem que ganhar seu lugar atravessando essas fronteiras sem achatar suas diferenças.
Provedores de segurança gerenciada tradicionais permanecem um substituto, especialmente para clientes que querem mais pessoas do que plataforma. Um provedor com muitos serviços pode se adaptar à política do cliente e ambientes legados de forma mais flexível. O risco é que o serviço manual sem uma plataforma compartilhada forte pode produzir registros desiguais e handoff mais lento. A aposta da Secureworks é que plataforma mais analistas é melhor do que qualquer um sozinho. O cliente deve testar essa alegação examinando o registro após os casos serem fechados, não contando quantas camadas de serviço são prometidas.
A diferenciação da Secureworks é mais forte quando o cliente valoriza uma plataforma XDR combinada com um serviço de detecção gerenciada maduro e herança de pesquisa de ameaças. É mais fraca quando o cliente precisa de uma pilha de endpoint de fornecedor único com integração mínima, uma plataforma pura de engenharia SIEM, ou capacidade profunda de resposta a incidentes sob demanda. O Taegis não é uma camada mágica acima de todo trabalho de segurança. É um ambiente operacional cujo valor aparece quando investigações repetidas podem ser transformadas em decisões mais claras, mais rápidas e mais responsáveis.
A combinação com a Sophos pode melhorar o produto se der ao Taegis mais profundidade de endpoint, mais cobertura de resposta e uma organização de serviço mais ampla sem restringir a abertura da plataforma. Pode prejudicar o produto se roadmaps, branding ou prioridades de integração tornarem mais difícil para os clientes entenderem onde a Secureworks termina e a Sophos começa. Os compradores devem observar documentação do produto, termos de serviço, suporte de integração e referências de clientes por essa razão.
Uma plataforma de operações de segurança pode sobreviver a mudanças de marca, mas os clientes precisam de contratos estáveis, APIs estáveis e comportamento de escalação estável.
Outra questão é a medição. Compradores de segurança são frequentemente tentados a pedir prova de que uma plataforma preveniu violações. Isso é difícil de provar honestamente. A ausência de uma violação não é prova da eficácia de uma ferramenta, especialmente quando o interesse do atacante, o perfil do negócio e a maturidade do ambiente variam.
Um conjunto melhor de medições é operacional: tempo do sinal ao caso, porcentagem de casos com contexto completo de ativos, porcentagem de casos que exigem retrabalho do cliente, ações de resposta aceitas sem evidência adicional, recorrência de falso positivo, tempo médio para confirmação do cliente, saúde do conector, sucesso de escalação após o expediente e completude de auditoria após incidentes fechados.
Essas medidas são menos glamourosas do que alegações de marketing, mas estão mais próximas do trabalho. Se o Taegis consistentemente encurta o caminho do sinal para a ação justificada, os clientes devem ver menos investigações em aberto e menos fadiga de analistas. Se meramente muda onde os alertas são vistos, os clientes verão o mesmo fardo de revisão sob um novo rótulo. A diferença aparecerá nas operações semanais, não em uma demonstração.
A documentação pública da Secureworks dá razão para acreditar que a empresa entende o statefulness do problema. A presença de APIs de investigação, fluxos de trabalho de caso, documentação de ação de resposta, descrições de serviço gerenciado e informações de status apontam para um produto construído em torno de operações contínuas, em vez de detecção pontual. Os arquivos financeiros públicos antes da aquisição pela Sophos também mostraram uma transição do negócio em direção à assinatura e receita recorrente anual do Taegis, o que indica que a plataforma era central para a estratégia de crescimento da Secureworks antes da aquisição.
Isso não prova resultado para o cliente, mas explica por que o Taegis é a superfície certa a ser examinada.
A evidência pública também deixa lacunas importantes. Ela não mostra uma amostra neutra de implantações de clientes. Não revela taxas de falso positivo, detecções perdidas, horas médias de manutenção de conectores, falhas de escalação ou a porcentagem de recomendações que os clientes aceitam sem investigação adicional. Não mostra se integrações mais recentes da Sophos melhoram materialmente a qualidade do registro para clientes que não padronizam em produtos de endpoint Sophos. Não mostra se as recomendações dos analistas gerenciados diferem significativamente do que um SOC interno forte produziria com a mesma telemetria.
Essas são as perguntas que um comprador deve testar em um piloto ou processo de referência.
Um piloto sério deve ser projetado em torno de ações aceitas, não de contagens de alertas. O cliente deve conectar telemetria representativa, definir propriedade para uma amostra de ativos importantes, predefinir quais ações de resposta são permitidas e rastrear cada caso do sinal inicial ao fechamento. Deve medir com que frequência o registro da Secureworks continha evidência suficiente para o cliente agir, com que frequência os analistas tiveram que pedir contexto faltante, com que frequência os proprietários de negócios contestaram a recomendação e com que frequência o mesmo tipo de falso positivo recorreu.
O piloto deve incluir escalação após o expediente e pelo menos um exercício que teste a aprovação sob pressão de tempo.
O mesmo piloto deve testar portabilidade de dados e saúde da integração. O cliente pode consultar o estado da investigação através de APIs documentadas? Os casos podem sincronizar limpos no sistema de tickets ou resposta do cliente? A plataforma pode mostrar saúde e lacunas dos conectores? O cliente pode preservar evidência de caso suficiente para auditoria após mudanças de serviço? Analistas internos podem revisar e desafiar o raciocínio? Essas questões importam porque as plataformas de operações de segurança se tornam parte da memória institucional.
Um cliente que não pode inspecionar ou exportar suficiente dessa memória criou um novo risco enquanto compra um serviço de controle de risco.
Para equipes de aquisição, a questão de preço deve estar ligada ao trabalho removido. Uma ferramenta de menor custo que envia alertas ambíguos para uma equipe escassa pode ser mais cara do que um serviço gerenciado de maior custo que produz registros de ação aceitos. Por outro lado, um serviço premium que ainda exige que os clientes refaçam a investigação é um teatro caro. A comparação econômica deve contar horas de analista, uso de retentor de resposta a incidentes, interrupções de proprietários de negócios, relatórios de conformidade, fadiga de falso positivo, manutenção de integração e lacunas de cobertura de pessoal.
O preço do produto é apenas uma parte do custo unitário.
O caso positivo mais realista para a Secureworks não é autonomia total. É delegação disciplinada. O cliente delega as primeiras camadas de monitoramento, correlação, triagem e empacotamento de evidências ao Taegis e aos analistas da Secureworks. O cliente retém autoridade sobre o contexto do negócio e ações de alto impacto. O serviço é bem-sucedido quando essa divisão é clara o suficiente para que ambos os lados se movam mais rápido. Falha quando o provedor envia conclusões genéricas e o cliente deve reconstruir a evidência, ou quando o cliente espera que o provedor aja sem autoridade pré-aprovada.
Essa divisão é também a melhor defesa contra alegações excessivas de IA ou automação. O mercado agora associa essas palavras a quase todo produto de segurança, mas as operações de segurança estão cheias de exceções, evidências parciais e consequências específicas do negócio. Correlação automatizada pode tornar um caso mais forte. Enriquecimento automatizado pode economizar tempo. Resposta automatizada pode ser valiosa sob condições cuidadosamente delimitadas. Nada disso remove a necessidade de revisão quando a ação pode interromper operações.
A Secureworks deve ser valorizada onde a automação apoia uma melhor decisão humana, não onde implica que a incerteza desapareceu.
O provável comprador da Secureworks não está escolhendo entre autonomia perfeita e trabalho manual. Está escolhendo quanto do fardo repetido de investigação transferir para uma plataforma especializada e serviço gerenciado. Se o Taegis pode manter um registro de alta qualidade, o cliente obtém mais do que um feed de alertas. Obtém um caminho repetível da suspeita à decisão. Se o registro é fraco, o cliente paga duas vezes: uma pela plataforma e outra por analistas internos para reparar o raciocínio.
O veredito é, portanto, condicional, mas claro. A Secureworks é mais forte quando julgada como uma empresa de confiabilidade de ação de produção para operações de segurança. Seu valor depende se o Taegis e seus analistas gerenciados podem preservar evidência, incerteza e responsabilidade através do meio confuso da investigação. Esse é um teste mais exigente do que o volume de alertas e mais útil para os clientes. Um sinal suspeito tem pouco valor até se tornar uma ação justificada.
O Taegis ganha seu lugar quando o cliente pode aceitar essa ação com confiança suficiente para agir, ressalva suficiente para evitar excessos e registro suficiente para explicar a escolha depois.