
Resumo
- A Arctic Wolf é mais forte quando suas operações gerenciadas transformam telemetria, triagem de analistas, contexto de exposição e conhecimento específico do cliente em ações de segurança que a equipe de TI ou segurança do cliente pode efetivamente aceitar, atribuir, executar e depois defender.
- As evidências públicas apoiam um modelo amplo de operações de segurança gerenciadas em MDR, gerenciamento de exposição, detecção em nuvem, resposta a incidentes, serviços de endpoint e conscientização, mas não provam de forma independente tempos de resposta universais, precisão de detecção, conclusão de remediação ou economia para o cliente.
A unidade útil não é o alerta, mas a ação aceita
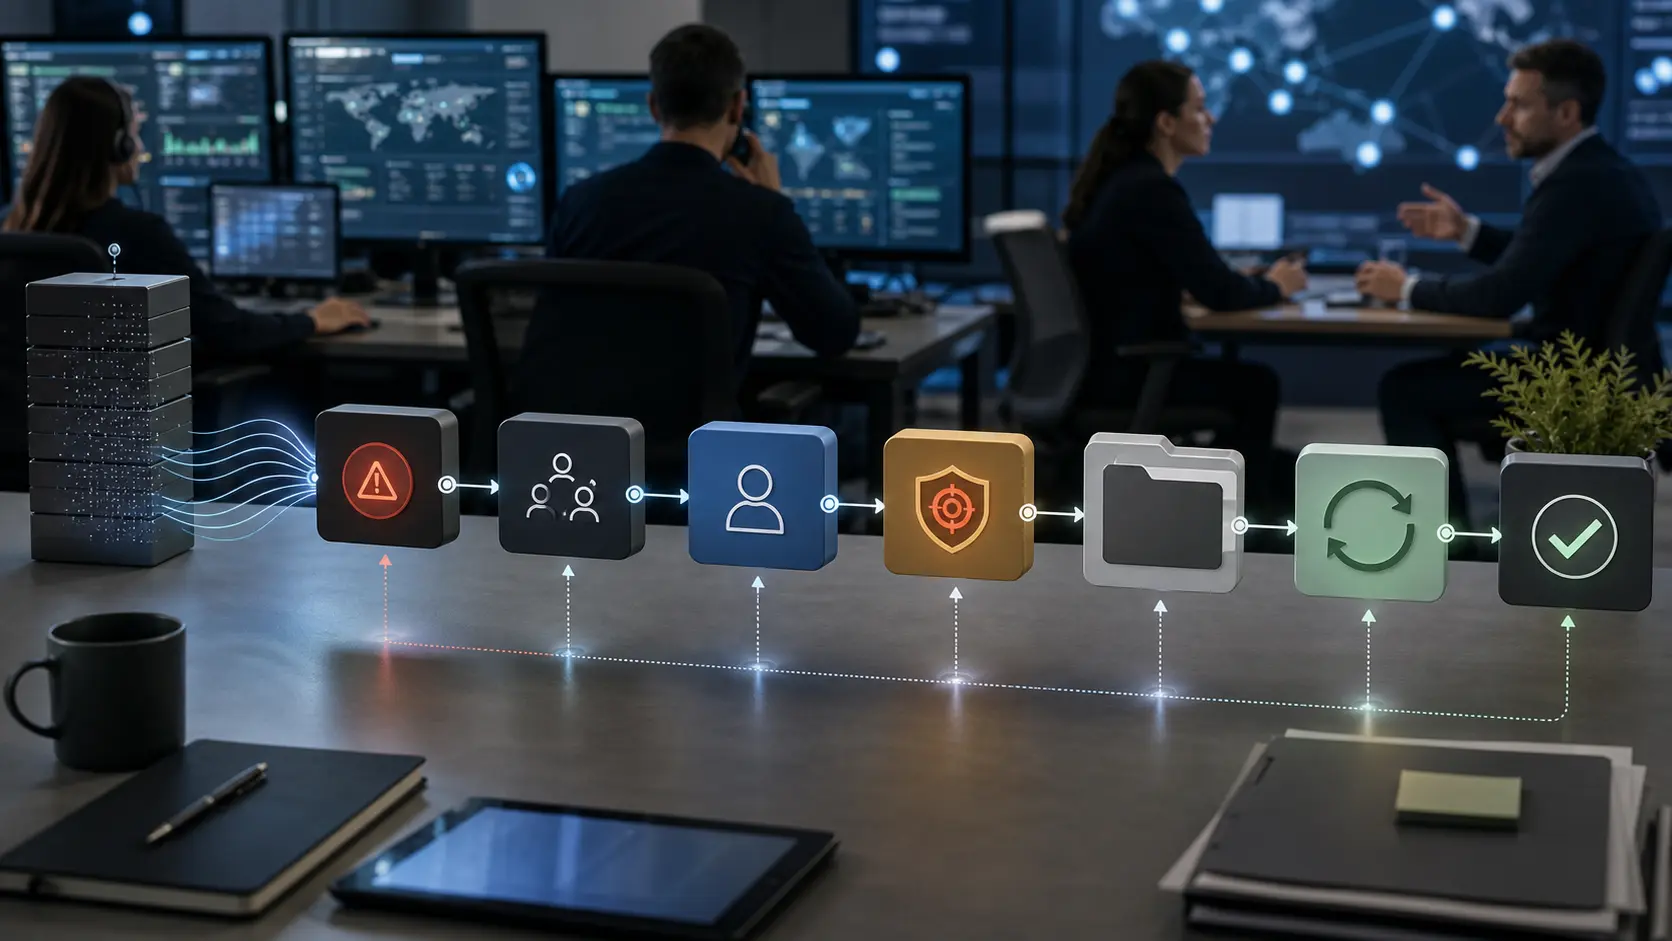
A maneira mais útil de avaliar a Arctic Wolf não é perguntar se ela pode produzir um alerta de detecção e resposta gerenciada. Muitos fornecedores de segurança podem fazer isso. A questão mais difícil é se a Arctic Wolf pode mover um cliente de um sinal para uma ação aceita: isolar este host, redefinir esta conta, corrigir este sistema, desabilitar esta identidade, bloquear esta rota, chamar este proprietário, preservar esta evidência, reabrir este ticket, verificar se a exposição foi fechada ou escalar o incidente porque o cliente não agiu rápido o suficiente.
Essa distinção é importante porque a segurança gerenciada é frequentemente comprada para fechar uma lacuna operacional, não apenas uma lacuna tecnológica. Uma empresa já pode possuir ferramentas de endpoint, logs em nuvem, alertas de identidade, scanners de vulnerabilidade e defesas de e-mail, mas ainda falhar no momento em que alguém precisa decidir o que fazer. O alerta pode ser ambíguo. O proprietário do ativo pode não estar claro. A equipe de segurança pode não ter autoridade para alterar sistemas de produção. O help desk pode ver o ticket, mas não entender o risco.
O fornecedor pode escalar, mas o cliente pode tratar a escalação como outro aviso consultivo. Uma página cheia de detecções não reduz o risco se ninguém aceitar o próximo passo.
A história pública atual da Arctic Wolf é construída em torno dessa lacuna operacional. Ela descreve um modelo gerenciado no qual a telemetria de segurança é coletada de redes internas, redes externas, endpoints e ambientes em nuvem; enriquecida com inteligência de ameaças, inteligência de código aberto, dados de vulnerabilidade e contexto de comprometimento de conta; depois investigada por uma Equipe de Segurança Concierge nomeada e uma organização mais ampla de operações de segurança. Suas páginas de produto também enquadram o serviço como um modelo de parceiro, em vez de uma implantação apenas de ferramenta.
Esse é o quadro certo para o segmento. Os clientes que compram detecção gerenciada geralmente não estão pedindo ao fornecedor para adicionar mais um painel. Eles estão pedindo ajuda para transformar sinais dispersos em trabalho repetível.
A dificuldade é que "trabalho repetível" é onde a segurança gerenciada pode se tornar decepcionante. Se a Arctic Wolf tem visibilidade, mas não contexto suficiente, pode enviar tickets ruidosos ou genéricos. Se tem contexto, mas não autoridade, pode saber a ação correta, mas ainda esperar pelo cliente. Se tem autoridade, mas controles fracos de reversão ou aprovação, pode criar risco operacional. Se fecha tickets sem prova de que a exposição foi corrigida, o cliente pode ter a sensação de atividade sem a redução do risco. A ação aceita é, portanto, um teste mais rigoroso do que a detecção.
Uma ação aceita tem várias propriedades. Ela nomeia o ativo, conta, usuário, vulnerabilidade ou processo de negócios afetado. Explica por que a ação é necessária agora, em vez de depois. Separa fatos confirmados de julgamentos de confiança. Diz quem é o responsável pelo próximo passo. Registra se a Arctic Wolf pode executar a ação, recomendá-la, coordená-la ou apenas observá-la. Captura o reconhecimento do cliente. Deixa evidências que um revisor posterior pode inspecionar. Tem um caminho para exceção, reversão ou escalação quando a ação é contestada.
Esta é a lente através da qual a Arctic Wolf deve ser julgada. A empresa construiu um portfólio público amplo o suficiente para cobrir triagem de alertas, priorização de exposição, monitoramento em nuvem, sincronização de tickets, resposta a incidentes, treinamento de conscientização e proteção de endpoints. A questão não é se esses rótulos existem. A questão é se a operação diária do cliente os experimenta como um fluxo de trabalho de ação coerente.
Um SOC gerenciado falha quando a propriedade desaparece entre a detecção e a remediação
A detecção e resposta gerenciada tem um problema de propriedade embutido na categoria. O fornecedor pode monitorar e investigar, mas o cliente geralmente possui o ambiente, o risco de negócio, as credenciais, as decisões de paralisação e a remediação final. Esse limite é inevitável. Também é onde muitos programas de MDR perdem valor.
Considere um sinal de roubo de credenciais. A Arctic Wolf pode ver autenticação anormal, atividade em nuvem, comportamento de endpoint, e-mail suspeito ou um padrão relacionado de inteligência de ameaças. A plataforma e os analistas podem enriquecer o sinal, atribuir urgência e abrir um caso. Mas a ação pode exigir que o cliente redefina senhas, desabilite contas, revogue sessões, revise regras de caixa de correio, inspecione atividade em nuvem, notifique um proprietário de negócio ou coordene com equipes jurídicas e de comunicações.
Se o cliente não concordou antecipadamente sobre quem pode autorizar quais ações, a detecção pode estar correta e ainda assim chegar tarde demais para importar.
O mesmo problema aparece no trabalho de vulnerabilidade e exposição. Os materiais de gerenciamento de exposição da Arctic Wolf enfatizam visibilidade de ativos, gerenciamento de vulnerabilidades, gerenciamento de superfície de ataque, priorização, orientação de remediação, integração com ITSM, metas de nível de serviço de remediação customizáveis e validação. Isso é exatamente para onde o gerenciamento de exposição tem que ir. Uma lista de vulnerabilidades por si só não é uma ação de segurança.
A ação aceita é a combinação de prioridade, proprietário, prazo, patch ou caminho de mitigação, tratamento de exceções e evidência de que a exposição realmente mudou.
Isso torna a prontidão do lado do cliente parte do denominador do produto. Um cliente com maturidade em propriedade de ativos, controle de endpoint, governança de identidade, disciplina de patch e regras claras de escalação pode extrair mais valor da Arctic Wolf do que um cliente cujo inventário está incompleto e cujos grupos de TI contestam todos os tickets urgentes. A Arctic Wolf pode reduzir a carga de coordenação, mas não pode fazer uma organização aceitar ações que ela está estruturalmente incapaz de executar.
O modelo Concierge da empresa tem a intenção de abordar isso atribuindo consultores de segurança nomeados que entendem o ambiente do cliente e fornecem estratégia, revisões de postura, relatórios, suporte de conformidade e suporte de remediação. O material público de FAQ diz que a Equipe de Segurança Concierge lida com triagem de alertas, priorização de riscos e patches, suporte de remediação, relatórios, atividades de conformidade, recomendações e orientação estratégica. Isso é significativo porque a ação aceita geralmente não é uma decisão única de um analista.
Ela depende do conhecimento acumulado dos sistemas do cliente, tolerância a interrupções, calendário de negócios e exceções anteriores.
Mas consultores nomeados só são valiosos se forem usados para tornar as ações mais precisas. O comprador deve perguntar como a Arctic Wolf registra o contexto específico do cliente, como esse contexto chega à triagem, com que frequência os playbooks são revisados e como suposições desatualizadas são removidas. Uma equipe nomeada pode se tornar uma força quando sabe que um determinado servidor é crítico para os negócios, que um determinado domínio de fornecedor é legítimo, que uma fábrica não pode reiniciar durante uma janela de produção ou que um sistema de identidade específico tem um caminho de migração conhecido.
Torna-se teatro se o ticket ainda parece um aviso genérico.
A propriedade também deve ser visível nos relatórios. Um relatório de SOC gerenciado útil não deve apenas contar alertas ou incidentes. Deve mostrar quais ações foram recomendadas, quais foram aceitas, quais foram executadas, quais perderam prazos, quais foram aceitas como risco pelo negócio e quais se repetiram porque a causa raiz não foi removida. Sem essa contabilidade de ações, tanto o fornecedor quanto o cliente podem parecer ocupados enquanto os mesmos riscos circulam pela fila.
A qualidade da telemetria é a primeira restrição em cada decisão downstream
A documentação de MDR da Arctic Wolf descreve telemetria de segurança de redes, endpoints e ambientes em nuvem, enriquecida com feeds de ameaças, OSINT, informações de CVE, dados de comprometimento de conta e outros contextos. Sua documentação de detecção em nuvem lista uma ampla gama de integrações suportadas de SaaS, identidade, infraestrutura, e-mail, rede e ferramentas de segurança, incluindo plataformas em nuvem, provedores de identidade, ferramentas SASE e fontes de segurança de e-mail. Seus materiais públicos também enfatizam uma postura XDR aberta, integrações atuais e processamento de eventos em larga escala.
Essa amplitude é importante, mas amplitude de telemetria não é o mesmo que qualidade de telemetria. Em operações gerenciadas, o primeiro modo de falha é frequentemente visibilidade incompleta ou mal normalizada. Se a cobertura de endpoint é parcial, os logs de identidade estão atrasados, os sensores em nuvem estão mal configurados, os sensores de rede perdem caminhos-chave, ou os dados do ticket não preservam os campos corretos, o analista vê uma imagem distorcida. Um sinal fraco pode ser triado como baixa prioridade porque a peça ausente nunca foi coletada.
Um ticket de alta gravidade pode ser superdimensionado porque o sistema carece de contexto de negócio. Uma exposição pode parecer fechada porque o scanner não a vê mais, mesmo que o ativo tenha sido movido ou o controle tenha quebrado.
É por isso que a integração e a prontidão técnica importam mais do que o marketing geralmente admite. As páginas de produto da Arctic Wolf referenciam configuração de serviço, prontidão técnica e configuração essencial de logs como parte da entrega de MDR. Essas não são preliminares administrativas; fazem parte do controle. A decisão inicial sobre quais logs são coletados, como as identidades são mapeadas, como os ativos são nomeados, como os endpoints são agrupados, como as contas em nuvem são escopadas e como os alertas são roteados determina a qualidade de cada ação posterior.
O comprador deve tratar a configuração de telemetria como um projeto conjunto de segurança, não uma lista de verificação de compras. Quais sinais são obrigatórios? Quais são opcionais? Quais integrações fornecem fluxo de eventos em tempo real e quais fornecem dados em lote atrasados? Quais fontes podem acionar contenção ou resposta de identidade, e quais fornecem apenas contexto? Como os coletores com falha são detectados? Quem é responsável por corrigir a ingestão quebrada? As lacunas de fonte de log são visíveis nas revisões mensais?
Como a equipe da Arctic Wolf sabe quando um sensor está inativo, uma credencial de API está expirando ou um cliente adicionou um novo locatário em nuvem fora do escopo monitorado?
As atualizações públicas de produto mostram que a Arctic Wolf continua adicionando superfícies de dados e ação, incluindo suporte para fontes adicionais de monitoramento em nuvem e identidade, serviços de notificação para credenciais, APIs de blocklist e relatórios, e recursos do Data Explorer. Essas atualizações são bons sinais de uma plataforma ativamente mantida, mas também mostram por que a manutenção da integração é uma tarefa permanente. Cada nova fonte, API, permissão ou recurso de relatório adiciona valor potencial apenas se o ambiente do cliente for mantido atualizado.
A telemetria também está ligada à qualidade da evidência. Quando um analista recomenda contenção ou correção de vulnerabilidade, o cliente precisa ver a base para essa ação. Um vago "comportamento suspeito observado" é menos útil do que um caso que mostra qual conta mudou, qual host se comunicou, qual serviço em nuvem registrou a ação, qual vulnerabilidade está sendo explorada na natureza, qual ativo está exposto e qual serviço de negócio pode ser afetado. Quanto mais concreta a evidência, mais fácil é para o cliente aceitar a recomendação e executá-la rapidamente.
A questão central do artigo, portanto, começa antes do alerta. A Arctic Wolf só pode transformar um sinal em uma ação aceita se o sinal chegar com cobertura, atualidade, mapeamento de identidade e contexto de ativo suficientes para tornar a ação defensável.
A triagem precisa reduzir o ruído sem esconder a incerteza
A página de MDR da Arctic Wolf diz que o serviço foi projetado para entregar resultados, não mais alertas. Seus materiais públicos descrevem triagem, investigações, ações de resposta, revisões proativas de postura, contexto específico do cliente e um modelo no qual a análise automatizada é combinada com validação humana. Essa é a ambição certa, porque o encaminhamento de alertas é uma das formas menos valiosas de segurança gerenciada. Se um provedor simplesmente envia tudo para o cliente, ele terceirizou o ruído em vez de reduzir o risco.
A triagem cria valor quando transforma eventos brutos em um número menor de casos explicáveis. Deve linkar sinais relacionados, suprimir comportamentos benignos conhecidos, identificar o caminho de ataque mais plausível, preservar explicações alternativas e atribuir urgência. Também deve tornar a incerteza explícita. Um caso raramente é perfeitamente confirmado ou sem sentido. Uma boa nota de triagem diz o que é conhecido, o que é suspeito, o que está faltando, qual ação é recomendada e o que mudaria a recomendação.
Os exemplos públicos da Arctic Wolf são úteis aqui, especialmente suas linhas do tempo de resposta a incidentes. Eles mostram a forma de um fluxo de trabalho no qual um sinal é detectado, correlacionado com outra atividade, escalado para triagem, contido ou remediado, e seguido por trabalho adicional de jornada de segurança. Essas linhas do tempo não devem ser lidas como uma promessa universal de tempo de resposta. São exemplos selecionados. Sua lição mais importante é processual: a ação se torna crível quando o caso conecta fonte, evidência, escalação, remediação e posterior endurecimento.
O risco é que a linguagem de IA e automação pode fazer a triagem parecer mais certa do que é. A Arctic Wolf descreve uma plataforma Aurora com automação especializada, contexto específico do cliente, um Gráfico de Operações de Segurança, proteções, registro, reversão e aprovação humana para ações de alto impacto. Também diz que os humanos permanecem no loop para julgamento, supervisão e decisões críticas. Essa ressalva não é uma fraqueza; é central para a confiança. Em operações de segurança, velocidade sem julgamento pode produzir erros caros.
Uma contenção falsa, uma desabilitação de conta equivocada ou um patch mal programado pode interromper os negócios.
O teste de ação aceita pergunta se a automação melhora a capacidade do analista de agir, não se substitui a responsabilidade. A automação coleta evidências mais rapidamente? Reduz o trabalho duplicado? Identifica casos semelhantes? Prepara um ticket que um humano pode validar? Propõe uma remediação com confiança e ressalvas? Registra por que uma ação foi tomada ou adiada? Impede que ações de baixa confiança ou irreversíveis sejam executadas sem revisão?
Os clientes devem procurar qualidade de triagem em artefatos diários, não apenas em descrições de plataforma. Um caso de alta qualidade da Arctic Wolf deve ser legível pelo líder de segurança do cliente, por um proprietário de TI e por um auditor. Deve contar uma história coerente. Deve nomear os sistemas afetados. Deve mostrar por que a ação recomendada é proporcional. Deve distinguir comprometimento confirmado de atividade suspeita. Deve reter metadados suficientes para pesquisa posterior.
Deve evitar fechar o loop com "monitoramento continua" quando o cliente ainda tem um sistema não corrigido, serviço exposto ou problema de identidade não resolvido.
A redução de ruído deve ser medida localmente. Se a Arctic Wolf afirma reduzir a carga de alertas, o cliente deve comparar a carga de trabalho pré-serviço com a fila de ações pós-serviço. Quantos alertas se tornaram tickets? Quantos tickets exigiram trabalho do cliente? Quantos foram falsos positivos? Quantos foram reabertos? Quantos se tornaram casos de resposta a incidentes? Quantos resultaram em uma mudança de controle documentada? A medida útil não é o número absoluto de eventos processados pelo fornecedor. É o número de ações válidas que o cliente pode executar sem se afogar em exceções.
A autoridade de resposta é a dobradiça entre conselho e redução de risco
O FAQ da Arctic Wolf diz que as escalações voltadas para o cliente e as ações de alto impacto envolvem supervisão e aprovação humana, e que as ações de resposta operam dentro de limites definidos. Sua documentação também referencia Active Response e inteligência de endpoint como parte do licenciamento MDR, enquanto as atualizações de produto listam integrações de ação de resposta de identidade para serviços suportados. É aqui que o serviço gerenciado passa do conselho para a intervenção.
A autoridade de resposta deve ser negociada com cuidado. Pouca autoridade deixa o fornecedor enviando recomendações que ficam na fila do cliente. Muita autoridade pode criar risco operacional e legal. Um provedor de segurança gerenciada pode saber que desabilitar uma conta é a ação cibernética mais segura, mas o cliente pode saber que a conta executa um processo crítico. Um fornecedor pode recomendar isolar um host, mas o host pode estar em uma cadeia de produção onde a paralisação é mais prejudicial do que o monitoramento curto.
Um fornecedor pode pressionar por patch de emergência, mas o cliente pode ter um congelamento de mudanças com implicações regulatórias ou de segurança.
O modelo certo não é simplesmente "automatizar mais". É autoridade em camadas. Ações de baixo risco podem ser pré-autorizadas. Ações de médio risco podem exigir reconhecimento do cliente dentro de uma janela definida. Ações de alto impacto podem exigir aprovação explícita, escalação para funções nomeadas e planejamento de reversão. Em todos os casos, o sistema deve registrar quem autorizou a ação, que evidência a apoiou, o que foi feito e como o resultado foi verificado.
A ênfase pública da Arctic Wolf em proteções, privilégio mínimo, permissões, monitoramento, registro, explicabilidade, reversão e aprovação humana para ações de alto impacto está alinhada com este modelo. O comprador ainda precisa testar como esses controles funcionam no pacote de serviço real que está sendo adquirido. Uma página de produto pode descrever a filosofia de design, mas o contrato, as integrações e os runbooks do cliente determinam o limite real de autoridade.
Um modo de falha comum é a responsabilidade de contenção pouco clara. Se a Arctic Wolf detecta atividade suspeita em endpoint, ela pode isolar o host? Esse recurso está disponível na licença do cliente? Depende do software de endpoint da Arctic Wolf, de uma ferramenta de endpoint de terceiros ou de ambos? Quem aprova o isolamento? Como uma exceção crítica para os negócios é tratada? Como o host é restaurado? O que acontece se o isolamento falhar? Como a falha é comunicada à equipe do cliente?
A resposta de identidade levanta questões semelhantes. Se a atividade suspeita envolve um provedor de identidade ou conta em nuvem, a Arctic Wolf pode desabilitar o usuário, remover grupos, redefinir credenciais ou forçar reautenticação? As atualizações públicas de produto mostram movimento nessa direção para integrações específicas, mas a disponibilidade de integração não é o mesmo que prontidão operacional. A equipe de identidade do cliente deve saber quais ações são permitidas, quais exigem aprovação e como as mudanças de emergência são reconciliadas com a governança normal de identidade.
A resposta a incidentes adiciona um limite diferente. A Arctic Wolf oferece serviços de resposta a incidentes e prontidão para incidentes, incluindo restauração, remediação de incidentes graves e forense digital. Em um evento importante, a ação aceita pode não ser mais um ticket discreto. Pode envolver restauração de negócios, preservação de evidências, coordenação jurídica, comunicações, seguro, estratégia de negociação e um plano de endurecimento pós-incidente. O fornecedor pode orientar ou realizar partes desse trabalho, mas o cliente ainda possui as decisões de negócios.
O relacionamento gerenciado mais valioso é aquele em que esses papéis são esclarecidos antes da violação.
A autoridade de resposta é, portanto, a dobradiça da promessa comercial. Detecção encontra risco. Triagem explica. Autoridade determina se o serviço pode reduzi-lo.
O gerenciamento de exposição é valioso apenas quando as descobertas se transformam em encerramento
Os materiais de gerenciamento de exposição da Arctic Wolf apresentam um escopo expandido: visibilidade de ativos, gerenciamento de vulnerabilidades, gerenciamento de superfície de ataque, priorização, remediação, validação, gerenciamento de patches através do Resolve, integrações com ITSM, orientação alimentada por IA, metas de nível de serviço de remediação customizáveis e relatórios sob demanda. A direção é comercialmente sensata. Muitas organizações não falham porque lhes faltam descobertas de vulnerabilidade.
Elas falham porque não conseguem determinar quais descobertas importam, quais ativos são reais, quem os possui e se a correção aconteceu.
A ação aceita no gerenciamento de exposição é diferente da ação aceita no MDR. Um caso de detecção geralmente pede ao cliente para responder a uma ameaça suspeita ou confirmada. Um caso de exposição pede ao cliente para reduzir a probabilidade ou o raio de explosão de uma ameaça futura. Isso torna mais fácil adiar. Uma vulnerabilidade crítica em um serviço voltado para a internet pode gerar ação. Uma má configuração em um sistema de perfil mais baixo pode ficar semanas. Um ativo obsoleto pode ser contestado. Um patch pode quebrar um aplicativo.
Um scanner pode continuar relatando uma descoberta depois que uma solução alternativa está em vigor.
O melhor caminho da Arctic Wolf é conectar o trabalho de exposição ao contexto operacional. As páginas públicas dizem que o Aurora Vulnerability Management enriquece as descobertas com contexto de ativo, inteligência de ameaças e probabilidade de exploração, e que o Attack Surface Management correlaciona inteligência de ameaças, contexto de negócio, criticidade do ativo, gravidade e explorabilidade, enquanto verifica a remediação. Essas são as entradas certas. Uma pontuação CVSS genérica não é suficiente.
Uma vulnerabilidade em um ativo voltado para o público não gerenciado usado por um sistema privilegiado tem uma prioridade de ação diferente da mesma vulnerabilidade em um host de laboratório atrás de controles compensatórios.
Mas o gerenciamento de exposição também é onde o trabalho do lado do cliente é mais visível. O fornecedor pode priorizar. O cliente aplica patches, altera configuração, substitui ativos, aceita risco ou financia remediação. O add-on de gerenciamento de patches Resolve da Arctic Wolf pode reduzir parte desse fardo para endpoints e sistemas operacionais suportados, e as atualizações públicas mostram suporte para macOS e Linux adicionado ao Resolve em junho de 2026. Mesmo assim, o gerenciamento de patches tem pré-requisitos: cobertura, agendamento, tolerância a reversão, janelas de manutenção, teste de aplicativos e tratamento de exceções.
O comprador deve pedir à Arctic Wolf para demonstrar o fluxo de trabalho completo de risco à remediação. Uma descoberta aparece. A plataforma a deduplica. Mapeia o ativo. Prioriza com base em ameaça e contexto de negócio. Abre ou sincroniza um ticket. Atribui um proprietário. Define uma data alvo. Fornece orientação de remediação. Acompanha o status. Revara ou valida de outra forma. Relata se o risco foi reduzido. Escala metas perdidas. Preserva exceções e aceitações de risco.
A versão mais perigosa do gerenciamento de exposição é aquela que melhora os painéis sem mudar a realidade. Se o mesmo serviço exposto permanece acessível, a mesma vulnerabilidade não corrigida recorrente, ou o mesmo ativo não gerenciado continua reaparecendo, o cliente não reduziu o risco. Os relatórios da Arctic Wolf devem tornar a recorrência visível, não enterrá-la na melhoria agregada. A diferença entre "descobrimos 5.000 riscos" e "fechamos os 40 riscos com maior probabilidade de importar" é a diferença entre atividade e resultado.
A questão comercial do artigo também está aqui. O gerenciamento de exposição pode tornar o MDR mais valioso porque reduz o número de incidentes evitáveis. Também pode aumentar a carga de trabalho do cliente se cada descoberta priorizada se tornar um ticket contestado. O valor da Arctic Wolf depende se sua priorização é confiável o suficiente para que as equipes do cliente ajam com base nela.
Ticketing, APIs e relatórios decidem se a ação sobrevive ao handoff
As ações de segurança geralmente falham depois que o analista fez um bom trabalho. O caso está claro, mas o sistema de trabalho do cliente está em outro lugar. O ticket perde campos quando sincronizado. A equipe proprietária não vê a urgência. Os comentários se dividem entre portais. Tickets duplicados confundem o status. Uma etapa de remediação é concluída na ferramenta ITSM, mas não refletida no portal de segurança. Um painel diz que o risco é menor, enquanto o proprietário do ativo acha que o trabalho ainda está pendente.
A documentação da Arctic Wolf aborda parte dessa superfície. Ela suporta sincronização de tickets ITSM entre o Portal Unificado da Arctic Wolf e o software ITSM do cliente, com integrações webhook para ConnectWise e ServiceNow e um modelo de pull bidirecional genérico através da API de Ticket da Arctic Wolf. A documentação observa que integrações personalizadas exigem equipe técnica do cliente porque os clientes conhecem suas próprias ferramentas. Essa é uma limitação importante. A disponibilidade de integração não elimina o trabalho de implementação.
O fluxo de trabalho de ação aceita depende desse handoff. Se o cliente vive no ServiceNow, ConnectWise ou outro sistema ITSM, o caso da Arctic Wolf deve chegar como um item de trabalho utilizável. Deve preservar gravidade, evidência, data de vencimento, ação recomendada, proprietário, serviço afetado, identificadores de ativo, comentários, anexos, histórico de escalação e critérios de encerramento. Se um analista de segurança tiver que redigitar manualmente os detalhes ou reconciliar estados, o serviço gerenciado está perdendo valor no limite.
A API de Ticket e a API de Relatórios também são relevantes porque clientes maduros geralmente desejam medir operações de segurança em seu próprio ambiente de relatórios. Eles podem precisar vincular as ações da Arctic Wolf ao gerenciamento de mudanças, inventário de ativos, remediação de vulnerabilidades, registros de incidentes, controles de conformidade, requisitos de seguro e painéis executivos. As APIs podem suportar isso, mas apenas se os campos forem estáveis, documentados, os limites de taxa forem compreendidos, a autenticação for tratada com segurança e a semântica de status estiver clara.
O comprador deve testar relatórios em torno da conclusão da ação, não apenas contagens de alertas. O cliente pode exportar todos os casos de alta gravidade para um trimestre? Pode identificar quais ações recomendadas foram aceitas, rejeitadas, concluídas ou em atraso? Pode ver quais unidades de negócios repetidamente perdem metas de remediação? Pode vincular um ticket fechado a evidências de validação? Pode distinguir "recomendado pela Arctic Wolf" de "executado pelo cliente" e "risco aceito"? Pode mostrar aos auditores a sequência de eventos sem montar capturas de tela manualmente?
As atualizações públicas de produto mostram melhorias contínuas em relatórios e exploração de dados, incluindo sincronização de relatórios e recursos relacionados à pesquisa. Essas são úteis, mas os relatórios são tão fortes quanto o processo subjacente. Se um ticket pode ser fechado sem remediação verificada, o relatório pode criar conforto falso. Se os comentários do cliente não sincronizam de volta, a equipe da Arctic Wolf pode operar com status desatualizado. Se a prevenção de duplicatas é fraca, duas equipes podem trabalhar o mesmo risco de forma diferente.
É por isso que a ação é a unidade correta de avaliação. Uma ação não está completa quando um caso é criado. Está completa quando o proprietário certo a aceitou, a etapa acordada foi tomada, o resultado foi verificado ou explicitamente aceito como risco, e a evidência está disponível para revisão posterior. Ticketing, APIs e relatórios são os trilhos que tornam isso possível em escala.
A economia do lado do cliente decide se a segurança gerenciada é mais barata do que construir o músculo
O apelo comercial da Arctic Wolf é mais claro para organizações que não podem ou não querem construir um centro de operações de segurança interno completo. A empresa diz que atende milhares de clientes em todos os setores e geografias, com monitoramento 24x7, especialistas em operações de segurança e mitigação de riscos guiada. Também posiciona seu serviço contra a escassez de talentos, a proliferação de ferramentas e os custos crescentes de segurança.
Esses são problemas reais do comprador. Contratar, treinar e reter analistas experientes é caro. Manter cobertura 24x7 é difícil. Manter detecções, integrações, escalações, caça a ameaças e playbooks de incidentes requer um modelo operacional especializado. Para muitas equipes de médio porte e empresariais, um serviço gerenciado pode produzir uma linha de base melhor do que uma equipe interna enxuta monitorando uma pilha de ferramentas.
Mas a segurança gerenciada não é gratuita uma vez adquirida. O cliente ainda paga taxas de serviço, integra telemetria, participa da integração, participa de revisões, executa remediação, lida com exceções, atualiza contatos, gerencia cobertura de identidade e endpoint, participa de resposta a incidentes e financia melhorias de controle. Se o ambiente do cliente for desorganizado, o serviço gerenciado pode expor mais trabalho do que a equipe esperava. Isso não é necessariamente ruim; o risco anteriormente oculto ainda é risco. Mas muda a economia.
O comprador deve calcular o custo da ação aceita, não apenas o custo do monitoramento. Suponha que a Arctic Wolf reduza o ruído de alertas, mas crie um fluxo menor de ações de alta qualidade. Quem executa essas ações? Quantas horas o patch consome? Quanta interrupção de negócios ocorre devido a mudanças de emergência? Quanto tempo interno é necessário para revisões mensais? Quanto esforço vai para a manutenção do conector? Com que frequência o cliente precisa de suporte de resposta a incidentes fora do serviço principal? Quais são os benefícios de seguro, conformidade ou relatórios ao conselho?
Que trabalho pode ser evitado porque a equipe da Arctic Wolf realiza triagem, pesquisa, enriquecimento e recomendações?
A seleção da Chubb da Arctic Wolf como provedor de MDR preferencial para segurados de cyber qualificados é um sinal de mercado significativo porque as seguradoras se preocupam com controles operacionais que reduzem a probabilidade e a gravidade de sinistros. Isso não prova que todo cliente da Arctic Wolf reduzirá perdas, mas mostra que uma parte interessada de seguros vê valor no padrão de controle: visibilidade ampla, monitoramento contínuo, detecção de ameaças e implementação guiada de controles críticos.
O alinhamento de seguros pode influenciar a economia se melhorar a garantia de seguro, preços, evidências de controle ou postura de renovação.
O material do Gartner Peer Insights e as próprias referências da Arctic Wolf a altas taxas de recomendação e classificações de clientes fornecem contexto adicional de sinal de mercado. São úteis, mas não decisivos. As populações de revisão são auto-selecionadas e os ambientes dos compradores diferem. Uma pequena equipe de TI pode valorizar o modelo de filtragem de alertas e consultoria da Arctic Wolf porque carece de analistas internos.
Um SOC empresarial maduro pode se importar mais com a profundidade da integração, controle sobre playbooks, fidelidade da API e como a Arctic Wolf coexiste com investimentos existentes em SIEM, SOAR, endpoint e segurança em nuvem.
O caso econômico mais forte aparece quando a Arctic Wolf ajuda o cliente a fazer trabalho que de outra forma não faria bem: manter monitoramento contínuo, conectar sinais de identidade e nuvem, triar atividade suspeita, priorizar trabalho de exposição, coordenar resposta a incidentes, produzir relatórios prontos para o conselho e manter pressão sobre a remediação. O caso mais fraco aparece quando o cliente já tem operações internas fortes e a Arctic Wolf se torna mais uma camada de alertas, portais e reuniões.
A conclusão é pragmática. A Arctic Wolf não deve ser comprada como uma forma de evitar responsabilidade. Deve ser comprada quando o cliente está preparado para usar o serviço como um parceiro operacional e medir se as ações aceitas estão acontecendo mais rapidamente, com melhores evidências e menos tensão interna do que o cliente poderia alcançar sozinho.
Exemplos de incidentes mostram a forma do fluxo de trabalho, não o desempenho universal
As páginas de linha do tempo de resposta a incidentes da Arctic Wolf estão entre os artefatos públicos mais claros para entender o modelo operacional preferido da empresa. A linha do tempo de ransomware mostra atividade detectada a partir do Active Directory e de um sensor da Arctic Wolf, correlação de tráfego de comando e controle com atividade do PowerShell Empire, escalação para triagem e remediação subsequente.
A linha do tempo de vulnerabilidade do Microsoft Exchange mostra integração, detecção, investigação, escalação, contenção, etapas de remediação, uma chamada com o cliente e trabalho adicional de jornada de segurança, como avaliação de patches, redefinições de conta, regras de bloqueio de firewall e endurecimento adicional.
Esses exemplos devem ser tratados com cuidado. São narrativas públicas selecionadas, não testes de desempenho aleatórios. Não provam que todo cliente receberá a mesma velocidade, que todo sinal será detectado, que toda contenção será bem-sucedida ou que toda remediação será concluída. O artigo não os usa dessa forma.
Seu valor é que revelam o tipo de fluxo de trabalho que a Arctic Wolf quer que os compradores esperem. O serviço não é meramente "vimos um alerta". É uma sequência: sinal de origem, correlação na plataforma, escalação para triagem, revisão do analista, contato com o cliente, contenção, remediação, acompanhamento e melhoria de postura. Essa é a forma correta para operações de segurança gerenciadas. Também expõe os lugares onde a falha pode acontecer.
No estágio de origem, a telemetria pode estar faltando. No estágio de correlação, os sinais podem não estar linkados. No estágio de triagem, a urgência pode estar errada. No estágio de contato com o cliente, o proprietário certo pode não estar acessível. No estágio de contenção, a autoridade pode ser insuficiente. No estágio de remediação, o cliente pode não ter capacidade de patch. No estágio de acompanhamento, a organização pode fechar o incidente imediato, mas ignorar a fraqueza sistêmica.
Uma boa segurança gerenciada transforma esses pontos de falha em controles explícitos. As listas de contato são mantidas. As rotas de escalação são testadas. Os playbooks definem autoridade. Os tickets preservam evidências. O contexto específico do cliente é atualizado. As varreduras de vulnerabilidade e as revisões de postura alimentam prioridades futuras. As lições dos incidentes mudam os planos de detecção e remediação. A linha do tempo se torna um loop operacional em vez de uma história sobre um único evento.
O comprador deve pedir à Arctic Wolf para percorrer exemplos anonimizados recentes que se assemelhem ao ambiente do próprio cliente. Um hospital, fabricante, governo local, varejista, empresa de software e instituição financeira não terão restrições idênticas. Paralisação crítica para os negócios, requisitos de privacidade, obrigações de seguro cibernético, coordenação jurídica e dependências de terceiros diferem. Um exemplo relevante é aquele em que o handoff, a autoridade e as restrições de remediação parecem familiares.
O exercício de due diligence mais importante é ensaiar um incidente antes que ele ocorra. Quem no cliente recebe a escalação da Arctic Wolf às 2 da manhã? Quem pode autorizar o isolamento do host? Quem pode desabilitar uma identidade privilegiada? Quem pode aprovar mudanças de emergência no firewall? Quem pode contatar executivos? Quem é responsável pela preservação de evidências? Quem se comunica com seguradoras? Quem decide quando a restauração dos negócios tem prioridade sobre a integridade forense? A Arctic Wolf pode fornecer experiência, mas o mapa de decisão do cliente tem que existir.
Os exemplos de incidentes apoiam a confiança na direção do modelo. Eles não removem a necessidade de ensaio local.
IA é útil apenas quando preserva supervisão e auditabilidade
A linguagem atual da plataforma da Arctic Wolf inclui fluxos de trabalho avançados de IA, automação especializada, uma estrutura Swarm of Experts, um Gráfico de Operações de Segurança, processamento de eventos em larga escala, contexto específico do cliente e um AI Trust Engine com controles para testes, permissões, monitoramento, registro, explicabilidade, reversão e aprovação humana. A empresa também diz que a funcionalidade atual de IA generativa não é treinada em dados do cliente, enquanto dados relevantes do cliente e de segurança podem ser usados no momento da invocação para melhorar o contexto.
Para o ângulo deste artigo, a IA não é o centro das atenções. A ação aceita é. A IA é útil apenas na medida em que ajuda a produzir melhores ações aceitas. Se enriquece evidências, agrupa sinais, pesquisa eventos relacionados, redige tickets mais claros, identifica casos semelhantes anteriores, resume grandes conjuntos de dados ou destaca contexto ausente, pode reduzir o tempo de ciclo e a fadiga do analista. Se produz recomendações confiantes, mas superficiais, esconde incertezas ou confunde quem aprovou uma ação, torna-se um risco.
As operações de segurança têm um ônus de responsabilidade maior do que muitos outros fluxos de trabalho de software. Uma recomendação equivocada pode desabilitar uma conta crítica, isolar um servidor de produção, perder uma intrusão ativa, expor dados privados ou criar um registro de auditoria que mais tarde se mostra enganoso. É por isso que a ênfase pública da Arctic Wolf em limites, privilégio mínimo e aprovação humana é importante. O comprador deve tratar esses controles como pontos de inspeção, não slogans.
As perguntas são concretas. Quais ações os fluxos de trabalho de IA podem iniciar? Quais ações eles podem apenas recomendar? Quais ações exigem validação do analista? Quais exigem aprovação do cliente? Como as entradas do modelo, evidências recuperadas, recomendações do sistema e anulações humanas são registradas? Como o sistema evita vazamento de contexto entre clientes? Como as falsas recomendações são detectadas e realimentadas? Que reversão existe para ações automatizadas ou semiautomatizadas? Como um cliente pode revisar as evidências por trás de uma contenção ou remediação sugerida?
O uso mais crível de IA neste contexto é a assistência limitada. Um caso começa com um sinal. Fluxos de trabalho automatizados reúnem eventos relacionados, aplicam inteligência de ameaças, inspecionam contexto específico do cliente e preparam um pacote de evidências. Um analista humano valida a conclusão e fecha, escala ou recomenda ação. O cliente recebe um ticket com explicação suficiente para agir. Etapas de alto impacto exigem aprovação. O sistema registra a decisão e o resultado. Casos futuros se beneficiam do resultado.
Esse modelo suporta o fluxo de trabalho de ação aceita. Aumenta a velocidade sem fingir que a segurança cibernética se tornou um problema totalmente autônomo. Também respeita a responsabilidade retida do cliente. Mesmo que a Arctic Wolf realize mais análise automaticamente, o cliente ainda possui sistemas, risco de negócio e muitas escolhas de remediação.
O comprador deve desconfiar de qualquer alegação de IA que não possa ser rastreada até um artefato operacional diário. "Mais automação" não é um resultado de negócio. "Este caso chegou ao proprietário certo com evidências claras, a ação foi aprovada, a correção foi verificada e a trilha de auditoria está completa" é um resultado de negócio. A história da plataforma da Arctic Wolf deve ser avaliada pelo segundo padrão.
A experiência do cliente depende se o aconselhamento se torna um ritmo operacional compartilhado
O modelo Concierge da Arctic Wolf é projetado para criar ritmo: revisões, avaliações de postura, orientação estratégica, monitoramento, relatórios, suporte de remediação e planejamento de jornada de segurança. A melhor versão desse modelo dá ao cliente uma cadência operacional de segurança que não conseguiria sustentar sozinho. A pior versão se torna uma reunião mensal onde itens abertos são revisados sem autoridade suficiente para mudar o backlog.
A diferença é a disciplina da pauta. Uma revisão útil deve começar com o status da ação: incidentes críticos, descobertas de alta prioridade não resolvidas, remediação em atraso, exposições repetidas, lacunas de integração, detecções ruidosas, falsos positivos, escalações perdidas e exceções. Depois, deve conectar esses itens a decisões de negócio. O cliente precisa financiar cobertura de endpoint? Substituir uma ferramenta de patch quebrada? Atualizar runbooks de resposta de identidade? Mudar política de backup? Reforçar controles de VPN? Aposentar ativos obsoletos voltados para a internet? Adicionar uma integração em nuvem?
Treinar uma unidade de negócios que repetidamente clica em simulações de phishing?
A Arctic Wolf pode fornecer os dados e recomendações, mas o cliente deve transformá-los em decisões. É por isso que a lente de ação aceita também é uma lente de gestão. Uma empresa que compra MDR e depois ignora repetidas recomendações de remediação não está recebendo valor baixo porque faltam alertas ao fornecedor. Está recebendo valor baixo porque o loop operacional está quebrado.
O treinamento de conscientização de segurança se encaixa nesse ritmo também. A navegação pública de soluções da Arctic Wolf enquadra a conscientização e o treinamento em torno do engajamento dos funcionários para reconhecer e neutralizar ataques de engenharia social, com simulações de phishing e microaprendizagem relevante. A conscientização é frequentemente avaliada pela taxa de conclusão ou taxa de clique. Para o propósito deste artigo, a questão da ação é mais nítida: quando um padrão aparece, o treinamento muda comportamento, relatórios, política ou design de controle?
Se um departamento repetidamente lida mal com ameaças simuladas ou reais, a equipe Concierge ajuda o cliente a ajustar defesas e educação? Se o treinamento produz relatos de usuários, esses relatos são triados e alimentados nos fluxos de trabalho de detecção?
A detecção e resposta em nuvem também depende do ritmo. A lista de integrações suportadas é ampla, incluindo principais fontes de nuvem, SaaS, identidade, e-mail e rede. Mas os ambientes em nuvem mudam rapidamente. Novos locatários, ferramentas SaaS não gerenciadas, credenciais temporárias, experimentos de desenvolvedores e desvios de permissão podem criar lacunas. O serviço gerenciado deve ajudar o cliente a manter a visibilidade à medida que o ambiente muda. Caso contrário, um mapa de integração antes bom torna-se desatualizado.
O mesmo vale para a prontidão para incidentes. Um serviço de retentor ou resposta a incidentes é mais valioso quando a preparação precede o evento. Listas de contato, matrizes de autoridade, expectativas de evidência, requisitos de seguro e prioridades de restauração devem ser conhecidos antes da crise. Os materiais públicos de incidentes e as descrições de serviço da Arctic Wolf apoiam essa orientação, mas os clientes ainda precisam ensaiar.
O ritmo compartilhado deve produzir menos surpresas. Não incidentes zero, falsos positivos zero e tickets urgentes zero; essas promessas seriam irrealistas. Em vez disso, menos momentos em que o cliente diz: "Quem é o dono disso?" ou "Por que você não nos disse que isso importava?" ou "Por que este ticket foi fechado?" Um bom parceiro de operações gerenciadas torna essas perguntas mais raras.
Onde as evidências públicas da Arctic Wolf são fortes e onde permanecem limitadas
As evidências públicas apoiam várias conclusões com confiança moderada. A Arctic Wolf tem um portfólio amplo e atual de operações de segurança gerenciadas. Sua documentação de MDR cobre monitoramento contínuo, enriquecimento de telemetria, inteligência de endpoint, resposta ativa e uma equipe Concierge nomeada. Suas páginas de gerenciamento de exposição abordam visibilidade de ativos, priorização de vulnerabilidades, orientação de remediação, integração ITSM, validação e suporte de gerenciamento de patches.
Sua documentação de detecção em nuvem mostra uma ampla superfície de integração em SaaS, identidade, IaaS, e-mail, SASE e ferramentas de segurança. Sua documentação de ITSM e API mostra que o handoff de ações e relatórios fazem parte do modelo operacional. Seus exemplos de incidentes mostram a sequência pretendida, do sinal à remediação e acompanhamento. Seus sinais de seguro e mercado de revisão sugerem aceitação de mercado para a abordagem de operações gerenciadas.
As evidências públicas não provam várias coisas que os compradores podem considerar mais importantes. Elas não verificam independentemente a precisão da detecção em ambientes de clientes. Não provam taxas de falso positivo, taxas de falso negativo, sucesso de contenção, conclusão de remediação, latência de alerta para ação, consistência do analista, economia de custos específica do cliente ou a qualidade de cada integração. Não mostram com que frequência os clientes falham em executar as ações recomendadas. Não mostram quanto trabalho os clientes devem reter após a assinatura.
Não mostram se todas as superfícies de produto parecem unificadas na operação diária.
Essa distinção não deve ser lida como uma rejeição. A segurança gerenciada é difícil de avaliar a partir de fontes públicas porque o trabalho acontece dentro dos ambientes dos clientes. Um provedor pode publicar documentação, estudos de caso e exemplos, mas a resposta final depende da qualidade dos dados, autoridade, playbooks, capacidade de resposta do cliente e restrições de negócio. Os materiais públicos da Arctic Wolf são fortes o suficiente para justificar uma consideração séria para clientes que buscam operações de segurança gerenciadas. Não são fortes o suficiente para pular a prova local.
O comprador deve realizar uma avaliação estruturada em torno de ações aceitas. Durante a prova de conceito ou integração inicial, escolha vários cenários representativos: atividade suspeita de identidade, sinal de malware em endpoint, má configuração em nuvem, vulnerabilidade de alto risco, relato de phishing, ativo exposto e escalação de incidente. Para cada um, meça se a Arctic Wolf pode reunir evidências, atribuir prioridade, recomendar ação, rotear o ticket, preservar contexto, coordenar com o cliente, verificar a conclusão e relatar o resultado.
A mesma avaliação deve incluir tratamento de falhas. O que acontece quando a telemetria está faltando? O que acontece quando um ticket é contestado? O que acontece quando um patch recomendado falha? O que acontece quando o proprietário do ativo perde o prazo? O que acontece quando a contenção interrompe o trabalho? O que acontece quando a confiança da Arctic Wolf é baixa? O que acontece quando o cliente deseja uma exceção? Esses casos revelam a maturidade do modelo operacional mais do que uma demonstração limpa.
A tese da Arctic Wolf é crível porque se alinha com a fraqueza real em muitos programas de segurança: a lacuna entre saber sobre o risco e fazer a coisa certa rapidamente. A empresa deve ser julgada pela frequência com que fecha essa lacuna, não por quantos sinais pode processar.
O scorecard do comprador deve seguir a ação do sinal à prova
Um scorecard prático para a Arctic Wolf começa com visibilidade. As fontes necessárias estão conectadas? Os sinais de endpoint, identidade, rede, nuvem e SaaS estão mapeados para ativos e proprietários reais? As falhas do coletor são detectadas? Novos ambientes são adicionados ao monitoramento? As credenciais de integração são mantidas? O cliente sabe o que a Arctic Wolf não pode ver?
A próxima medida é a qualidade da triagem. Os casos são compreensíveis? Incluem evidências e ações recomendadas? A confiança e a incerteza estão claras? Os falsos positivos são gerenciáveis? Os eventos relacionados estão linkados? Os problemas recorrentes são reconhecidos? A equipe Concierge conhece o contexto específico do cliente, ou os casos parecem genéricos?
A terceira medida é a autoridade. Quais ações a Arctic Wolf pode realizar diretamente? Quais exigem aprovação? Quais exigem a equipe de TI do cliente? As aprovações de emergência são testadas? As ações irreversíveis são controladas? A reversão é planejada? Os registros pós-ação estão completos?
A quarta medida é o encerramento da remediação. Os tickets chegam ao proprietário certo? O cliente conhece o prazo? A Arctic Wolf acompanha a conclusão? A redução do risco é verificada? As exceções são documentadas? Os prazos perdidos são escalados? Os relatórios mostram o risco aberto honestamente?
A quinta medida é a economia. O ruído de alertas diminuiu? A carga de trabalho do analista mudou? Os incidentes são detectados mais cedo? As exposições de alta prioridade são fechadas mais rapidamente? O serviço reduz a necessidade de contratação interna ou cobertura 24x7? Cria trabalho gerenciável ou expõe um backlog de remediação que o cliente não pode financiar? Os benefícios de seguro, auditoria e relatórios ao conselho são reais o suficiente para contar?
A medida final é o aprendizado. Cada incidente, falso positivo, sinal perdido e exposição em atraso melhora o próximo fluxo de trabalho? A Arctic Wolf ajusta detecções, atualiza playbooks, refina o contexto do cliente e ajusta recomendações de postura? O cliente muda controles, propriedade e processo em resposta? Um relacionamento de segurança gerenciada que não aprende gradualmente se tornará outro canal de alerta.
Sob este scorecard, o valor da Arctic Wolf não é automático nem misterioso. A empresa traz escala, experiência em operações de segurança, uma plataforma ampla, triagem gerenciada, priorização de exposição, resposta a incidentes e orientação voltada para o cliente. O cliente traz acesso ao ambiente, contexto de negócio, autoridade de remediação e disposição para agir. O produto conjunto é a ação aceita.
Essa é a questão de compra correta. Não "a Arctic Wolf tem MDR?" Sim, tem. Não "a Arctic Wolf processa muitos eventos?" Ela diz que sim, e os materiais públicos apoiam uma operação em larga escala. A questão mais importante é se o cliente pode apontar para um sinal de segurança que se tornou uma ação documentada, depois uma correção verificada, depois uma redução mensurável no risco. Se a Arctic Wolf pode tornar essa sequência rotineira, o serviço gerenciado tem valor. Se a sequência quebra no handoff, na autoridade, na remediação ou na prova, o cliente comprou monitoramento sem encerramento operacional suficiente.