
要約
- NFSv2では変更操作の応答が安定記憶への到達を意味した。障害復旧は単純だったが、各WRITEが永続化の待ち時間を負った。
- NFSv3は
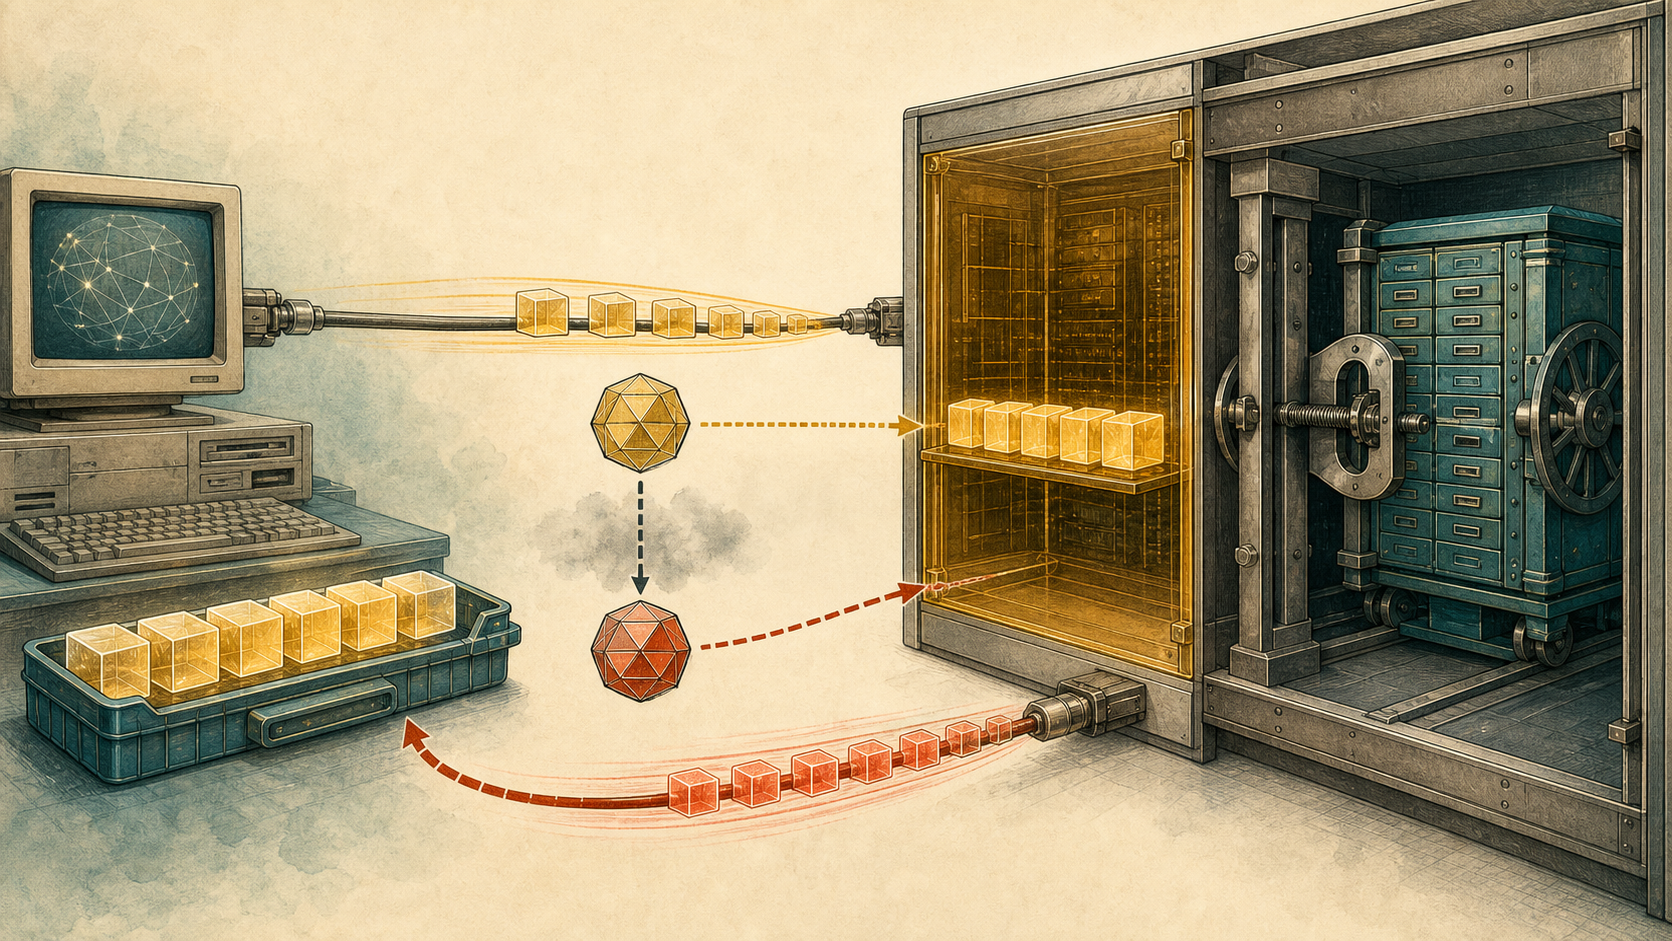
UNSTABLE、DATA_SYNC、FILE_SYNCを分け、応答に実際の書き込み長、到達したcommitment、サーバー世代を示す不透明なverifierを載せた。 - 不安定な応答の後、クライアントはデータを保持する。後の
COMMITでverifierが変われば、旧世代の未commitデータを失ったものとして再送する。
OKの後に残った仕事
遠隔ファイルへ一つの範囲を書き、NFS3_OKを受け取る。外側の状態だけなら完了に見える。しかし同じ結果のcommittedがUNSTABLEなら、RPCの成功と障害後の生存はまだ一致していない。
RFC 1094のNFSv2では、変更操作は同期的だった。WRITEが戻れば、クライアントはデータが安定記憶にあると仮定し、手元のコピーを破棄できた。これはstateless serverの復旧を簡潔にした反面、永続媒体の速度を毎回の応答時間に持ち込んだ。
RFC 1813は、この同期WRITEをthroughputのbottleneckとして扱う。NFSv3の「safe asynchronous writes」は、危険を消したという意味ではない。危険が閉じるまで、誰がデータを持ち、何を比較するかを定義したという意味で安全だった。
要求と実績を分ける三段階
WRITEのstableはUNSTABLE、DATA_SYNC、FILE_SYNCから選ぶ。FILE_SYNCはデータと全メタデータ、DATA_SYNCはデータを再取得するのに必要なメタデータまでを応答前に安定化する。UNSTABLEでは、サーバーは全部、一部、あるいは何も永続化せずに返せる。
応答のcommittedは、要求の写しではなく実績である。サーバーがより強く保存したなら、その強い段階を返せる。さらにcountは実際に書いた長さを示す。short writeなら、成功は要求全体ではなくその範囲だけに及び、残りは別のWRITEが必要になる。
したがって一つの緑色状態では足りない。呼び出しが終わったか、何byte進んだか、その範囲がどこまで永続化したかは別の問いである。
verifierは内容ではなく世代を結んだ
結果のverfはopaque cookieであり、同じサーバーinstanceでは一定、未commitデータを失いうる新しいinstanceでは異なる必要がある。典型はrebootだが、意味の中心は電源操作ではなく、volatileな保管状態の断絶にある。
これはchecksumではない。同じinstanceの異なるファイルや範囲は同じ値を共有しうる。値が同じでも、内容の正しさ、競合書き込みの不在、要求全長の完了は証明しない。後の処理が、以前データを預かった同じサーバー世代に属するかだけを示す。
その間、クライアントはbufferを保持する。RFC 1813が示す状態はdirty、done but needs to be committed、doneの三つである。二番目は、転送は終わったが保管責任は終わっていない状態だ。高速化の費用はクライアントmemoryに現れる。
COMMITの成功にも比較が要る
COMMITは、以前UNSTABLEだった変更を安定記憶へflushする。範囲を指定でき、offset 0、count 0なら先頭から末尾までを対象にする。remote fsyncという比喩は便利だが、applicationの正しさや複製完了まで保証するものではない。
成功結果にもverifierがある。WRITE時と一致すれば、同じinstanceの保管を経たcommitとして扱える。変化していれば、古いverifierでUNSTABLEだった範囲は失われた可能性があるため、クライアントは再送する。
変化は全byteの消失を証明しない。障害前に一部がdiskへ出ていた可能性はある。しかしどれかを安全に判別できない以上、既知のoffsetへ再度書くのが回復規則になる。逆に一致もfile hashではない。status、count、range、他clientとの調整は別に必要だ。
stableにも境界があった
RFC 1813のstable storageは、反復する停電、一定のhardware failure、software crashとrebootに耐えるものとして説明される。同時にstable storage module自体の故障は対象外である。backup、replication、論理整合性、永遠の保存を一語から推論してはならない。
またNFSv3はclient/server間や複数client間のstrict cache consistencyを提供しない。COMMIT済みの範囲でも、applicationが正しいversionを選んだとは限らない。durabilityとconsistencyは別の境界である。
RFC 3530とRFC 7530はNFSv4へこの仕組みを引き継ぎ、RFC 8881はverifierが変化した場合、古いUNSTABLE4データを失ったと仮定して回復するよう明記する。protocol全体がstatefulになっても、このinstance境界は残った。
速さは責任を移した
サーバーは永続化をまとめ、通常時の応答を早められる。その代わりクライアントは未commit byte、範囲、verifierを保持し、世代変更後の再送を担う。仕事は削除されたのではなく、正常経路から回復経路へ移った。
常時FILE_SYNCなら旧来の待ち時間を戻す。常時UNSTABLEなら、障害時に大きな再送queueが現れる。設計の価値は中間状態を名付けたことにある。
client自身がCOMMIT前にcrashする場合もある。server側に回復可能な手順があっても、呼び出し側が最後まで実行するとは限らない。そのためapplicationが「WRITEの成功」をbusiness transactionの完了へ昇格させるなら、どの層がflushを待ち、closeや結果通知の前に何を要求するかを別に決めなければならない。
さらに、serverが要求より強いcommittedを返せる点は運用上重要である。clientは特定のhardwareを推測せず、返された証拠だけでbufferを早く解放できる。能力の高い実装は共通protocolを破らず利益を渡し、弱い実装は未完了を正直に残せる。相互運用性は最小能力への固定ではなく、結果の強さを明示することで成立した。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加