
Zusammenfassung
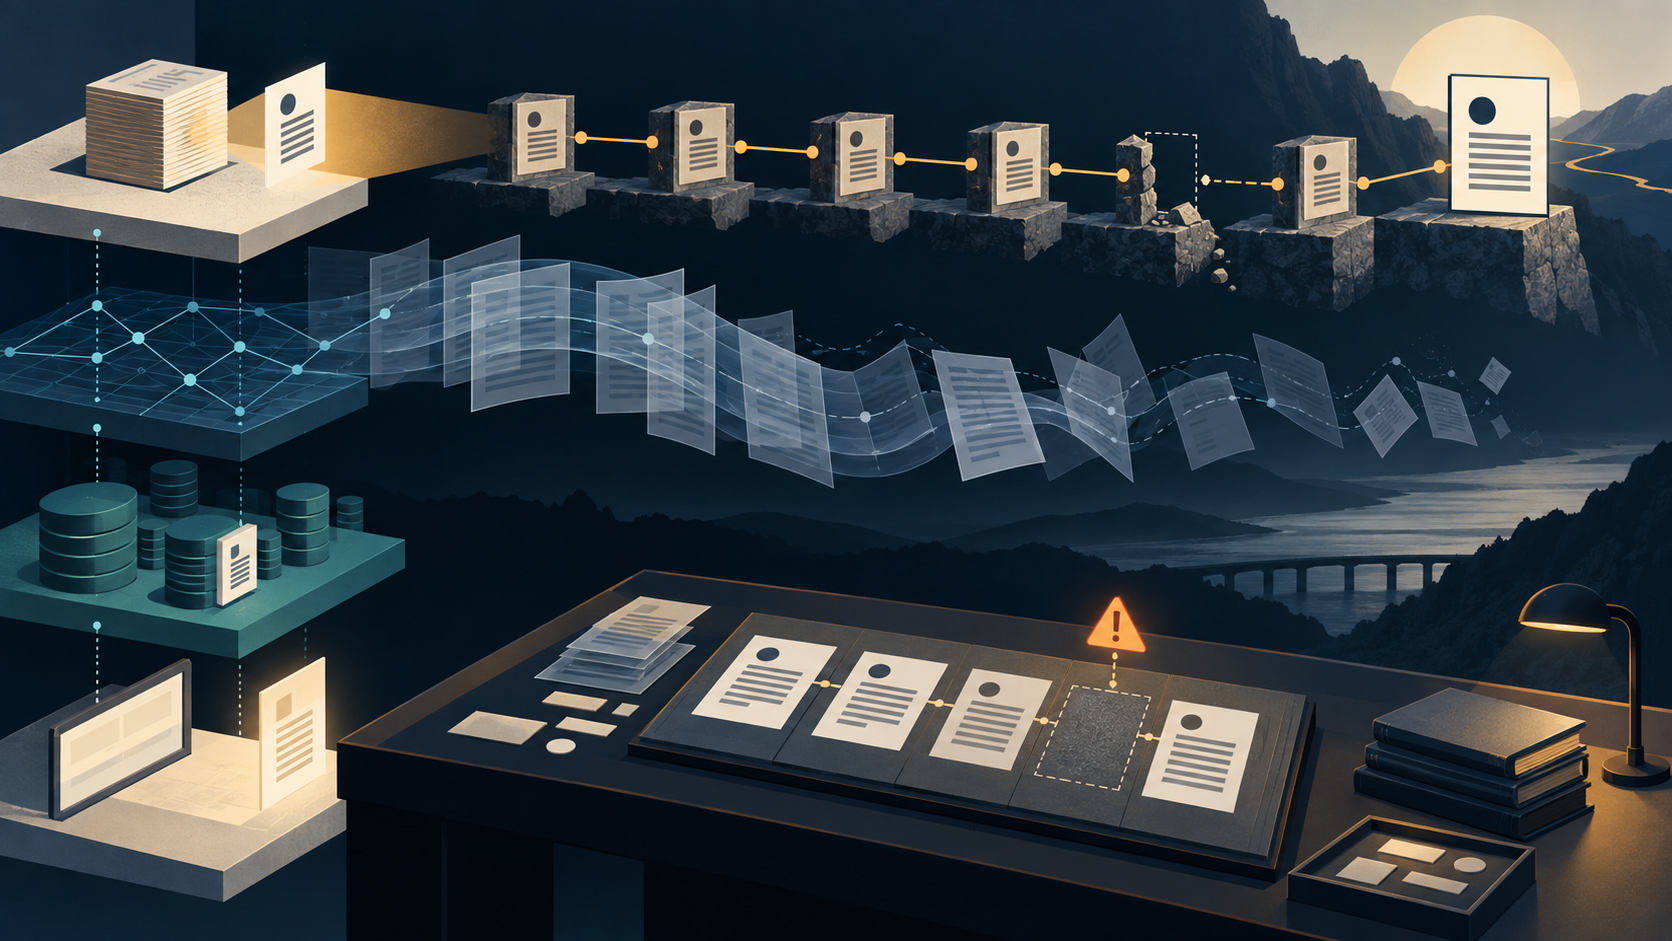
- RFC 5005 bezeichnet Paged Feeds als verlustbehaftet: Während des Blätterns kann sich der Bestand unbemerkt ändern, weshalb die Seiten keine kohärente Momentaufnahme garantieren.
- Archived Feeds schaffen eine rekonstruierbare Struktur. Sie belegen weder vollständigen Abruf noch Abgleich, Aufbewahrung, Warnung oder die tatsächlich gerenderte Leseransicht.
Ein Kontrollsystem sieht einen erfolgreichen Abruf des aktuellen Dokuments, einen funktionierenden prev-archive-Link und eine wachsende lokale Tabelle. Daraus macht es den Zustand „Archiv vollständig“.
Diese Verdichtung ist nicht durch RFC 5005 gedeckt. Der Standard beschreibt drei verschiedene Anordnungen. Ein Complete Feed erklärt ein einzelnes Dokument zur Darstellung aller Einträge des logischen Feeds. Ein Paged Feed verteilt Einträge auf veränderliche Dokumente. Ein Archived Feed verbindet ein Subscription Document für neue oder geänderte Einträge mit älteren Archive Documents. Für Mischformen definiert RFC 5005 keine Semantik.
Beim Paged Feed ist die Grenze ausdrücklich. Während ein Client den Links first, last, previous und next folgt, können Einträge hinzukommen oder sich ändern, ohne dass der Client es bemerkt. Deshalb heißt dieser Feed lossy. Seine Seiten sollen nicht als kohärent oder vollständig dargestellt werden. Eine lückenlose Reihe von HTTP-Erfolgen ist keine Transaktion über den Gesamtbestand.
Das Archiv bietet stärkere Eigenschaften. prev-archive verweist auf das unmittelbar ältere Archiv, next-archive gegebenenfalls auf das jüngere und current auf das aktuelle Dokument. Inhalt und Adresse eines publizierten Archive Documents sollten über die Zeit unverändert bleiben. Das ermöglicht Clients, ein bereits verarbeitetes Archiv nicht ständig neu abzurufen.
Die Formulierung ist jedoch ein SHOULD NOT change, kein kryptografisches Unveränderlichkeitsversprechen. Wird ein altes Dokument korrigiert, können Clients mit gespeicherter Verarbeitung davon nichts erfahren. Eine für alle wichtige Korrektur sollte daher zusätzlich im Subscription Document erscheinen.
Rekonstruktion erfordert einen Ablauf: einen noch nicht verarbeiteten prev-archive dereferenzieren, die enthaltenen Einträge aufnehmen und wiederholen, bis ein bekannter Link, das Ende ohne Vorgänger oder ein Fehler erreicht ist. Publisher müssen nicht jedes Archiv ausliefern. 403, 404 oder 410 können die Kette begrenzen. Auch der Client muss nicht in jedem Fall alles speichern oder rekonstruieren; bei einem unvollständigen Ergebnis soll er den Nutzer informieren.
Damit sind mindestens vier Endzustände zu unterscheiden: ältestes Archiv erreicht, verifizierter Anker erreicht, Abruffehler, oder Abbruch wegen Zeit-, Anfrage- beziehungsweise Speicherlimit. Ein allgemeines success verliert genau die Information, die ein späteres Audit braucht.
Beim Abgleich gilt Ähnliches. Von Duplikaten soll der zuletzt aktualisierte Eintrag zählen. Fehlt der Zeitpunkt oder ist er gleich, muss der Client die Präzedenz bestimmen. RFC 4287 definiert Atom-Identitäten und Zeitangaben, aber keinen externen Sachverhalt. RFC 6721 ergänzte Löschhinweise, weil ein Atom-Client sonst nicht erkennen konnte, dass ein bereits empfangener Eintrag entfernt wurde.
Auch fh:complete bleibt eine Publisher-Aussage. Das Element erklärt die Einträge eines Dokuments zum vollständigen logischen Bestand. Es belegt nicht, dass ein Cache die aktuelle Repräsentation besitzt, alten Zustand entfernt, denselben Sicherheitskontext bewahrt oder einem Menschen die richtige Sicht gezeigt hat.
Ein belastbarer Rekonstruktionsbeleg enthält deshalb:
- Identität, Abrufzeit und Validator des Subscription Documents;
- deklarierten Feed-Typ und beobachteten Linkgraph;
- jeden IRI, Redirect, Status, Authentisierungskontext und Content-Hash;
- Traversierungsfolge, Retries, Ressourcenlimit und Stopgrund;
- Regeln für Duplikate, Zeitgleichheit und Löschhinweise;
- Revision und Stichtag des gespeicherten Zustands sowie den Vollständigkeitsstatus;
- die tatsächlich gezeigte Warnung;
- einen Readback der Leseransicht.
Das ist eine Governance-Empfehlung, keine zusätzliche Norm des RFC. Sie folgt Heng Lus Trennung von Realitätsebenen. Der Standard belegt kein konkretes Produkt, keine vollständige reale Kette, keinen Löschvorgang und keine Nutzerwirkung. Zwei verifizierte Errata korrigieren eine Beispiel-UUID und die Bezeichnung URI zu IRI; die Beweisgrenze bleibt bestehen.
Die Führungsfrage lautet daher nicht, ob der Archivpfad erreichbar ist. Sie lautet, welchen historischen Ausschnitt dieser Beobachter mit welchem Stichtag, Stopgrund und Restzweifel vertreten kann.
Quellen
- RFC 5005 — Feed Paging and Archiving
- Errata zu RFC 5005
- RFC 4287 — The Atom Syndication Format
- RFC 6721 — The Atom deleted-entry Element
- IANA Link Relations Registry
- RFC 9111 — HTTP Caching
- RFC 5005 — kanonischer Text
- RFC-Editor-Datensatz
- IETF-Datatracker-Datensatz
- IETF-Datatracker-Verlauf
- RFC 5023 — The Atom Publishing Protocol
- RFC 7232 — HTTP Conditional Requests
- RFC 8288 — Web Linking
- RFC 8322 — Resource-Oriented Lightweight Information Exchange
- Heng Lu — Running Code Primary
- Heng Lu — Minimum Initial Specification
- Heng Lu — On Reality Layers
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten