
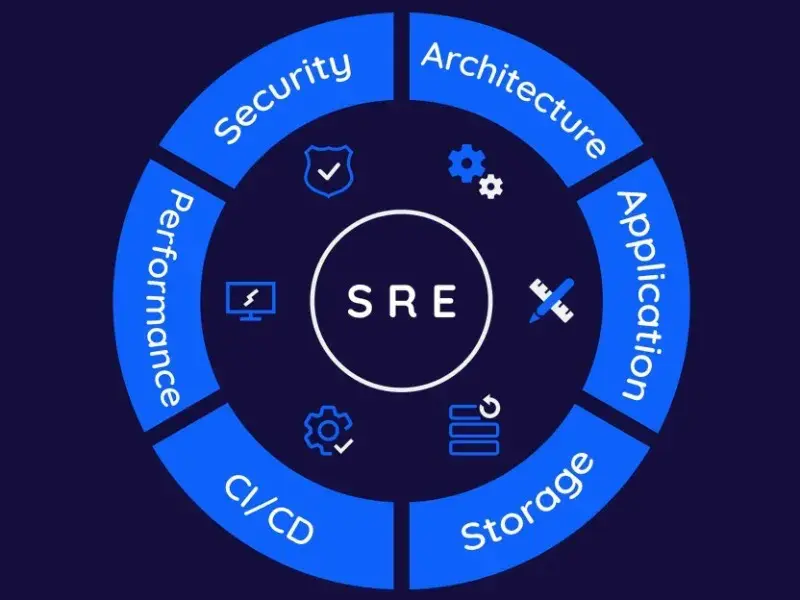
- Bei Google entstanden, konzentriert sich SRE auf die Entwicklung und Wartung hochzuverlässiger und skalierbarer Systeme durch Automatisierung, Überwachung und bewährte Ingenieurpraktiken.
- Site Reliability Engineering (SRE) ist eine entscheidende Disziplin, die Softwareentwicklung mit Betriebsmanagement verbindet, um die Zuverlässigkeit, Skalierbarkeit und Leistung von IT-Systemen sicherzustellen.
Site Reliability Engineering (SRE)ist eine Disziplin, die Prinzipien der Softwareentwicklung auf das Betriebs- und Infrastrukturmanagement anwendet, um die Zuverlässigkeit, Skalierbarkeit und Effizienz von IT-Systemen sicherzustellen. Bei Google entstanden, konzentriert sich SRE auf die Entwicklung und Wartung hochzuverlässiger und skalierbarer Systeme durch Automatisierung, Überwachung und bewährte Ingenieurpraktiken.
Was ist SRE?
SRE ist im Wesentlichen eine Reihe von Praktiken und Prinzipien, die darauf abzielen, die Zuverlässigkeit und Leistung von Systemen zu verbessern. Sie kombiniert Aspekte der Softwareentwicklung und des Systembetriebs, um einen proaktiven Ansatz für das Management und die Optimierung der IT-Infrastruktur zu schaffen. Ziel ist es, widerstandsfähige, skalierbare Systeme zu bauen und zu warten, die konstante Leistung erbringen. SRE konzentriert sich auf die Verbesserung der Zuverlässigkeit und Leistung von Systemen durch Schlüsselpraktiken.
Durch die Definition klarer Service-Level-Ziele (SLO), das Management von Fehlerbudgets, die Implementierung eines strukturierten Incident-Managements, die Kapazitätsplanung und Skalierung sowie die Automatisierung von Aufgaben stellt SRE sicher, dass Systeme reibungslos und effizient arbeiten und die Erwartungen der Benutzer sowie die Geschäftsziele erfüllen.
Lesen Sie auch:Erkunden Sie das Internet-Governance Forum (IGF): Was ist es und warum ist es wichtig?
Service-Level-Ziele (SLO)
SRE betont die Definition und Messung der Servicezuverlässigkeit durch Service-Level-Ziele (SLO), das sind spezifische, quantifizierbare Ziele für die Leistung und Zuverlässigkeit des Systems. Beispielsweise könnte ein Streaming-Dienst wie Netflix ein SLO für sein Content-Delivery-Netzwerk definieren, das eine Verfügbarkeit von 99,9 % pro Monat anstrebt. Das bedeutet, dass der Dienst während dieses Zeitraums mindestens 99,9 % der Zeit betriebsbereit und für Benutzer zugänglich sein muss.
SLOs bieten klare Ziele für Zuverlässigkeit und Leistung, helfen Teams, sich auf die Erfüllung der Benutzererwartungen zu konzentrieren und eine konstante Servicequalität sicherzustellen.
Fehlerbudgets
Fehlerbudgets sind ein Schlüsselkonzept in SRE und stellen die zulässige Menge an Ausfallzeit oder Fehlern in einem bestimmten Zeitraum dar. Sie gleichen das Bedürfnis nach Zuverlässigkeit mit der Fähigkeit aus, Innovationen zu entwickeln und neue Funktionen bereitzustellen. Beispielsweise hat ein Cloud-Dienstanbieter wie AWS ein Verfügbarkeits-SLO von 99,95 %, steht ihm ein kleines Fehlerbudget zur Verfügung, das eine bestimmte Menge an Ausfallzeit oder Fehlern berücksichtigt. Dieses Budget hilft zu bestimmen, inwieweit neue Funktionen oder Betriebsänderungen verfolgt werden können, ohne die Zuverlässigkeit zu beeinträchtigen.
Fehlerbudgets ermöglichen es Teams, den Kompromiss zwischen Zuverlässigkeit und Innovation zu managen und sicherzustellen, dass neue Entwicklungen die Servicequalität nicht über akzeptable Grenzen hinaus negativ beeinflussen.
Incident-Management
SRE-Praktiken umfassen einen strukturierten Ansatz für das Incident-Management, der sich auf schnelle Reaktion und Lösung konzentriert, um die Auswirkungen von Serviceunterbrechungen zu minimieren. Bei einem größeren Ausfall würde eine globale E-Commerce-Plattform wie Alibaba SRE-Prinzipien anwenden, um das Problem schnell zu identifizieren, das Interventionsteam zu mobilisieren und eine Korrektur zu implementieren. Post-Incident-Reviews und Retrospektiven helfen, zukünftige Vorfälle zu verhindern und die Reaktionsstrategien zu verbessern.
Effektives Incident-Management reduziert Ausfallzeiten, verbessert die Systemzuverlässigkeit und erhöht die allgemeine Benutzerzufriedenheit, indem es eine schnelle Behebung von Störungen gewährleistet.
Lesen Sie auch:Was ist IT-Asset-Management?
Kapazitätsplanung und Skalierung
SRE beinhaltet proaktive Kapazitätsplanung und Skalierung, um variable Arbeitslasten zu bewältigen und sicherzustellen, dass die Systemleistung bei sich ändernder Nachfrage optimal bleibt. Beispielsweise nutzt eine Finanzhandelsplattform wie Nasdaq SRE-Praktiken, um Handelsvolumina vorherzusagen, Spitzenzeiten zu planen und die Infrastruktur entsprechend anzupassen. Dieser Ansatz stellt sicher, dass das System hohe Handelsvolumina ohne Leistungseinbußen bewältigen kann.
Angemessene Kapazitätsplanung und Skalierung gewährleisten, dass Systeme effektiv auf Benutzeranfragen reagieren können, Leistungsengpässe vermeiden und ein hohes Serviceniveau aufrechterhalten.
Automatisierung und Effizienz
SRE betont die Automatisierung wiederkehrender Aufgaben und Prozesse, um die betriebliche Effizienz zu verbessern und das Risiko menschlicher Fehler zu reduzieren. In einem großen Rechenzentrum kann eine Organisation Automatisierungstools einsetzen, um Serverbereitstellung, Überwachung und Updates zu verwalten. Dies reduziert manuelle Eingriffe und gewährleistet konsistente und zuverlässige Systemabläufe. Automatisierung verbessert die Effizienz, reduziert Betriebskosten und minimiert das Potenzial für Fehler, was zu zuverlässigeren und skalierbareren Systemen führt.
Praktische Anwendungen von SRE
Als Initiator von SRE nutzt Googlediese Praktiken intensiv, um seine umfangreiche Infrastruktur zu verwalten und eine hohe Zuverlässigkeit und Leistung für seine Dienste wie Google Search und YouTube sicherzustellen.
Netflix nutzt SRE-Prinzipien, um die Zuverlässigkeit seines Streaming-Dienstes aufrechtzuerhalten, enorme Datenmengen und Benutzerverkehr zu verwalten und gleichzeitig ein reibungsloses Seherlebnis zu bieten.
AWS wendet SRE an, um seine Cloud-Dienste zu verwalten, mit Fokus auf Verfügbarkeit, Leistung und Skalierbarkeit, um eine breite Palette von Kundenanwendungen zu unterstützen.
Slacknutzt SRE-Praktiken, um die Zuverlässigkeit und Leistung seiner Messaging-Plattform sicherzustellen, die Systemkapazität zu verwalten und Vorfälle effektiv zu behandeln, um ein reibungsloses Benutzererlebnis zu bieten.
Site Reliability Engineering (SRE) ist eine entscheidende Disziplin, die Softwareentwicklung mit Betriebsmanagement verbindet, um die Zuverlässigkeit, Skalierbarkeit und Leistung von IT-Systemen sicherzustellen. Durch die Fokussierung auf Service-Level-Ziele, Fehlerbudgets, Incident-Management, Kapazitätsplanung und Automatisierung bietet SRE einen Rahmen für den Bau und die Wartung robuster Systeme, die die Erwartungen der Benutzer erfüllen und Geschäftsziele unterstützen.
Während Organisationen weiter wachsen und sich weiterentwickeln, bieten SRE-Praktiken wesentliche Werkzeuge und Strategien zur Verwaltung komplexer Infrastrukturen und zur Bereitstellung zuverlässiger, hochwertiger Dienste.