
Zusammenfassung
- Entwurf 08 unterscheidet einen amortisierten VOPRF-Batch mit einem gemeinsamen Beweis von einem generischen Batch mit optionalen Antworten je Position.
- Frische Nonces halten die Token-Eingaben auseinander; HTTP 200, 206 oder ein gültiger Beweis zählen dennoch nicht die tatsächlich finalisierten und dauerhaft gespeicherten Token.
- Der Betreiber braucht einen abgestuften Beleg, der Bestände erklärt, ohne Emission und spätere Einlösung dauerhaft verknüpfbar zu machen.
Ein Performance-Test meldet einen deutlichen Gewinn. Sechzig Token werden in einem Austausch angefordert, der Beweis wird nur einmal über die Listen erzeugt, die Antwort ist erfolgreich. Danach übernimmt eine Zahl im Dashboard die Rolle der Wahrheit.
Gerade dort beginnt das Problem. Der Beweis kann mathematisch richtig sein, während der Client eine Ausgabe vertauscht, eine Finalisierung verwirft oder vor dem Datenbank-Commit abstürzt. Der Server hat gearbeitet; der nutzbare Bestand ist trotzdem kleiner.
draft-ietf-privacypass-batched-tokens-08 ist ein aktiver WG-Entwurf vom 4. Mai 2026. Er wurde dem IESG zur Veröffentlichung als Proposed Standard vorgelegt, steht zum Stichtag aber auf AD Evaluation::Revised I-D Needed. Er ist kein RFC. Auch 0x0005, der vorgeschlagene VOPRF-Typ mit ristretto255 und SHA-512, ist im aktuellen IANA-Register noch nicht aktiv eingetragen.
Zwei Batch-Modelle verteilen Fehler unterschiedlich
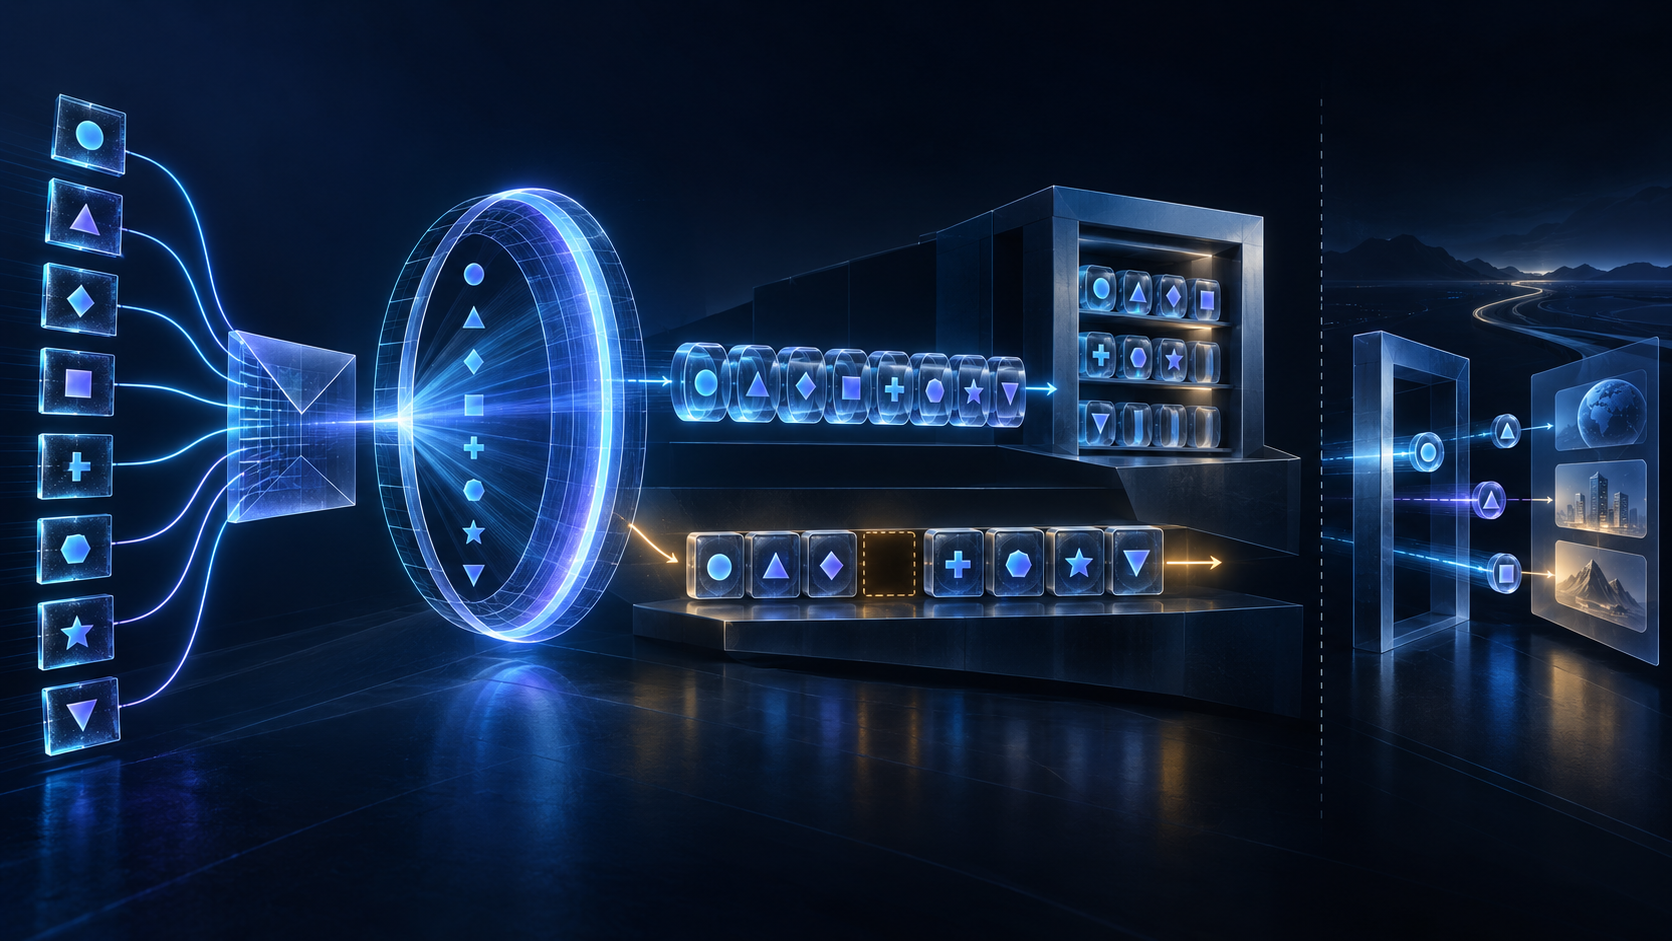
Im amortisierten Modell sendet der Client mehrere blinded elements derselben unterstützten privaten Token-Art. Der Issuer wertet jedes Element aus und erzeugt einen Beweis über Eingabe- und Ausgabeliste. Der Client prüft diesen gemeinsamen Beweis, bevor er einzelne Authenticator-Werte bildet.
Im generischen Modell ist der Batch ein Behälter gewöhnlicher TokenRequests. Verschiedene registrierte Typen dürfen zusammen vorkommen. Für jede Position gibt es eine optionale Antwort. Fehlt sie, hat der Issuer diese Anforderung abgelehnt oder konnte sie nicht bedienen; spätere Positionen werden weiterverarbeitet.
Teilweise Ausstellung muss mit 206 signalisiert werden, keine Ausstellung mit 400. Der Client überspringt leere Positionen und finalisiert die übrigen mit den jeweiligen Requests.
Ein gemeinsames Feld batch_success=true kann diese beiden Modelle nicht korrekt abbilden. Beim amortisierten Verfahren ist der Beweis ein gemeinsamer Gatekeeper. Beim generischen Verfahren ist Unvollständigkeit selbst Bestandteil des Ergebnisses.
Frische Nonces lösen keine Speichertransaktion
Für jedes amortisierte Token zieht der Client einen frischen 32-Byte-Nonce. Zusammen mit Token-Typ, Challenge-Digest und Issuer-Key-ID bildet er die individuelle Eingabe. Das Bündeln hebt die Individualität der Token nicht auf.
Der Client muss aber die Reihenfolge bewahren. Das ite evaluated element gehört zum iten Nonce und zum passenden Abschnitt des Authenticator-Outputs. Vertauschung oder Kürzung kann diesen Zusammenhang zerstören, obwohl die Oberfläche nur einen erfolgreichen Beweis zeigt.
Nach der Finalisierung beginnt die Verantwortung des Bestandsdienstes. Ein Prozess kann vor dem Commit ausfallen, eine Teilmenge schreiben oder bei einer Wiederholung doppelte Einträge anlegen. Ein Backup kann bereits verbrauchte Token wieder sichtbar machen. Der Fresh-Nonce-Satz des Protokolls beweist keine lokale Einzigartigkeit.
Positionsdaten sollten nur so lange erhalten bleiben, wie sie für Zuordnung und Commit nötig sind. Ein dauerhafter Batch-Identifier in späteren Redemption-Logs würde sonst die Blindheit auf einer anderen Schicht aushebeln.
Der Beweis wird amortisiert, die Arbeit bleibt linear
Der Entwurf beschreibt BlindEvaluateBatch als linear in Nr. Für jedes Element bleibt eine Auswertung. Der praktische Vorteil entsteht, weil die Beweisgenerierung über alle Elemente geteilt wird; bei größeren Batches kann der Aufwand ungefähr die Hälfte von Nr einzelnen Ausstellungen erreichen.
Das ist kein konstanter Aufwand. Parsing, Evaluierung, Admission, Netz, Client-State, Finalisierung und Speicherung wachsen weiter. Auch der generische Typ trägt ausdrücklich lineare Kosten.
Mit dem Vorteil wächst der gemeinsame Ausfallbereich. Ein nicht unterstützter Typ, eine unbekannte gekürzte Key-ID, ein zu großer Batch oder ein einziges nicht deserialisierbares Element führt beim amortisierten Request zu 422. Scheitert beim Client die Deserialisierung oder Beweisprüfung, wird abgebrochen.
Die Obergrenze muss deshalb die Kosten eines korrelierten Verlusts berücksichtigen. Größer ist nicht automatisch besser, selbst wenn der Durchschnittsdurchsatz steigt.
206 verlangt Positionsarbeit
HTTP 206 ist hier keine gewöhnliche Transportkuriosität. Es bedeutet: Einige angeforderte Token wurden ausgestellt, andere nicht. Die Antwort enthält nutzbare Information.
Ein Client darf sie weder wegen fehlender 200 verwerfen noch alle angeforderten Elemente als Erfolg buchen. Er muss den optionalen Vektor lesen, Lücken erkennen, vorhandene Antworten nach dem jeweiligen Token-Verfahren finalisieren und nur bestätigte Datensätze gutschreiben.
Der Entwurf nennt gemischte truncated_token_key_id für denselben Typ als mögliches Beispiel. Bei einem Key-Rollover kann 206 also ein Konfigurationssignal sein. Eine pauschale Wiederholung verwischt es.
Die Bilanz braucht getrennte Begriffe:
angefordert ≠ vorhanden ≠ finalisiert ≠ committed ≠ verfügbar ≠ eingelöst.
Das Wort „issued“ reicht nicht. Es muss kenntlich machen, ob der Issuer Bytes erzeugt, der Client finalisiert oder der Store einen Bestand bestätigt hat.
Retry ist eine Governance-Regel
Nach 206 kann der Client nur die Lücken wiederholen, sofern er die Zuordnung sicher bewahrt. Eine Wiederholung des gesamten Batches kann zusätzliche gültige Token erzeugen und Quote verbrauchen. Nach einem Netzabbruch ist unbekannt, ob der Issuer bereits gearbeitet hat.
Ein lokaler Ausfall nach der Finalisierung verlangt zuerst eine Speicherrekonstruktion. Eine neue Ausstellung ist kein deterministischer Ersatz für eine verlorene Transaktion.
Definieren Sie daher Retry-Zustände, Einheit, Verantwortlichen und Quote-Auswirkung. Ein temporärer Positionsbeleg kann Request-Digest, Typ, Key-Epoche, Antwortpräsenz, Finalisierung und Commit enthalten. Er darf nicht unbefristet mit dem Bearer-Token und späterer Einlösung verknüpft bleiben.
Timeout ist Beobachtungsverlust, kein Beweis der Nichtausführung.
Batch-Limits sind Verteilungspolitik
Der Issuer bestimmt, wie viele Token ein amortisierter Batch enthalten darf. Im generischen Verfahren kann er Anforderungen oberhalb einer Grenze ignorieren. Die Security Considerations empfehlen Limits pro Client und Key.
Ein hohes Limit unterstützt Prefetch und Offline-Betrieb, konzentriert aber Bearer-Wert und Leckagerisiko. Ein niedriges Limit hält den Issuer näher an jeder Nutzung und steigert die Online-Abhängigkeit. Während eines Key-Wechsels können Grenzen und gemischte IDs zu Teilantworten führen.
Das Limit braucht daher Version, Owner, Monitoring und Ausnahmeweg. Die IETF-Spezifikation koordiniert Wire-Format und Semantik; sie legitimiert keine universale Quote. Lokale Abuse- oder Geschäftsentscheidungen sollten als solche sichtbar bleiben.
Registriernummer, Implementierung und Betrieb sind getrennte Nachweise
Revision 08 schlägt 0x0005 und vier neue Media Types vor. Das eingefrorene IANA-Register enthält den Wert nicht. Die Security AD bat am 20. September um Referenzkorrekturen, Klarheit zur Zuteilung und ein frühes HTTPDIR-Review.
Die Nachricht bezeichnet die Punkte als voraussichtlich leicht lösbar. Sie ist weder Ablehnung noch Sicherheitsbefund. Sie zeigt aber, dass der Text noch nicht abgeschlossen ist.
Eine spätere IANA-Zuteilung belegt Koordination, nicht Implementierung. Ein Implementierungsbericht belegt keine Interoperabilität. Interoperabilität belegt keinen korrekten lokalen Bestand. Der Shepherd berichtet starke Zustimmung in einer kleinen WG und gemeldete Implementierungen, aber keine vollständige Matrix.
Ein Audit kann selbst zum Korrelator werden
RFC 9576 trennt Attestation-, Issuance- und Redemption-Kontexte. Privatsphäre hängt davon ab, welche Beobachtungen verbunden werden können. Batch-Größe, Zeitpunkt, Issuer und Key-Epoche sind zusätzliche Metadaten.
Ein permanenter Batch-ID, der in lokalen Token-Einträgen und späteren Origin-Logs erscheint, schafft eine unerwünschte Brücke. Auditierbarkeit verlangt nicht, jede spätere Aktion im Voraus verknüpfbar zu machen.
Nutzen Sie Aggregatwerte und Einweg-Digests, kurze Aufbewahrung für Positionskarten und getrennte Berechtigungen. Interne Batch-IDs gehören nicht in Origin-Requests. Eine begrenzte Incident-Verknüpfung benötigt Zweck, Genehmigung und Ablauf.
Der fehlende Beleg hat drei Ebenen
Auf Batch-Ebene stehen Variante, Endpoint, Typen, Challenge-/Konfigurationsdigest, Key-Epoche, Request-Anzahl, HTTP-Status, Vektorlänge, Proof-/Response-Digest, Limit und Zeit.
Auf Positionsebene stehen vorübergehend Request-Digest, Antwort ja/nein, Deserialisierung, Finalisierung und Commit. Die Reihenfolge bleibt nur so lange wie nötig.
Auf Bestandsebene stehen Anfang, bestätigte Zugänge, Quarantäne, Löschung, Auswahl, bestätigte Einlösung, unklare Ergebnisse und Ende in transaktionaler Form.
Redemption benötigt einen separaten Beleg für Challenge-Kompatibilität, Präsentation, Replay-State, Origin-Autorisierung und Anwendungseffekt. Der Ausstellungsbeleg darf diese Entscheidung nicht vorwegnehmen.
Die Kette lautet:
konfigurieren -> attestieren -> anfordern -> zulassen -> antworten -> finalisieren -> committen -> auswählen -> einlösen -> autorisieren -> beobachten.
Batching spart Aufwand. Es hebt keine Verantwortungsgrenze auf.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten