
Кратко
- Во время поэтапного выпуска программного обеспечения Cloudflare ошибка привела к тому, что некоторые эксплуатировавшиеся в партнёрстве экземпляры F-Root не включали обязательные glue-записи. Результатом стали спорадические сбои разрешения зоны .net, хотя другие части распределённой системы продолжали отвечать.
- ISC зафиксировал получение внешнего сигнала в 17:33 UTC, подтверждение сообщения в 17:41, проверку и эскалацию в 17:46 и полное восстановление в 20:51. Документированный интервал от осведомлённости ISC до восстановления составил 3 часа 18 минут.
- Cloudflare контролировала дефектный выпуск и программное исправление, тогда как ISC проверил сообщение, эскалировал инцидент и запросил вывод затронутых префиксов. Восстановление сочетало коррекцию кода, отзыв маршрутов через BGP и последующее объявление префиксов.
- После инцидента стороны договорились регулярно испытывать функцию вывода BGP-маршрутов. Рассмотренный публичный источник подтверждает это обязательство, но не устанавливает последующие даты, частоту, критерии успеха или независимую проверку испытаний. Отсутствие публичного подтверждения не доказывает, что испытаний не было.
Механизм отказа: ответы без обязательных glue-записей
Корневая система DNS направляет рекурсивный резолвер к следующей части иерархии имён. Для корректного делегирования ответ должен содержать сведения, позволяющие продолжить разрешение. Если имя авторитетного сервера находится внутри делегируемой зоны, резолверу может понадобиться адресная glue-запись: без неё возникает логический тупик, при котором для получения адреса сервера сначала пришлось бы обратиться к самому этому серверу.
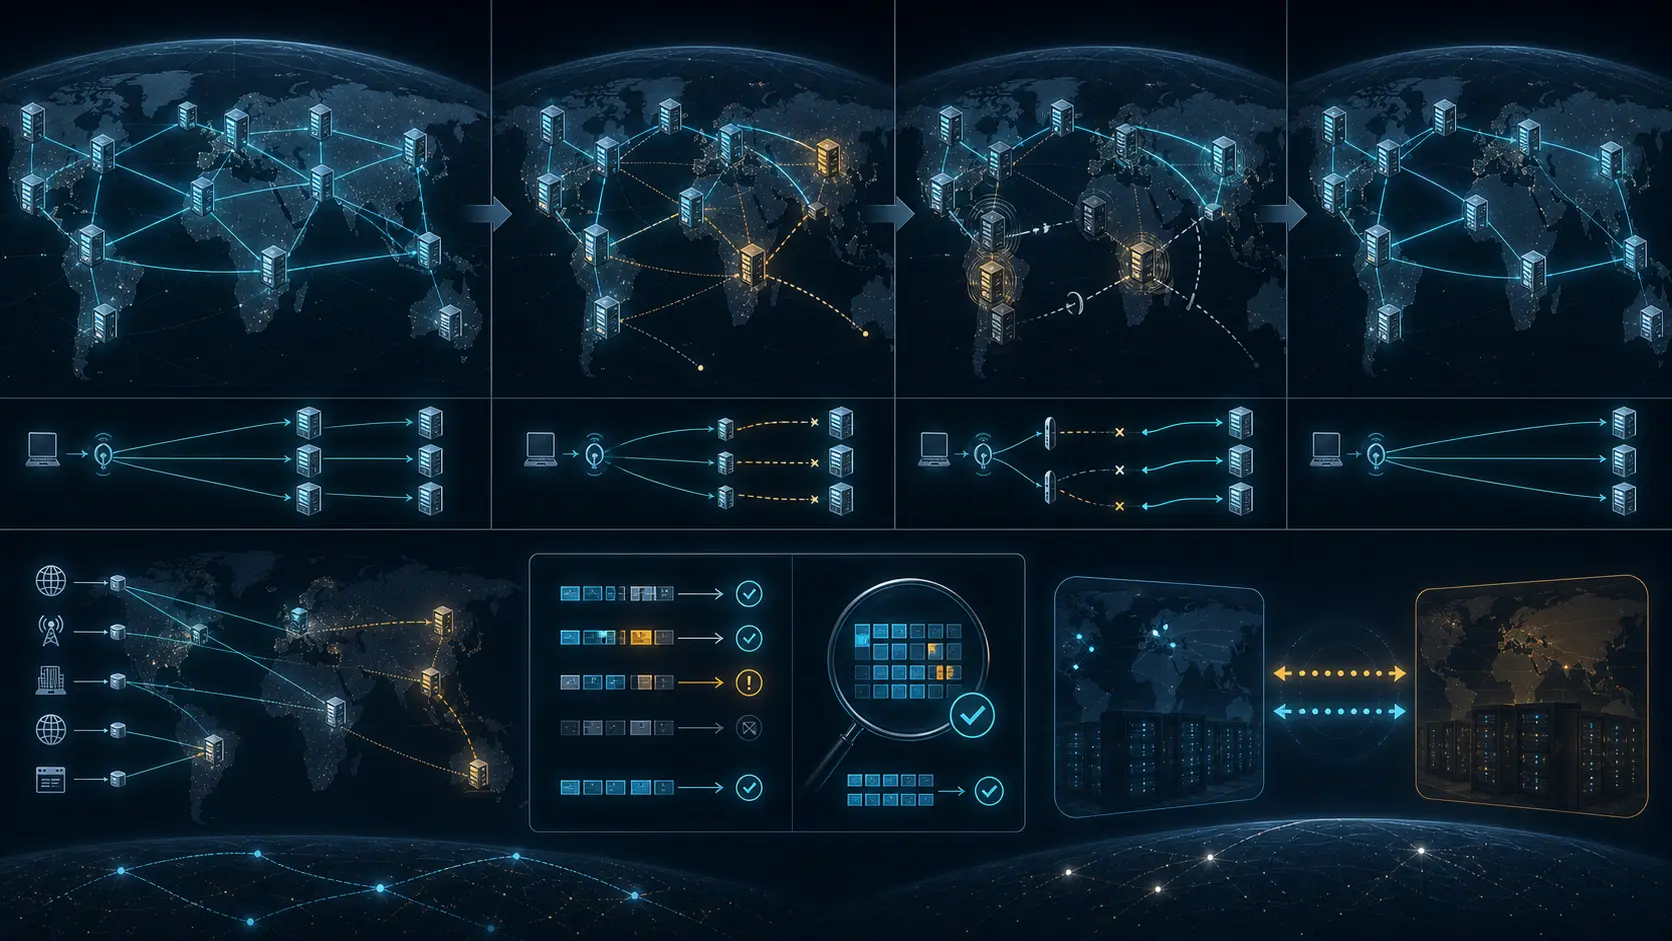
Согласно послеинцидентному материалу Internet Systems Consortium, ошибка, внесённая во время поэтапного выпуска программного обеспечения Cloudflare, привела к тому, что некоторые работавшие в рамках партнёрства экземпляры F-Root выдавали ответы без обязательных glue-записей. Это вызвало спорадические сбои разрешения зоны .net.
Слово «спорадические» здесь важно. Инцидент не обязательно выглядел как единый глобальный обрыв, одинаково заметный каждому пользователю. Anycast направляет запросы к разным экземплярам сервиса в зависимости от сетевой топологии и доступных маршрутов. Если дефект присутствует только на части узлов, один резолвер может получить корректный ответ, а другой — неполный. Повторная попытка может пройти по иному пути или воспользоваться кэшированными данными. Система поэтому способна выглядеть в целом доступной и одновременно создавать реальные ошибки для некоторой доли запросов.
Публичный источник не приводит надёжного общего числа затронутых пользователей, резолверов или запросов. Масштаб нельзя выражать неподтверждённой цифрой. Нельзя также считать документированный период реагирования точной продолжительностью воздействия на каждого пользователя. Но отсутствие агрегированной оценки не делает механизм незначительным: ошибка в ответе корневой инфраструктуры способна прервать дальнейшую цепочку разрешения имён, а выборочный характер отказа усложняет установление общей причины.
Инцидент выявил принципиальное различие между доступностью и корректностью. Узел может принимать пакеты, отвечать с обычной задержкой и проходить поверхностную проверку работоспособности, но при этом формировать функционально неполный ответ. Мониторинг только времени отклика, потерь пакетов, состояния процесса или доступности порта не гарантирует обнаружения такого дефекта.
Для DNS нужна семантическая проверка: содержит ли ответ ожидаемые секции и записи, соответствует ли он требованиям протокола и позволяет ли резолверу завершить следующий шаг. В anycast-системе эти проверки должны выполняться из нескольких сетей и регионов, поскольку один измерительный пункт может постоянно попадать на исправный экземпляр и не видеть ошибку другого пути.
Распределённость F-Root не была бесполезной. Она ограничивала зависимость от одной машины, площадки или линии связи и не позволила частичному дефекту автоматически превратиться в единый тотальный отказ. Но количество узлов само по себе не защищает от общей ошибки выпуска, попавшей на несколько экземпляров. Избыточность создаёт альтернативы; проверяемая устойчивость требует дополнительно уметь обнаружить неверное поведение, изолировать его и безопасно вернуть исправленные узлы в работу.
Кто контролировал выпуск, обнаружение и вывод маршрутов
Ключевой вопрос этого случая — не только какой компонент сформировал неправильный ответ, но и кто практически контролировал каждую стадию предотвращения и восстановления.
По опубликованному описанию Cloudflare контролировала поэтапный выпуск, затронутую программную реализацию на партнёрских экземплярах и исправление программного дефекта. ISC получил сообщение крупного сетевого оператора, проверил наблюдаемое поведение, передал информацию Cloudflare и запросил вывод затронутых префиксов. Такая последовательность изложена в официальном разборе оператора F-Root.
Это распределение ролей не является доказательством намерения, небрежности или единоличной ответственности какой-либо стороны. Рассмотренный источник не позволяет делать такие более широкие выводы. Он подтверждает более узкий и операционно важный факт: контроль был разделён. Организация, получившая и проверившая первый документированный внешний сигнал, не контролировала дефектный выпуск и его программное исправление. Организация, управлявшая кодом, не была источником первого зафиксированного сигнала в опубликованной хронологии. Ограничение воздействия дополнительно требовало действий на уровне маршрутизации.
Эта граница между организациями является частью технической модели риска. Если одна сторона видит симптом, другая может изменить код, а вывод неисправных экземпляров зависит от согласованной маршрутизирующей процедуры, время восстановления определяется не только сложностью дефекта. Оно зависит от качества контактных путей, скорости подтверждения, ясности полномочий, доступности дежурных специалистов и готовности выполнить аварийное действие.
Формальная ответственность и реальная способность изменить состояние системы не всегда совпадают. Организация может отвечать за общий сервис, но не иметь непосредственного доступа к конкретному выпуску партнёра. Другая сторона может контролировать программное обеспечение, но не получать внешние сообщения по тому же каналу. Третьим элементом становится способность убрать затронутый маршрут из глобальной таблицы. Поэтому анализ устойчивости должен следовать не только организационной схеме, но и практической цепочке управления.
Для этого случая цепочка выглядит так: внешний наблюдатель распознаёт ошибочное поведение; ISC получает и проверяет сообщение; инцидент эскалируется Cloudflare; программный дефект исследуется и исправляется; затронутые префиксы выводятся, чтобы исключить проблемные экземпляры из обслуживания; после проверки маршруты объявляются снова. Сбой или задержка на любой передаче способен продлить период неопределённости.
Разделённый контроль не означает, что партнёрская эксплуатация неизбежно слабее полностью внутренней. Партнёрство может давать масштаб, географическое покрытие, специализированные знания и резервирование. Но его устойчивость должна оцениваться вместе с переходами между сторонами. Наличие компетентных команд по обе стороны не заменяет проверку того, что они способны своевременно пройти общую процедуру.
Документированная последовательность: 3 часа 18 минут
ISC зафиксировал четыре опорные отметки:
- 17:33 UTC — ISC узнал о проблеме от крупного сетевого оператора.
- 17:41 UTC — ISC подтвердил получение сообщения.
- 17:46 UTC — ISC проверил поведение и эскалировал инцидент Cloudflare.
- 20:51 UTC — было зафиксировано полное восстановление сервиса.
Эти времена приведены в опубликованной хронологии ISC. От первой документированной осведомлённости ISC в 17:33 до полного восстановления в 20:51 прошло 3 часа 18 минут.
Этот интервал необходимо описывать точно. Он не доказывает, что первый ошибочный ответ появился именно в 17:33. Это время, когда ISC, согласно опубликованной записи, узнал о проблеме. Источник также не даёт полной измерительной серии, показывающей частоту неудачных разрешений на каждом этапе. Поэтому 3 часа 18 минут — документированный интервал от осведомлённости ISC до восстановления, а не точная длительность всего пользовательского воздействия или совокупная мера ущерба.
Первые шаги были сравнительно быстрыми. От осведомлённости до подтверждения прошло восемь минут, ещё пять минут — до проверки и эскалации. Большая часть интервала пришлась на последующую фазу. Из этого нельзя без дополнительных доказательств заключать, что конкретная сторона действовала неоправданно медленно. Хронология показывает другое: подтверждение симптома и полное восстановление корректного обслуживания являются разными задачами.
После эскалации требовалось локализовать дефектный выпуск, подготовить программную коррекцию, вывести затронутые маршруты, проверить состояние экземпляров и затем безопасно объявить префиксы снова. Восстановление сочетало два инструмента. Исправление кода устраняло источник неверных ответов. Вывод BGP-префиксов изолировал затронутые экземпляры на уровне маршрутизации. Последующее объявление возвращало исправленные узлы в доступный путь.
ISC описывает соединение программного исправления, вывода префиксов и их последующего объявления. Такая комбинация подчёркивает, что маршрутизирующая мера была самостоятельным аварийным средством контроля. Она могла ограничить воздействие проблемных экземпляров, пока программная причина устранялась и проверялась.
При этом вывод маршрута не является полной заменой программного исправления. Он может убрать дефектный узел из обслуживания, но не исправляет саму реализацию. И наоборот, наличие исправленного кода ещё не доказывает, что восстановленный экземпляр безопасно возвращён в сеть. Завершённая процедура должна подтвердить и устранение причины, и корректность возврата.
Почему резервирование не устранило координационный риск
Anycast и географическая распределённость создают реальную устойчивость к отказу отдельных площадок, соединений и машин. Несколько экземпляров могут обслуживать общий адрес, а маршрутизация направляет пользователей к доступным путям. Однако такая архитектура не гарантирует, что все доступные экземпляры выдают одинаково правильный ответ.
При частичном дефекте распределённость создаёт неоднородную картину. Один регион или оператор может направляться к исправной группе узлов, другой — к затронутой. Общий индикатор доступности способен оставаться зелёным, хотя функциональная корректность нарушена для части путей. Это объясняет, почему внешний сигнал от крупного сетевого оператора имел значение: пользовательская или операторская видимость может охватывать путь, которого не видит внутренняя проверка из другой сети.
Опубликованная последовательность не доказывает отсутствия внутреннего мониторинга. Она устанавливает только то, что первым документированным сигналом в этой хронологии было внешнее сообщение. Корректный вопрос поэтому состоит не в том, «почему мониторинга не было», а в том, какие проверки могли бы надёжно обнаружить отсутствие обязательных glue-записей на части anycast-экземпляров и как быстро они должны были сработать.
Здесь проявляются три разные контрольные поверхности.
Контроль выпуска. Поэтапное развёртывание может ограничить охват дефекта, но только если ранняя когорта проверяется по правильным свойствам. Измерение загрузки, задержки и доступности процесса недостаточно, когда ошибка относится к содержанию DNS-ответа. Нужны репрезентативные запросы и автоматическое сравнение ожидаемой семантики до расширения выпуска.
Контроль обнаружения. Проверки должны выполняться из разных автономных систем, сетей и регионов и связывать наблюдаемый ответ с конкретной версией и экземпляром. Иначе команда может видеть отдельные жалобы, но тратить дополнительное время на установление общего программного источника.
Контроль изоляции. Возможность вывести префикс через BGP должна существовать не только в документации. Необходимо знать, кто уполномочен принять решение, кто технически выполняет изменение, как независимо подтвердить исчезновение маршрута и как избежать ненужного воздействия на исправные части системы.
Таким образом, архитектурное резервирование и операционная готовность отвечают на разные вопросы. Первое показывает наличие альтернативных узлов и путей. Второе показывает, может ли организация или группа партнёров распознать дефект, вывести затронутую часть и безопасно восстановить её под временным давлением.
Что доказывает обязательство регулярно испытывать вывод маршрутов
После происшествия ISC сообщил о договорённости с Cloudflare регулярно тестировать функцию вывода BGP-маршрутов. Это важный элемент послеинцидентной реакции, потому что он адресует тот аварийный путь, который понадобился для ограничения неисправных экземпляров. Договорённость о регулярных испытаниях указана в публичном материале ISC.
Эта договорённость доказывает признание необходимости поддерживать функцию вывода, а не рассматривать её как разовое действие. Она показывает направление предполагаемого улучшения. Но обязательство проводить испытания и доказательство выполненных испытаний — разные виды свидетельства.
В рассмотренном публичном материале нет достаточных данных о последующих датах таких учений, их частоте, охваченных префиксах или площадках, критериях успеха, обнаруженных отклонениях, корректирующих действиях и независимой проверке результатов. Поэтому нельзя установить, исполнялось ли обязательство с определённой периодичностью и насколько успешно.
Эту границу нельзя превращать в утверждение, что испытаний не было. Внутренние проверки могли проводиться без публикации результатов. Отсутствие рассмотренного публичного подтверждения является ограничением доступного доказательства, а не доказательством отсутствия действия. Наиболее узкий вывод таков: публичная запись подтверждает намерение регулярно испытывать вывод маршрутов, но не позволяет оценить последующее исполнение и устойчивость этой способности.
Для доказательства долговечности исправления потребовался бы более конкретный набор данных. Он мог бы включать дату каждого упражнения, участников, исходное состояние, время от решения до наблюдаемого исчезновения маршрута, подтверждение из независимых сетевых точек, влияние на исправные узлы, условия повторного объявления и список выявленных отклонений. Особенно важно заранее определить критерии, иначе завершённое упражнение можно объявить успешным без измеримой границы.
Долговечность относится не только к BGP-команде. Если реальный аварийный путь проходит через несколько организаций, испытание должно охватывать всю цепочку: появление тестового сигнала, его получение, техническую проверку, эскалацию, авторизацию, вывод маршрута, независимое наблюдение результата, проверку исправления и безопасное восстановление. Тест одного технического шага не доказывает готовность всей процедуры.
Ограниченный тест долговечности для операторов и советов директоров
Вопрос «исправлен ли дефект?» слишком узок. Код можно исправить, не устранив слабость проверки выпуска, зависимость от внешнего обнаружения или неготовность аварийной координации. Более полезная оценка разделяет долговечность на доказуемые контрольные элементы.
1. Контроль выпуска
Оператор должен показать, что поэтапное развёртывание разделено на наблюдаемые когорты и может быть остановлено до расширения. Для DNS проверка должна включать не только производительность, но и правильность ответов. Необходимо знать точную версию каждого экземпляра, иметь воспроизводимый набор запросов и сравнивать результаты новой версии с ожидаемым поведением.
Полезный критерий — время от первого семантического отклонения до автоматической или санкционированной остановки выпуска. Если проверка видит только падение процесса, она не охватывает механизм инцидента 2020 года. Если она проверяет обязательные записи, но лишь из одной сети, она может не увидеть затронутый anycast-путь.
2. Контроль обнаружения
Нужно измерять время от первого неправильного ответа до внутреннего сигнала. Проверки должны проходить из нескольких независимых сетей и сопоставляться с телеметрией конкретной версии и площадки. Внешние сообщения операторов также следует включать в систему обнаружения, а не рассматривать только как обращения поддержки.
Качественная процедура позволяет быстро ответить на четыре вопроса: какой запрос дал неверный результат, из какой сети он наблюдался, к какому экземпляру или выпуску он относится и воспроизводится ли дефект из других точек. Без этой связи распределённость увеличивает время диагностики.
3. Контроль эскалации
Участники должны заранее знать, кто принимает сообщение, кто подтверждает дефект, кто может остановить выпуск, кто санкционирует изменение маршрутизации и кто выполняет его технически. Контакты и полномочия должны проверяться на практике, включая нерабочее время.
Испытание считается неполным, если для его прохождения команда должна импровизированно искать владельца решения. Устойчивость зависит не только от правильной схемы, но и от доступности конкретной функции под временным давлением.
4. Контроль изоляции
Вывод затронутого префикса должен быть измеримым и наблюдаемым. Полезные показатели включают время от решения до выполнения команды, время до исчезновения маршрута из независимых точек, корректность перенаправления трафика и отсутствие непредусмотренного воздействия на исправные части системы.
Необходимо также определить границу точности. Если процедура способна вывести только слишком широкую группу узлов, она может заменить частичный дефект более крупным отказом. Если она чрезмерно осторожна и требует длительного согласования, изоляция может запоздать. Испытание должно выявлять этот компромисс заранее.
5. Контроль возврата
Повторное объявление маршрута требует собственной проверки. До возврата нужно подтвердить версию исправления, воспроизвести запросы, выявлявшие дефект, проверить ответы из нескольких сетей и определить условия немедленного повторного вывода. Желательна поэтапная реактивация, а не одновременное возвращение всей затронутой группы.
Успешный вывод без проверенного возврата не доказывает полноценную готовность. Аварийный механизм должен быть обратимым, наблюдаемым и не создавать нового риска после устранения исходной причины.
6. Контроль доказательств
Каждое упражнение должно оставлять проверяемый след: временные отметки, принятые решения, фактически наблюдавшиеся маршруты, результаты семантических тестов, отклонения от цели и владельцев корректирующих действий. Независимая проверка не обязательно требует раскрытия чувствительной топологии. Она требует достаточных данных, чтобы другая компетентная сторона могла определить, достигнуты ли заранее установленные критерии.
Совету директоров или комитету по риску недостаточно знать, что учение состоялось. Необходимо видеть, было ли оно успешным, какие задержки обнаружены, какие меры остаются открытыми и когда способность должна быть проверена снова.
Ограниченный вывод
Инцидент 23 января 2020 года был устранён. Публичная хронология показывает, что ISC получил внешний сигнал, проверил его, эскалировал проблему и запросил вывод затронутых префиксов. Восстановление сочетало исправление программного обеспечения, BGP-вывод и последующее объявление маршрутов. Документированный интервал от осведомлённости ISC до полного восстановления составил 3 часа 18 минут.
Но восстановление сервиса и доказательство долговременной готовности — не одно и то же. Распределённость F-Root ограничила некоторые виды единичного отказа, однако не исключила дефектные ответы с части экземпляров и не устранила необходимость координации между организациями. Согласие регулярно проверять вывод маршрутов является содержательной послеинцидентной мерой, но рассмотренный публичный источник не подтверждает последующее исполнение, частоту, критерии успеха или независимую оценку таких испытаний.
Поэтому вывод должен оставаться ограниченным. Нельзя утверждать, что испытания не проводились. Нельзя также считать само обязательство доказательством их результатов. Архитектурная избыточность подтверждает наличие альтернатив, хронология подтверждает непосредственное восстановление, а долговечная аварийная готовность требует отдельного, повторяемого и проверяемого свидетельства.
Обзор для участников
Подробный контекст профиля
Войдите с подходящим уровнем подписки, чтобы открыть полный обзор и примечания к источникам.
Только для Стратегического сообщества
Стратегическое сообщество
Открыто всем читателям. Вступите и войдите, чтобы открыть обзоры профилей.
Вступить в Стратегическое сообществоТолько для Альянса лидеров
Альянс лидеров
Для проверенных владельцев IP-активов и руководителей. Войдите, чтобы открыть обзоры Альянса.
Вступить в Альянс лидеров