
Кратко
- RFC 5198 определяет Net-Unicode не как один UTF-8, а как совокупность кодирования, NFC, версии репертуара, CRLF и ограничений на управляющие символы.
- ОС или языковая среда может обновить Unicode-таблицы без изменения кода. Поэтому точный бинарный файл не воспроизводит решение без версии данных и отпечатков обработки.
Отсутствующая координата
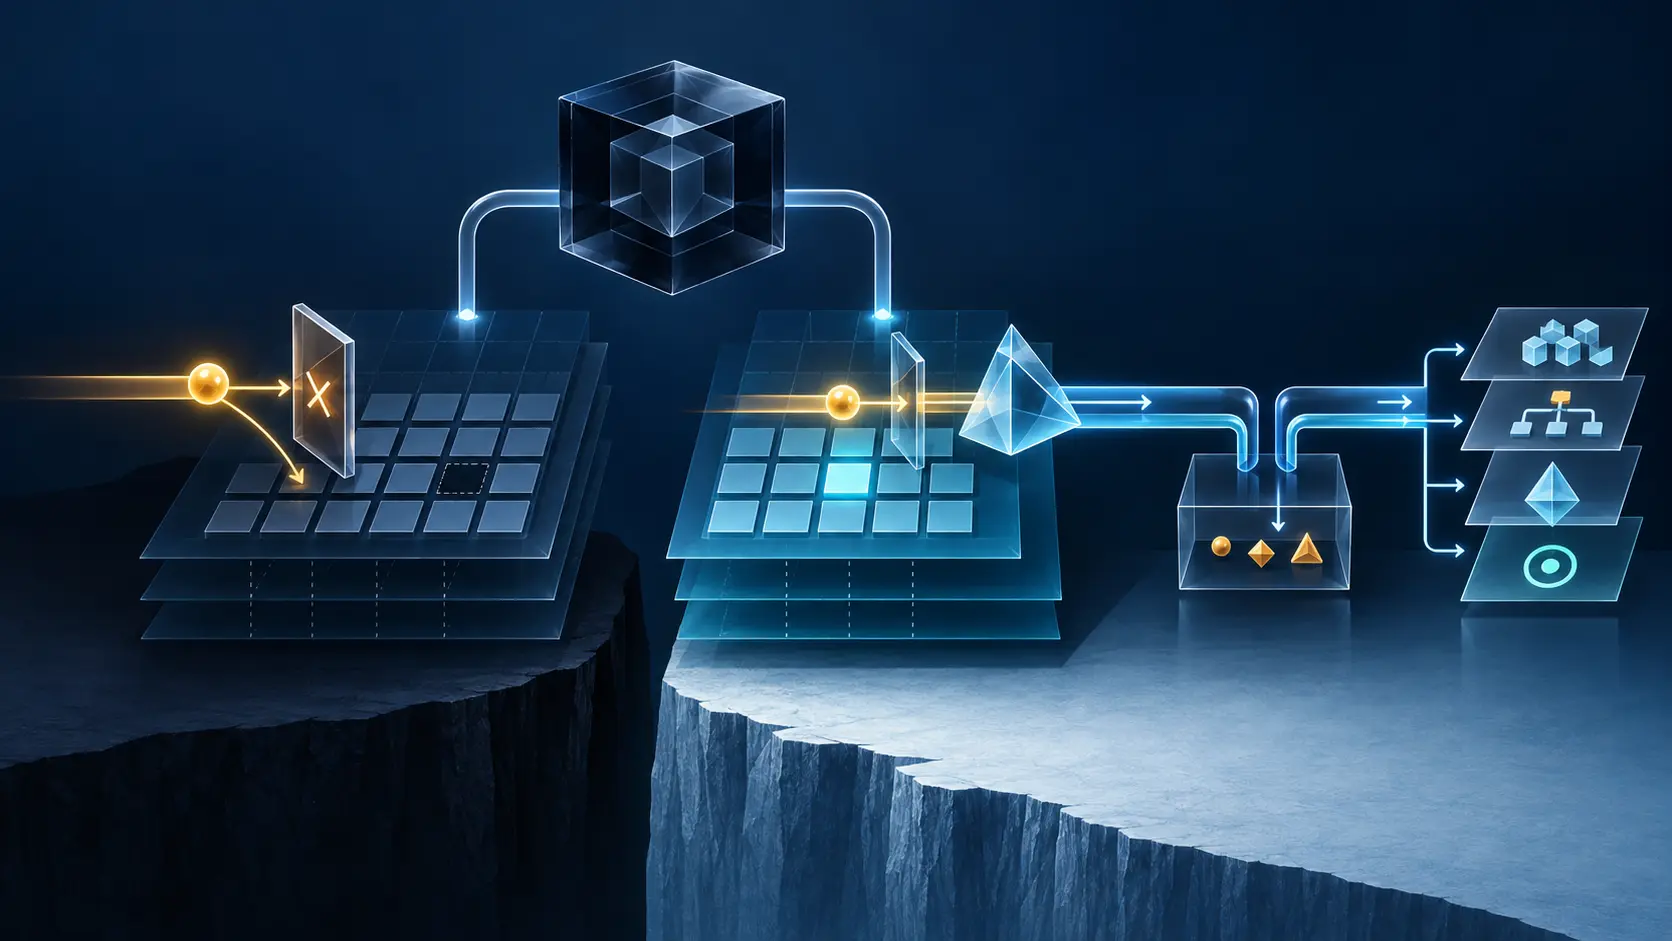
Версия приложения отвечает, какие его байты работали. RFC 5198 показывает, почему этого мало: приложения обычно поручают преобразование и нормализацию функциям ОС или языковой библиотеки. Эти функции обновляются независимо от кода. Программа может не знать версию Unicode и процедуру NFC, которой фактически воспользовалась, и не уметь доказать их согласованность.
Стабильность NFC при этом сохраняет важную границу. Строка без неназначенных точек, уже приведённая к NFC, должна оставаться NFC в будущих версиях. Меняется край репертуара. Пока точка не назначена, она нормализуется в себя; после будущего назначения она может участвовать в отображении. Отправитель Net-Unicode не вправе передавать точку, неназначенную в его зависимой версии.
Новая библиотека способна сдвинуть допустимый набор при неизменном приложении. Именно эту зависимость расследование должно восстановить.
Профиль поверх UTF-8
RFC 3629 задаёт UTF-8. RFC 5198 добавляет сетевой текстовый профиль. Строки протокола завершаются CRLF. Наследованный CR NUL допустим, но нежелателен и опасен там, где NUL завершает строку. C1 запрещены; IND, NEL, U+2028 и U+2029 не служат заменой CRLF. Начальный BOM запрещён.
Перед отправкой последовательность следует привести к NFC. Нельзя передавать неназначенные точки, а версии Unicode и NFC обязаны быть согласованы. Поэтому unicode_valid скрывает как минимум декодирование, проверку назначения, нормализацию, правила строк и управляющих символов.
Статусы errata тоже нельзя стирать. Сообщение 7531 остаётся Reported и исправляет неверное отнесение U+0080–U+009F к ASCII; отдельный запрет C1 ясен. Проверенное 1402 меняет только редакционную ссылку «ниже» на «выше».
Одинаковы ли строки на двух рубежах
RFC предупреждает: вход нельзя считать уже нормализованным. Ненормализованная форма может обойти наивное сопоставление в межсетевом экране. Если экран использует одну таблицу, а приложение другую, их положительные журналы не доказывают сравнение одной последовательности.
Порядок операций существенен. Нормализация до проверки подписи отличается от проверки исходных октетов. Замена конца строки меняет смещения; удаление BOM является преобразованием. Для протокола с собственной точной UTF-8-семантикой действует его профиль, и журнал обязан его назвать.
Что сохранить
Запись включает хэш приложения, образ хоста или контейнера, языковую среду, Unicode Character Database и данные NFC. Неизвестная версия остаётся неизвестной.
Для сообщения связываются хэш октетов, результат UTF-8, точки и вердикт назначено/не назначено. BOM, Private Use, C0, C1, CR, LF, CR NUL, U+2028 и U+2029 имеют отдельные поля. Хэши до и после NFC показывают реальное преобразование.
Далее отдельно фиксируются сравнение, фильтрация, подпись или хранение, полномочие решения и наблюдаемый эффект. Net-Unicode не доказывает личность или авторизацию. Полный чек доказывает более узкий факт: какая текстовая среда вынесла решение.
Источники
- RFC 5198 HTML
- RFC 5198, текст
- Страница RFC 5198
- IETF Datatracker: RFC 5198
- История RFC 5198
- Ссылки RFC 5198
- Errata RFC 5198
- RFC 3629 — UTF-8
- RFC 2277 — кодировки и языки
- RFC 4690 — интернационализированные имена
- RFC 3454 — Stringprep
- RFC 8264 — PRECIS
- RFC 6365 — терминология интернационализации
- RFC 854 — Telnet
- RFC 698 — расширенный ASCII
- Unicode Standard Annex #15
- Политика стабильности Unicode
- Heng Lu — слои реальности и символическая власть
- Heng Lu — минимальная начальная спецификация
- Heng Lu — приоритет работающего кода
Обзор для участников
Подробный контекст профиля
Войдите с подходящим уровнем подписки, чтобы открыть полный обзор и примечания к источникам.
Только для Стратегического сообщества
Стратегическое сообщество
Открыто всем читателям. Вступите и войдите, чтобы открыть обзоры профилей.
Вступить в Стратегическое сообществоТолько для Альянса лидеров
Альянс лидеров
Для проверенных владельцев IP-активов и руководителей. Войдите, чтобы открыть обзоры Альянса.
Вступить в Альянс лидеров