

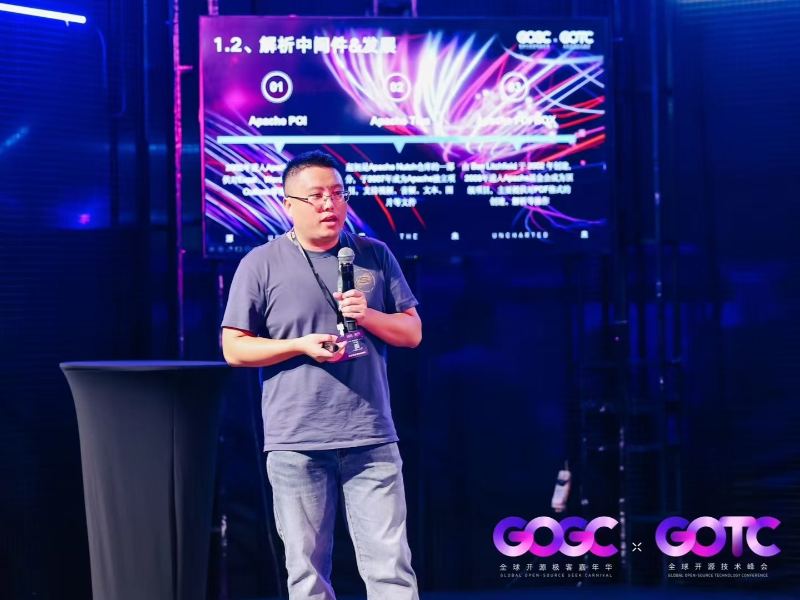
- Xiao Yumin, технический директор TorchV AI, — эксперт в области технической разработки, специализирующийся на RAG, векторном поиске и анализе неструктурированных данных.
- Xiao рассказывает о направленности компании на B2B-решения, использовании неструктурированных данных, а также об уникальных вызовах и возможностях в меняющемся ландшафте технологий на базе ИИ.
Недавно нам представилась возможность побеседовать с Xiao Yumin, техническим директором TorchV AI.TorchV AI— ведущий инноватор в области ассистентов для написания текстов в формате Platform-as-a-Service (PaaS). Компания привлекла к себе внимание с момента основания в 2023 году благодаря передовой платформе, которая поддерживает создание маркетингового контента и подготовку официальных документов.
О Xiao Yumin
Xiao Yumin — технический директор TorchV AI. Он участвовал в разработке на Java и Python, обладает глубокой экспертизой в области технических архитектур, микросервисов, фреймворков с открытым исходным кодом и особым интересом к RAG (генерация с дополнением поиском), векторному поиску и анализу неструктурированных данных. В настоящее время он руководит продуктовыми и исследовательскими направлениями в TorchV AI, уделяя основное внимание большим моделям, RAG и векторному поиску. Кроме того, Xiao — автор проекта Knife4j на платформе GVP Open Source China.
Читайте также:Интервью с Feng Ruohang, автором Pigsty: упрощение управления PostgreSQL и развитие китайского open source-сообщества
Вопрос: Я понимаю, что продукт вашей компании ориентирован в первую очередь на B2B-клиентов. По сравнению с B2C-продуктами, такими как «Wenyan Yixin» от Baidu и «Tongyi Qianwen» от Alibaba, которые представляют собой генеративные ИИ, ориентированные на поиск по документам, что повлияло на ваше решение сосредоточиться на B2B-сегменте?
«В корпоративной среде неструктурированные данные имеют огромную ценность. Это как топливо для автомобиля: данные могут приводить бизнес в движение, постоянно раскрывая свою ценность».
Xiao Yumin, технический директор TorchV AI
Сначала мы ставили перед собой задачу разработать решение Software-as-a-Service (SaaS), и сейчас у нас есть две версии. Одна — онлайн-сервис SaaS, который работает с момента появления RAG и больших моделей. Уже с 2019 года мы занимались разработкой продуктов для интеллектуального обслуживания клиентов, хотя и на несколько устаревшем стеке технологий. После появления больших моделей мы кардинально преобразовали наш стек технологий. Раньше мы вели базу знаний, поддержание которой требовало значительных человеческих ресурсов.
Например, если пользователь спрашивал о погоде в Шанхае, мы поддерживали конкретные ответы — либо через погодные API, либо на основе других текстовых данных, что было очень трудоёмко для нашей команды базы знаний.
Используя возможность, которую открыли большие модели, и опираясь на наш прежний опыт, мы решили запустить бизнес, сделав базу знаний краеугольным камнем. Кроме того, как вы заметили, в этой сфере работают и крупные компании, такие как Baidu и Alibaba. Однако у небольших компаний есть свои явные преимущества. Во-первых, многие малые и средние предприятия (МСП) могли не полностью пройти цифровую трансформацию. С приходом искусственного интеллекта разработанная нами база знаний позволяет опереться на прежние усилия по цифровизации, делая ИИ по-настоящему востребованным продуктом.
Кроме того, в нашей практической работе около 80% времени уходит на обработку неструктурированных данных.
Кроме того, мы твёрдо убеждены, что в корпоративной среде неструктурированные данные имеют значительную ценность. Как раскрыть весь их потенциал? Это как заправка автомобиля: данные могут приводить бизнес в движение, постоянно раскрывая свою ценность. При общении со многими клиентами они часто озвучивают схожие опасения. Значительная часть таких данных, включая документы, обычно хранится на личных компьютерах сотрудников. Им нужна централизованная платформа для данных, своего рода хаб данных.
Однако, когда мы раньше обсуждали хабы данных и большие данные, акцент делался в основном на том, что крупные компании создают центры больших данных, и это не позволяло полностью раскрыть ценность хабов данных, так как фокус был в первую очередь на структурированных данных.
У крупных компаний есть потребительские продукты, такие как WeChat и DingTalk, которые глубоко интегрированы в офисную среду и имеют значительные накопленные данные, что позволяет проводить их анализ и исследование. Однако для малых и средних предприятий такие продукты не подходят. У них есть разнообразные документы: финансовые отчёты, данные о сотрудниках, договоры и другие материалы. Поэтому задача состоит в том, чтобы эффективно использовать эти данные в эпоху ИИ. Наша текущая цель — эффективно применять эти инструменты с помощью совместных методов внутри компании, чтобы оптимизировать весь рабочий процесс.
Вопрос: При разработке продуктов вашей компании создаёте ли вы различные категории продуктов по индивидуальному заказу, чтобы решать специфические задачи разных клиентов?
Отвечая на ваш вопрос о персонализации продуктов для клиентов: мы не практикуем масштабную кастомизацию. Вместо этого мы строим всё на фундаментальной базе знаний, которая служит краеугольным камнем нашей экосистемы данных. После создания этого фундамента мы разрабатываем поверх него различные приложения — что-то вроде центра приложений, предназначенного для удовлетворения потребностей бизнеса. Например, сегодня нам может понадобиться приложение для проверки договоров, чтобы повысить эффективность юридического отдела компании.
Такое приложение у нас уже есть, а завтра это может быть приложение для написания текстов, ориентированное, например, на подготовку годовых отчётов. Мы адаптируем приложения под конкретные обстоятельства клиентов, чтобы они действительно помогали создавать полезные ИИ-сценарии внутри компании. Мы стремимся по одному закреплять каждое приложение. В профессиональном контексте внедрение ИИ сильно отличается от создания забавной картинки, видео или музыки. Требования к ИИ в профессиональной среде значительно выше.
Читайте также:Интервью с Du Junping, основателем и генеральным директором Datastrato: стимулирование инноваций в области данных и ИИ
Вопрос: Не могли бы вы рассказать о технических трудностях, с которыми вы столкнулись при разработке ваших продуктов и решений?
Действительно, есть несколько сложных задач. Как часто говорят технологи, эта конкретная проблема, похоже, не имеет дна. Сегодня в отрасли управление документами, особенно PDF, — пожалуй, самый трудный и проблемный аспект. В настоящее время ни один поставщик, даже самые продвинутые системы вроде ChatGPT4, не может гарантировать полное и точное извлечение информации из PDF-документов. Как мы видим, это непрерывный итеративный процесс: все в области ИИ всё больше сосредоточены на решении этой задачи.
Развитие технологий, безусловно, идёт вперёд, в том числе благодаря многочисленным проектам с открытым исходным кодом и разным моделям ИИ, которые продвигаются в этом направлении.
Вопрос: Есть ли у вас другие мысли, которыми вы хотели бы поделиться, относительно вашего взгляда на неструктурированные данные?
«Способность анализировать, изучать и понимать неструктурированные данные — это не только технологический вызов, но и стратегическая необходимость для компаний, стремящихся получить конкурентное преимущество».
Xiao Yumin, технический директор TorchV AI
Неструктурированные данные — это обширный и неиспользованный ресурс, который таит в себе огромный потенциал для организаций. Учитывая сложность и объёмы неструктурированных данных, для извлечения их ценности требуются инновационные подходы и технологии. Появление больших языковых моделей и прогресс в ИИ позволили нам получать из них инсайты способами, о которых раньше нельзя было и представить. На мой взгляд, будущее — за нашей способностью превращать эти данные в действенные инсайты, и мы активно работаем над этой целью.
Личный взгляд
Xiao Yumin проявляет себя как дальновидный и прагматичный лидер в области искусственного интеллекта и разработки программного обеспечения. Его глубокая техническая экспертиза в таких областях, как RAG, векторный поиск и анализ неструктурированных данных, в сочетании с практическим опытом разработки open source-проектов, таких как Knife4j, делает его авторитетной фигурой в своей сфере. Стремление Xiao использовать технологии ИИ для решения реальных задач, особенно в B2B-сегменте, отражает его понимание рынка и вызовов, с которыми сталкиваются малые и средние предприятия.
Подход Xiao к разработке продуктов методичен и сосредоточен на создании масштабируемых решений, которые можно адаптировать под разнообразные потребности бизнеса. Его акцент на создании прочного фундамента в виде базы знаний как краеугольного камня для различных приложений свидетельствует о стратегическом мышлении и долгосрочном видении. Уделяя приоритетное внимание разработке приложений, адаптируемых к конкретным требованиям клиентов, Xiao демонстрирует острое понимание важности гибкости и адаптивности в быстро меняющемся технологическом ландшафте.
Кроме того, взгляды Xiao на проблемы управления неструктурированными данными, особенно на сложности, связанные с извлечением значимой информации из таких документов, как PDF, показывают его стремление к постоянному совершенствованию и инновациям. Его признание стратегической ценности неструктурированных данных и их потенциала для бизнеса подчёркивает его прогрессивное мышление и стремление открывать новые пути для роста и конкурентных преимуществ.
В целом Xiao Yumin — вдумчивый и целеустремлённый человек, сочетающий технические навыки с ясным пониманием бизнес-ландшафта. Его лидерство в TorchV AI характеризуется сосредоточенностью на разработке практичных ИИ-решений, которые способны по-настоящему изменить то, как компании работают и процветают в цифровую эпоху.