
Resumo
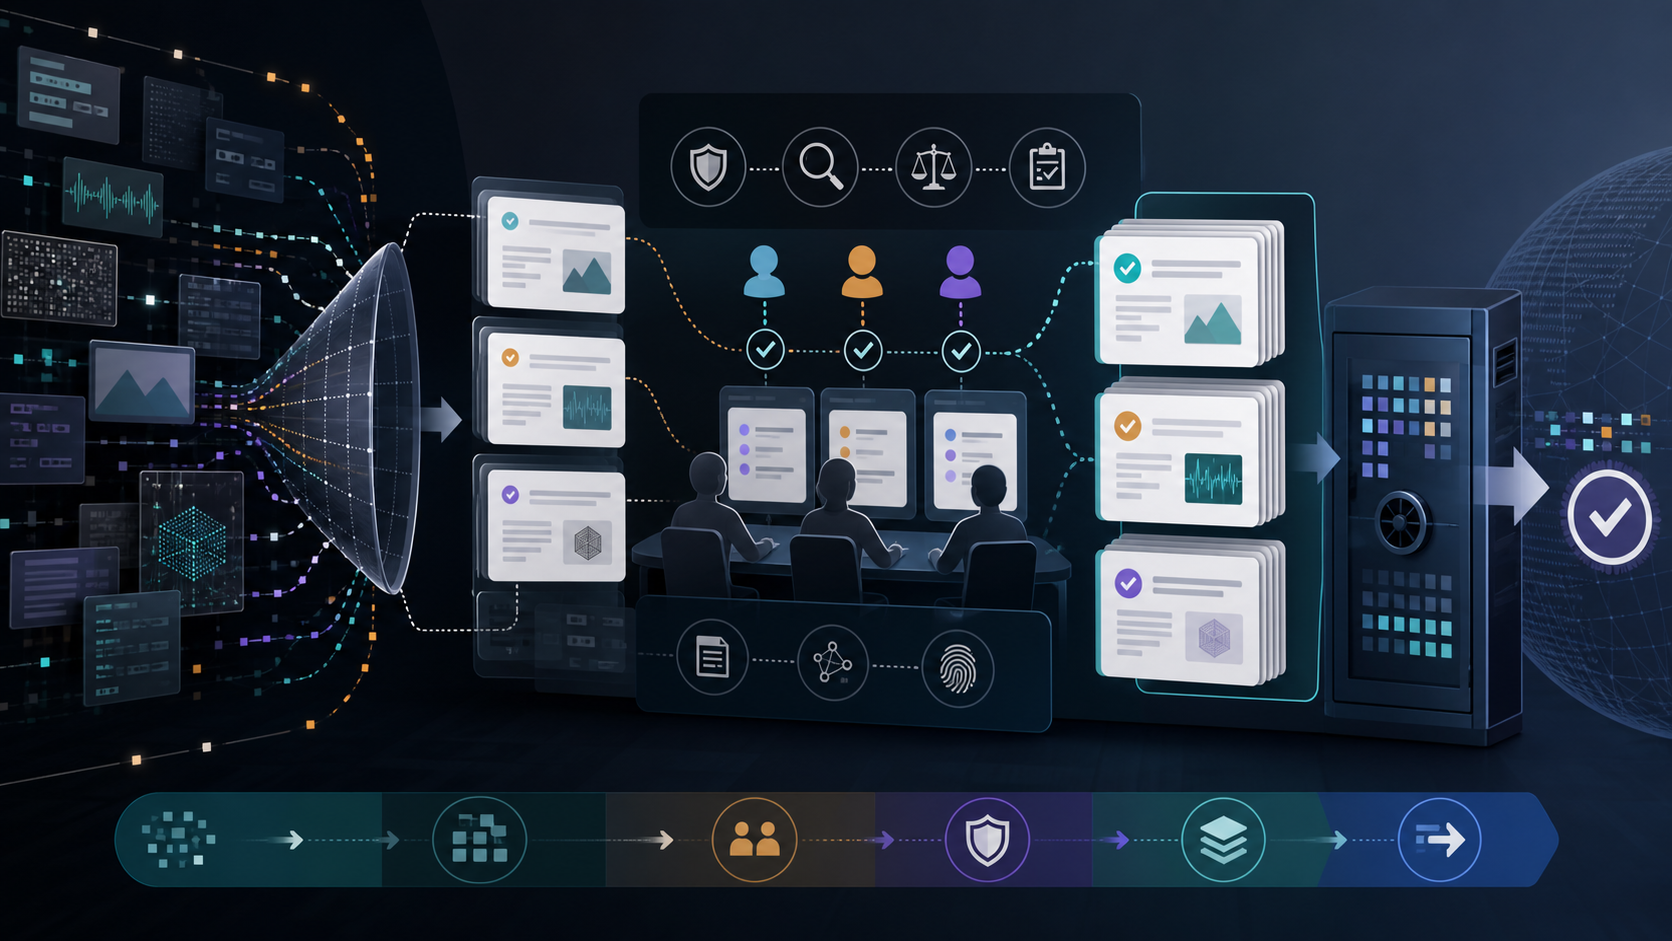
- A Scale AI deve ser julgada pela unidade de dados ou avaliação aceita: uma tarefa, linha, rótulo, resultado de revisão ou registro de avaliação de modelo que um comprador possa confiar o suficiente para treinar, avaliar, exportar, auditar e reutilizar.
- A superfície de produto pública da Scale tem os primitivos certos para esse trabalho: projetos, tarefas, lotes, taxonomias, callbacks, estados de auditoria, separação de revisores, painéis, rastreamentos, integrações de armazenamento e opções de implantação segura. Esses primitivos tornam a qualidade governável, mas não a tornam automática.
- Os riscos mais difíceis não são riscos de marca. São instruções ambíguas, baixa concordância entre revisores, vazamento de benchmark, proveniência fraca, erros de permissão de armazenamento, restrições de localidade de dados, conjuntos de avaliação desatualizados, overfitting no teste, loops de retrabalho e o custo de manter humanos e juízes automatizados alinhados.
- Os compradores devem comparar a Scale AI com revisão manual, operações de dados internas, ferramentas de provedores de modelo, pilhas de avaliação de código aberto e fazer menos da tarefa medindo custo por unidade aceita, taxa de retrabalho, divergência entre revisores, completude de proveniência, configuração de segurança, melhoria marginal do modelo e o custo de mudança para sair.
A unidade aceita é o produto
A Scale AI está na parte menos teatral da pilha de IA. Seu trabalho está a montante da demonstração do modelo e a jusante do despejo de dados brutos. É o lugar onde uma imagem, documento, conversa, resposta de código, raciocínio, cenário de segurança ou registro operacional se torna algo que uma equipe de modelo pode treinar ou avaliar. A história pública muitas vezes faz isso parecer um problema de escala: mais anotadores, mais rótulos, mais tarefas, mais demanda empresarial e governamental. A história de produção é mais restrita e mais difícil. Um comprador precisa de uma unidade de evidência que possa ser aceita.
Uma unidade aceita não é meramente um rótulo. É um registro com uma razão para existir, um conjunto de instruções, uma taxonomia, um caminho de revisor, um rastro de proveniência, um resultado exportável e contexto suficiente para que outra equipe entenda por que deveria influenciar um modelo. Nadocumentação de tarefasda Scale, uma tarefa é a unidade individual de trabalho mapeada para um dado a ser rotulado. Em suadocumentação de conceitos-chave, projetos organizam tarefas, lotes agrupam tarefas e tarefas concluídas produzem respostas estruturadas. Esse é o denominador certo para julgar a Scale porque é pequeno o suficiente para inspecionar e grande o suficiente para importar quando repetido milhões de vezes.
A mesma lógica se aplica à avaliação. Uma pontuação de modelo é tão útil quanto os exemplos, rubricas, revisores e regras de amostragem que a produziram. A página de avaliação para desenvolvedores de modelo da Scale enquadra o problema como uma escassez de conjuntos de dados de avaliação confiáveis e de alta qualidade e consistência na comunicação, ao mesmo tempo que alerta sobre riscos como desinformação, privacidade, viés, uso indevido cibernético e conteúdo de substâncias perigosas.
Essa alegação de produto é importante porque nomeia o problema real do comprador: não se um modelo pode vencer um benchmark uma vez, mas se uma organização pode continuar avaliando o comportamento correto sem vazar as respostas, treinar para o teste ou perder a consistência do revisor ao longo do tempo.
É por isso que a pergunta útil não é se a Scale tem operações de dados, se tem uma grande rede de contribuidores ou se um cliente a usou. A pergunta útil é se a Scale ajuda um comprador a transformar incerteza em evidência aceita a um custo total menor do que as alternativas. Um exemplo bruto pode ser ambíguo. Uma política pode mudar. Dois revisores podem discordar. Um modelo pode melhorar nos casos fáceis enquanto falha nos casos extremos que importam. Um juiz automatizado pode se tornar uma fonte de viés em vez de um atalho. Uma permissão de armazenamento pode ser conveniente durante o upload e perigosa durante a exportação.
Um lote pode parecer completo enquanto a próxima equipe não consegue reproduzir a base para aceitação.
A unidade aceita também separa três camadas que geralmente são misturadas. A capacidade do modelo é o que o modelo do cliente pode fazer. A confiabilidade do produto é se as ferramentas, revisores, APIs, painéis e escolhas de implantação da Scale podem processar evidências de forma previsível. O resultado de produção do cliente é se a tarefa real do comprador melhora após supervisão, integração, revisão, tratamento de exceções, armazenamento, segurança e custos de mudança serem incluídos. A Scale pode fornecer a segunda camada e influenciar a terceira. Ela não possui todos os resultados do modelo do cliente.
Esse limite é importante para a entidade de diretório existente da Scale AI. A Scale AI é a empresa sendo avaliada aqui, junto com superfícies operadas pela Scale, comoData Engine,Generative AI Data Engine, Scale Evaluation,GenAI PlatformeDonovan. O artigo não é um julgamento sobre todo modelo treinado com dados da Scale, todo programa governamental que nomeia a Scale, toda aplicação de cliente que fica em cima de um provedor de modelo ou toda alegação de mercado de trabalho feita sobre o trabalho de dados. Essas podem ser relevantes para a confiança do comprador, mas não são o denominador técnico central.
O denominador central é a unidade de dados de treinamento ou avaliação aceita. Se essa unidade for confiável, a Scale pode se tornar infraestrutura. Se não for, a Scale se torna um roteamento de tarefas caro.
A Scale vende um loop de repetição, não um modelo pronto
A história de produto público mais forte da Scale é um loop. A páginaData Engineenquadra o ciclo como coletar, curar e anotar dados, depois treinar e avaliar modelos, e depois repetir. A páginaGenerative AI Data Engineestende essa história para conjuntos de dados personalizados, revisão de especialistas no assunto, RLHF, avaliação de modelo, red-teaming e trabalho de segurança. O loop importa porque o desenvolvimento útil de modelo raramente termina com um conjunto de dados. Um modelo falha de uma nova maneira, um comprador adiciona uma nova política, um caso extremo aparece em produção, um regulador pede evidência, um segmento de cliente muda, ou um provedor de modelo lança uma nova versão. Então o processo de dados e avaliação tem que se mover novamente.
Para os compradores, esse loop de repetição é tanto a razão para considerar a Scale quanto a razão para ser cuidadoso. Um projeto de rotulagem único pode ser gerenciado como um engajamento de serviços. Um loop de repetição se torna infraestrutura operacional. Uma vez que a equipe de modelo de um comprador depende de um fornecedor para taxonomias, processos de revisão, pools de contribuidores, painéis de avaliação, casos de red-team, integrações de armazenamento e exportações, o fornecedor não está mais apenas preenchendo um backlog. Está moldando o que a organização do comprador conta como evidência.
A documentação da Scale tem maquinário real por trás dessa alegação. Projetos estão vinculados a um caso de uso e instruções. Adocumentação de gerenciamento de projetosdiz que as tarefas em um projeto devem compartilhar as mesmas instruções e que mudanças significativas nas instruções devem criar um novo projeto. Essa é uma restrição pequena, mas importante. Ela reconhece que a deriva de instruções altera o significado de um rótulo. Se uma equipe edita a definição de uma resposta prejudicial, um documento fiscal válido, uma marcação de faixa, um sintoma clinicamente relevante ou uma chamada de ferramenta bem-sucedida no meio de um conjunto de dados, os exemplos resultantes podem não ser mais comparáveis. Um novo limite de projeto pode preservar o significado.
Lotes adicionam outra camada operacional. AAPI de lotespermite que as equipes criem lotes dentro de projetos, definam callbacks, recuperem status e contem tarefas agrupadas por estado. Ela também observa que a priorização afeta tarefas ainda não iniciadas e não garante ordem de conclusão. Essa ressalva é útil porque os compradores de produção geralmente assumem que uma fila de fornecedor se comporta como um agendador de trabalho interno. Pode não ser. Se um conjunto urgente de exemplos é necessário para diagnosticar uma falha de modelo ao vivo, o comprador tem que saber o que a prioridade pode e não pode prometer.
Os callbacks tornam a unidade operacional. Adocumentação de callbackdescreve resultados JSON enviados para endpoints do comprador, comportamento de repetição se nenhuma resposta bem-sucedida for retornada e eventos para conclusão de tarefa, mudanças de status de auditoria e tarefas recolhidas. Um callback não é um recurso glamoroso, mas é a diferença entre um projeto de console web e um sistema que pode se conectar ao processo de lançamento do comprador. Se uma tarefa concluída chega com o status, resposta e estado de revisão corretos, a equipe de modelo pode acionar validação downstream, exportação, treinamento ou revisão. Se os callbacks falham silenciosamente ou não são autenticados e monitorados corretamente, unidades aceitas podem se perder entre as equipes.
O argumento comercial da Scale, portanto, depende do loop ser mais barato e mais confiável do que as alternativas do comprador. As alternativas não são imaginárias. Um grande laboratório de IA pode construir sua própria operação de dados. Uma empresa pode contratar revisores de domínio e executar um processo interno mais leve. Um provedor de nuvem ou modelo pode oferecer ferramentas de avaliação próximas à API do modelo. Estruturas de avaliação de código aberto podem cobrir parte da tarefa.
Uma equipe pode reduzir a quantidade de trabalho estreitando o produto, escolhendo um modelo menor, evitando automação de alto risco ou usando aprovação humana para menos ações. A Scale vence apenas quando seu loop produz melhores unidades aceitas por dólar e por semana do que essas alternativas.
O comprador deve resistir à tentação de medir o loop apenas pelo volume. Mais tarefas concluídas não é o mesmo que mais evidência útil. Se a taxonomia errada for usada, a saída é desperdício preciso. Se os revisores discordam, mas a discordância é oculta, o resultado é falsa confiança. Se os casos extremos são sub-amostrados, o modelo pode melhorar na média enquanto falha exatamente nas situações que justificam o projeto. Se um conjunto de avaliação se torna familiar para a equipe de desenvolvimento do modelo, a pontuação pode melhorar enquanto o comportamento no mundo real não. O volume é útil apenas quando a aceitação é significativa.
A concordância humana é o recurso escasso
A parte mais difícil do produto da Scale não é mover dados através de uma API. É alinhar humanos e modelos em torno de julgamento contestado. Muitas tarefas de treinamento e avaliação são fáceis apenas em exemplos. Um revisor pode identificar uma placa de pare em uma imagem clara, mas as falhas do modelo geralmente se acumulam nas margens: oclusão, ruído do sensor, sarcasmo, contexto local, intenção ambígua, idioma de baixos recursos, conflitos de política, documentos parciais, sinais de segurança mistos ou exemplos onde a resposta correta depende de uma regra interna do cliente.
Quanto mais economicamente valioso o comportamento do modelo, mais provável que a evidência exija julgamento em vez de transcrição.
A documentação pública da Scale mostra que ela entende a revisão como um processo de várias etapas. Em suadocumentação de avaliação de rotulagemda Plataforma GenAI, anotadores humanos podem trabalhar em tarefas atribuídas, rótulos são salvos, itens incertos podem ser pulados e tarefas podem sinalizadas para revisão com comentários. Nadocumentação de auditoria, os processos de avaliação podem ter dois níveis de auditoria, e o rotulador, primeiro auditor e segundo auditor devem ser pessoas diferentes. Os auditores podem aprovar, solicitar revisão ou corrigir a tarefa.
Essas escolhas de design importam. A separação de revisores reduz o risco de que o mal-entendido de uma pessoa se torne a resposta final. Sinalizar tarefas incertas dá aos revisores um caminho para preservar a ambiguidade em vez de forçar cada exemplo a um falso binário. Solicitações de revisão criam um registro de que a primeira passagem não foi aceita. Métricas para contribuidores e auditores podem ajudar a identificar se um revisor é excepcionalmente leniente, excepcionalmente rigoroso ou inconsistente. Essas não são suficientes por si só, mas são os tipos certos de primitivos.
O comprador ainda tem que perguntar se os primitivos são bem usados. Um processo de auditoria de dois níveis pode se tornar um carimbo de borracha se os revisores estiverem apressados, mal treinados ou otimizando para produtividade. Métricas de contribuidores podem encorajar concordância superficial se o alvo for muito estreito. Uma opção de pular pode proteger a qualidade, ou pode se tornar uma maneira de evitar casos difíceis. Um segundo auditor pode melhorar o julgamento, ou pode adicionar custo sem mudar o resultado se a rubrica for ruim. A superfície do produto pode suportar qualidade; não pode definir a verdade do cliente.
É por isso que os critérios de aceitação têm que ser escritos antes que o volume cresça. Os compradores devem definir o que conta como concordância, que tipos de discordância são aceitáveis, quais exemplos exigem escalação, que evidência um revisor deve fornecer, com que frequência exemplos padrão-ouro ou revisados por especialistas são inseridos, quando uma taxonomia é revisada e como os rótulos antigos são migrados quando a política muda.
Eles devem medir não apenas a taxa de aceitação final, mas a rejeição na primeira passagem, frequência de revisão, discordância entre revisores, categorias de tarefas puladas, tempo para resolver exemplos disputados e impacto do modelo após as unidades aceitas serem usadas.
Adocumentação de Auditorias Fixlessda Scale é útil aqui porque trata o feedback como dados estruturados em vez de apenas um comentário. Ela documenta escopo de feedback, gravidade, estado, resultados aceitos ou rejeitados e regras de cálculo de pontuação de qualidade. Suadocumentação de Pro Qualitymostra caminhos de aprovação, alteração e rejeição e relata totais de revisão, resultados no nível da tarefa e informações relacionadas ao revisor. Isso não diz ao comprador que os rótulos resultantes são bons. Diz ao comprador onde exigir evidência.
O perigo é o falso consenso. Se uma tarefa é fácil, os revisores concordam. Se uma rubrica é vaga, os revisores podem concordar também porque inferem o mesmo atalho dos exemplos em vez de aplicar a regra pretendida. Se um comprador treina um modelo nessa saída, o modelo pode aprender o atalho. Depois, quando a tarefa se move para uma nova região, segmento de cliente, tipo de documento ou contexto de política, o atalho quebra. Um bom processo de dados, portanto, precisa de discordância. Precisa que o sistema descubra onde o julgamento é incerto e onde a rubrica não viaja.
O valor da Scale aumenta quando ela torna a discordância visível, resolve-a consistentemente e preserva a razão. Seu valor cai quando ela transforma a discordância em um problema de produtividade.
A avaliação não pode ser reduzida a um leaderboard
A avaliação de modelo é onde o problema de confiança do comprador da Scale se torna mais explícito. Um conjunto de dados de treinamento pode ser inspecionado tarefa por tarefa, mas um sistema de avaliação se torna uma autoridade dentro da organização. Ele diz às equipes qual modelo é melhor, se um lançamento é aceitável, se uma proteção funciona, se um problema de red-team é corrigido e se um produto pode passar do teste para a produção. Se essa autoridade é fraca, a organização pode implantar com confiança o comportamento errado.
A página de produtoAvaliação para Desenvolvedores de Modeloda Scale identifica dois problemas que os compradores devem levar a sério: conjuntos de dados de avaliação confiáveis e consistência. Ela também enfatiza conjuntos de avaliação proprietários e avaliações direcionadas. Essa é uma direção sólida porque os benchmarks públicos são muitas vezes muito genéricos ou muito expostos para responder à pergunta de um comprador. Um banco avaliando respostas de atendimento ao cliente, um usuário de defesa avaliando suporte a planejamento, uma empresa de mídia avaliando sumarização e uma empresa de software avaliando comportamento de assistente de código não precisam do mesmo conjunto de aceitação. Eles precisam de tarefas que representem as falhas que realmente temem.
O trabalho acadêmico de avaliação aponta na mesma direção. O projetoHELMde Stanford argumenta para avaliar modelos de linguagem em múltiplas dimensões, como precisão, calibração, robustez, justiça, viés, toxicidade e eficiência. Isso importa para a Scale porque uma única pontuação pode esconder a troca que decide se um modelo deve ser usado. Um modelo pode ser mais preciso na média e menos seguro em uma classe restrita de solicitações de alto risco. Pode ser eficiente e mal calibrado. Pode ter bom desempenho em inglês e mau desempenho em um idioma local. Pode evitar conteúdo ofensivo e ainda assim dar conselhos não qualificados. Um sistema de avaliação sério tem que preservar essas dimensões em vez de colapsá-las em um número amigável para aquisição.
Há também o problema de contaminação. Pesquisas sobre contaminação de benchmark, incluindo o artigo da ACL Anthology sobrecontaminação de dados em benchmarks modernos de LLM, mostram por que a sobreposição entre material de treinamento e material de avaliação pode fazer o desempenho parecer melhor do que é. O risco não se limita a benchmarks públicos. Um comprador privado pode contaminar seu próprio conjunto de avaliação usando os mesmos exemplos para ajuste, iteração de instruções, treinamento de revisores e aprovação de lançamento. Quanto mais uma equipe otimiza contra um conjunto de avaliação fixo, mais o conjunto pode parar de medir capacidade geral e começar a medir familiaridade.
A documentação da Plataforma GenAI da Scale mostra várias ferramentas que podem ajudar se o comprador as usar com disciplina. Avisão geral da avaliação de próxima geraçãodescreve avaliações como linhas de dados e tarefas, com conjuntos de dados reutilizáveis e resultados assíncronos. Adocumentação de avaliação automáticadescreve a decodificação guiada por modelo que pode retornar razões e pontuações. Adocumentação de painéis de avaliaçãodescreve métricas de monitoramento através de tabelas, gráficos, histogramas, gráficos de dispersão, séries temporais e consultas de agregação. Avisão geral de rastreamentodescreve spans e traces que capturam entradas, saídas, IDs, tempo, metadados, status e tipo.
Juntas, essas peças podem suportar um processo de avaliação sério. Elas podem permitir que um comprador monte linhas, execute tarefas humanas e automatizadas, inspecione traces, monitore tendências e compare lançamentos. Mas elas também criam novas responsabilidades. Juízes automatizados precisam de sua própria validação. Painéis precisam de regras de amostragem. Traces podem conter dados sensíveis. Conjuntos de dados reutilizáveis precisam de versionamento e controles de contaminação.
A melhoria em série temporal pode refletir um ganho real de produto, uma amostra alterada, um juiz diferente, um padrão de instrução limpo ou uma mudança na população de usuários. O painel não é a verdade; é um instrumento que tem que ser calibrado.
A pergunta útil do comprador é, portanto, não: "A Scale pode executar avaliações?" Ela pode. A pergunta útil é: "A Scale pode nos ajudar a provar que a avaliação ainda significa o que pensamos que significa?" Essa prova requer exemplos retidos, calibração de revisores, novos casos adversariais, versões explícitas de política, captura de razão, verificações de contaminação, intervalos de confiança onde prático e uma regra de lançamento que impeça as equipes de otimizar apenas para a pontuação exibida.
A avaliação é valiosa quando cria fricção no momento certo. Ela deve desacelerar um lançamento quando alucinação, privacidade, segurança, viés, legal, domínio específico ou falhas de contexto do cliente aparecem. Ela deve identificar a classe de falha que precisa de mais dados. Ela deve distinguir entre uma melhoria de modelo, uma solução alternativa de configuração e um artefato de medição. Se a superfície de avaliação da Scale fizer isso, é um produto de confiança do comprador. Se meramente dá uma pontuação, é um benchmark mais bonito.
Proveniência e armazenamento são controles de qualidade
A proveniência de dados é muitas vezes tratada como um tópico de conformidade, mas em um sistema de treinamento e avaliação é um tópico de qualidade primeiro. Uma equipe de modelo precisa saber de onde veio um exemplo, qual versão de instrução foi aplicada, quem ou o que revisou, quais dados foram anexados, qual resultado foi exportado e se o registro pode ser reutilizado para o próximo modelo. Se esses fatos estão faltando, a equipe ainda pode treinar um modelo, mas não pode explicar por que a evidência deve ser confiável.
Os documentos da Scale expõem várias superfícies de proveniência. Metadados e tags de tarefa podem carregar contexto do lado do comprador. Lotes podem segmentar trabalho por projeto, tempo ou agrupamento operacional. Payloads de callback podem carregar conclusão e mudanças de revisão no sistema do comprador. Traces na Plataforma GenAI podem preservar entradas, saídas e status para unidades de trabalho. Fluxos de trabalho podem importar de traces, arquivos CSV, bancos de dados e armazenamento em nuvem, chamar modelos ou serviços de aplicação, juntar ground truth, executar tarefas de juiz, exportar como avaliações e agendar execuções repetidas, de acordo com aintrodução a fluxos de trabalhoe oguia de fluxo de trabalho de avaliaçãoda Scale.
Essas são as fundações de um registro útil. Elas permitem que um comprador reconstrua como um exemplo se moveu da fonte bruta para a saída aceita. Elas também tornam possível separar evidência gerada por um humano, evidência gerada por um juiz automatizado, evidência importada de um sistema do comprador e evidência inferida de uma execução de modelo. Essa distinção importa porque nem toda evidência deve ter a mesma autoridade. A rejeição de um especialista humano a uma resposta médica não é equivalente a uma pontuação barata de juiz modelo.
Um trace de uma chamada de ferramenta específica do cliente não é equivalente a uma linha genérica de benchmark. Um caso de red-team escrito após um incidente pode merecer mais peso do que um exemplo de validação de rotina.
O armazenamento e os controles de acesso moldam se esse registro pode ser confiável. A documentação pública da Scale mostra escolhas práticas de integração. Adocumentação do AWS S3recomenda acesso IAM delegado com um ID externo e alerta sobre o risco de confusão de deputado em certos padrões entre contas. Adocumentação do Google Cloud Storagealerta similarmente sobre riscos de URL adivinhada em padrões de acesso entre projetos. Adocumentação do Azure Blob Storageobserva que desvincular uma conexão na Scale não revoga as permissões do Azure. Essas não são notas de rodapé legais abstratas. São fatos operacionais que decidem se um comprador sabe quem ainda pode ler os dados subjacentes.
Adocumentação de URLs de resultado segurosé especialmente importante. Ela diz que alguns resultados de segmentação, vídeo e lidar são enviados por padrão para URLs de resultado S3 públicas com UUIDs, enquanto URLs de resultado autenticados podem ser habilitados entrando em contato com o suporte. Isso não significa que um comprador deva entrar em pânico, e não prova uma implantação ruim. Significa que a entrega de resultado é uma questão de configuração que pertence ao plano de aceitação. Se os dados são sensíveis, o comprador deve saber se os resultados exigem autenticação, por quanto tempo os links permanecem utilizáveis, onde os objetos são armazenados, como o acesso é registrado e se as equipes downstream copiam resultados para locais menos controlados.
A localidade e soberania de dados adicionam outra camada. As superfícies públicas da Scale incluem alegações de implantação governamental e segura, incluindo o posicionamento de Donovan em torno de contextos classificados, air-gapped e FedRAMP High. O FedRAMP Marketplace lista aScale AI Data Platformcomo certificada pelo FedRAMP, Classe D High, com data de certificação em 9 de setembro de 2024. Isso é significativo para compradores do setor público porque mostra um caminho de autorização para um produto definido. Não resolve automaticamente todos os requisitos de localidade, classificação, missão, controle de exportação ou dados do cliente.
A conclusão certa é que proveniência e armazenamento são parte do produto, não controles posteriores. Se um comprador não consegue rastrear uma unidade de dados aceita de volta à sua fonte, versão de política, caminho de revisor e localização do resultado, a unidade é frágil. Pode ainda ser útil para um experimento rápido, mas não é forte o suficiente para governar um lançamento de modelo ou apoiar uma auditoria séria.
A confiabilidade é visível em limites, callbacks e incidentes
A confiabilidade da Scale deve ser medida em dois níveis. O primeiro é a confiabilidade da superfície do produto: APIs, estado da tarefa, callbacks, painéis, acesso ao armazenamento, identidade e disponibilidade do produto. O segundo é a confiabilidade da evidência produzida: rótulos, resultados de avaliação, decisões do revisor e traces. Ambos importam, e podem falhar independentemente. Uma API estável pode entregar rótulos fracos. Um processo de revisor forte pode ser bloqueado por uma interrupção de serviço ou callback quebrado.
A documentação pública da API dá aos compradores detalhes suficientes para iniciar uma lista de verificação de confiabilidade. Adocumentação de autenticaçãosepara modos ao vivo e de teste e observa que tarefas ao vivo são concluídas por humanos e incorrem em custos, enquanto o modo de teste pode retornar respostas de teste incorretas. Isso é um lembrete de que testes de integração não são testes de qualidade. Um comprador pode validar a fiação da API em um ambiente de teste, mas não pode inferir qualidade de dados humana a partir de respostas de teste. A validação ao vivo requer uma amostra controlada e orçamento.
Limites técnicos também importam. Adocumentação de limites e recomendações técnicaslista limites como taxas de solicitação de criação de tarefa, tamanho de metadados, contagem de atributos, metadados de upload de arquivo, tamanho de anexo e orientação de suporte a navegador. Essas não são restrições desqualificantes. Toda plataforma tem limites. O ponto é que eles devem ser contados antes que um comprador comprometa um processo de alto volume. Uma operação de dados que depende de metadados ricos, anexos grandes ou envio rápido de tarefas precisa projetar em torno dessas restrições em vez de descobri-las em produção.
O tratamento de erros é outra questão de unidade aceita. Adocumentação de erroscobre falhas de anexo, erros de autenticação, erros de pagamento, recursos ausentes, conflitos de idempotência, limites de taxa e erros de servidor. Adocumentação de callbacksdiz que as repetições de callback podem continuar por até 20 tentativas ao longo de 24 horas se uma resposta bem-sucedida não for recebida. Os compradores devem transformar esses fatos em controles: tratamento de mensagens mortas, procedimentos de reprodução, detecção de duplicatas, autenticação de callback, alertas, tratamento de exportação atrasada e reconciliação entre o estado da tarefa da Scale e o sistema do comprador.
A página de status pública da Scale adiciona um sinal operacional útil, mas incompleto. Em 11 de julho de 2026, oendpoint de resumo de statusrelatou todos os sistemas operacionais em componentes incluindo API, Platform, Web Application, Document AI, Nucleus, Spellbook, Catalog Forge, Catalog Explorer e Donovan. Oendpoint de incidentespúblico retornou um histórico de incidentes resolvidos, incluindo degradação de desempenho em janeiro de 2025, degradação de desempenho do Nucleus em março de 2024, uma interrupção da aplicação web Donovan em novembro de 2023 e problemas anteriores de plataforma ou aplicação.
Esse histórico não deve ser exagerado nem ignorado. Uma página de status é operada pelo fornecedor e muitas vezes esparsa. Ela não fornece um conjunto de dados de nível de serviço completo, análise de causa raiz ou impacto específico do cliente. Mas prova que a superfície do produto teve incidentes públicos e que os compradores devem projetar em torno de atraso, degradação e interrupção específica de componente.
Para uma operação de dados ou avaliação, o tempo de inatividade pode ter um efeito de segunda ordem: lançamentos de modelo esperam, filas de revisão acumulam, triagem de incidentes carece de exemplos frescos e uma equipe pode implantar um modelo sem a passagem de avaliação pretendida.
Os compradores devem definir confiabilidade no nível da unidade aceita. Quantas tarefas enviadas atingem um estado terminal? Quantas unidades aceitas são entregues ao sistema do comprador sem reconciliação manual? Com que frequência os callbacks falham ou exigem reprodução? Com que frequência erros de anexo são causados por permissões de armazenamento do comprador? Com que rapidez uma tarefa rejeitada pode ser corrigida? Quanto trabalho de revisão é atrasado por problemas de plataforma? Quantas execuções de avaliação são invalidadas por traces ausentes ou configuração de juiz alterada?
Essas são perguntas melhores do que se a página de marketing diz que a plataforma está pronta para empresa.
A oportunidade da Scale é que seus primitivos são explícitos o suficiente para essa medição. Seu risco é que os compradores podem confundir a existência de primitivos com uma garantia de resultado.
Histórias de clientes e prêmios governamentais são sinais de demanda, não prova de aceitação
A Scale tem sinais de demanda visíveis. Sua página inicial diz que trabalha com os principais laboratórios de IA, empresas e governos. Suas páginas de produto descrevem trabalho para dados, avaliação e aplicações de IA. Suahistória de cliente TIMEdescreve recursos de IA da TIME, como resumos, voz, tradução e chat, com ajuste fino, red-teaming, proteções, monitoramento e milhares de vetores de ataque. A Defense Innovation Unit anunciou oThunderforge, um esforço de protótipo envolvendo a Scale AI para suporte à decisão impulsionado por IA em planejamento operacional e de teatro. A Scale também anunciou que o Departamento de Defesa, Gabinete do Diretor Digital e de Inteligência Artificial expandiu um acordo empresarial para umteto de US$ 500 milhões, cobrindo áreas como visão computacional, suporte à decisão e operações de dados.
Esses são sinais de mercado significativos. Eles mostram que compradores com necessidades sérias estão dispostos a avaliar ou usar a Scale. Eles também mostram por que a lente da unidade aceita é necessária. Uma história de cliente não é um estudo independente de retorno sobre investimento. Um protótipo governamental não é prova de sucesso final da missão. Um teto de contrato não é o mesmo que valor consumido.
Um logotipo de cliente não pode dizer a um comprador diferente se uma taxonomia era boa, os revisores concordaram, os dados permaneceram dentro dos limites exigidos, as descobertas do red-team mudaram o modelo, ou o conjunto de avaliação previu o comportamento de produção.
A mesma cautela se aplica a evidências de defesa e setor público. A adoção no setor público aumenta as apostas porque a unidade aceita pode influenciar suporte à decisão, fluxos de trabalho de inteligência, planejamento operacional ou software de missão. A páginaDonovanda Scale enfatiza teste, avaliação, monitoramento, proteções, rastreabilidade, agnosticismo de modelo e opções de implantação segura. Essas são as categorias certas para os compradores do setor público se preocuparem. Mas quanto mais consequente o uso, mais conservador o padrão de evidência deve ser. Uma sugestão apoiada por modelo em um contexto de missão não deve ser aceita porque um painel é elegante. Deve ser aceita porque o registro de origem, contexto de recuperação, saída do modelo, caminho de revisão, tratamento de falha e autoridade humana são todos claros.
Compradores comerciais enfrentam o mesmo padrão em apostas mais baixas. Uma empresa de mídia pode usar IA generativa para resumir artigos ou responder perguntas de leitores. Uma empresa de software pode usar avaliações para comparar assistentes de codificação. Uma instituição financeira pode revisar extração de documentos. Um varejista pode treinar um modelo de recomendação ou fraude. Em cada caso, o comprador deve perguntar: Qual é a unidade aceita? Quem a revisou? O que o revisor viu? Como os erros são encontrados? O que acontece quando a política muda? Quais exemplos são retidos?
Como sabemos que o modelo melhorou porque os dados melhoraram?
A evidência de cliente da Scale é mais forte quando usada como um mapa de possíveis casos de uso. É mais fraca quando usada como prova de que qualquer comprador específico verá o mesmo resultado. A tarefa do comprador, dados, tolerância ao risco, pool de revisores, ambiente de segurança e processo de lançamento decidem se o resultado viaja.
Isso é especialmente importante porque muitas decisões de aquisição de IA são tomadas sob pressão. Executivos querem adoção visível. Equipes de produto querem se mover rápido. Equipes de modelo querem dados melhores. Equipes de segurança querem controles. Equipes de finanças querem saber se o gasto cria melhoria mensurável do modelo. O denominador da unidade aceita dá a todos eles uma linguagem comum. Ele muda a discussão de "Quem mais usa a Scale?" para "O que exatamente estamos aceitando, e que evidência torna isso aceitável?"
O investimento do Meta tornou a neutralidade uma questão de produto
A estrutura corporativa geralmente fica fora de uma avaliação técnica, mas no caso da Scale, ela se cruza com a confiança do comprador. Em junho de 2025, a Scale anunciou um investimento do Meta avaliando a empresa em mais de US$ 29 bilhões, com Alexandr Wang ingressando no Meta enquanto permanecia no conselho da Scale, Jason Droege se tornando CEO interino e o Meta detendo uma posição minoritária de capital. A Scale disse que permanecia independente e continuaria protegendo os dados dos clientes.
Logo depois, o TechCrunch, citando a Reuters e respostas da empresa, relatou preocupações de que alguns grandes clientes estavam reavaliando relacionamentos após o investimento do Meta.
A questão técnica não é se toda reação de cliente relatada aconteceu exatamente como descrito. A questão do comprador é mais simples: a Scale lida com evidência sensível de desenvolvimento de modelo. Um laboratório de IA, empresa ou cliente governamental pode enviar dados que revelam fraquezas do modelo, direção do produto, falhas de segurança, rubricas de avaliação, padrões privados de instrução, casos extremos específicos de domínio, dados do cliente ou prioridades de lançamento futuro. Mesmo que as proteções contratuais sejam fortes, a percepção de neutralidade importa porque os dados enviados podem ser estrategicamente sensíveis.
A resposta da Scale tem que ser operacional, não retórica. Os compradores devem procurar limites contratuais de uso de dados, controles de acesso, segregação, direitos de auditoria, regras de retenção, localização de armazenamento, política de acesso do revisor, manuseio de subcontratados, procedimentos de exportação, notificação de incidentes, processo de exclusão e compromissos claros em relação a informações competitivas. Eles também devem examinar como a Scale lida com conjuntos de avaliação específicos do cliente.
Se o conjunto de avaliação privado de um comprador é a joia da coroa, não deve ser reutilizado casualmente, exposto a concorrentes ou usado para melhorar um serviço generalizado sem permissão explícita.
Isso não significa que o investimento do Meta torna a Scale inutilizável. Muitos fornecedores empresariais atendem concorrentes enquanto mantêm limites de dados. Provedores de nuvem hospedam rivais. Fornecedores de software analisam dados sensíveis de clientes sob restrições contratuais. Empreiteiros de defesa apoiam múltiplos programas. A questão é se a Scale pode tornar o limite credível o suficiente para compradores cujos dados e avaliações revelam estratégia de modelo.
A lente da unidade aceita ajuda novamente. Para cada unidade, um comprador deve saber quais dados entraram na Scale, quem ou o que os processou, qual modelo ou revisor os viu, onde o resultado foi armazenado, quais metadados foram anexados a ele e se pode ser excluído, exportado ou isolado. Se esse registro é forte, as preocupações com neutralidade corporativa podem ser gerenciadas através de contratos e controles. Se o registro é fraco, a confiança depende de garantias.
Em IA, garantias não são suficientes. Os artefatos são muito valiosos.
A economia é marginal, não mágica
A questão comercial da Scale é se melhores dados e resultados de avaliação excedem os custos de mão de obra de anotação, revisão de especialistas, configuração de segurança, integração, retrabalho, dependência de fornecedor e melhoria marginal do modelo. Essa frase é deliberadamente não romântica porque a qualidade dos dados não cria valor por si só. Ela cria valor apenas quando muda um modelo, produto ou decisão o suficiente para justificar o custo.
O erro mais comum é comparar o preço unitário da Scale com uma taxa horária interna ou com um recurso simplista de avaliação de provedor de modelo. Isso perde toda a pilha de custos. Um comprador paga por design de projeto, redação de taxonomia, seleção de amostra, integração de armazenamento, revisão de segurança, revisão legal, tempo da equipe de modelo, calibração de revisor, design de auditoria, retrabalho, exportação, monitoramento, interpretação de painel e o experimento downstream que prova se as unidades aceitas melhoraram o modelo. Se a melhoria do modelo é pequena, evidência cara ainda pode ser um mau investimento.
O segundo erro é tratar a revisão humana como um custo fixo. A revisão humana se torna mais cara à medida que a tarefa se torna mais ambígua, mais sensível, mais específica do domínio ou mais multilíngue. Um revisor geral pode classificar conteúdo óbvio. Um especialista no domínio pode ser necessário para tarefas médicas, legais, de defesa, rede, código, finanças ou segurança. O posicionamento da Scale em torno de especialistas no assunto no GenAI Data Engine é comercialmente atraente exatamente por essa razão, mas a revisão especializada muda a economia.
O comprador deve medir o custo por unidade aceita revisada por especialista, não apenas o custo por tarefa enviada.
O terceiro erro é ignorar o retrabalho. Retrabalho não são apenas tarefas rejeitadas. Inclui instruções pouco claras, mudanças de taxonomia, retreinamento de revisor, correções de permissão de armazenamento, reconciliação de callback, atualização de conjunto de avaliação, investigação de contaminação, rótulos duplicados, exemplos desatualizados e experimentos de modelo que falham em se beneficiar dos novos dados. Os primitivos de revisão e auditoria da Scale podem descobrir retrabalho se os compradores os instrumentarem. Se não o fizerem, o retrabalho se torna erosão invisível de margem.
A métrica econômica certa é a melhoria marginal do modelo ou produto por unidade aceita. Para dados de treinamento, o comprador deve comparar o comportamento do modelo antes e depois de adicionar exemplos aceitos, preferencialmente por classe de falha. As alucinações caíram para a categoria alvo? A precisão da extração melhorou em documentos difíceis? Um modelo de visão lidou melhor com a condição de borda? Um modelo de política fez menos aprovações inseguras? O modelo melhorou em exemplos retidos que não foram usados para ajustar o processo? Se não, as unidades aceitas podem estar bem formadas, mas estrategicamente de baixo valor.
Para avaliação, a métrica é diferente. Um bom sistema de avaliação pode não melhorar o modelo diretamente. Pode prevenir um lançamento ruim, encontrar uma falha cedo, encurtar o tempo de depuração, revelar regressões de modelo, apoiar governança ou tornar um caso de uso arriscado inaceitável antes que cause dano. Esse valor é real, mas mais difícil de contar. Os compradores devem rastrear incidentes de lançamento evitados, tempo para identificar classe de falha, número de descobertas que bloqueiam lançamento, redução na revisão manual por lançamento, confiança em comparações de modelo e se a avaliação prevê problemas de produção observados.
A proposta de valor da Scale é mais forte onde o comprador tem necessidades repetidas e de alto risco de evidência e nenhum apetite para construir toda a operação de dados sozinho. Desenvolvedores de modelo de fronteira, equipes de IA empresarial e usuários governamentais se encaixam nesse perfil porque precisam de um suprimento constante de exemplos confiáveis, rubricas de avaliação, casos de red-team e artefatos de revisão. A proposta de valor é mais fraca onde a tarefa é simples, única, de baixo risco, facilmente tratada por revisores internos ou não conectada a uma decisão mensurável de modelo.
Fazer menos da tarefa é uma alternativa legítima. Se uma aplicação de modelo não pode ser avaliada bem o suficiente, a resposta pode ser estreitar o produto, manter aprovação humana, evitar automação em um segmento sensível ou adiar a implantação. A Scale compete não apenas com outros fornecedores, mas com a contenção.
O que os compradores devem medir antes de escalar
Um comprador avaliando a Scale deve começar com um plano de aceitação pequeno e representativo. O plano não deve perguntar: "A Scale pode processar nossos dados?" Deve perguntar: "A Scale pode produzir unidades aceitas que mudam uma decisão de modelo ou decisão de lançamento de uma forma que possamos verificar?" Esse plano precisa de um denominador, uma amostra, uma linha de base e uma taxonomia de falha.
Para trabalho de dados, o comprador deve definir o tipo de unidade: rótulo de imagem, extração de documento, classificação de segurança, revisão de resposta de código, julgamento de traço de raciocínio, par de preferência, caso de red-team, resposta fundamentada em recuperação, avaliação de chamada de ferramenta ou correção de especialista. Deve definir os dados de origem, versão da instrução, taxonomia, qualificações do revisor, caminho de escalação e formato de exportação. Deve incluir casos difíceis conhecidos e exemplos onde a resposta correta é intencionalmente ambígua.
Se todo exemplo de teste é fácil, o teste é principalmente teatro de integração.
A primeira métrica é a aceitação na primeira passagem. Quantas unidades enviadas são aceitas sem correção? A segunda é a discordância. Com que frequência os revisores diferem, e em quais categorias? A terceira é o retrabalho. Quantas unidades exigem instruções alteradas, rótulos revisados ou revisão adicional de especialista? A quarta é a completude da proveniência. O comprador pode reconstruir fonte, versão da instrução, caminho de revisor, resultado e destino de exportação para cada unidade aceita? A quinta é o impacto no modelo. Adicionar ou usar a unidade aceita melhora o comportamento alvo em um conjunto retido?
Para trabalho de avaliação, o comprador deve medir estabilidade e capacidade preditiva. Se o mesmo modelo é avaliado duas vezes sob as mesmas condições, quanto a pontuação se move? Se os revisores mudam, o resultado se mantém? Se um juiz automatizado é usado, com que frequência ele concorda com a revisão humana especializada em casos difíceis? A avaliação captura falhas históricas conhecidas? Ela identifica novas falhas que os logs de produção depois confirmam? Ela permanece útil depois que a equipe de modelo viu alguns dos exemplos, ou se torna um alvo de treinamento?
Para segurança e governança de dados, o comprador deve revisar o caminho de armazenamento e resultado antes de enviar qualquer dado sensível. Quais permissões de armazenamento em nuvem são concedidas? Quem pode revogá-las? As URLs de resultado são autenticadas? Onde os traces são armazenados? O que é retido após a exportação? Os endpoints de callback são autenticados e registrados? As chaves de API são separadas por ambiente? As funções de revisor e auditor são limitadas aos dados certos?
Implantações do setor público ou reguladas exigem superfícies autorizadas pelo FedRAMP, ambientes air-gapped, restrições de região ou chaves gerenciadas pelo cliente?
Para confiabilidade, o comprador deve instrumentar o caminho da submissão ao uso downstream. Tarefa enviada não é tarefa aceita. Tarefa aceita não é tarefa consumida pelo processo de treinamento ou avaliação. Treinamento ou avaliação consumido não é melhoria de produto. Cada handoff deve ter reconciliação. Falhas de callback, lotes atrasados, erros de anexo, mudanças de status de auditoria e tarefas rejeitadas devem ser visíveis. Incidentes na página de status devem ter playbooks do lado do comprador: o que pausa, o que tenta novamente, o que recai e quais decisões de lançamento esperam.
Para dependência de fornecedor, o comprador deve projetar um teste de saída. As unidades aceitas podem ser exportadas em um formato útil? A taxonomia pode ser recriada em outro lugar? Os comentários do revisor e estados de auditoria podem viajar? Os conjuntos de avaliação privados são portáteis? As definições de fluxo de trabalho e painéis são substituíveis? O comprador pode executar um processo interno reduzido se a Scale estiver indisponível ou estrategicamente inadequada? O custo de mudança não é uma razão para evitar um fornecedor, mas deve ser conhecido antes que a dependência cresça.
Essas medições não são anti-Scale. São as condições sob as quais a Scale pode provar seu valor. Um comprador que faz esse trabalho pode descobrir que a Scale é significativamente melhor do que operações internas ou ferramentas dispersas. Também pode descobrir que um processo de revisão interno restrito é suficiente. Qualquer resultado é melhor do que comprar volume sem aceitação.
O veredito
A Scale AI é uma das empresas mais importantes na camada de evidência de IA porque a indústria aprendeu que os modelos são limitados pela qualidade dos dados, qualidade da avaliação e a disciplina da revisão. Suas superfícies de produto público mostram maquinário sério: APIs de tarefa e lote, taxonomias, callbacks, auditorias, separação de revisores, linhas de avaliação, painéis, traces, orquestração de fluxo de trabalho, integrações de armazenamento em nuvem, alegações de implantação segura e sinais de autorização do setor público.
Esses são os blocos de construção certos para uma empresa tentando transformar dados incertos em unidades de treinamento e avaliação aceitas.
Os blocos de construção não resolvem a questão. O trabalho duro não é a existência de tarefas. É se a tarefa significa a mesma coisa após milhares de exemplos, vários revisores, mudanças de política, handoffs de armazenamento, iterações de modelo e decisões de lançamento. É se um conjunto de avaliação permanece fresco e não contaminado. É se juízes automatizados ajudam em vez de lavar o viés do modelo em uma pontuação. É se dados privados e lógica de avaliação privada permanecem dentro do limite pretendido pelo comprador. É se a melhoria marginal no comportamento do modelo vale o custo da operação de evidência.
Os sinais de mercado da Scale são fortes. Laboratórios de IA, empresas e compradores do setor público têm razões para querer um sistema externo para trabalho de dados e avaliação. A autorização FedRAMP e as alegações de produto voltadas para defesa tornam a Scale relevante em ambientes onde a confiança do comprador não é opcional. O investimento do Meta e os relatos de reação de clientes tornam a neutralidade e os limites de dados mais importantes, não menos. Histórias de clientes e anúncios de contrato devem aumentar o escrutínio, não substituí-lo.
O melhor argumento para a Scale não é que todo cliente deve terceirizar o trabalho de dados para o maior fornecedor visível. O melhor argumento é que as equipes modernas de IA precisam de uma maneira repetível de fabricar evidência confiável, e a Scale montou muitos dos primitivos de produto necessários para fazê-lo. A melhor crítica é que a qualidade da evidência é local. Ela depende das instruções, revisores, dados, casos extremos, escolhas de segurança e disciplina de lançamento do comprador. Nenhum fornecedor pode tornar um processo de aceitação fraco forte processando-o em escala.
Portanto, a decisão do comprador deve ser concreta. Escolha o comportamento do modelo que importa. Defina a unidade aceita. Execute uma amostra representativa. Meça concordância do revisor, proveniência, retrabalho, risco de contaminação, configuração de segurança e impacto no modelo. Compare a Scale com revisão interna, ferramentas de provedor de modelo, pilhas de avaliação de código aberto e um escopo de produto mais restrito. Depois, escale o processo apenas se a unidade aceita sobreviver.
O verdadeiro produto da Scale AI é a confiança na unidade de dados que uma equipe de modelo está disposta a usar. Essa confiança é cara, frágil e mensurável. É também exatamente onde a próxima fase da competição de IA será decidida.