
Resumo
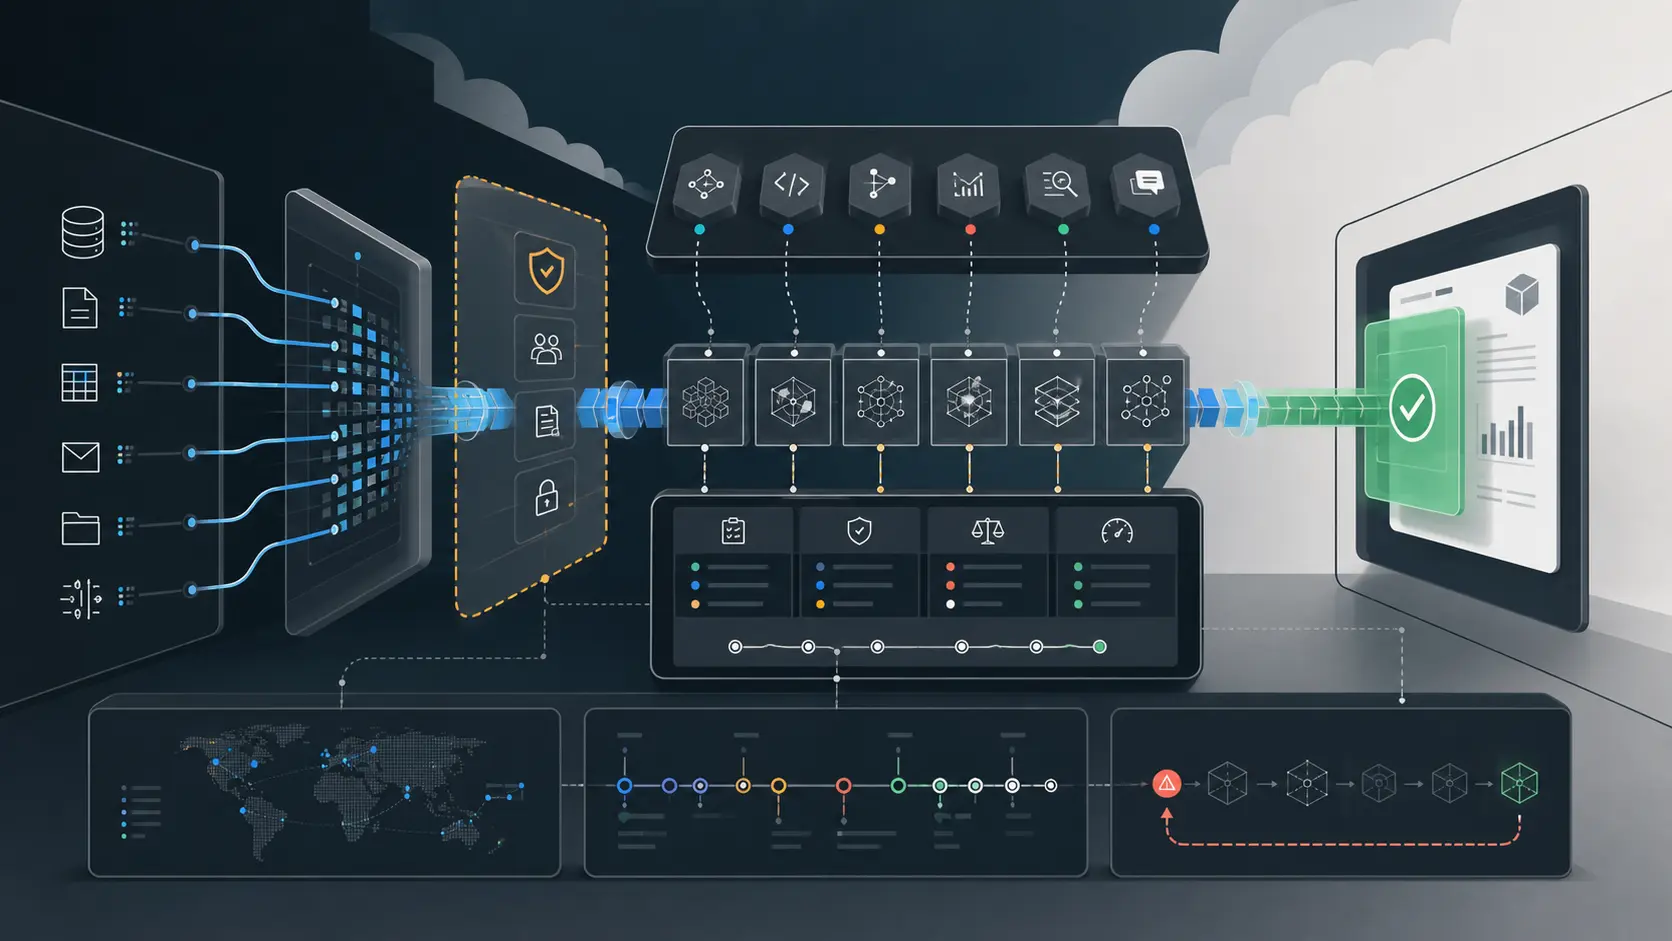
- A proposta de IA empresarial do Google Cloud não se limita mais a uma simples chamada ao modelo Gemini. É uma superfície operacional que combina o Gemini Enterprise Agent Platform, o legado Vertex AI, BigQuery, Agent Search, IAM, Cloud Audit Logs, Cloud Run, Workflows e os controles de capacidade em um fluxo de trabalho governado.
- A saída aceita é o denominador útil. Uma resposta do modelo é apenas uma etapa; a confiabilidade em produção depende da atualidade dos dados, das permissões das ferramentas, dos conjuntos de avaliação, da auditoria de logs, do design de cotas, dos controles de custos, do gerenciamento de exceções e das reversões.
- As evidências públicas confirmam a profundidade dos controles e a demanda pelo Google Cloud, mas não resultados universais para os clientes. Os registros da Alphabet mostram um grande crescimento do Google Cloud e investimentos em infraestrutura, enquanto os incidentes de status e a documentação mostram por que os clientes ainda precisam de supervisão local e design de recuperação.
A saída a ser considerada é o fluxo de trabalho aceito, não a resposta impressionante
A demonstração mais forte da IA do Google Cloud é uma pergunta respondida com uma grande janela de contexto, um resumo baseado em dados, um agente chamando uma ferramenta, ou um desenvolvedor passando rapidamente de uma solicitação em linguagem natural para um código implantado. Essa demonstração importa, mas não é a unidade de produção que o comprador empresarial paga no final.
A unidade que importa é o fluxo de trabalho governado aceito: uma resposta, uma decisão, uma modificação no código, um resultado de dados, uma resposta ao cliente, uma recomendação de segurança ou uma ação interna apoiada por um modelo, que uma empresa está disposta a preservar, auditar e repetir.
Esse denominador muda o julgamento. Um modelo pode produzir uma resposta fluente em segundos e ainda assim falhar no fluxo de trabalho se citar dados empresariais desatualizados, agir sob uma identidade errada, exceder uma cota, mudar silenciosamente o comportamento após uma migração de modelo, não deixar nenhum rastro de auditoria útil, ou criar um efeito colateral que uma equipe não pode desfazer.
A saída aceita inclui todos os esforços necessários para passar da solicitação ao resultado utilizável: preparação de dados, design de acesso, ajuste de pesquisa, avaliação, revisão humana, gerenciamento de exceções, monitoramento, alocação de custos, resposta a incidentes e planejamento de migração.
O Google Cloud está bem adaptado para este teste precisamente porque sua proposta pública agora é mais ampla do que um simples endpoint de modelo. No relatório anual de 2025 da Alphabet, o Google Cloud é descrito como incluindo infraestrutura, plataforma, aplicativos e outros serviços em nuvem, com ofertas de IA como infraestrutura de IA empresarial, Vertex AI e Gemini Enterprise, ao lado de segurança cibernética e análise de dados.
O mesmo documento indica que o Google Cloud gerou US$ 58,705 bilhões em receita em 2025, enquanto o formulário 10-Q do primeiro trimestre de 2026 relata US$ 20,028 bilhões em receita para o Google Cloud no trimestre, um aumento de 63% em relação ao ano anterior. Esta não é uma API de desenvolvedor de nicho. É uma grande empresa de nuvem empresarial que pede aos clientes que transfiram tarefas recorrentes para sua infraestrutura.
A escala eleva o nível de exigência. Se o Google Cloud quer ser o sistema onde funcionários, desenvolvedores, equipes de dados e grupos de operações aceitam o trabalho assistido por IA, os clientes deveriam julgá-lo com base em tarefas comuns repetidas, em vez de momentos de pico. Um analista pode fazer uma pergunta ancorada em uma política interna e obter uma resposta atualizada, correta em termos de permissões e verificável? Um agente desenvolvedor pode propor código enquanto preserva o controle de fontes, evidências de teste e reversão?
Um fluxo de suporte ao cliente ou de segurança pode encaminhar uma recomendação para a pessoa certa com contexto suficiente para aceitá-la ou rejeitá-la? Uma equipe de dados pode saber qual conjunto de dados, qual versão de modelo e qual solicitação do usuário produziu a resposta? Essas são questões de produção. Elas não encontram resposta apenas na capacidade do modelo.
A fronteira jurídica e de marca não é cosmética
A empresa em questão é o Google Cloud, o negócio de nuvem operado pelo Google para serviços de infraestrutura, dados, segurança, colaboração e IA empresarial. Não deve ser confundido com o Google Search, o uso consumidor do Gemini, os anúncios de pesquisa do DeepMind, YouTube, Android, ou cada resultado de parceiro ou cliente envolvendo um modelo do Google. A linguagem setorial específica da Alphabet é importante aqui: Google Cloud inclui Google Cloud Platform e Google Workspace, e os serviços GCP incluem infraestrutura, plataforma, infraestrutura de IA empresarial, Vertex AI, Gemini Enterprise, segurança cibernética e análise de dados.
Este é o limite operacional para este artigo.
A fronteira também protege a análise de um erro fácil. O Google tem pesquisa de modelos de classe mundial, mas um cliente que compra Google Cloud não recebe a garantia direta de que cada avanço de modelo se torna um fluxo de trabalho aceito estável. Os avanços da pesquisa podem melhorar a resposta bruta. O fluxo de trabalho governado ainda depende da superfície do produto em nuvem: funções IAM, disponibilidade regional, configurações padrão de registro, conectores de dados, cotas, avisos de ciclo de vida de modelos, acordos de suporte, SLA, faturamento e gerenciamento de mudanças.
Um resultado de modelo do DeepMind e um resultado de produção do Google Cloud são relacionados, mas não constituem a mesma evidência.
A fronteira também funciona no outro sentido. Quando uma história de cliente indica que a Replit executa Claude no Vertex AI ou que a Fifth Dimension centraliza a inferência do Gemini e do Claude no Vertex AI, a evidência diz respeito em parte ao Google Cloud como um plano de controle multi-modelo gerenciado, não apenas ao Gemini. Essa distinção é comercialmente importante. Os clientes podem escolher o Google Cloud porque ele permite combinar os modelos do Google, modelos parceiros, BigQuery, Cloud Run e controles de segurança em nuvem em uma única arquitetura.
Eles também podem enfrentar custos de mudança porque esses mesmos controles se tornam parte integrante de seu processo de saída aceita.
A questão sobre o produto não é "Gemini é bom?" mas "O Google Cloud pode tornar o trabalho assistido por modelo suficientemente governável para que uma empresa aceite a saída repetidamente uma vez que o custo total seja contabilizado?" A qualidade do Gemini é um elemento de entrada. A superfície de controle da nuvem é o produto.
Google Cloud vende uma superfície de controle
A documentação atual do Google descreve aGemini Enterprise Agent Platformcomo uma plataforma unificada para construir, implantar, governar e otimizar sistemas agentivos de classe empresarial e soluções baseadas em modelos. Avisão geral do ciclo de vidadivide o ciclo de vida em construção, dimensionamento, governança e otimização. Ela menciona Studio low-code, um kit de desenvolvimento de agentes orientado a código, acesso ao Model Garden, um runtime gerenciado, gerenciamento de sessão, o Memory Bank, uma identidade de agente única, Agent Registry, Agent Gateway, avaliação Gen AI, Cloud Observability e Topology.
Esta lista é reveladora. Ela indica que o Google Cloud sabe que a IA empresarial não é simplesmente inferência. A mesma plataforma que hospeda um modelo também deve responder quem ou o que está agindo, qual ferramenta é aprovada, quais dados estão envolvidos, se uma resposta foi avaliada, se a ação é observável e como um runtime é implantado. A comparação útil, portanto, não é apenas OpenAI, Anthropic, Microsoft, AWS ou um modelo open source.
É o fluxo de trabalho existente do cliente: um processo analítico manual, um fluxo SaaS existente, um data warehouse e pilha de BI, uma fila de tickets, uma estrutura de agentes caseira, ou uma decisão de menor risco de automatizar menos.
Os elementos da plataforma pública naturalmente correspondem às questões de produção.Agent Registrycentraliza os componentes de IA aprovados, servidores MCP e endpoints para que o acesso às ferramentas não fique disperso em experiências desconectadas.Agent Gatewayusa metadados de registro, identidade do agente e controles de política enquanto produz telemetria de observabilidade para as interações.Agent Identitydá a um agente uma identidade fortemente atestada baseada em SPIFFE, com a documentação especificando que as identidades não são compartilhadas por várias cargas de trabalho por padrão e não podem gerar chaves de conta de serviço de longa duração.
Esses controles são importantes porque os sistemas agentivos falham de forma diferente dos chatbots. Um chatbot pode errar no texto. Um agente pode errar ao ler dados, invocar uma ferramenta, atualizar um ticket, escrever código, acionar uma implantação ou transmitir uma instrução a outro serviço. A superfície de controle deve preservar a diferença entre uma sugestão e uma ação. Ela também deve manter um registro durável do que aconteceu quando uma premissa errada passa da linguagem para o estado de produção.
A vantagem do Google Cloud é que a maioria dos elementos circundantes já vive em seu domínio de nuvem. IAM, Cloud Audit Logs, BigQuery, Cloud Run, Workflows, Cloud Monitoring, VPC Service Controls e faturamento não são módulos complementares de um projeto amador separado. São primitivas de nuvem estabelecidas que podem ser integradas ao fluxo de trabalho de IA. A fraqueza é a mesma: uma vez que um cliente adota o caminho integrado, a cadeia de saída aceita herda a complexidade, o modelo de custo e os modos de falha de uma plataforma de nuvem.
A ancoragem de dados é o primeiro problema de confiabilidade
A maioria dos trabalhos de IA empresarial falha antes de chegar ao modelo. Os dados estão incompletos, desatualizados, muito permissivos, mal descritos, duplicados, restritos regionalmente ou dispersos entre sistemas SaaS e data warehouses. Um modelo poderoso isoladamente ainda pode produzir uma resposta inaceitável se o sistema de recuperação fornecer a política de ontem, um registro de cliente desatualizado, um arquivo que o usuário não deveria ver, ou uma tabela cujo significado mudou sem linhagem.
O Google Cloud dispõe de matérias-primas críveis para este problema.A ancoragem com Agent Searchpermite que o Gemini se conecte a dados de sites ou documentos através do Agent Search. A página descreve pré-requisitos como permissões IAM, ativação de aplicativos de IA e criação de data stores, e indica que a ancoragem a dados do cliente pode usar até 10 fontes de dados do Agent Search. Apágina do produto Agent Searchseparada posiciona o serviço como um sistema RAG gerenciado para dados empresariais e descreve citações, links, controle de fontes de dados e conectores.
Esta é uma redução significativa no custo de construção. Uma equipe pode evitar montar manualmente cada componente de ingestão, OCR, segmentação, integração, indexação, recuperação e citação. Mas a ancoragem gerenciada não elimina o trabalho de decisão sobre a que a resposta aceita deve ser ancorada. Um número máximo de fontes de dados é um limite a ser contornado. Um conector que lê Jira, SharePoint, Salesforce ou um repositório de documentos ainda depende da atualidade, permissões e semântica desses sistemas.
Se a política oficial e o rascunho da política estiverem ambos no repositório, o modelo pode não saber qual é a autoridade, a menos que a camada de recuperação e instrução carregue essa governança.
BigQuery adiciona uma segunda camada. Suadocumentação sobre governança de dadosdescreve Knowledge Catalog, descoberta de metadados, qualidade de dados, perfil de dados, linhagem, IAM, controles de acesso em nível de linha e coluna, VPC Service Controls, registros de auditoria, mascaramento, criptografia, controles de compartilhamento, clean rooms e métricas de uso. Este é o tipo de controles que uma equipe de dados precisa antes de poder aceitar um resultado apoiado por um modelo vindo de um contexto de data warehouse. Eles também adicionam trabalho. Alguém precisa definir os termos do glossário, proprietários, regras de qualidade, políticas de mascaramento, concessões de acesso, ingestão de linhagem e monitoramento de uso. Esse trabalho pode ser menos caro do que construir uma pilha de governança de dados privada do zero, mas não é gratuito.
A governança de dados é também onde a comparação de custos totais se torna concreta. Um analista manual pode passar horas encontrando documentos, mas sabe qual fonte é a autoridade. Um agente ancorado na nuvem pode responder em segundos, mas exigir semanas de limpeza de permissões e ajuste de repositórios de dados antes que a resposta seja segura o suficiente para ser aceita. A questão não é se o Google Cloud pode recuperar dados. É se o cliente pode manter sua superfície de recuperação precisa e correta em termos de permissões no ritmo das mudanças comerciais ordinárias.
Os compromissos de confidencialidade ajudam, mas a retenção e a geografia ainda exigem design
Os compromissos públicos do Google Cloud dão aos compradores empresariais um ponto de partida mais sólido do que o uso de IA para consumidores. Ostermos específicos do serviçodo Google Cloud indicam que o Google não usará os Dados do Cliente para treinar ou ajustar modelos de IA/ML sem a autorização ou instrução do cliente. Apágina de governança de dados do Agent Searchindica igualmente que os dados do cliente usados no Agent Search não são usados para treinar modelos de base, e que os modelos de base são fixos e processam as entradas para fornecer uma saída para o serviço.
Isso é importante. Responde a uma das primeiras perguntas no nível do conselho: as solicitações de entrada, os documentos recuperados e as saídas da empresa se tornam dados de treinamento dos modelos de outra pessoa? Também ajuda a distinguir a IA empresarial do Google Cloud do uso consumidor menos controlado.
Mas a frase sobre confidencialidade não constitui todo o design de governança. Adocumentação sobre retenção zero de dadosindica que o Google não usa dados do cliente para treinar ou ajustar modelos gerenciados sem autorização, enquanto descreve cenários como monitoramento de abuso e modos de ancoragem onde o comportamento de retenção pode variar e os clientes podem precisar solicitar exceções ou compreender condições distintas. A ancoragem com Google Search e Maps tem sua própria linguagem de retenção. Isso não torna a plataforma insegura. Significa que um cliente deve mapear cada funcionalidade que ativa em relação à classe de dados que está disposto a expor e à região onde pode ser processada.
A questão regional é semelhante. A documentação sobre ancoragem indica que os aplicativos de IA estão disponíveis em multirregiões globais, europeias e americanas. Uma empresa operando sob regras de localidade de dados não pode assumir que cada funcionalidade de IA, modelo, conector, registro e caminho de suporte tem a mesma geografia. A soberania de dados raramente é um único interruptor. É uma cadeia de localização do modelo, localização do repositório de dados, logs, acesso ao suporte, backup, monitoramento, uso de modelos terceiros e acesso de funcionários.
Essa cadeia muda o aprovisionamento. Uma empresa que escolhe entre Google Cloud, outro provedor de nuvem, uma funcionalidade de IA SaaS existente, um modelo open source em seu próprio ambiente ou menos automação deve comparar as evidências do caminho dos dados, não os slogans. O Google Cloud possui muitas das boas primitivas de controle. O comprador ainda precisa provar que o conjunto de funcionalidades selecionado corresponde às suas obrigações de localidade, retenção e auditoria.
As permissões determinam se um agente é útil ou perigoso
A passagem da resposta à ação depende da identidade. Um modelo que só pode resumir é limitado por seu texto. Um agente apoiado por um modelo que pode ler dados privados, chamar APIs, escrever tickets, modificar código, alterar registros de clientes, iniciar workflows ou acionar implantações precisa de um modelo de permissões mais restrito do que o entusiasmo da demo.
A documentação do Google Cloud oferece aos clientes várias primitivas úteis.A documentação IAM da Agent Platformindica que o acesso pode ser gerenciado no nível do projeto ou do recurso, e que papéis personalizados são recomendados quando as equipes precisam limitar o acesso apenas às permissões necessárias.Agent Identityfaz do próprio agente um principal, em vez de esconder cada ação atrás de uma única conta de serviço compartilhada.Agent Gatewayusa identidade e metadados de registro para decisões de autorização e aplicação de políticas.
Esses controles só são úteis se o cliente os usar com disciplina. O caminho de menor resistência em qualquer plataforma é acesso amplo durante o piloto: uma conta de serviço, uma função permissiva, muitas ferramentas e uma promessa de restringir depois. Isso pode ser aceitável para um sandbox. É o modelo errado para um fluxo de trabalho aceito. Um fluxo de trabalho governado exige identidades distintas para classes de ação distintas, permissões de fonte de dados que seguem o usuário ou a tarefa, escopos de ferramentas que correspondem ao raio de dano máximo aceitável, e logs que identificam o agente, o usuário e o alvo.
O design também deve distinguir leitura, proposta e execução. Um agente que lê uma política e redige uma resposta não deve automaticamente ter permissão para enviar a resposta. Um agente que recomenda uma modificação de código não deve automaticamente mesclá-la. Um agente que classifica um problema do cliente não deve automaticamente modificar o registro da conta, a menos que a ação tenha uma regra de aprovação, uma verificação de pós-condição e um caminho de recuperação. O objetivo da confiabilidade do fluxo de trabalho de IA não é impedir cada ação da máquina. É tornar a autoridade de cada ação legível e limitada.
É aí que o domínio integrado do Google Cloud pode ajudar. Cloud IAM, contas de serviço, políticas em nível de recurso, VPC Service Controls e registros de auditoria são familiares para as equipes de segurança em nuvem. Mas o objeto de governança mudou. O principal agora pode ser um agente, os dados podem ser um contexto de recuperação em vez de uma consulta direta ao banco de dados, e a saída pode se tornar uma ação comercial. As equipes de segurança devem tratar as permissões dos agentes como privilégios de produção, não como configurações de redação de consultas.
A avaliação é uma funcionalidade, não um substituto para o julgamento
O Google Cloud merece elogios por tornar a avaliação parte da história da plataforma. Avisão geral do serviço de avaliação Gen AIindica que ele suporta avaliação objetiva, baseada em dados, de modelos de IA generativa e casos de uso como migração de modelos, mudanças na formulação de consultas e ajuste fino. Ele descreve rubricas adaptativas como testes de aprovação/reprovação personalizados para consultas individuais, semelhantes a testes unitários no desenvolvimento de software. Adocumentação sobre avaliação de agentesestende a ideia à capacidade de um agente realizar tarefas e alcançar objetivos.
Esta é a direção certa. As empresas devem parar de tratar a avaliação de IA como uma competição pontual entre fornecedores. Um fluxo de trabalho governado exige testes recorrentes para a saída aceita: a resposta usou a fonte aprovada, respeitou os limites de função, incluiu evidências suficientes, recusou quando os dados faltam, concluiu a chamada de ferramenta, evitou formatação perigosa downstream, cumpriu os objetivos de latência e custo, e preservou um caminho de recuperação?
Mas as ferramentas de avaliação não criam o conjunto de verdade. O cliente ainda precisa definir o que é uma boa resposta, coletar casos representativos, rotular casos limite, decidir os limites de aprovação/reprovação, incluir exemplos negativos, testar injeção de instruções, testar dados desatualizados, testar discordâncias de permissões e atualizar o conjunto quando a empresa muda. Se uma empresa nunca escreveu como um humano decide se um resumo de risco de fornecedor é aceitável, um serviço de avaliação de modelo não pode deduzir toda a política. Ele pode operacionalizar o teste uma vez que a organização forneceu o padrão.
O custo da avaliação também aumenta com a ambição. Um fluxo de resumo simples pode exigir um pequeno conjunto de exemplos e verificações manuais pontuais. Um agente governado que escreve código, lê um data warehouse, contacta um cliente ou atualiza um registro de conformidade exige testes mais aprofundados. Ele precisa de pós-condições específicas da ação, testes de regressão em versões de modelos, instruções conflitantes, orçamentos de custo e latência, e revisão humana em casos incertos. Quanto mais valioso o fluxo de trabalho, mais caras as evidências de aceitação.
Esse custo muitas vezes vale a pena ser pago. A revisão manual sem avaliação escala mal e perde a deriva. Uma ferramenta SaaS existente pode esconder o comportamento de seu próprio modelo. Uma pilha interna pode criar ainda mais carga de avaliação porque cada componente é montado localmente. O serviço de avaliação do Google Cloud pode reduzir o trabalho de infraestrutura. Ele não remove o trabalho organizacional de decidir o que é aceitável.
Os logs de auditoria transformam uma caixa preta em um registro, mas apenas se ativados e lidos
A auditabilidade é uma das vantagens mais claras do Google Cloud em relação a uma simples chamada a um modelo autônomo.A documentação de registro de auditoria da Agent Platformindica que os serviços do Google Cloud escrevem logs de auditoria para ajudar a responder quem fez o quê, onde e quando. Os logs de atividade do administrador não podem ser desativados. Os logs de eventos do sistema identificam ações automatizadas do Google Cloud que modificam recursos e também não podem ser desativados. Os logs de acesso a dados incluem leituras e gravações de dados fornecidos pelo usuário, mas a documentação indica que eles devem ser explicitamente ativados.
A página separada sobreativação de logs de auditoria de acesso a dadosé fácil de perder e muito importante. Ela indica que os clientes devem ativar esses logs para obter logs de auditoria sobre o uso de endpoints de modelo, e que a visualização do fluxodata_accessrequer o Private Logs Viewer. Avisão geral do Cloud Audit Logsgeral acrescenta que os logs de acesso a dados fora do BigQuery estão desativados por padrão porque podem ser volumosos e incorrer em custos.
Este é um compromisso prático de governança. O registro completo cria evidências, mas também custos, questões de retenção, questões de controle de acesso e trabalho de revisão. Se uma equipe não ativar os logs corretos, pode não ser capaz de reconstruir qual consulta, qual endpoint, qual fonte de dados, qual identidade ou qual chamada de ferramenta levou a uma saída aceita. Se ativar tudo sem disciplina de roteamento e retenção, pode gerar logs sensíveis de grande volume que poucas pessoas inspecionam. A auditabilidade não é uma caixa de seleção. É um produto de dados.
Para um fluxo de trabalho de IA aceito, o registro mínimo deve incluir o usuário ou serviço que solicitou o trabalho, a identidade do agente, o modelo e a versão, as fontes de recuperação, as chamadas de ferramentas, as decisões de autorização, o resultado da avaliação ou etapa de revisão, a saída final aceita e qualquer ação downstream. O Google Cloud documenta vários elementos desta cadeia, mas o registro de ponta a ponta atravessa fronteiras de produtos.
Um cliente pode precisar de Cloud Logging, logs de aplicação, metadados de tarefa do BigQuery, telemetria do Agent Gateway, registros de controle de fonte, histórico de tickets e trilhas de auditoria de sistemas de negócio.
A implicação comercial é simples: as economias que ignoram a revisão de auditoria são superestimadas. Se um modelo economiza 20 minutos de redação, mas exige 10 minutos de inspeção de evidências, o ganho de saída aceita não é de 20 minutos. Se o registro evita um erro custoso, a economia ainda pode ser excelente. A contabilidade deve incluir o trabalho de revisão.
A deriva de versões é um custo de confiabilidade
Os sistemas de IA mudam com mais frequência do que os fluxos de trabalho empresariais tradicionais. Os modelos são retirados, os endpoints tornam-se obsoletos, os filtros de segurança mudam, as janelas de contexto aumentam, os perfis de latência evoluem, os preços mudam e os modelos parceiros aparecem ou desaparecem. A página deversões e ciclo de vida de modelosdo Google Cloud existe porque esta é uma preocupação operacional real. Ela define os termos do ciclo de vida para modelos Gemini e de integração, fornece datas, recomenda atualizações e indica caminhos de migração. As notas de versão documentam atualizações de produção, funcionalidades, problemas conhecidos e funcionalidades obsoletas.
A questão operacional não é se a mudança ocorre. É se a mudança é visível antes de quebrar o trabalho aceito. Uma migração de modelo que melhora o raciocínio geral pode ainda assim alterar o tom, o comportamento de recusa, o esquema de saída, o estilo de citação, o custo de tokens ou a frequência de chamadas de ferramentas. Uma mudança na ancoragem pode melhorar a recuperação para um corpus e degradar para outro. Uma atualização do filtro de segurança pode bloquear uma tarefa legítima de segurança interna. Um aviso de obsolescência pode forçar uma migração durante um trimestre movimentado.
O Google Cloud pode ajudar publicando informações sobre o ciclo de vida e ferramentas de avaliação. Os clientes ainda precisam de disciplina de migração. Cada fluxo de trabalho aceito deve ter um caminho de modelo bloqueado ou declarado quando possível, uma suíte de regressão, um conjunto de dados representativo, uma janela de mudança, uma opção de reversão ou fallback, e um proprietário que monitore as notas de versão. Se o fluxo de trabalho usar um modelo parceiro através do Vertex AI, o cliente também depende do ciclo de vida e dos termos desse modelo parceiro.
A escolha multi-modelo reduz a dependência de um único modelo, mas pode aumentar o trabalho de teste.
Esta é uma das razões pelas quais o denominador de saída aceita é útil. Uma única chamada de modelo pode parecer barata. Um fluxo de trabalho governado inclui migrações futuras. Se o cliente não pode arcar com o teste de mudanças de modelo, não deve automatizar profundamente um trabalho de alto impacto. Se o fluxo de trabalho é valioso o suficiente, a avaliação recorrente e o planejamento de migração fazem parte do custo real do produto.
Capacidade e incidentes tornam a confiabilidade uma escolha de design
O Google Cloud tem a escala de infraestrutura para servir IA empresarial, mas os clientes não devem confundir escala com capacidade infinita. O relatório 10-Q do primeiro trimestre de 2026 da Alphabet relata US$ 462,3 bilhões em obrigações de desempenho restantes relacionadas ao Google Cloud e investimentos significativos em infraestrutura técnica. Indica também que as despesas de capital do primeiro trimestre de 2026 foram de US$ 35,7 bilhões e que a Alphabet esperava aumentar os investimentos em infraestrutura técnica em relação a 2025. Esta escala sinaliza demanda e compromisso. Também mostra que a capacidade de IA é intensiva em capital.
No nível do produto, o Google Cloud expõe vários conceitos de consumo e capacidade. Avisão geral de throughput provisionadodescreve uma assinatura de custo fixo e duração determinada que reserva throughput para modelos de IA generativa suportados, por modelo e localização. Ela recomenda considerar esta opção para aplicações de produção em tempo real, cargas de trabalho críticas com throughput consistentemente alto, experiência do usuário previsível e custos determinísticos. Adocumentação sobre cotaslista limites regionais e por modelo, cotas do Agent Runtime, cotas de avaliação e comportamento de lote. Ela observa que a inferência em lote do Gemini usa um pool compartilhado e pode enfileirar o trabalho sob pressão de capacidade.
Esses detalhes não são anedotas para compras. Eles determinam se um fluxo de trabalho é confiável. Um agente de suporte ao cliente usado por alguns funcionários internos pode tolerar variabilidade PayGo mais facilmente do que um sistema de reclamações voltado ao cliente durante um pico de volume. Um lote de avaliação noturno pode ser enfileirado se o resultado for necessário no dia seguinte, mas não se condicionar uma implantação dentro de uma hora. Um fluxo de trabalho com um objetivo de latência estrito pode exigir throughput provisionado ou um caminho de fallback.
O custo determinístico pode contar tanto quanto a latência determinística porque o trabalho assistido por modelo pode criar custos de tokens, recuperação, registro e revisão difíceis de prever durante um piloto.
Os incidentes de status fazem a mesma constatação. Em 27 de fevereiro de 2026, o Google Cloud relatou umincidente na API Vertex AI Geminique durou 1 hora e 58 minutos e afetou o endpoint global e as regiões americanas. A causa raiz relatada foi uma mudança de configuração de um serviço de filtragem de segurança que suporta os modelos Gemini, resultando em erros de sobrecarga; a remediação incluiu reversão, adição de capacidade, fortalecimento dos pontos de verificação de validação e melhoria dos alertas. Em 18 de julho de 2025, umincidente multi-produto us-east1afetou produtos como Cloud Run, Cloud Workflows, BigQuery, IAM, Cloud Monitoring, Vertex AI Online Prediction e VPC após um problema de hardware de workflow/plano de controle.
Esses incidentes não provam que o Google Cloud é excepcionalmente não confiável. Eles provam que os fluxos de trabalho de IA governados dependem de serviços compartilhados: APIs de modelos, filtros de segurança, regiões, redes, IAM, monitoramento, orquestração e plataformas de dados. Um fluxo de trabalho resiliente precisa de uma regra para dados desatualizados, uma regra de nova tentativa, um modelo ou fila de fallback, uma mensagem de modo degradado, uma rota manual para trabalhos urgentes e uma forma de distinguir uma falha de plataforma de uma falha de modelo. O modelo pode ser capaz enquanto o endpoint está limitado em throughput.
Os dados podem estar corretos enquanto o motor de workflow está inativo. O agente pode estar saudável enquanto os caminhos IAM ou rede estão comprometidos.
A confiabilidade é, portanto, em parte uma característica do produto e em parte uma escolha de arquitetura. O Google Cloud oferece SLAs e opções de capacidade. Ainda é o cliente quem decide quais tarefas merecem throughput reservado, design multirregional, retorno manual ou menos automação.
A reversão é mais fácil para o cálculo do que para o estado de negócio aceito
O Google Cloud possui controles de implantação maduros para infraestrutura de software.Cloud Runpermite que as equipes dividam o tráfego, implantem gradualmente uma revisão e voltem a uma revisão anterior. A documentação também alerta que as mudanças de tráfego não são instantâneas e que as requisições em andamento continuam durante a transição.Workflowssuporta estruturas de try, nova tentativa e tratamento de exceções.
Estes são controles úteis para aplicações de IA. Uma equipe pode implantar um novo serviço de agente em uma pequena porcentagem do tráfego, monitorar erros e reverter o contêiner se ele se comportar mal. Pode interceptar falhas HTTP transitórias, tentar novamente algumas chamadas e bifurcar para um caminho de exceção. Pode encaminhar um fluxo de trabalho com falha para um ticket em vez de fingir que a ação está concluída.
Mas a reversão de negócio é mais difícil do que a reversão de infraestrutura. Se um agente redige uma resposta e um humano não a enviou, a reversão é simples: descartar o rascunho. Se um agente atualiza um campo de CRM, submete um formulário de conformidade, modifica uma política, envia uma mensagem, aprova um reembolso, abre um ticket de suporte ou mescla código, o efeito colateral vive fora do endpoint do modelo. Reverter uma revisão do Cloud Run não retira a mensagem nem restaura o antigo entendimento do cliente. Uma nova tentativa pode piorar uma falha temporária se a ação downstream não for idempotente.
É aí que o teste de saída aceita se torna rigoroso. Cada classe de ação precisa de uma pós-condição e um caminho de recuperação. Um fluxo de modificação de código precisa de evidências de controle de fonte, testes, reversão de implantação e propriedade de problemas. Um fluxo de resultado de dados precisa de linhagem da consulta, versão do conjunto de dados, verificações de qualidade de dados e procedimentos de correção. Um fluxo de ação do cliente precisa de limites de aprovação e uma forma de informar o cliente se uma resposta aceita posteriormente se revelar errada.
Um fluxo de segurança ou operações precisa de uma exceção humana e um caminho para remover um falso bloqueio.
O Google Cloud pode fornecer muitos controles de baixo nível, mas não pode definir a lógica de reversão de negócio do cliente. Uma plataforma pode permitir que um cliente implemente a nova tentativa; ela não pode saber se tentar novamente a ação é seguro. Uma plataforma pode registrar a requisição; ela não pode garantir que o sistema downstream atingiu o estado esperado a menos que o workflow verifique o destino. A carga se desloca para o design.
As histórias de clientes mostram adoção, não uma resposta universal
As histórias de clientes do Google Cloud são sinais de mercado úteis porque mostram os tipos de fluxos de trabalho que os compradores estão tentando. Elas não devem ser lidas como benchmarks independentes.
FletcherTechrelatou ter implantado o Gemini Enterprise em seus dados centrais em três semanas, fornecendo 31.778 respostas a 222 funcionários ao longo de três meses e economizando mais de 2.500 horas. A história cita conectores de dados, Jira, ServiceNow, SharePoint, assistentes de IA personalizados e um projeto dedicado do Google Cloud para governança de recursos, acesso e custos. Isso está próximo do tema da saída aceita: o valor não é apenas o assistente, mas a integração nos sistemas e controles diários.
Fifth Dimensionrelatou usar o Vertex AI para centralizar a inferência do Gemini e do Claude para fluxos de trabalho de imóveis comerciais ricos em documentos, com Cloud SQL, Cloud Storage, Cloud Run e BigQuery na pilha. A história descreve fluxos de trabalho de longa duração e um objetivo de confiabilidade relatado de 99,9%. É um exemplo útil do Google Cloud como plataforma de workflow multi-modelo, em vez de um ambiente exclusivo do Gemini.
Replitrelatou usar Claude no Vertex AI, Gemini, Cloud Run, Compute Engine, Cloud SQL e BigQuery para apoiar a criação e implantação de software assistida por IA. A história indica que a Replit suporta mais de 35 milhões de desenvolvedores e mais de 100.000 aplicações através do Cloud Run. Novamente, a lição é arquitetural: o agente está conectado à implantação, aos dados e à infraestrutura.
Os limites são igualmente importantes. Essas histórias não divulgam as taxas de exceção completas, as saídas falsamente aceitas, os minutos de revisão humana, o tempo de reversão, o trabalho de migração, as consultas com falha, o custo de limpeza de dados ou o que aconteceu quando um endpoint degradou. Elas não são inúteis porque são promocionais; são úteis se lidas como evidências de adoção. Mostram que os clientes estão transferindo trabalho real para as superfícies de IA do Google Cloud. Não provam que toda empresa economizará dinheiro após os custos de supervisão e integração.
O caso comercial depende da redução do trabalho total
O caso comercial do Google Cloud é mais forte quando a tarefa é repetida, rica em evidências, limitada por permissões e suficientemente cara para que melhores ferramentas superem o trabalho manual. Bons candidatos incluem respostas a conhecimento interno ancoradas em fontes aprovadas, primeiros rascunhos de modificações de código com teste e revisão, extração de dados ricos em documentos, triagem de suporte, enriquecimento de segurança, análise governada e roteamento de workflow onde uma saída aceita pode ser verificada antes de mudar o mundo exterior.
O caso se enfraquece quando a tarefa é rara, ambígua, de alta responsabilidade, mal documentada, dispersa por sistemas inacessíveis, ou dependente de julgamento humano tácito. Nesses casos, o modelo ainda pode ajudar na redação ou pesquisa, mas o fluxo de trabalho aceito permanece principalmente humano. Fazer menos automação pode ser racional. Uma empresa não precisa de um agente autônomo para uma tarefa que ocorre duas vezes por mês e tem consequências graves em caso de erro.
O conjunto de alternativas é amplo. O trabalho manual tem baixa dependência de plataforma, mas alto custo de mão de obra e evidências inconsistentes. A IA SaaS existente pode ter melhor integração de domínio, mas governança intersistema ou escolha de modelo mais fraca. Outro provedor de nuvem/modelo pode oferecer melhor desempenho de modelo ou melhor adequação ao ecossistema, mas exigir integração de dados e identidade diferente. O open source pode reduzir o aprisionamento proprietário e melhorar o controle, ao mesmo tempo que aumenta o trabalho de hospedagem, segurança, avaliação e operações.
Uma pilha interna pode ser adaptada, mas exige engenharia de plataforma rara. O argumento do Google Cloud é que sua superfície integrada de IA, dados, identidade, implantação e registro reduz o custo do caminho do meio.
Os custos de mudança devem ser contabilizados desde o início. Se um cliente constrói repositórios de dados, suítes de avaliação, funções IAM, serviços Cloud Run, Workflows, linhagem do BigQuery, caminhos de auditoria, dashboards e processos de suporte em torno do Google Cloud, ele ganha consistência, mas perde portabilidade. Um modelo concorrente pode ser chamado através do Vertex AI ou de um fornecedor distinto, mas o sistema de saída aceita é mais do que um modelo. Inclui logs, permissões, avaliadores, contratos de dados e esquemas de implantação.
Isso não é uma razão para evitar o Google Cloud. É uma razão para projetar caminhos de saída. Armazene conjuntos de dados de avaliação em formatos portáveis. Mantenha as regras de negócio fora das instruções livres sempre que possível. Separe os adaptadores de modelo da lógica de workflow. Acompanhe documentos fonte e esquemas de saída. Torne os registros de auditoria legíveis fora de um único console. O melhor resultado para o cliente não é um aprisionamento zero; é modularidade suficiente para que o Google Cloud mereça a carga de trabalho reduzindo o trabalho, não prendendo o processo.
O que um comprador sério deve perguntar
A pergunta de compra deve ser formulada como um teste operacional. Para uma tarefa repetida, qual é a saída aceita, quem a aceita, que evidência é necessária, que dados podem ser usados, que ação pode seguir e o que acontece quando está errada? Esta declaração deve preceder a decisão de plataforma.
Para o Google Cloud em particular, um comprador deve perguntar se o fluxo de trabalho precisa da experiência de assistente voltada ao funcionário do Gemini Enterprise, da superfície de construção e governança da Agent Platform, da ancoragem do Agent Search, da governança do BigQuery, da implantação do Cloud Run, da orquestração do Workflows, ou de tudo isso. Comprar todas as peças sem definição de tarefa cria um programa de plataforma, não um fluxo de trabalho confiável. Comprar muito pouco cria uma demo de modelo que não pode ser governada.
O comprador também deve perguntar quais logs de acesso a dados serão ativados, quem pode consultá-los, onde são mantidos e qual processo de revisão transforma os logs em supervisão. Deve decidir quais ações exigem aprovação humana, quais podem ser executadas automaticamente e quais nunca devem ser delegadas. Deve especificar um plano de migração de modelo antes que a primeira mudança de versão de modelo ocorra. Deve definir regras de cota e throughput antes que um piloto bem-sucedido se torne um produto movimentado. Deve escrever um plano de fallback para erros de endpoint e recuperação de dados desatualizados.
Deve testar injeção de instruções e manipulação insegura de saídas porque a lista de riscos LLM da OWASP não é teórica para sistemas que transmitem a saída do modelo para ferramentas.
Finalmente, o comprador deve manter visível o denominador humano. Quantas saídas aceitas são esperadas por semana? Quantas são rejeitadas? Quanto tempo leva a revisão? Com que frequência o agente pede esclarecimentos? Quantas saídas requerem correção após aceitação? Com que frequência os proprietários de dados atualizam o corpus? Quantas horas de engenharia são dedicadas à migração de modelos e registro? Se esses números não forem coletados, a organização medirá entusiasmo em vez de produtividade.
O Google Cloud oferece às empresas uma superfície de controle séria para fluxos de trabalho de IA governados. Ele tem os modelos, o domínio de dados, a maquinaria de identidade, a camada de implantação, os logs, o serviço de avaliação e a escala comercial. O teste não resolvido é se os clientes podem usar esses elementos para reduzir o trabalho total uma vez que a supervisão é contabilizada. O vencedor não é a plataforma que responde mais rápido em uma demo. É aquela cujas saídas aceitas permanecem úteis, explicáveis, corretas em termos de permissões e recuperáveis após a centésima execução ordinária.