
概要
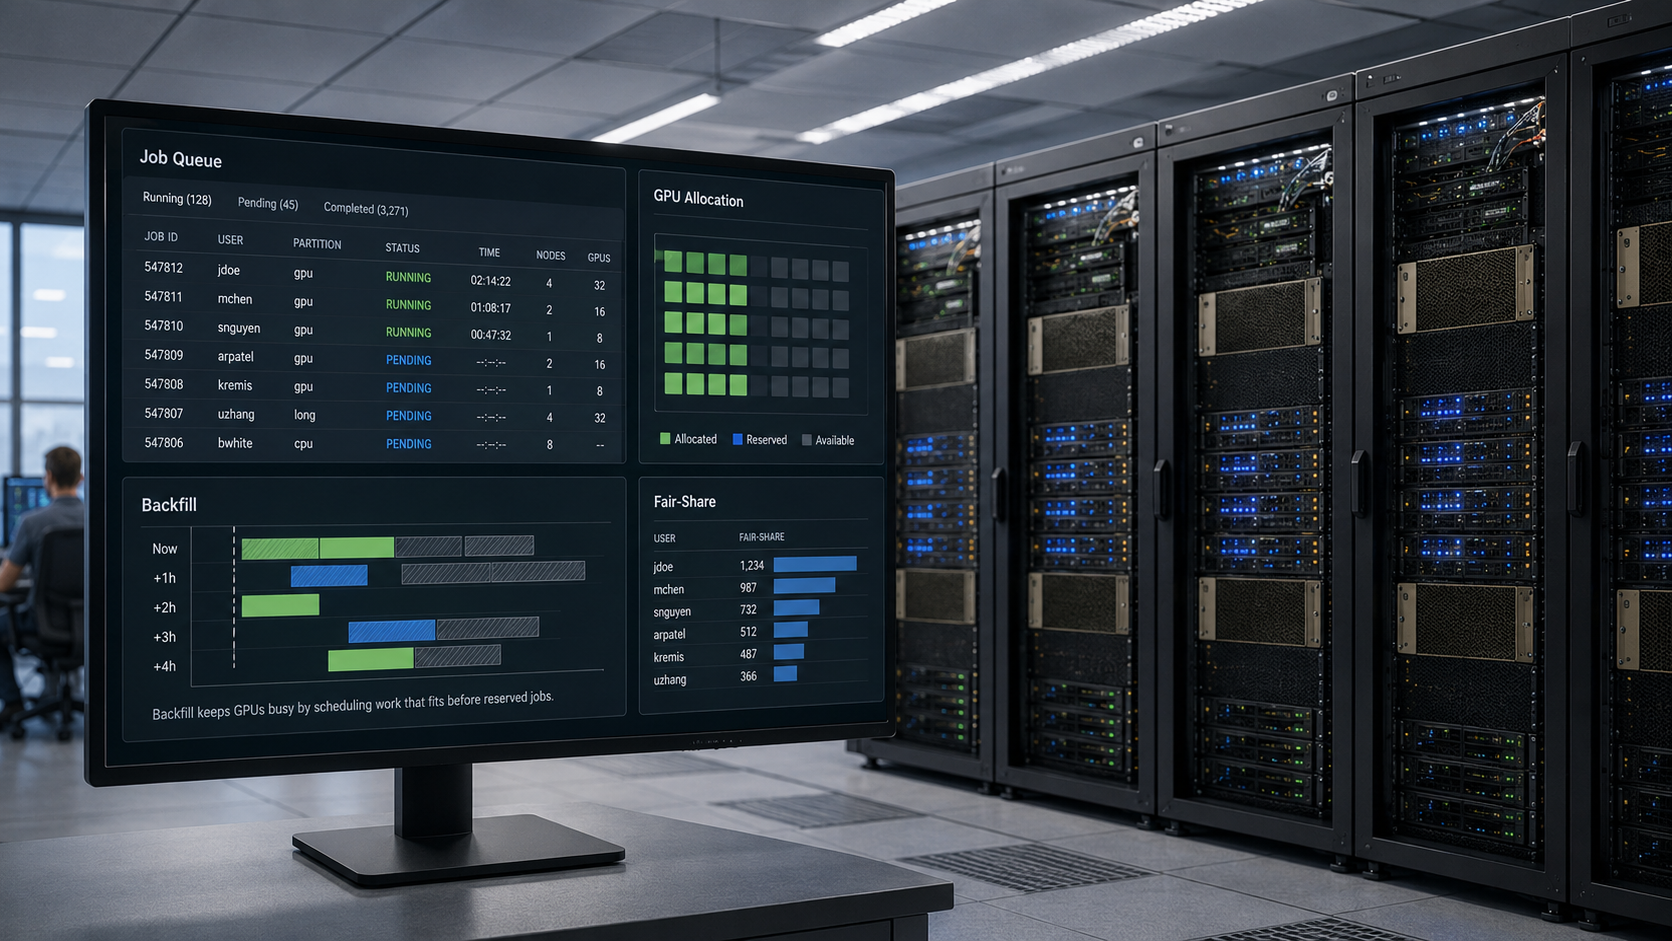
- Slurm は、ノード、CPU、メモリ、GPU、その他のリソースを割り当て、パーティション、優先順位、QOS ルール、フェアシェア、リザベーションをキューの決定に変換する。
- TRES、GRES、トポロジー、cgroups により、運用者はアクセラレータを制約付きの物理リソースとしてスケジュールできる。GPU の数だけでは、有用な配置や効率的な実行は保証されない。
- Slurm の開発者は、商用のエンジニアリング、サポート、トレーニングを提供するために 2010 年に SchedMD を設立した。NVIDIA は 2025 年 12 月 15 日に同社を買収し、オープンソースでベンダー中立な開発を継続すると表明した。
- 買収後の信頼性は、マルチベンダーでのテスト、リリースの挙動、コントリビューションのパターンにかかっている。一方で、各クラスタ運用者は、自社のユーザーが実際に体験するポリシーに対して説明責任を負い続ける。
アイドル状態の GPU は、必ずしも利用可能な GPU ではない
Slurm クラスタでは、物理的にアイドル状態のアクセラレータが、次に要求した人に自動的に割り当てられるわけではない。ジョブはまず、パーティションに適合し、要求されたリソース形状に合致し、アカウントと QOS ルールを満たし、必要なノードをブロックするリザベーションを回避し、競合するジョブより優先されなければならない。そうして初めて、スケジューラはリソースを割り当て、ジョブの開始を許可する。
この一連の流れにより、Slurm は単なるキュー以上のものになっている。Slurm は、高性能コンピューティング(HPC)および AI システムの広い範囲にとっての、受け入れと割り当てを担うコントロールプレーンなのである。ユーザーはジョブを投入し、slurmctldはそれをクラスタの状態とポリシーに照らして評価し、計算ノード上のslurmdプロセスがジョブを起動・監視し、slurmstepdが個々のジョブステップを管理する。オプションのslurmdbdサービスは、ジョブ、リソース使用量、アカウントの関係をデータベースに記録する。
その結果は、技術的なだけでなく経済的な意味も持つ。AI クラスタは、GPU を全体としては十分に保有していても、空きデバイスが不適切なノードに散在していたり、不適切なトポロジーの背後にあったり、別のプロジェクト用にリザーブされていたりするために、大規模なトレーニングジョブを開始できないことがある。スケジューラは、関連する制約を表現することで、そのような無駄を減らせる。しかし、不足している GPU を作り出したり、輻輳したファブリックを修復したり、非効率なアプリケーションを有用にしたりすることはできない。
したがって Slurm の重要性は、アプリケーションが実行される前に下される判断にある。このプロジェクトは 20 年以上をかけて、「今、誰がどのマシンを使えるのか」という単純な問いを、ますます多様化し高価になるインフラを割り当てるための設定可能なシステムへと発展させてきた。
Slurm はローカルのポリシーをマシン時間に変える
Slurm はローレンス・リバモア国立研究所が主導する協力プロジェクトとして始まり、2002 年に初めて登場した。初期の役割は、すべてのアプリケーションがマシン全体を理解することを要求せずに、大規模な Linux クラスタ全体で独立に投入された並列ジョブを調整することだった。当初のアーキテクチャは、リソース割り当てとジョブ実行を分離し、各機関で適応できる共通の制御層を提供した。
この基本的な分離は今も見て取れる。コントローラはノード、ジョブ、スケジューリング状態の中央ビューを維持し、計算ノードのデーモンはすでに承認されたジョブを実行する。バックアップコントローラと永続化された状態は、コントローラの停止による影響を軽減できるが、高可用性は依然として、首尾一貫した状態、機能する認証、ネットワーク到達性、テスト済みの復旧手順にかかっている。「フォールトトレラント」は設計上の能力であり、すべてのコントロールプレーン障害が無害であるという保証ではない。
より深い変化は、Slurm がポリシーのプリミティブを蓄積するにつれて生じた。パーティションはノードをサービス区分または管理上のプールにグループ化する。アソシエーションはユーザーとアカウントをシェア、制限、過去の使用量に結び付ける。QOS ルールは優先順位、制限、プリエンプション(先取り)の動作を変更できる。リザベーションはメンテナンス、イベント、指名されたユーザーのためにリソースを確保する。多要素優先度は、経過時間、フェアシェア、ジョブサイズ、パーティション、QOS、サイト定義の要素を組み合わせることができる。
公平性についての普遍的な Slurm の定義は存在しない。ある大学は、長期割り当てを使い切っていないプロジェクトを優遇するかもしれない。国立研究所は、あるキャンペーンのために容量をリザーブするかもしれない。商用の GPU 運用者は、差別化されたサービス層を設けるかもしれない。同じソフトウェアがこの 3 つすべてを表現できるのは、ポリシーを定義するのがサイトだからである。
この柔軟性は、Slurm の強みの一つであり、運用上のリスクの一つでもある。パーティションが重複し、例外が蓄積し、複数の重み付けシステムが相互作用すると、キューは説明が難しいものになりうる。ソフトウェアが設定を正確に実装している場合でも、ユーザーはその結果を恣意的だと感じる。スケジューラは優先度を計算できるが、ポリシーを正当化するのは依然として機関の役割である。
フェアシェアが決めるのは誰が待つかであり、公平性の意味ではない
フェアシェアは、まるでスケジューラの客観的な特性であるかのように語られることが多い。実際には、機関の割り当て方針を時間を超えて引き継ぐためのメカニズムである。過去の使用量、アカウント階層、設定されたシェアは将来の優先度に影響を与え、割り当て分をあまり消費していないグループが、多く消費したグループよりも有利になるようにできる。
そのため、アカウンティング(利用記録)はガバナンスの一部となる。slurmdbdは、1 つまたは複数のクラスタにわたって、ジョブ、ステップ、アソシエーション、追跡可能なリソースを記録できる。管理者はこれらの記録をレポート、チャージバック(費用配賦)、利用制限、フェアシェア計算に使用する。管理的に見えるデータベースのフィールドが、研究者やエンジニアリングチームが次に希少な計算リソースを獲得する時期に影響を与えうるのである。
台帳の品質は重要である。ユーザーが誤ったアカウントにマッピングされていたり、リソース使用量が一貫して記録されていなかったり、履歴データが誤って保持されていたりすると、結果として得られる優先度は技術的に有効でありながら、機関として見れば間違ったものになりうる。プロジェクトメンバーシップの変更、共有サービスアカウント、手動で修正された記録はすべて、スケジューラがそれらを権利の証拠として扱う可能性があるため、ガバナンスが必要である。
これは、キューの紛争をソフトウェアのバグに単純化できない理由の一つである。長い待ち時間は、需要、不正確なウォールタイムの要求、リザベーション、低いフェアシェア係数、トポロジーの要件、QOS ルール、あるいは単に現在の空きリソースに収まらないジョブによって引き起こされうる。Slurm はメカニズムを公開しているが、運用者は、どれが原因だったかを再構成できるだけの可観測性を必要とする。
したがってユーザーにとって、説明可能性はサービス品質の一部である。ジョブがなぜ保留中なのか、どのポリシーが適用されるのか、何があれば開始できるのかが見えれば、キューは受け入れやすくなる。クラスタがより高価になり、商業的に重要になるにつれて、その透明性は研究者向けの利便性ではなく、経営上の課題になる。
バックフィルは空きの隙間を有用な仕事に変える
厳格な優先度キューは容量を無駄にしうる。大規模で優先度の高いジョブが先頭に並んでいても、十分なノードが空くまで開始できないことがある。追加のロジックがなければ、そのリザベーションまでに完了できる小さなジョブも待たされ、リソースがアイドル状態のままになる。
Slurm のバックフィルスケジューラは、優先度の高いジョブがいつ開始できるかを推定し、それらを遅らせずに完了できる低優先度のジョブを開始することで、この問題に対処する。スケジューラは単に次のジョブがどれかを問うのではない。先にあるジョブの予定開始時刻を維持しつつ、一時的な空きをジョブが利用できるかどうかを問うのである。
このメカニズムが強力なのは、大規模クラスタは頻繁に断片化するからである。早く終わるノードもあれば、占有されたままのノードもある。短いジョブは、機関がより重要と考えるジョブの開始時刻を変えずに、その隙間に入り込めるかもしれない。したがってバックフィルは、利用率を改善しつつ、待ち時間も同時に減らすことができる。
その効果は、受け取る情報に依存する。ユーザーが必要以上に長いウォールタイムを要求すると、スケジューラはジョブが安全に収まらないと判断するかもしれない。要求が少なすぎると、ジョブは完了前に終了させられるかもしれない。トポロジーとアクセラレータの制約により、理論上は利用可能な隙間が使えなくなることもある。障害は予定されたスケジュールを無効にしうる。
バックフィルは、Slurm の運用モデルを縮図として示している。ソフトウェアは宣言された状態から高度な判断を下すことができるが、未来を完全に知ることはできない。より良いキューの成果は、正確な要求、信頼できるクラスタ状態、そしてスケジューラにトレードオフを行う余地を十分に与えるポリシーにかかっている。
GPU は、割り当ての「大きさ」と同じくらい「形状」を重要にした
アクセラレータは「利用可能な容量」の意味を変えた。分散トレーニングジョブでは、8 個の GPU の要求よりも 8 個の CPU の要求の方が、はるかに代替が効きやすいことが多い。アクセラレータのモデル、メモリ容量、PCIe や NVLink の関係、ネットワーク上の位置、ノード構成は、割り当てが期待どおりに機能するかどうかを左右する。
Slurm は、TRES(Trackable RESources)と GRES(Generic RESources)を通じて、異種混在のリソースを表現する。GPU は数えられ、型付けされ、ノードに関連付けられる。デバイスと cgroup の統合により、ジョブを割り当てられたアクセラレータに制限できる。トポロジープラグインと制約は、物理マシンをある程度考慮してスケジューラがジョブを配置するのに役立つ。
これにより GPU は、接続された周辺機器から、スケジュール可能な経済的単位へと変わる。管理者はアクセラレータの使用量を記録し、アクセスを制限し、特定のデバイスタイプをリザーブし、希少なハードウェアをめぐるポリシーを設計できる。AI インフラにとってこれは重要である。なぜなら、キューがクラスタ内で最も高価なコンポーネントへのアクセスを決定していることが多いからだ。
しかし、リソースモデルの有用性は、それが捉えるトポロジー次第である。不適切な通信経路を持つノードに散らばった 8 個の空き GPU は、密接に接続された 2 台のサーバー内の 8 個の GPU と同等ではないかもしれない。スケジューラは設定されたトポロジーに基づいて選択できるが、すべてのネットワーク、メモリ、アプリケーションの依存関係を自動的に推測することはできない。
同じ限界は利用率にも当てはまる。ダッシュボードには GPU が割り当てられていると表示されていても、ジョブはストレージ、集合通信、データ読み込み、または度重なる障害を待っているかもしれない。Slurm は運用者に、誰がいつそのリソースを保持していたかを伝えることができる。しかし、それだけでアクセラレータが生産的な仕事をしていたことを証明するわけではない。
スケジューラはファブリックの上に位置するが、依然としてファブリックに依存している
Slurm はデータ経路上にはない。ジョブが開始されると、アプリケーションのトラフィックはスケジューラを経由せずに、プロセッサ、メモリ、相互接続、ストレージを通って流れる。しかし、それでスケジューラが物理インフラから独立するわけではない。
配置の選択は、スイッチ、ブロック、アクセラレータドメイン全体にジョブを集中させたり分散させたりする。トポロジーを考慮した割り当ては、並列ジョブの通信距離を縮められる。トポロジーを無視した割り当ては、十分な生の容量を、性能の悪いジョブに変えてしまいかねない。有用な帯域幅が他の場所にあるからである。
スケジューラはまた、正確なノード状態にも依存する。GPU は存在していても不健康なことがある。ノードはコントローラから到達可能でも、ストレージ経路が劣化していることがある。ネットワークパーティションにより、実行中のジョブがコントローラの視点とは違って見えることがある。プラグイン、ノードのヘルスチェック、ローカル運用は、そうした物理的状態を、スケジューラが対応できる状態に変換する必要がある。
これは、性能レポートで読み違えやすい境界を作り出す。ジョブの実行が遅い場合、根本原因は割り当て、アプリケーションの挙動、ストレージ、ネットワークの競合、アクセラレータの健全性、またはそれらの組み合わせかもしれない。クラスタがアイドル状態の場合、原因は悪いスケジューリングアルゴリズムではなく、需要の低さ、断片化、リザベーション、障害かもしれない。
したがって運用者にとって有用な尺度は、要求から完了した仕事までの経路全体、すなわちキューの遅延、割り当ての質、起動の成功率、実行時間、再試行、失われた仕事、最終的な完了である。GPU の割り当て総数は参考になるが、生産的な成果と同じではない。
SchedMD はオープンプロジェクトをサポートビジネスに変えた
Slurm が研究所での出自を超えて広がるにつれ、組織が必要としたのはソースコードだけではなかった。本番クラスタには、予測可能なリリース、デバッグ、アップグレード支援、トレーニング、そして特殊なサイト構成を横断して働けるエンジニアが必要だった。Slurm の開発者たちは、その商用レイヤーを提供するために 2010 年に SchedMD を設立した。
この取り決めは、よく知られたオープンソースの取引を作り出した。コードはプロジェクトライセンスのもとで公開されたままとなり、その一方で顧客は、困難な本番システムをめぐる専門知識、サポート、開発に対して対価を支払った。商用業務はメンテナに持続的なエンジニアリングの資金調達手段を与え、主要クラスタを制御するキューが予期せぬ挙動をしたときのエスカレーション経路を運用者に与えた。
SchedMD はまた、知識の集約点にもなった。大規模なスケジューリングシステムには、ドキュメントだけでは学びにくい運用上の詳細、すなわち障害復旧、アップグレードの順序、プラグイン間の相互作用、アカウンティングのエッジケース、珍しいポリシーの影響などが蓄積される。主要メンテナを雇用する企業は、すべてのコントリビューションやすべての導入を所有することなく、その経験をサポート上の強みに変えられる。
この区別が重要なのは、Slurm のポリシーが常にローカルであり続けたからである。SchedMD はコード、パッチ、ガイダンスを出荷できたが、大学、国立研究所、商用 AI サービスの内部で、フェアシェアの重み、リザベーション、アカウントの権利を決定したわけではない。Slurm のユーザー体験は、一部分は上流のソフトウェアであり、一部分は機関自身の基本規則なのである。
AI がスケジュール対象の GPU 容量の価値を拡大する頃には、SchedMD の役割は従来のソフトウェアベンダーより大きくなっていた。SchedMD は、多くの運用者がすでに自らのワークフロー、スクリプト、アカウンティングシステム、運用手順に組み込んでいた、オープンなコントロールプレーンの主要な商業的ステュワードとなっていた。
NVIDIA はステュワードシップをめぐるインセンティブを変えた
NVIDIA は 2025 年 12 月 15 日に SchedMD の買収を発表した。Slurm はオープンソースでベンダー中立であり続けると述べ、SchedMD の開発者はより多くのアクセラレーテッドシステムとエンジニアリングリソースを利用できるようになると主張した。ライセンスが突然プロプライエタリになったわけではなく、買収によってローカルのスケジューリングポリシーが運用者から NVIDIA に移ったわけでもない。
変わったのは、プロジェクトの主要な商業的ステュワードをめぐるインセンティブ構造である。NVIDIA はメンテナに資金を提供するソフトウェア企業であるだけでなく、GPU、ネットワーク、システムの大手サプライヤーでもあり、その性能はワークロードがどのように検出・配置・起動されるかに依存しうる。
これは、もっともな利益ともっともな懸念を生み出す。複雑な AI システムへの早期アクセスはテストを改善し、ハードウェアの変更からスケジューラのサポートまでの道のりを短縮できる。同じ近接性は、競合するアクセラレータ、相互接続、システム設計が引き続き最優先の注意を受けるのかという正当な疑問を提起する。
買収から最初の数か月で得られる証拠は、買収による掌握か完全な中立かを宣言することを正当化しない。公開開発は継続した。Slurm 26.05 とその後のパッチは活発なリリース作業を示し、2026 年 7 月のパッチリリースはクラッシュやその他の運用上の問題に対処した。Slinky も開発を続けた。これらは買収当日の約束よりも強いステュワードシップの指標だが、長期的な比較の問いを解決するものではない。
NVIDIA はまた、Slurm が主要なスーパーコンピューティングシステムで広く使われていると述べ、買収時点で SchedMD が数百の顧客をサポートしていたと述べた。これらの発言は規模を示すものだが、企業による報告であり、特定時点のものにすぎない。民間の AI クラスタ、研究システム、すべてのスケジューラ導入を完全に網羅した調査ではない。
したがって中立性の問いは、観測可能なエンジニアリング上のテストとして組み立てるべきである。インターフェースは可能な限り汎用に保たれているか。競合ハードウェアに影響する問題は、オープンかつ迅速に処理されているか。リリースプロセスと継続的インテグレーション環境は、真に異種混在のハードウェア基盤を実際に試験しているか。外部のコントリビュータは、NVIDIA のプロプライエタリ製品を通らなくても、コードに影響を与え続けられるか。
オープンソースは運用者に退出権を与えるが、無料の代替品を与えるわけではない
Slurm のオープンソースライセンスが重要なのは、運用者がその条件のもとでコードを閲覧・変更・再配布できるからである。これは、クローズドソフトウェアへの単純な転換に対する正式な障壁を作り、ステュワードシップが受け入れがたいものになった場合にコミュニティがフォークする法的な経路を与える。
しかし、実行可能なフォークはライセンスだけで生まれるわけではない。大規模なスケジューリングには、コントローラの状態、アカウンティング、プラグイン、リリース、セキュリティ、そして広範なハードウェアマトリクスを理解するメンテナが必要である。テストシステム、ユーザーの信頼、サポート対象バージョン全体に修正をバックポートする用意のある人材も必要である。
実際の切り替えコストも、1 つの実行ファイルを置き換えるよりはるかに大きい。成熟した Slurm 環境には、ジョブスクリプト、アカウント構造、過去の使用量、カスタムプラグイン、監視、運用手順、ユーザーの習慣が蓄積されている。別のスケジューラが技術的に有能であっても、ポリシーと組織の記憶の高コストな移行を必要とすることがある。
だからこそ、NVIDIA による所有は、フォーク可能性を完全な答えとみなすことなく、精査に値するのである。中立性の最も強い形は、問題が起きた後に離脱できるという理論上の能力ではない。離脱が必要になる前に、異種混在のインフラ全体で有用であり続けるプロジェクトこそが、中立性の最も強い形である。
同じ論理は商用サポートにも当てはまる。運用者は、コードがオープンであっても、主要メンテナを雇用する企業の専門知識に依存することがある。その専門知識が一つのハードウェアエコシステムに狭まれば、ソースは利用可能なままでありながら、実際のサポートの境界は中立性を失うことになる。
Slinky は 2 つのコントロールプレーンを同じ環境に置く
現代の AI インフラは、バッチスケジューリングと Kubernetes をますます組み合わせるようになっている。プラットフォームチームは、Slurm のジョブモデル、フェアシェア、リザベーション、並列ワークロードのセマンティクスを維持しつつ、プロビジョニング、オペレータ、サービス、コンテナのライフサイクルに Kubernetes を使いたいと考えるかもしれない。
Slinky は、それらの世界を橋渡ししようとする SchedMD の試みである。そのslurm-operatorは Kubernetes 指向のメカニズムを通じて Slurm コンポーネントをデプロイ・管理でき、slurm-bridgeは共有リソースを対象に Kubernetes と Slurm の間でワークロードを調整する。最初の安定版系列が 2025 年後半に登場した後、バージョン 1.2.0 が 2026 年 7 月 2 日にリリースされた。
その魅力は明らかである。組織は、確立された Slurm ポリシーを維持しながら、その周囲のインフラを管理するためにクラウドネイティブなツールを使用できる。これにより、バッチ計算用に完全に別個の運用環境を構築する必要性を減らせる。
難しさは権限である。Kubernetes と Slurm は、望ましい状態、ワークロードの所有権、復旧について異なるモデルを持つ。障害の後に両方のシステムがノード、デバイス、またはワークロードを制御していると判断した場合、統合には、どちらの状態が権威であり、もう一方のシステムをどのように調整するかについて明確な答えが必要である。
これはアプローチを拒否する理由ではない。Slinky は、アーキテクチャの美しさではなく、運用上の証拠で判断されるべきだという理由である。本番導入では、2 つのオーケストレーションシステムが関与する場合に、アップグレード、フェンシング、RBAC、コントローラ障害、部分的なネットワークパーティションがどのように処理されるかを示す必要がある。
Slurm の歴史は、スケジューラが調整する範囲の境界を繰り返し拡大してきた。Kubernetes 統合はそのパターンを継続するが、新しい制御面ごとに、何かが壊れたときに責任がどこへ移るかを知ることの重要性が増す。
キューは利用率を改善しても、悪い結果を生み出すことがある
Slurm は、高価な容量をより有用にする多くの方法を運用者に提供する。バックフィルはアイドル時間の隙間を減らせる。フェアシェアはアクセスを時間的に分散できる。トポロジーを考慮した配置は局所性を改善できる。リザベーションは重要なジョブを保護できる。プリエンプションは緊急またはプレミアムなジョブのための余地を作れる。
それぞれのメカニズムにはコストもある。リザベーションは、期待されたジョブが来ない場合、容量を遊ばせることになる。アプリケーションがチェックポイントに対応していない場合、プリエンプションは有用な仕事を破壊しうる。トポロジールールは一つのジョブの性能を維持する一方で、他のジョブの断片化を増やすことがある。フェアシェアは、機関の優先順位に合わなくなったポリシーを報いることがある。
運用者が一つの指標を最適化すると、リスクは大きくなる。高い GPU 割り当ては、他の場所で停滞しているジョブにデバイスを割り当てたままにすることで達成できる。短いキューの待ち時間は、実行を長引かせるリソース形状のジョブを受け入れることで達成できる。積極的なプリエンプションは、中断されたジョブにすでに費やした電力と計算を無駄にしながら、一つのサービスレベルを保護できる。
AI インフラにとって、より良い尺度は、希少な容量と時間の単位あたりに完了した有用な仕事である。Slurm はその成果に貢献するが、それは一つの層にすぎない。トレーニングフレームワーク、ストレージ、ネットワーク設計、チェックポイント処理、アクセラレータの健全性、ユーザーの要求の質はすべて、割り当てが価値を生むかどうかに影響する。
これはまた、上流とローカルの責任の境界でもある。サイトが特定のアカウントを優遇するポリシーを選んだり、リザベーションを使い過ぎたり、非現実的なプリエンプションルールを設定したりした場合、その結果を自動的に SchedMD や NVIDIA のせいにするべきではない。スケジューラが状態を誤計算したり、デバイスを誤って扱ったり、リグレッションを引き起こしたりした場合は、上流の挙動が関連する層になる。
信頼できる運用には、それらのケースを区別するのに十分な監査可能性が必要である。
実際の制御面は複数のアクターに分割されている
Slurm のステュワードシップは、一つのコントローラがクラスタをスケジュールし、一つの企業がプロジェクトの専門家の多くを雇用している現在、中央集権的に見えることがある。しかし実際には、制御は分割されている。
上流のメンテナは、どのコードがリリースに入るかを決める。NVIDIA は SchedMD を所有し、エンジニアリングリソースを配分できる。ハードウェアベンダーは統合作業を提供し、テスト用のシステムを提供する。クラスタ管理者は、バージョン、プラグイン、トポロジーモデル、アカウント、QOS、制限を選択する。機関のリーダーは、誰が希少な計算リソースを受ける資格を持つかを決める。ユーザーは、どのリソースを要求するか、実行時間をどの程度正確に申告するかを決める。そしてアプリケーションが、割り当てが効率的に使われるかどうかを決める。
この層状の制御こそが Slurm の中心的な事実である。単一のアクターが結果全体を所有しているわけではない。
これはまた、キューのガバナンスが戦略的に重要になった理由も説明する。アクセラレータがあまり希少でなく、価値も低かった時代には、最適でないルールは苛立たしいだけだった。大規模な AI 環境では、同じルールが待ち時間、断片化、そして有用な仕事を完了する高価な容量の量を変えうる。
Slurm の功績は、共通のオープンなシステムが、すべての機関を一つの公平性の定義に強制することなく、非常に異なる割り当てモデルを表現できることにある。その限界も同じである。ソフトウェアは、選択されたモデルが賢明で、理解しやすく、正当であることを保証できない。
したがって長期的な試金石は、Slurm がジョブをスケジュールし続けるかどうかではない。運用者が、ジョブが希少な計算リソースへのアクセスを得た理由、または失った理由を引き続き再構成でき、その一方で上流プロジェクトが、運用者が実行したい異種混在のハードウェア全体で信頼に値し続けるかどうかである。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加