
要約
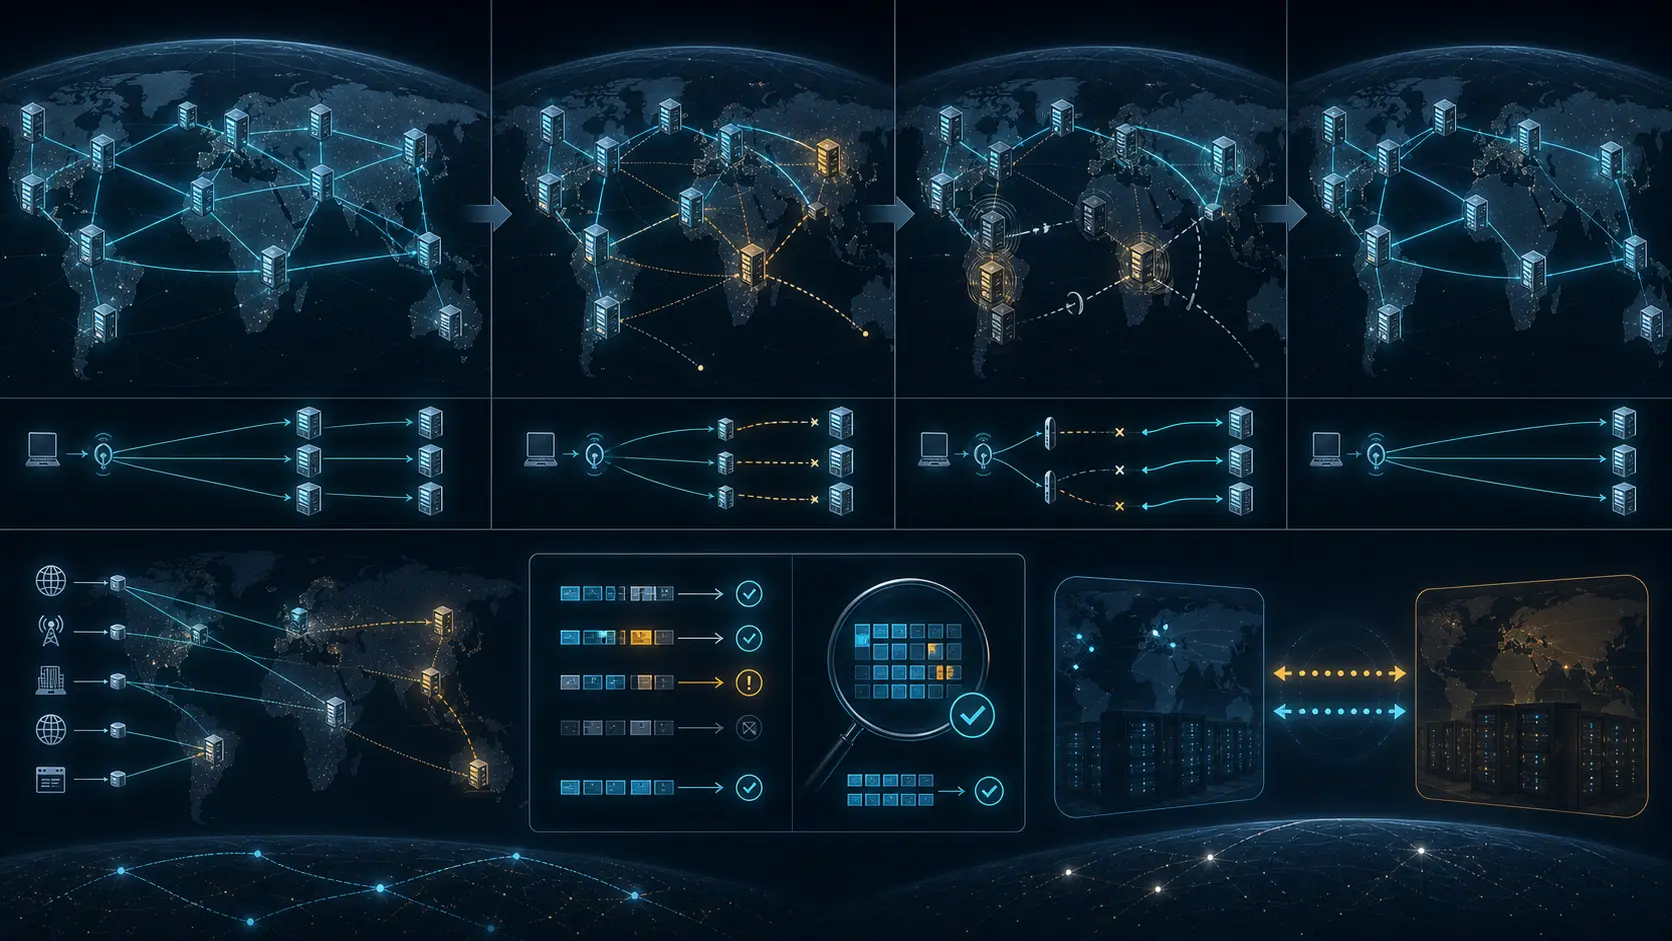
- Cloudflareの段階的なソフトウェアリリースで導入された不具合により、提携運用されていた一部のF-Rootノードが必要なglueレコードを省略し、.netの名前解決に断続的な障害が生じた。
- ISCの記録では、17時33分(UTC)の認識から20時51分の全面復旧まで3時間18分を要した。即時修復は記録されているが、合意されたBGP経路撤回テストが後にどの頻度、基準、結果で実施されたかは、今回確認した公開資料からは立証できない。
障害は「全停止」ではなく、正しくない応答として現れた
2020年1月23日に起きたF-Rootの問題は、世界中のすべてのF-Rootインスタンスが同時に停止する種類の障害ではなかった。公開された事後報告によれば、Cloudflareが段階的に展開していたソフトウェアの不具合により、同社との提携で運用されていた一部のF-Rootノードが、必要なglueレコードを含まない応答を返した。その結果、.netドメインの名前解決が断続的に失敗した。
この仕組みは、インフラの健全性を稼働率だけで測る危険を示す。サーバーがネットワーク上で到達可能であり、DNSクエリに何らかの応答を返していても、その応答内容がプロトコル上必要な情報を欠いていれば、利用者にとってサービスは正しく機能していない。生存確認や到達性の監視だけでは、意味的に誤った応答を見逃し得る。
事故の仕組みと時系列についての主要な根拠は、公開されたF-Root障害の事後報告である。本稿が確認した公開資料は、影響を受けた利用者やリゾルバーの総数を定量化していない。そのため、影響を「小規模」または「広範」と断定するのではなく、.netの解決失敗が断続的に発生したという確認可能な範囲にとどめる必要がある。
glueレコードの欠落が下流の失敗を生む仕組み
DNSの委任では、上位ゾーンから下位ゾーンの権威サーバーへ問い合わせを進めるために、ネームサーバー名だけでなく、そのサーバーへ到達するためのアドレス情報が必要になる場合がある。glueレコードは、この参照が循環したり、次の問い合わせ先へ進めなくなったりすることを避けるために使われる。
一部のF-Rootノードが必要なglueを省いた応答を返すと、そのノードへ到達したリゾルバーは、委任を正常にたどれない可能性がある。しかし、anycastで分散されたすべてのノードが同じ誤動作をしていたわけではないため、結果は一様な全面停止ではなく、経路や問い合わせ時点などに左右される断続的な失敗となる。
ここで重要なのは、冗長なノード数そのものと、正しい応答を継続できる能力は別だという点である。多数の拠点が存在しても、一部が同じリリース経路を通じて同じ欠陥を受け取れば、分散は障害を消すのではなく、誤動作を限定的かつ不規則に見せることがある。断続性は影響を抑える場合がある一方、検知と再現を難しくする。
リリース、検知、経路撤回を誰が制御していたか
この事故では、運用上の制御が一つの組織に集中していなかった。公開された事後報告に基づくと、Cloudflareは問題のあるソフトウェアリリースとその修正を制御していた。一方、F-Rootの運用主体であるInternet Systems Consortium(ISC)は、外部から寄せられた報告を確認し、問題をエスカレーションし、影響を受けたプレフィックスの撤回を要請した。
この分担は、それ自体が過失を意味するものではない。分散運用や提携は、地理的な到達性、容量、攻撃耐性を高めるために合理的な場合がある。しかし事故対応では、問題を最初に認識した側が、問題を生んだリリースを直接停止・修正できるとは限らない。さらに、誤った応答を返すノードを利用経路から外すには、別の運用権限や調整が必要になる。
したがって、責任を検討するときは「どちらの組織の障害だったか」という単純な二択より、次の制御面を分けて見る必要がある。
- 欠陥の混入を防ぐリリース審査と段階展開の停止条件。
- 到達性だけでなくDNS応答の正しさを外部から確認する監視。
- 利用者報告を技術的事象として検証し、担当者へ到達させるエスカレーション経路。
- 影響を受けたanycastプレフィックスを速やかに撤回する権限と手順。
- 修正後に経路を再広告し、正常性を確認する復旧判断。
ISCについての基本情報はBTWのISCディレクトリー項目でも確認できる。ただし、事故の具体的事実はディレクトリー記述ではなく、上記の事後報告に依拠している。
3時間18分の復旧過程
ISCが記録した時刻によれば、同組織が問題を認識したのは17時33分(UTC)だった。17時41分に報告を受領したことを相手方へ伝え、17時46分には問題を検証してCloudflareへエスカレーションした。全面復旧は20時51分に記録されている。
17時33分から20時51分までは3時間18分である。この数字は、最初のソフトウェア変更時点からの障害継続時間や、すべての個別利用者が影響を受けた時間を意味しない。公開記録上の「ISCが認識した時刻」から「全面復旧」までの復旧区間を示す。
復旧は単一の操作ではなく、複数の措置によって進んだ。Cloudflare側でコードが修正され、影響を受けた経路についてBGPプレフィックスの撤回が行われ、その後に再広告された。コード修正は原因となった動作を変える。経路撤回は、誤った応答を返す可能性があるノードへ利用者トラフィックが到達することを止める。再広告は、修正と確認の後にその経路をサービスへ戻す。
この組み合わせは、修復と隔離が別の機能であることを示す。不具合の修正が完了するまで待つ以外に、影響を受けた運用単位をトラフィック経路から外す手段があれば、利用者への露出を抑えられる可能性がある。ただし、その手段が実用的であるためには、誰が判断し、誰が実行し、どの条件で再広告するかが事前に決まっていなければならない。
冗長化が協調リスクを消さなかった理由
anycastと多数のサーバー拠点は、設備故障、回線断、局所的な過負荷などに対して有効な冗長性を提供する。しかし、冗長性の存在は、すべての障害モードに対する回復力を自動的には証明しない。
第一に、共通のソフトウェア変更は、物理的に分散された複数ノードへ共通原因障害を持ち込める。段階展開は影響範囲を限定するが、その段階で誤応答を検出し、展開を止める判定条件がなければ、限定された障害は利用者側に残る。
第二に、障害が「応答なし」ではなく「不完全な応答」として現れると、一般的な稼働監視では異常が見えにくい。プロトコルの意味を検査する外部テスト、複数地点からの問い合わせ、既知の正常応答との比較が必要になる。
第三に、検知者と変更管理者が異なる場合、情報の確認と受け渡しに時間がかかる。外部報告を受けた組織が影響を検証できても、コードを修正する権限がなければ、別組織の担当者へ確実に到達する必要がある。
第四に、隔離手段がBGP経路撤回であるなら、DNS運用と経路運用の双方が関与する。技術的に撤回可能であることと、事故時に安全かつ迅速に撤回できることは同じではない。連絡先、承認、実行担当、対象プレフィックス、監視、再広告条件を含む手順全体が機能しなければならない。
事故後のテスト合意が証明すること、しないこと
事後報告は、関係者がBGP経路撤回を定期的にテストすることで合意したと記録している。これは重要な是正方向である。事故時に使われた隔離手段を、平時にも実行可能か確認するという発想が明示されたからだ。
しかし、合意は実施記録ではない。今回確認した公開資料からは、その後の事故固有のテストについて、実施日、頻度、対象範囲、成功基準、所要時間、失敗項目、是正措置、独立した確認の有無を立証できない。公開情報が見つからないことは、テストが行われなかった証拠ではない。確認可能なのは、定期テストへの合意が文書化されたことと、後続の実施を証明する公開記録が今回の資料には含まれていないことまでである。
この区別は、事故対応の評価で欠かせない。「修正した」「手順を見直した」「今後テストする」という表明は、適切な出発点になり得る。しかし耐久性を判断するには、その後に手順が繰り返し機能したことを示す証拠が必要になる。
運用者と取締役会が確認すべき限定的な耐久性テスト
同種の分散基盤を評価する運用者や取締役会は、抽象的に「冗長化されているか」と尋ねるだけでは足りない。少なくとも、次の項目を証拠とともに確認する必要がある。
- 段階リリースの各段階で、DNS応答の意味的正しさをどのテストが確認するのか。
- 異常を検出したとき、展開を自動または手動で停止する定量的な基準があるか。
- 運用主体の外部から、複数地域・複数経路で応答を検査しているか。
- 外部報告を受けた担当者が、変更管理者と経路運用者へ24時間到達できるか。
- 対象プレフィックスを撤回する訓練をいつ実施し、検知から撤回まで何分を要したか。
- 撤回による副作用をどう監視し、どの条件で再広告するか。
- テストの成功基準、失敗、是正期限、再試験結果が保存されているか。
- 結果を実行担当者以外が確認し、経営層へ未解決事項を報告しているか。
2020年1月23日の事故については、直接的な不具合の修正とサービス復旧が記録されている。そこから先の結論は限定されるべきだ。冗長性が無意味だったとはいえないし、その後に訓練が行われなかったとも断定できない。ただし、冗長性が耐久的な回復力を証明したとも、定期的な撤回テストへの合意だけを根拠に断定できない。
検証可能な回復力とは、ノード数や合意文書ではなく、欠陥を防ぎ、正しく検知し、権限を越えてエスカレーションし、影響部分を隔離し、復旧させ、その一連の経路が後日も定義された基準で機能したことを示せる状態である。この事故の即時修復は記録されている。残る問いは、その緊急経路が繰り返し訓練され、結果が検証可能な形で残されているかどうかである。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加