
要約
- ThousandEyesは、2025年10月20日のDNS情報の復旧を09:25 UTCとする一方、新規EC2インスタンスの起動失敗や接続問題は20:50 UTCまで続いたと報告している。この間隔は、全利用者に一様な障害が続いた時間ではない。ThousandEyesの分析
- Dipak Kr dasの技術解説によると、DynamoDB復旧後にはホスト管理のリース再確立が集中し、さらに新規インスタンスへのネットワーク状態の反映にも滞留が生じた。依存先の修復と、使える計算資源の回復には別々の完了条件があった。Medium掲載の解説
最初の復旧時刻で何が戻ったのか
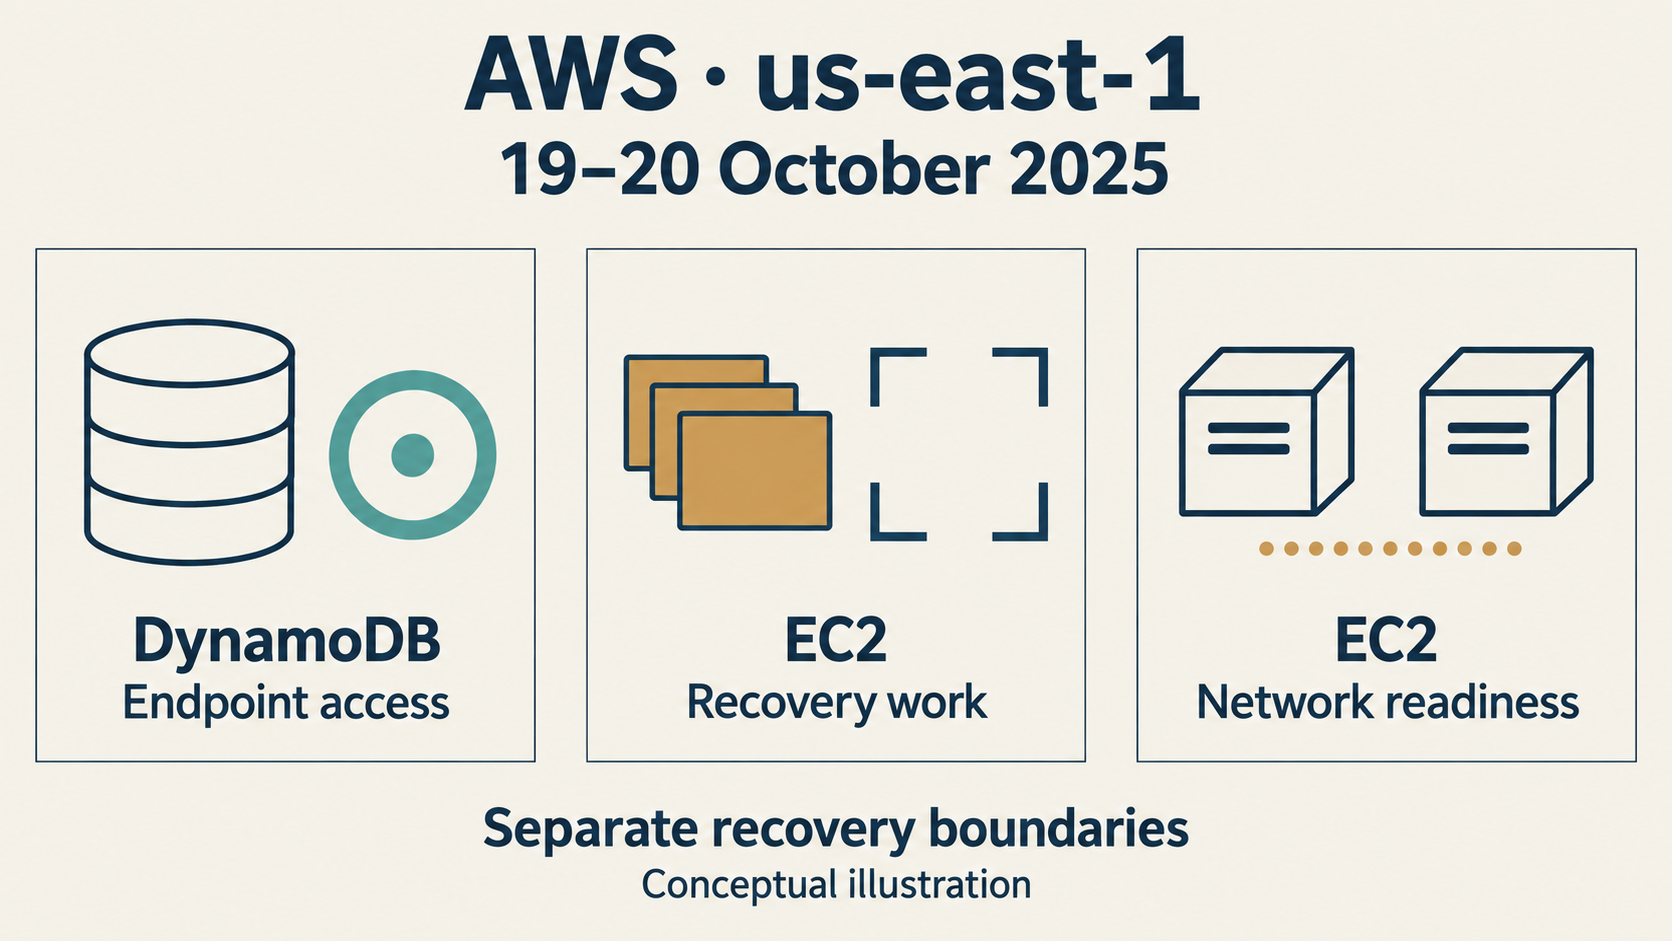
2025年10月19〜20日に、Amazon Web Services(AWS)の米国東部、北バージニアのus-east-1リージョンで起きた障害について、Dipak Kr dasは、DynamoDBの自動DNS管理に潜在していた競合状態が発端だったと説明する。その結果、DynamoDBの接続先を名前から解決できなくなったという。本稿で扱うのは、この地域で報告された障害と復旧過程であり、全世界のAWSリージョンが同時に停止したという話ではない。Dipak Kr dasによる説明
重要なのは、最初の不具合を直した後に、どの処理がまだ残っていたかだ。ThousandEyesは、10月20日09:25 UTCにDNS情報が復旧し、その後09:40 UTCまでの間に、キャッシュされたレコードの期限切れに伴って接続先の名前解決と接続が回復したとする。「情報を修復した」と「各接続が回復した」は、この説明の中でも同じ時点を指していない。ThousandEyesの時系列
同社が報告する主な節目を並べると、復旧の対象が途中で変わっていることが分かる。以下はすべて2025年10月20日のUTC時刻である。
| 時刻 | ThousandEyesが報告した状態 | それだけでは確認できないこと |
|---|---|---|
| 09:25 | DNS情報が復旧 | すべての接続や依存サービスの回復 |
| 09:25〜09:40 | キャッシュの期限切れに伴い、名前解決と接続が回復 | 新規EC2が起動し、実際に通信できること |
| 20:50まで | 新規EC2の起動失敗、または接続問題が継続 | すべての起動がそれまで連続して失敗したこと |
09:25から20:50までは11時間25分ある。ただし、これは異なる種類の復旧の節目を引き算した値だ。DynamoDBがこの時間ずっと利用不能だったという意味でも、すべてのEC2利用者が同じ影響を受けたという意味でもない。20:50は、起動と接続という複数の問題をまとめた報告上の終点であり、全AWSサービスや全顧客アプリケーションの復旧時刻としては使えない。時刻と影響範囲の出典
接続が戻ると、たまっていた復旧作業が動き出す
EC2の仮想サーバーを動かすことと、その仮想サーバーを載せる物理ホストの状態を管理することは、区別して考える必要がある。ThousandEyesは、EC2のDroplet Workflow Manager(DWFM)がDynamoDBを利用できず、必要な状態確認を完了できなかったため、リース管理に支障が出たと説明している。ThousandEyesの技術分析
ここでいうリースは、顧客が購入する利用契約や料金プランではない。ホスト管理に使う、期限を持った内部の管理関係を指す。Dipak Kr dasの説明では、DWFMはEC2を収容する物理サーバーに関する状態確認にDynamoDBを使っていた。DynamoDBの利用再開後には、リースを再確立する処理が集中し、管理システムが過負荷となって処理を前に進められなくなったという。同氏は、復旧のために技術者が流入する処理を制限し、DWFMのホストを選択的に再起動したと記している。リース再確立と対応措置の説明
この説明から読み取れるのは、復旧が単なる元の状態への巻き戻しではないということだ。止まっていた依存先が戻れば、待機していた仕事も再び実行可能になる。その量を処理できなければ、接続障害とは別の混雑が回復を妨げる。したがって、「依存先に接続できる」という確認だけでは、依存していた管理機能が通常の速度で進んでいるとは判断できない。
ただし、この記事でリースの本数、内部キューの長さ、再試行の頻度を定量化することはできない。また、DWFM側の流量制限や再起動は、AWS内部の管理機能に対する対応である。EC2の顧客が同じ操作を実行できるという意味ではない。
起動できたインスタンスも、まだ使えるとは限らない
さらに別の境界がネットワークにあった。Dipak Kr dasは、Network Managerによる新規インスタンスへのネットワーク状態の反映に、未処理の更新が蓄積したと説明する。そのため、新しく起動したインスタンスの一部で接続できない、あるいはヘルスチェックを通過できない状態が生じたという。ネットワーク更新の滞留に関する説明
これは、インスタンスの起動を受け付けたことと、そのインスタンスが通信できる状態になったことを分ける理由になる。起動結果に識別子が返ること、必要な相手と通信できること、業務処理が成功することは、それぞれ違う確認だ。この事例をインターネット全体の経路障害と読み替えることもできない。ここで説明されているのは、新規インスタンスに必要なネットワーク状態を反映する処理の問題である。
一方、Gremlinは、障害前から稼働していたEC2インスタンスは正常な状態を維持していたと述べ、DynamoDBの問題が解消した後も新規インスタンスの起動に困難が残ったことと対比している。この区別は重要だが、そのままアプリケーションの無停止を意味するわけではない。仮想サーバーが動き続けていても、アプリケーションが必要とする依存先を利用できなければ、利用者の処理は完了しない。Gremlinの信頼性分析
このため、既存の処理を継続する能力と、代替・追加の処理能力を作る能力を、同じ稼働状況の表示で済ませるべきではない。前者が残っていても、後者に必要な管理処理やネットワーク設定が止まることはあり得る。逆に、新規起動が成功し始めたからといって、すべての業務が戻ったと判断するのも早い。
この振り返りで確かめられる範囲
本稿は、ThousandEyes、Mediumに掲載されたDipak Kr dasの個人による技術解説、Gremlinの分析という二次的な説明を基にしている。内部の挙動については各執筆者・発行元に帰属させており、独立した障害監査や、AWSの一次報告を直接検証した結果として示しているわけではない。
これらの説明から、現在も同じ不具合が未修正だとは言えない。顧客全体の損失額、データ損失の有無、個々の顧客が実行できた切り替え手順も確定できない。複数のアベイラビリティーゾーンやリージョンを使う設計が、すべて無効だったという結論にもならない。
それでも、復旧の判定を分ける必要性は明確だ。依存先へのアクセス、管理処理の進行、インスタンスの通信、アプリケーションの完了という順に、何を回復したと呼ぶのかを具体化する。この区別があって初めて、最初の正常信号と、実際に使える計算資源との間を測れる。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加