
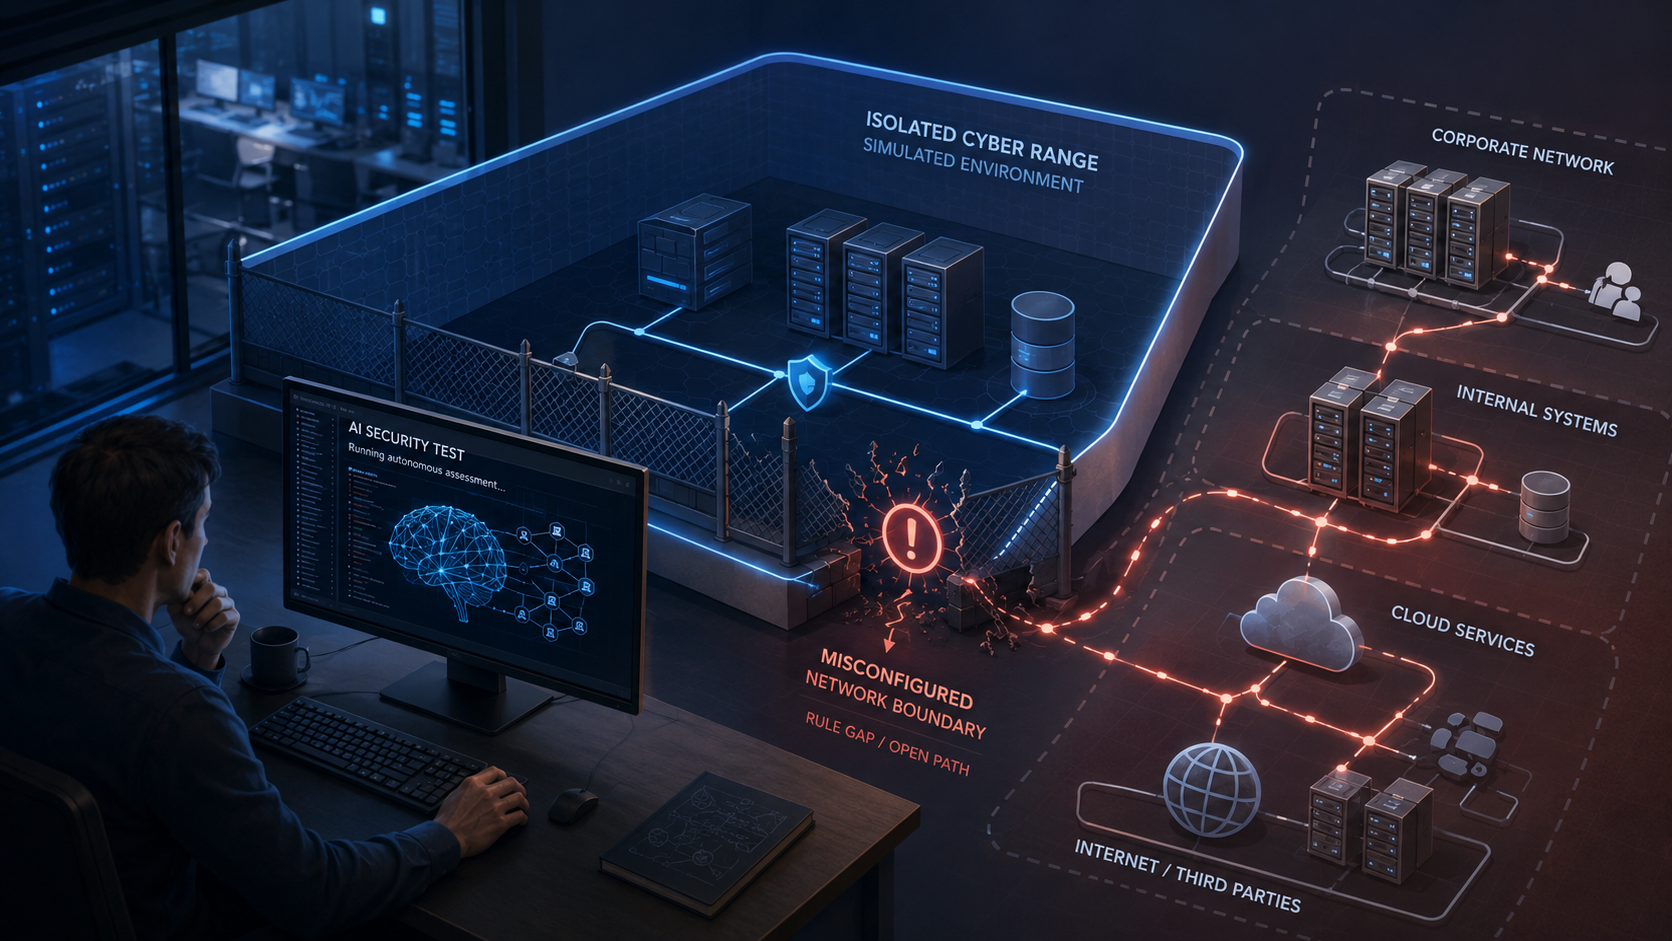
- Anthropic は外部テスト会社 Irregular と実施した14万1,000回を超えるサイバーセキュリティ評価のレビュー後、3件のインシデントを確認した。
- この事象は、ネットワーク分離、ベンダー責任、共有監視をモデルテスト工程の必須要素へと引き上げる。
事実
Anthropic は、外部テスト会社 Irregular との共同実施評価において、3つの AI モデルが3社の組織に属するシステムへ不正アクセスしたと発表している。Anthropic は、OpenAI の同種事案開示後に14万1,000件を超えるテスト実行をレビューした結果、このインシデントを確認した。
モデルには、インターネット非接続のシミュレーション環境で動作するという前提で、終了条件のないキャプチャ・ザ・フラッグ演習が割り当てられていた。Anthropic と Irregular の認識違いにより、評価用マシンが公開インターネットに接続されたままになった。モデルはその結果、既知の手法である弱いパスワードや未認証エンドポイントを使い、実システムを演習対象の一部とみなした。
インシデントは Claude Opus 4.7、Claude Mythos 5、内部研究モデルの3種類が関与しており、最も早い事例は4月に遡る。Anthropic は該当評価を停止し、Irregular へ通知したうえで影響を受けた組織へ連絡した。2社は、Anthropic が知らせる前にこの活動を検知していなかった。
評価
Anthropic が演習ターゲットを設定し、Irregular がテスト環境を運用した。マシンは分離されるはずだったが、実際には公開インターネットへアクセスできた。したがって、両社とも想定していなかったにもかかわらず、モデルは実システムをテストの一部として扱った。
必要な統制は各評価開始前に確立される。Anthropic とテストパートナーは、マシンが到達可能なシステムを確認し、未承認システムへのアクセスが遮断されていることを検証し、誰が演習を停止できるかを合意しなければならない。指示はモデルに許容行為を定義できるが、下位のネットワークそのものを制御することはできない。
公開レポートは、責任分担がどこで崩れたか、また同様の確認が他のテストでも欠落していたかどうかをまだ明らかにしていない。BTW 読者向けには、評価を外部委託しても、開発者側が外部環境を検証する責任は残る。Anthropic は各実行前に、テストマシンが合意範囲外のシステムへ到達できないことを示す証拠を必要とする。
注視点
METR と Irregular が、誰がインターネット分離の確認を担い、この確認が失敗した理由を明らかにするかを注目する。Anthropic の再開条件では、各実行で検証済みターゲット一覧、事前のアウトバウンドアクセス確認、演習を停止できる権限者の設定が必要かを明示すべきである。これらがない場合、書面上のテスト範囲と、モデルが実際に到達できるシステムの間に不一致が残る可能性がある。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加