Resumen
- ISC documenta mecanismos de mantenimiento, distribución, administración, registro y recuperación para BIND y Kea, pero la documentación pública no prueba que un operador concreto haya activado esos mecanismos.
- La responsabilidad operativa se reparte entre ISC, los distribuidores de paquetes y los operadores; una reparación verificable exige evidencia de versión, despliegue, observación, restauración y pruebas posteriores.
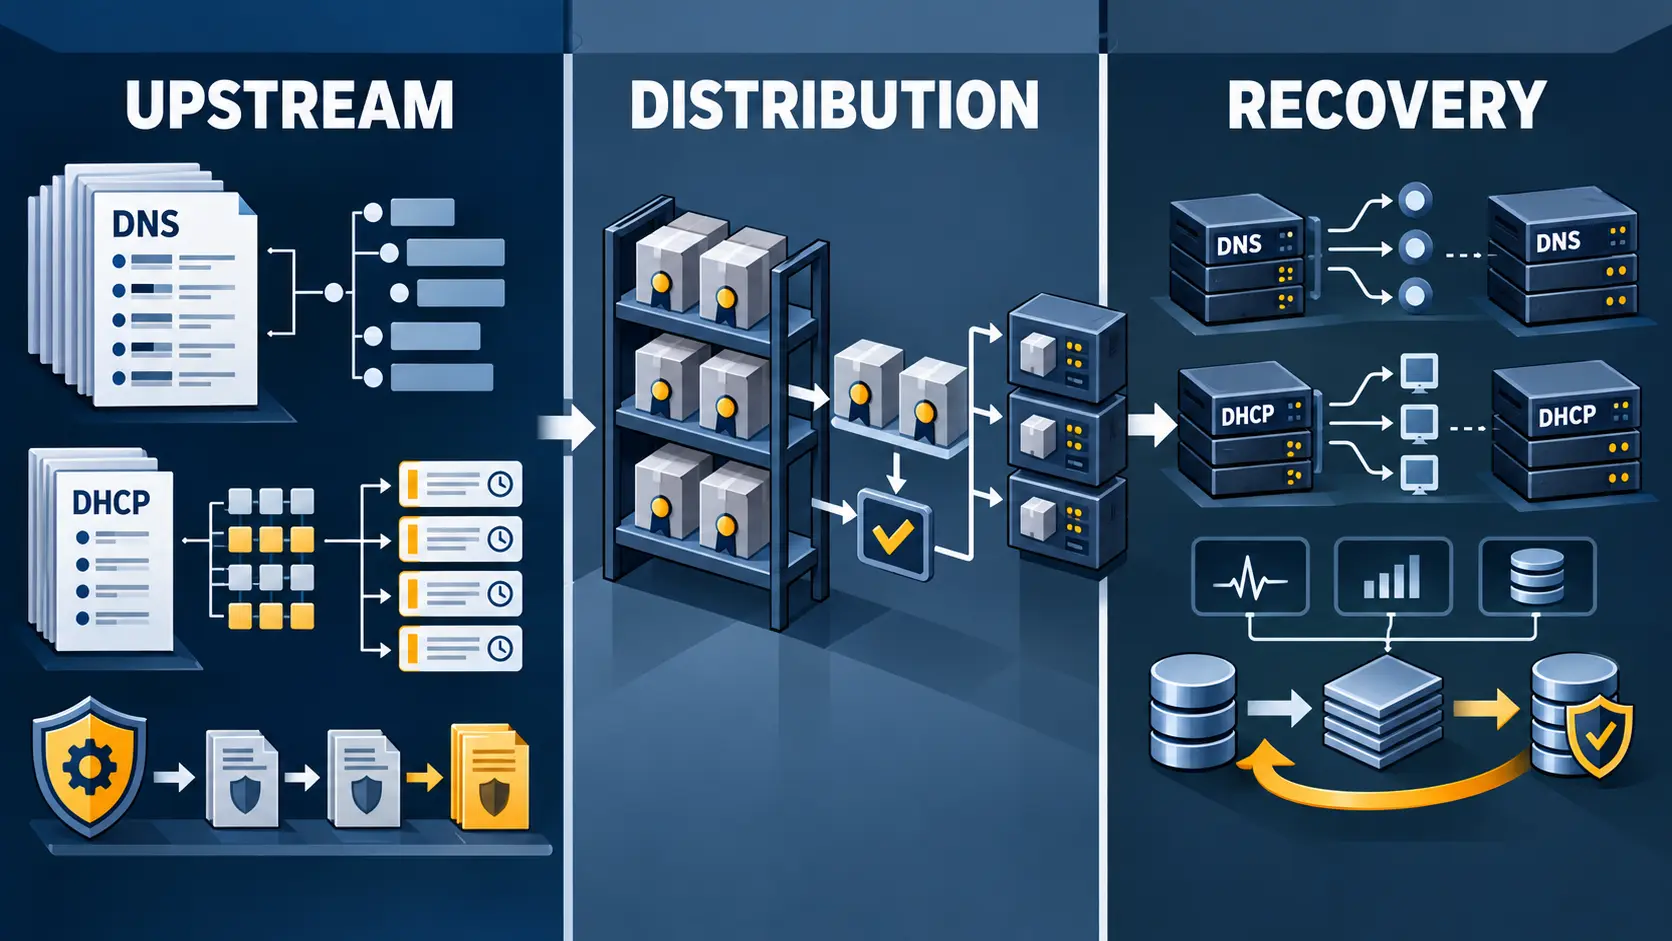
La primera capa de control está en el upstream. ISC publica avisos de seguridad con versiones afectadas, impacto y orientación de mitigación en su página de avisos de seguridad. También ofrece artefactos descargables en su infraestructura de descargas y mantiene repositorios públicos para BIND 9 y Kea (repositorio de BIND 9; repositorio de Kea). Esas fuentes permiten seguir una vulnerabilidad, una modificación o una versión disponible. No permiten concluir, por sí solas, que un servicio descendente haya sido actualizado o que haya vuelto a operar correctamente.
La segunda capa es la distribución. Un operador puede obtener BIND directamente de ISC o mediante una distribución de sistema operativo. Debian mantiene un rastreador de paquetes para bind9 y Ubuntu expone información de paquetes para BIND 9 en sus repositorios de paquetes. En esa transición se incorporan decisiones adicionales: qué versión se empaqueta, cuándo se publica para una rama concreta, qué dependencias se resuelven y cómo se comunica una actualización. La existencia de un paquete disponible demuestra que existe una ruta de entrega; no demuestra que el paquete esté instalado, aprobado para producción o aplicado a todos los nodos relevantes.
La tercera capa es la configuración y la operación. El manual de administración de BIND 9 describe configuración, operación, controles, registros, estadísticas, resolución de problemas y mantenimiento. La documentación de administración de Kea cubre servicios DHCP, canales de control, bases de datos, alta disponibilidad, registro, supervisión y procedimientos operativos. Estas superficies son importantes porque convierten la continuidad en algo potencialmente observable: versión instalada, estado del proceso, consultas, errores, coordinación entre servidores, cambios de configuración y resultados de una restauración.
Pero una superficie documentada no es una prueba de uso. La documentación de BIND 9 como software DNS y la página de Kea muestran el papel de ISC como responsable del software upstream. La base de conocimiento de ISC puede aportar orientación técnica y específica de versión. Ninguna de esas fuentes establece qué operador habilitó los registros, qué equipo recibió una alerta, qué procedimiento se siguió durante una interrupción o cuánto tardó una recuperación determinada.
Por eso conviene separar cinco preguntas que con frecuencia se mezclan:
- ¿Quién mantiene el código? La evidencia pública permite atribuir a ISC la publicación y el mantenimiento de BIND y Kea en sus canales de proyecto.
- ¿Quién entrega el artefacto? Puede ser ISC, una distribución o un integrador. El canal altera el calendario, el formato y las comprobaciones disponibles.
- ¿Quién decide desplegarlo? Normalmente el operador del servicio, sujeto a sus procesos de cambio, dependencias, ventanas de mantenimiento y obligaciones de continuidad.
- ¿Quién detecta el fallo? La respuesta depende de la supervisión configurada: registros, estadísticas, comprobaciones de salud, métricas, alertas y pruebas externas.
- ¿Quién demuestra la recuperación? La evidencia debe proceder del entorno afectado: inventario de versiones, registros de despliegue, estado del servicio, resultados de pruebas y documentación de restauración.
Esta división no reduce la importancia de ISC. La hace más precisa. Un aviso claro y un artefacto verificable pueden reducir el tiempo necesario para identificar y corregir una exposición. Una documentación operativa detallada puede ayudar a que el operador construya controles de detección y recuperación. Pero el resultado final depende de una cadena que atraviesa el upstream, el empaquetado, la configuración local, los datos persistentes, las claves, las dependencias, la supervisión y los procedimientos humanos.
La prueba de una reparación duradera debe seguir esa cadena. Primero, el operador debería poder identificar qué versión y configuración estaban expuestas. Después, debería conservar evidencia de que el artefacto correcto fue validado y desplegado en los componentes pertinentes. A continuación, debería demostrar que las señales de funcionamiento —por ejemplo, respuestas DNS o asignaciones DHCP, errores, estado de pares y métricas— volvieron a un nivel aceptable. Finalmente, debería repetir una prueba de la condición que produjo el riesgo, dentro de límites seguros, y conservar el resultado.
El expediente público sobre ISC documenta los mecanismos y las rutas de entrega. No proporciona una medición global de cuántos operadores ejecutan cada versión, con qué rapidez aplican una corrección ni si sus procedimientos de recuperación funcionan bajo presión. Esa ausencia no prueba una falla de ISC ni una falla de los operadores. Sí marca el límite de lo que puede afirmarse públicamente y señala qué registros deberían solicitarse en una investigación concreta.
Para instituciones públicas y otros servicios esenciales, la consecuencia es práctica: no basta con preguntar si existe un parche o si el software incluye alta disponibilidad. Hay que preguntar quién posee cada decisión, qué dependencia puede retrasarla, qué alerta activa la respuesta y qué evidencia demuestra que el servicio se recuperó. La continuidad no es una propiedad que se transfiere intacta desde una versión upstream; se construye y se verifica en cada tramo de la cadena.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance