
Resumen
- RFC 3512 muestra que perder una respuesta no prueba que el SET haya fallado: el agente pudo ejecutar el cambio y el gestor repetirlo, mientras el subsistema subyacente conserva un estado que no es necesariamente idempotente.
- La operación solo queda cerrada cuando la evidencia une solicitud, respuesta, valores anteriores y posteriores, semántica MIB, activación, estado operativo, persistencia, dependencias, prueba del servicio y capacidad de restauración.
El gestor esperó y agotó el temporizador. No recibió una respuesta, así que envió otra vez el mismo valor. El segundo intento recibió noError y la automatización marcó el cambio como exitoso.
La etiqueta ocultaba la pregunta importante: ¿qué hizo el primer intento?
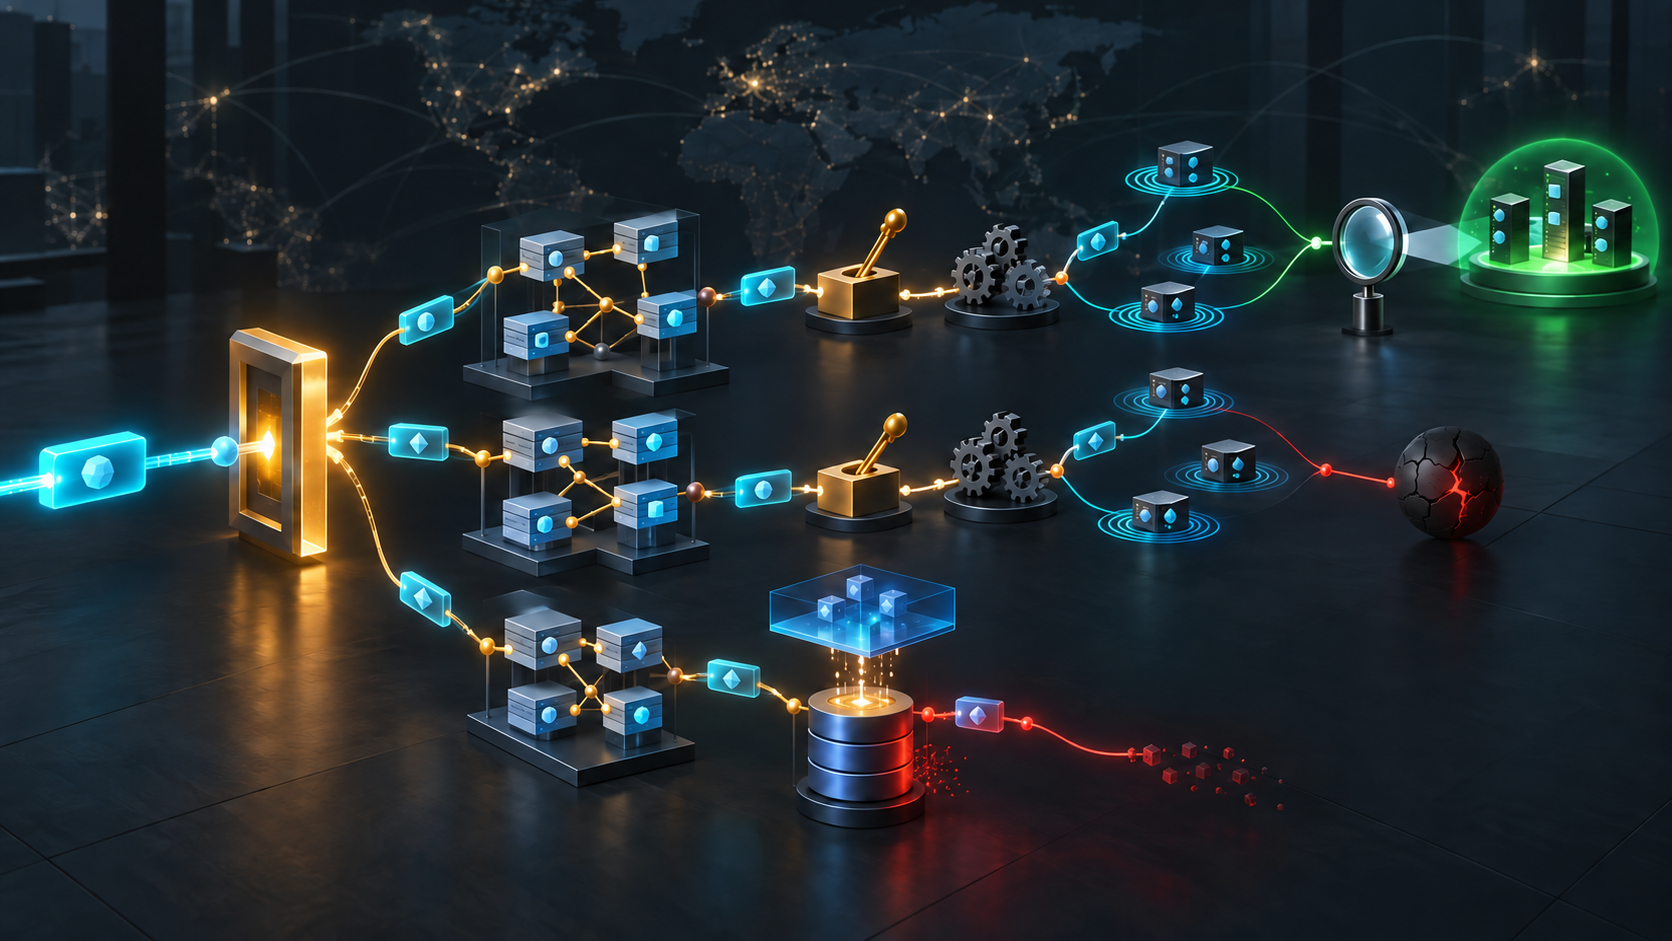
RFC 3512, publicado en abril de 2003 con categoría Informational, incluye precisamente este caso. Un agente acepta el primer SET, pero la red pierde la respuesta. El gestor reintenta. En la capa del protocolo, repetir el mismo valor puede parecer inocuo. En un subsistema con transiciones, asignaciones o estados intermedios, la segunda ejecución puede no significar lo mismo.
El silencio conserva dos futuros posibles. Una buena operación de configuración debe distinguirlos.
Un timeout no es un rollback
La expiración del gestor solo describe su observación: la respuesta no llegó dentro del plazo. No demuestra que la solicitud no llegó, que el agente la rechazó o que el subsistema no comenzó a actuar.
Por eso un reintento automático necesita más que igualdad de bytes. La idempotencia debe abarcar el efecto real. Establecer un valor estable puede ser repetible; crear una fila, asignar un índice, iniciar una tarea o activar una transición puede requerir una identidad de operación y deduplicación explícita.
RFC 3512 señala que el agente puede necesitar gestionar el estado intermedio o acumular varios SET antes de activar el conjunto de una vez. Si esa realidad no aparece en la MIB, el gestor observa mensajes pero no la transacción.
El recibo mínimo después de un timeout incluye consulta de estado, valores antes y después, identidad del objeto o fila, y evidencia de activación. Repetir primero y preguntar después invierte el orden de control.
La transacción excede un PDU
El documento define una aspiración de integridad: que el cambio completo se ejecute o no se ejecute. Después advierte que las transacciones pueden abarcar un objeto, varias filas, varias tablas o muchos equipos. La integridad en el nivel del protocolo no basta.
Un SET con varios varbinds puede mejorar eficiencia y, dentro de ciertas implementaciones, mantener juntos valores relacionados. Pero no crea por sí solo un commit distribuido. Tampoco garantiza que el proceso instrumentado acepte la combinación, que una dependencia exista o que todos los equipos activen en la misma ventana.
La aplicación debe comprender la MIB y los controles que coordinan las tablas. El modelo debe expresar qué significa preparado, comprometido, activo y fallido. La operación debe verificar qué ocurrió fuera del agente.
noError responde una pregunta acotada. Convertirlo en “el servicio cambió” añade una conclusión que el PDU nunca transportó.
Una fila creada todavía puede no servir
RowStatus permite crear y activar filas conceptuales. RFC 3512 explica que un objeto de estado puede coordinar datos de una tabla o que un objeto separado puede comprometer un conjunto grande.
Cuando existen relaciones entre tablas, sus destinos deben estar definidos. Si desaparece una fila referenciada, la otra puede eliminarse, invalidarse o conservar una referencia rota. Sin semántica explícita, el gestor no sabe qué reconstruir tras un fallo parcial.
Además, notInService no es un almacén indefinido. RFC 2579 permite que el agente retire filas que permanezcan demasiado tiempo en estados incompletos. Utilizar RowStatus como interruptor puede convertir una desactivación temporal en pérdida de configuración.
El recibo debe enumerar filas dependientes, claves, referencias y reglas de destino compartido. Una lista de SET exitosos no sustituye ese grafo.
Lo administrativo y lo operativo viven en tiempos distintos
RFC 3512 utiliza el ejemplo de una rueda a la que se ordena invertir el giro. El SET termina, pero una lectura inmediata puede mostrar todavía el sentido anterior mientras la rueda frena. Un solo objeto intentaba representar la orden y el movimiento presente.
La paradoja desaparece cuando el modelo separa estado administrativo y estado operativo. El primero dice qué se desea. El segundo muestra qué hace el sistema.
En una red, habilitar un proceso no prueba que haya vecinos, rutas, recursos o políticas aplicadas. La activación puede incluir latencia del subsistema, latencia de persistencia y latencia operativa. Cada una requiere un observable.
Esperar un número fijo de segundos no es verificación. El sistema debe observar la transición pertinente y registrar cuándo alcanzó el criterio definido.
Lo que funciona ahora quizá no sobreviva
RFC 3512 distingue configuración volátil de información persistente. Una operación puede modificar el comportamiento en ejecución sin actualizar el estado que se cargará al reiniciar.
Objetos como StorageType pueden describir la intención de almacenamiento, pero la plataforma y el agente deciden finalmente cómo y cuándo ocurre. La confirmación del protocolo no puede prometer una escritura durable que el subsistema no completó.
Hay que conservar tres recibos: aceptación, uso operativo y persistencia. Si solo se comprueba el segundo, el próximo reinicio se convierte en la primera prueba del tercero.
La restauración también depende de identidad. Los índices físicos y lógicos pueden cambiar, así que reproducir valores antiguos no garantiza reconstruir la misma relación. Un backup es material de recuperación; una restauración probada es evidencia diferente.
El error genérico pierde la causa
RFC 3512 recomienda no depender únicamente de errores SNMP para representar fallos de aplicación. badValue puede cubrir entrada inválida, falta de recursos, política de seguridad, defecto del agente o error posterior de evaluación.
También puede ocurrir que el protocolo acepte el valor y la aplicación falle después. Sin objeto de diagnóstico, notificación de finalización o estado operativo, el gestor no recibe la causa.
Las notificaciones de cambio deberían incluir quién inició la operación. Si otra vía —CLI, HTTP u otra herramienta— modifica el equipo, debe conservarse el mecanismo y la identidad disponibles. De lo contrario, el repositorio del gestor se vuelve un historial de sus propias acciones, no del dispositivo.
Después de una notificación, RFC 3512 aconseja recuperar la configuración relevante. La notificación anuncia un evento; no sustituye la imagen de estado.
Configurar incluye probar
El patrón pre-test, cambio y espera de convergencia, re-test coloca la verificación dentro del proceso. El pre-test evita culpar al cambio por una inestabilidad anterior. La espera reconoce que el sistema tiene dinámica. El re-test comprueba comportamiento.
No es una garantía absoluta. Los defectos lentos pueden aparecer fuera de la ventana; otros nodos pueden bloquear convergencia; una métrica estable puede ocultar otra dependencia.
Por eso la prueba debe nombrar el servicio y su horizonte temporal. Si el cambio pretende producir conectividad, política o resolución, el recibo final pertenece a esa función, no al mensaje de gestión.
Cerrar el ticket en el segundo SET exitoso habría sido fácil. Cerrar la incertidumbre exige saber qué hicieron ambos intentos y qué estado quedó vivo.
De RFC 3535 a una separación más explícita
RFC 3535, informe Informational del taller IAB de mayo de 2003, describe a SNMP como fuerte para monitorización, pero registra poca implantación de MIB escribibles, complejidad transaccional, dificultad de rollback y reproducción, y una distancia entre tareas del operador y objetos centrados en datos.
RFC 6241 definió después NETCONF y separó datos de configuración y datos de estado, con capacidades transaccionales explícitas cuando están soportadas. RFC 8342 distinguió configuración running, intended y estado operativo.
Esos documentos posteriores afinan el vocabulario, no demuestran que una tecnología nueva cierre automáticamente el ciclo. Tampoco deben proyectarse como requisitos que RFC 3512 ya contenía.
El problema común sigue intacto: saber si una solicitud fue aceptada no basta para saber qué realidad quedó después.
El recibo para un reintento seguro
Guardar identidad del cambio, iniciador y acceso, request-id, equipo y software, revisión MIB, capacidades, valores previos, valores posteriores y hora de cada intento.
Vincular las filas y tablas afectadas, controles de activación, estado administrativo, estado operativo, transición del subsistema y destino de persistencia. Registrar la respuesta perdida como desconocida, no como fallo demostrado.
Tras un timeout, consultar el estado antes de repetir. Si se repite, usar una identidad que permita deduplicar donde el sistema lo soporte. Después, verificar dependencias, convergencia y servicio, y conservar el material de rollback.
Solo una cadena así distingue “el mensaje se repitió” de “el cambio se ejecutó una sola vez y produjo el estado previsto”.
Límite de evidencia
Este Artículo no identifica proveedor, producto, equipo, red, cliente, cambio real, interrupción o incidente. No estima el uso actual de SNMP para configuración ni afirma que todos los reintentos tengan efectos laterales.
RFC 3512 se describe como guía Informational de abril de 2003. RFC 3535 es un informe de taller. RFC 6241 y RFC 8342 son referencias Standards Track posteriores y no requisitos retroactivos.
Los principios de especificación mínima y primacía del código en ejecución de Heng Lu son lentes editoriales declaradas, no evidencia sobre SNMP ni intención de los autores de los RFC.
La conclusión es limitada: cuando se pierde una respuesta, reintentar no responde qué efecto tuvo la primera operación.
Fuentes
- https://bib.ietf.org/public/rfc/bibxml/reference.RFC.2579.xml
- https://bib.ietf.org/public/rfc/bibxml/reference.RFC.3411.xml
- https://bib.ietf.org/public/rfc/bibxml/reference.RFC.3512.xml
- https://datatracker.ietf.org/api/v1/doc/document/rfc3512/?format=json
- https://datatracker.ietf.org/doc/rfc3512/
- https://datatracker.ietf.org/doc/rfc3512/history/
- https://heng.lu/minimum-initial-specification-localized-future-decision-voluntary-adoption-internet-coordination-system/
- https://heng.lu/running-code-primary-the-patch-needed-to-preserve-the-internet-original-design/
- https://www.rfc-editor.org/errata_search.php?rfc=3512
- https://www.rfc-editor.org/info/rfc3512
- https://www.rfc-editor.org/rfc/rfc2579.html
- https://www.rfc-editor.org/rfc/rfc3410.html
- https://www.rfc-editor.org/rfc/rfc3411.html
- https://www.rfc-editor.org/rfc/rfc3412.html
- https://www.rfc-editor.org/rfc/rfc3413.html
- https://www.rfc-editor.org/rfc/rfc3414.html
- https://www.rfc-editor.org/rfc/rfc3415.html
- https://www.rfc-editor.org/rfc/rfc3416.html
- https://www.rfc-editor.org/rfc/rfc3417.html
- https://www.rfc-editor.org/rfc/rfc3418.html
- https://www.rfc-editor.org/rfc/rfc3512.html
- https://www.rfc-editor.org/rfc/rfc3512.txt
- https://www.rfc-editor.org/rfc/rfc3535.html
- https://www.rfc-editor.org/rfc/rfc6241.html
- https://www.rfc-editor.org/rfc/rfc8342.html
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance