
Zusammenfassung
- Traefik Labs ist das private Unternehmen mit Open-Core-Modell hinter Traefik Proxy, einem quelloffenen Reverse-Proxy und Ingress-Controller, für den Gründer Emile Vauge 2015 den ersten Code schrieb. Das Unternehmen wurde 2016 unter dem Namen Containous gegründet und 2020 in Traefik Labs umbenannt.
- Die bestimmende technische Idee von Traefik ist die von Providern gesteuerte dynamische Konfiguration: Es überwacht Docker, Kubernetes, Dateien und andere Infrastrukturquellen und übersetzt dann Service-Metadaten in Router, Services und Middleware, ohne bei jeder Änderung eine statische Proxy-Konfigurationsdatei neu schreiben zu müssen.
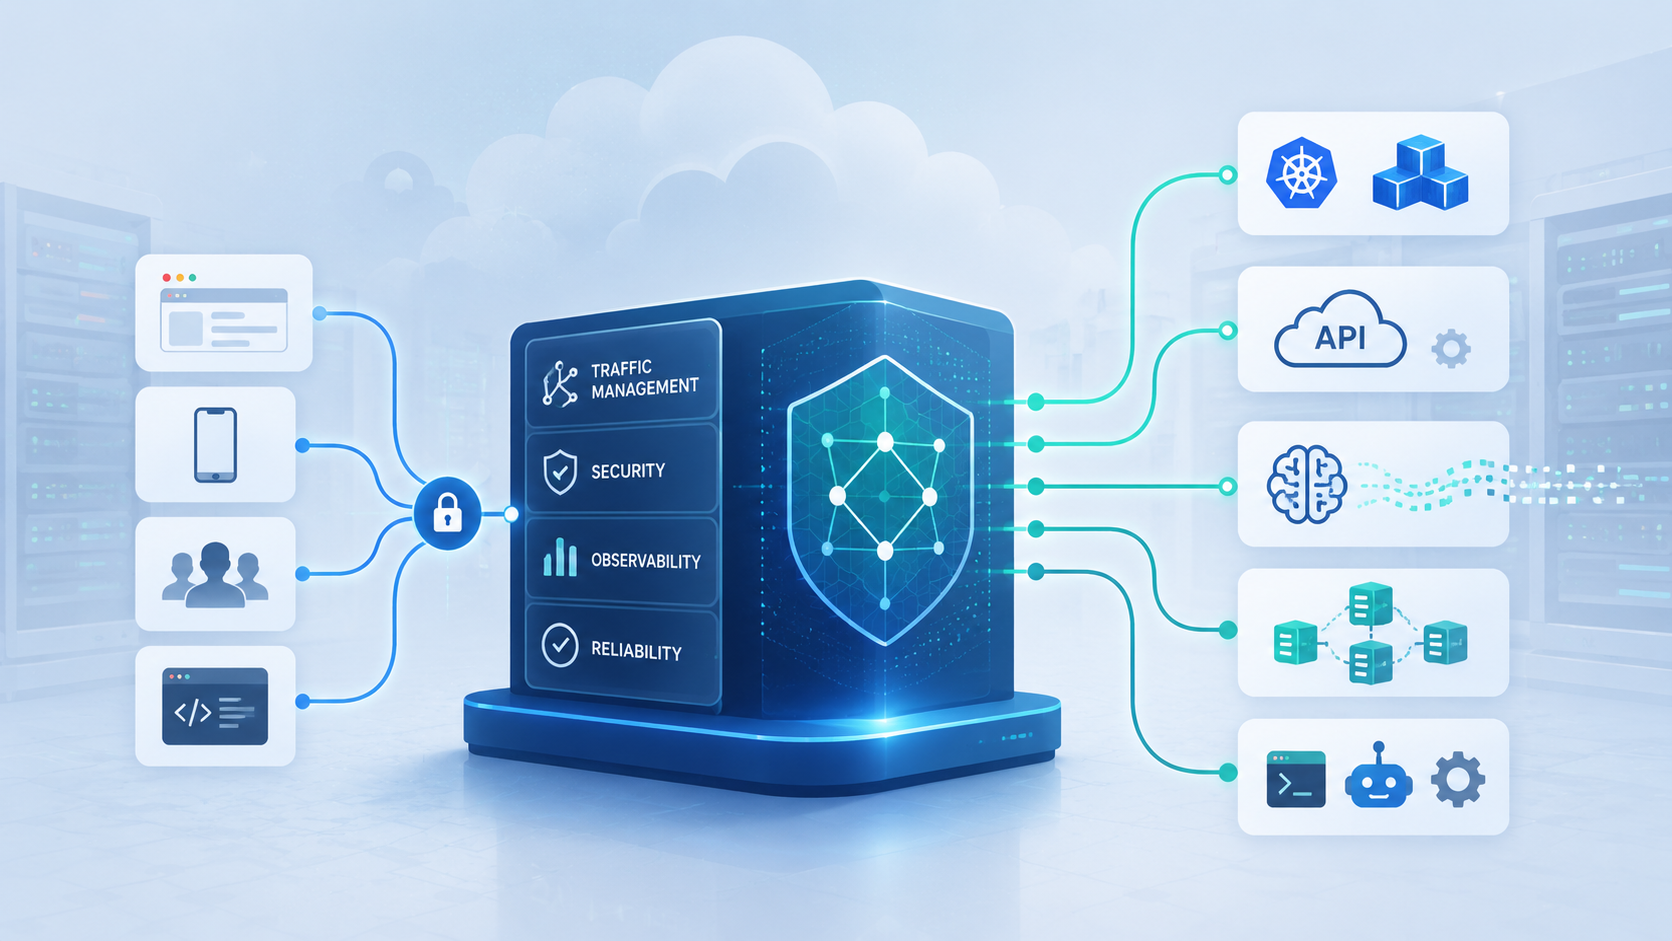
- Die kommerzielle Reichweite geht über die Ingress-Funktion hinaus. Traefik Hub fügt API-Gateway, Discovery, Richtlinien und Verwaltung hinzu, während AI Gateway und MCP Gateway die Gateway-Logik auf Modellanbieter, Prompts, Agentenverbindungen, Server und Tools ausdehnen.
- Die Verbreitungskennzahlen sind beeindruckend, bedürfen aber einer genauen Lesart. Im Juli 2026 gab das Projekt 1.000 Mitwirkende und 3,5 Milliarden Pulls der offiziellen Docker-Images bekannt; keine dieser Zahlen stellt eine eindeutige Anzahl von Produktionsbereitstellungen, Kunden oder Benutzern dar.
- Die strategische Chance besteht darin, dass Traefik zu einer gemeinsamen Policy-Schicht für Anwendungs- und Agenten-Traffic wird. Das Gegenrisiko ist die Konzentration: Ein Gateway, das TLS terminiert, Benutzer authentifiziert, Header umschreibt, Backends auswählt und Tools autorisiert, könnte zu einem breiten Engpass für Sicherheit und Verfügbarkeit werden.
Gateway-Unternehmen, kein Netzbetreiber
Traefik Labs nimmt in der digitalen Infrastruktur eine Position ein, die operativ leicht zu erkennen ist, kommerziell jedoch häufig falsch eingeordnet wird. Es besitzt kein globales Content Delivery Network, stellt keine Cloud-Computing-Kapazität bereit, betreibt kein autonomes System und verkauft keine Zugangskonnektivität. Seine Software läuft normalerweise in einer Infrastruktur, die der Kunde auswählt und verwaltet.
Dennoch kann das Unternehmen direkt im Pfad des Produktionsverkehrs stehen: Eine Traefik-Instanz kann eine Verbindung akzeptieren, bevor die Anwendung sie sieht, die Verschlüsselung terminieren, bestimmen, welches Backend sie empfängt, Authentifizierung erzwingen, Header ändern, Ratenbegrenzungen anwenden und operative Signale aufzeichnen.
Diese Position verleiht dem Unternehmen eine Bedeutung, die über die scheinbare Größe eines Proxy-Ausführungsprofils hinausgeht. Das Gateway ist ein Entscheidungspunkt zwischen externer Anfrage und internen Diensten. Wenn die Entscheidung richtig ist, können Anwendungsteams schneller bereitstellen und Infrastrukturteams wiederkehrende Kontrollen vereinheitlichen.
Wenn sie falsch ist, kann ein syntaktisch korrekter Pfad eine Verwaltungsschnittstelle offenlegen, eine Policy-Kette einem gefälschten Identitätssignal vertrauen, ein Zertifikatsfehler viele Anwendungen stoppen oder eine einzige Konfigurationsänderung den Verkehr in einer großen Umgebung umleiten.
Daher ist das rechtliche und institutionelle Subjekt Traefik Labs, das private Softwareunternehmen, nicht nur Traefik Proxy allein. Das offene Projekt hat ein Repository, Mitwirkende, Releases, Issues, Lizenzbedingungen und Sicherheitshinweise. Das Unternehmen beschäftigt wichtige Maintainer, kontrolliert die kommerziellen Produkte, verkauft Support und Enterprise-Funktionen und nutzt die breite Vertrautheit mit dem Proxy als Vertriebskanal für das Open-Core-Modell. Die beiden sind eng verbunden, aber sie sind nicht eine einzige rechtliche oder institutionelle Einheit.
Die nachgewiesene operative Struktur umfasst Traefik Labs SAS in Frankreich und Traefik Labs, Inc. für einige Aktivitäten außerhalb Europas. Die aktuellen rechtlichen Unterlagen nennen das französische Unternehmen in der 132 rue Bossuet, Lyon, mit der SIREN-Nummer 818103475. Es gibt keine öffentlich zugänglichen konsolidierten, geprüften Abschlüsse, keine vollständige Cap Table, keine aktuelle Bewertung, keine nach Produkt aufgeschlüsselten Umsätze und keine verifizierte Kundenzahl.
Ein verantwortungsbewusstes Profil kann erklären, wie das Unternehmen Wert schafft, ohne finanzielle Ergebnisse zu erfinden, die den erfassten Anteil überschätzen.
Das Problem, das Traefik im Container-Zeitalter lösen sollte
Traditionelle Reverse-Proxy-Operationen wurden für Umgebungen konzipiert, in denen sich Backend-Dienste relativ langsam ändern. Ein Administrator konnte eine Serverliste definieren, Virtual Hosts konfigurieren, die Datei testen und den Proxy neu laden. Dieses Modell funktionierte in stabilen Umgebungen, aber Container und Orchestratoren veränderten das Tempo und die Zuständigkeit für Änderungen. Dienste konnten erstellt, neu geplant, skaliert, ersetzt oder gelöscht werden, während Anwendungen weiterliefen. Die Backend-Adresse wurde weniger dauerhaft als die Dienstidentität, die durch Orchestrierungs-Metadaten repräsentiert wird.
In dieser Umgebung fügt jeder manuelle Konfigurationsschritt Zeit und Fehlermöglichkeiten hinzu. Ein Bereitstellungssystem kann einen neuen Dienst in Sekunden starten, aber er ist für den externen Client erst nutzbar, wenn die Verkehrsschicht von seiner Existenz weiß. Die menschliche Ticketwarteschlange kann zur langsamsten Komponente einer automatisierten Plattform werden.
Das erneute Schreiben einer Datei und das erneute Laden des Proxys bei jedem Ereignis erzeugen zudem Wettlaufbedingungen: Die Konfiguration könnte auf einen Endpunkt verweisen, der bereits verschwunden ist, einen bereiten Endpunkt verpassen oder einen veralteten Zustand beibehalten, der von einem anderen Automatisierungsprozess erzeugt wurde.
Traefiks Antwort bestand darin, den Proxy die Infrastrukturquelle überwachen zu lassen, die den gewünschten Zustand bereits kennt. Docker-Labels, Kubernetes-Ressourcen, Dateien und andere Provider-Schnittstellen werden zu Eingaben. Traefik interpretiert diese Eingaben und gleicht die Routing-Objekte zur Laufzeit ab. Der Vorteil liegt nicht nur in der Generierung von Konfiguration; vielmehr bewegen sich die Bereitstellungsdaten der Anwendung und das Netzwerkverhalten innerhalb einer einzigen operativen Schleife.
Das Designziel wurde manchmal als „Netzwerke langweilig machen“ beschrieben. Das Wort meint nicht, dass sie unwichtig sind, sondern dass sie so vorhersehbar sind, dass ein Entwickler für jede Route oder jedes Zertifikat kein Ticket an einen Spezialisten benötigt. Ein Dienst erscheint mit seinen gewünschten Metadaten, das Gateway entdeckt ihn, die Route wird verfügbar und die Zertifikatsautomatisierung kümmert sich um die wiederkehrende Aufgabe. So kann die Organisation ihre knappe Netzwerkkompetenz für Plattformentwurf, Sicherheitsgrenzen und Ausnahmefehler einsetzen, anstatt für das routinemäßige Exponieren von Diensten.
Der Kompromiss ist ebenso wichtig: Metadaten werden zur durchsetzbaren Netzwerkpolitik. Ein Label, eine Annotation oder eine benutzerdefinierte Ressource ist nicht mehr nur eine Beschreibung; sie könnte festlegen, wer auf einen Dienst zugreifen darf und welche Kontrollen auf dem Weg dorthin gelten. Die Frage verschiebt sich von „Wer kann die Proxy-Konfigurationsdatei bearbeiten?“ zu „Welche Identitäten dürfen Metadaten veröffentlichen, denen der Proxy vertraut, und in welchen Namespaces und für welche Ressourcen?“.
Die Automatisierung reduziert Übergaben, beseitigt jedoch nicht die Autorität; sie verlagert sie in das Orchestrierungssystem und die Richtlinien.
Von Emile Vauges Code zu Containous
Emile Vauge schrieb 2015 den ersten Traefik-Code. Die Entstehungsgeschichte des Projekts sollte von der Unternehmensgeschichte getrennt werden, die darauf aufbaut. Traefik begann als Software zur Lösung eines praktischen Container-Netzwerkproblems, während die kommerzielle Einheit 2016 unter dem Namen Containous gegründet wurde. Diese Ein-Jahres-Differenz beseitigt die häufige Verwirrung: 2015 markiert den Code-Beginn, 2016 die Gründungsphase des Unternehmens.
Das frühe Projekt profitierte von einem klaren, demonstrierbaren Anwendungsfall. Entwickler konnten Traefik neben Docker starten und die Service-Labels das Routing bestimmen lassen. Als Kubernetes wuchs, wurde Ingress zu einem weiteren natürlichen Bereitstellungspunkt. Die automatische Zertifikatsbeschaffung über ACME reduzierte eine zweite Klasse sich wiederholender Arbeit. Der Wert des Projekts konnte getestet werden, bevor ein Kaufprozess stattfand – einer der stärksten Vertriebsvorteile, die offene Infrastruktursoftware bieten kann.
Containous gab dem Projekt eine Struktur für kommerziellen Support und Produktentwicklung. Das Unternehmen konnte Ingenieure einstellen, die Dokumentation pflegen, Unternehmensfunktionen entwickeln, Support anbieten und Kunden ansprechen, deren Anforderungen die der Community-Installation überstiegen. Es konnte auch in Integrationen investieren, die den Proxy über mehrere Infrastrukturanbieter hinweg nützlich machten. Die geschäftliche Herausforderung bestand darin, Einnahmen um ein Werkzeug herum aufzubauen, dessen Kernattraktivität in der kostenlosen Adoptionsfreundlichkeit lag.
Zwischen 2016 und 2019 wurde Traefik stark mit Docker und Kubernetes Ingress assoziiert. Diese Assoziation war ein Vorteil, da sie das Projekt in einen der am schnellsten wachsenden Bereiche der Infrastruktursoftware platzierte, aber sie war auch eine Einschränkung: Ein Unternehmen, das nur als Ingress-Controller bekannt war, konnte als austauschbare Cluster-Komponente und nicht als Unternehmens-Policy-Plattform behandelt werden. Ein großer Teil der späteren Strategie von Traefik Labs lässt sich als Versuch verstehen, den Vorteil der dynamischen Erkennung beizubehalten und gleichzeitig die wirtschaftliche Kategorie darum herum zu erweitern.
Der Firmenname schuf eine zusätzliche Inkongruenz. Entwickler kannten Traefik, während Investoren, Mitarbeiter und Kunden mit Containous zu tun hatten. Als das Projekt zum Adoptionstreiber wurde und das Portfolio wuchs, machte es Sinn, die Unternehmensmarke mit dem Projektnamen zu vereinen. Daher war die Umbenennung im Jahr 2020 nicht nur kosmetisch; sie war ein Eingeständnis, dass der offene Name die größte Marktbekanntheit besaß, und eine engere Verknüpfung zwischen dem Vertrauen der Community und der kommerziellen Identität des Unternehmens.
Die Architektur: Entrypoints, Provider, Router, Services und Middleware
Das operative Modell von Traefik lässt sich anhand einer kleinen Reihe von Konzepten verstehen, die die Netzwerk-Exposition, Entdeckung, Zuordnung, Zustellung und Richtlinie trennen. Entrypoints definieren, wo der Verkehr in das Gateway eintritt, typischerweise durch Bindung an Ports und Protokolle. Provider liefern Konfiguration aus Infrastrukturquellen. Router entscheiden, ob eine Anfrage einer Regel entspricht. Services repräsentieren Backends, die die Anfrage verarbeiten können. Middleware verändert, filtert oder autorisiert den Verkehr zwischen Zuordnung und Zustellung.
Ein Entrypoint ist die Grenze, an der das Gateway mit der Annahme von Verkehr beginnt; er kann HTTP, verschlüsseltes HTTPS oder ein anderes unterstütztes Protokoll darstellen. Er ist Teil der statischen Bereitstellungsform, da er Listener, Adressen und grundlegendes Transportverhalten definiert. Plattformteams können öffentlichen und internen Verkehr, Verwaltungsschnittstellen oder Protokollklassen trennen, aber die Stärke der Trennung hängt vom umgebenden Netzwerk und dem Bereitstellungsdesign ab.
Provider verbinden Traefik mit der sich ändernden Infrastruktur. Der Docker-Provider kann Labels und Container-Status abtasten; der Kubernetes-Provider kann Ingress, benutzerdefinierte Traefik-Ressourcen oder Gateway-API-Ressourcen beobachten. Der Datei-Provider lädt dynamische Objekte aus Konfigurationsdateien. Die Provider-Schicht ist nicht nur ein bequemer Adapter; ihre Berechtigungen bestimmen, was Traefik sieht, und damit den Umfang der Autorität, die für das Routing abgeleitet werden kann.
Router drücken die Zuordnungslogik aus; sie können Hostnamen, Pfade, Header, Methoden und protokollspezifische Bedingungen auswerten. Wenn eine Anfrage an einem Entrypoint eintrifft, bestimmen die Zuordnungsregeln und die Priorität, welcher Router sie übernimmt, und dieser Router verweist dann auf Middleware und einen Service. Die Einfachheit der Abstraktion macht gängige Bereitstellungen verständlich, aber sich überschneidende Regeln können ein Ergebnis liefern, das zwar gemäß der Priorität korrekt, für den Betreiber jedoch überraschend ist.
Services repräsentieren die Zustellungsseite: Sie definieren die Backend-Server oder andere Ziele und verteilen Anfragen unter ihnen. Health Checks, Sticky Sessions und Transporteinstellungen können die Zustellung formen. Die dynamische Erkennung hilft, die Mitgliedschaft mit dem Orchesterzustand in Einklang zu halten, beweist jedoch nicht, dass eine Anwendung, die eine nominell „gesunde“ Antwort zurückgibt, aus geschäftlicher Sicht ein korrektes Ergebnis liefert. Anwendungsgesundheit und geschäftliche Überwachung bleiben getrennte Verantwortlichkeiten.
Middleware bietet wiederverwendbare Richtlinien. Eine Komponente kann umleiten, eine andere Header entfernen oder hinzufügen, eine dritte authentifizieren, eine vierte die Rate begrenzen, eine fünfte den Pfad umschreiben. Ketten bieten Kombinierbarkeit, machen aber auch die Reihenfolge zu einem Teil des Sicherheitsmodells. Eine Anfrage, die vor der Authentifizierung geändert wird, kann sich anders verhalten als eine, die danach geändert wird. Wiederverwendbare Komponenten reduzieren Wiederholungen nur dann, wenn die Teams die gesamte zusammengesetzte Pipeline verstehen.
Der Reiz der Architektur liegt darin, dass ihre Konzepte mit der organisatorischen Arbeit übereinstimmen. Plattformteams legen Entrypoints, Provider und Schutzmaßnahmen fest; Anwendungsteams drücken ihre Routing-Absicht aus; Sicherheitsteams legen Authentifizierungs- und Header-Richtlinien fest; Betriebsteams wahren die Verfügbarkeit und führen Upgrades durch. Das Modell kann Self-Service unterstützen, ohne zentrale Kontrolle zu beseitigen, aber die Verteilung der Verantwortlichkeiten ist eine organisatorische Entscheidung, keine automatische Eigenschaft der Software.
Statische und dynamische Konfiguration und die Reconciliation-Schleife
Traefik trennt statische von dynamischer Konfiguration. Die statische Konfiguration richtet die Prozessumgebung ein: Entrypoints, aktivierte Provider und andere Startparameter. Änderungen in dieser Schicht erfordern normalerweise einen Neustart oder eine neue Bereitstellung. Die dynamische Konfiguration umfasst Router, Services und Middleware, die aktualisiert werden können, während das Gateway läuft. Diese Trennung ist grundlegend, um Infrastrukturereignisse in lebendiges Routing-Verhalten zu verwandeln.
Die Trennung schützt die Laufzeit davor, dass jede Datenquelle jeden Aspekt des Gateways ändern kann. Ein Kubernetes-Objekt kann eine Route definieren, sollte aber nicht unbedingt einen neuen Listener öffnen oder einen Provider aktivieren können. Die statischen Einstellungen bilden die äußere Betriebshülle, und die dynamischen Objekte arbeiten darin. Dies schafft eingebaute Governance-Grenzen, aber die Betreiber müssen sie bewusst gestalten.
Die Reconciliation-Schleife ist der praktische Mechanismus. Ein Provider beobachtet eine Quelle, erkennt eine Änderung des gewünschten Zustands, übersetzt sie in Traefik-Objekte und aktualisiert die Laufzeitkonfiguration. Ein Mensch muss nach jedem Ereignis keine vollständige Datei generieren; das System vergleicht kontinuierlich die Beschreibung der Infrastrukturquelle mit dem, was angewendet werden soll. Dies ist ein bekanntes Muster in Kubernetes-Controllern: deklarative Absicht in laufenden Zustand umwandeln.
Reconciliation reduziert die Konfigurationslatenz, schafft aber neue Fehlermodi. Der Ereignisstrom kann sich verspäten; ein Provider kann Berechtigungen oder Konnektivität verlieren; der Orchestrator kann ein Objekt akzeptieren, das das Gateway ablehnt; verschiedene Controller können verwandte Ressourcen unterschiedlich interpretieren; der Status kann hinter dem tatsächlichen Verkehrsverhalten zurückbleiben. Der Betreiber benötigt daher Einblick in das Quellobjekt und die Traefik-Interpretation; die Überwachung nur einer Seite reicht nicht aus.
Die Unterscheidung zwischen statisch und dynamisch prägt die Incident-Response. Eine Routenkorrektur kann schnell über eine dynamische Ressource angewendet werden, während die Änderung eines Provider-Bereichs, eines Listeners oder einer Netzwerkvertrauensgrenze einen kontrollierten Neustart erfordert. Es ist wichtig, vor einer Krise zu wissen, in welche Kategorie eine vorgeschlagene Lösung fällt. Alle Konfiguration als gleichermaßen dynamisch zu behandeln, erzeugt falsche Erwartungen hinsichtlich Wiederherstellungszeit und Rollback.
Ein ausgereifter Betrieb testet den Reconciliation-Pfad selbst: Kann ein autorisiertes Subjekt eine Route veröffentlichen? Wird ein nicht autorisierter Namespace blockiert? Entfernt eine Löschung die Exposition? Erzeugt eine ungültige Konfiguration einen beobachtbaren Status? Verhält sich ein Provider-Ausfall vorhersehbar? Das operative Produkt ist nicht nur die endgültige Route, sondern die gesamte Kette von der Anwendungsabsicht bis zum abgeglichenen Netzwerkzustand.
Service Discovery verwandelt Metadaten in Netzwerkpolitik
Service Discovery war der Grund, warum Traefik sich in Container-Plattformen nativ anfühlte, nicht nachträglich hinzugefügt. Der Orchestrator verfügt bereits über Informationen zu Services, Endpunkten, Labels, Namespaces und der gewünschten Replika-Zahl. Traefik konsumiert ausgewählte Teile davon, anstatt ein separates Inventar abzufragen. Dies reduziert Doppelarbeit und ermöglicht es Routen, Workloads zu folgen, wenn die Plattform sie neu plant.
Der Mechanismus ist wirkungsvoll, weil der Dienstname wichtiger wird als eine einzelne Serveradresse. Eine Backend-Instanz kann verschwinden und eine andere ihren Platz einnehmen, während die Route stabil bleibt. Der Provider gleicht die Service-Mitgliedschaft ab, und neue Anfragen werden an die aktuelle Gruppe gesendet. Für Plattformteams richtet sich das Gateway nach derselben Control Plane, die auch für Bereitstellung und Skalierung verwendet wird.
Die sicherheitstechnische Konsequenz ist, dass der Discovery-Bereich zum Autoritätsbereich wird. Ein Provider mit Leseberechtigung für den gesamten Cluster kann Ressourcen vieler Teams sehen. Wenn das Gateway Cross-Namespace-Referenzen akzeptiert oder Daten über Mandantengrenzen hinweg vertraut, könnte ein Workload versuchen, die Exposition oder Richtlinie eines anderen Workloads zu beeinflussen. Die genaue Syntax variiert je nach Bereitstellung, aber Least Privilege, Namespace-Grenzen und explizite Referenzrichtlinien sind unerlässlich.
Zugangskontrollen können unsichere Objekte blockieren, bevor sie das Orchester-System erreichen. Policy-Engines können erlaubte Entrypoints, Host-Muster, Zertifikatsanbieter, Middleware-Referenzen und Namespace-Beziehungen durchsetzen. Statische Analyse kann sich überschneidende Routen und verbotene Annotationen erkennen. Diese Kontrollen sind am wirksamsten, bevor die Konfiguration das Gateway erreicht, benötigen aber eine Laufzeitüberprüfung, da die endgültige Interpretation durch den Controller und die Data Plane erfolgt.
Metadaten werfen eine Change-Management-Frage auf. Ein Entwickler sieht ein Routing-Label vielleicht als Teil des Anwendungsmanifests, während ein Sicherheitsteam es als Entscheidung über externe Exposition betrachtet. Beide Interpretationen sind gültig. Die Review-Prozesse sollten dem Ausmaß der Auswirkung entsprechen: Eine Änderung eines internen Pfads mag geringes Risiko darstellen, das Hinzufügen eines öffentlichen Hosts, das Überspringen der Authentifizierung oder das Verweisen auf eine gemeinsam genutzte Middleware erfordert jedoch eine strengere Genehmigung.
Die weitergehende Lehre ist, dass Cloud-native Netzwerke die Konfiguration nicht beseitigen; sie verteilen sie und machen sie ereignisgesteuert. Die Proxy-Konfigurationsdatei mag aus dem täglichen Betrieb verschwinden, aber die Routing-Absicht existiert in Labels, Annotationen, benutzerdefinierten Ressourcen, Helm-Values, Git-Repositories, Admission-Policies und Provider-Berechtigungen. Der Komfort von Traefik ist real, hängt jedoch von einer Governance ab, die die Konfiguration an diesen neuen Orten verfolgt.
Routing, Priorität, Health und die Grenzen der Automatisierung
Ein Gateway muss viele potenziell überlappende Deklarationen in eine einzige Entscheidung pro Anfrage umwandeln. Traefik-Router können Hosts, Pfade, Header, Methoden und andere Attribute abgleichen. Dies gibt Anwendungsteams eine große Ausdruckskraft, bedeutet aber, dass zwei Routen, jede für sich vernünftig, zusammen mehrdeutig sein können. Prioritätsregeln bestimmen den Gewinner, nicht die ungeschriebene Absicht des Betreibers.
Daher reicht es nicht aus, nur erfolgreiche Pfade zu testen. Die Verifizierung muss sicherstellen, dass die erwartete Anfrage die beabsichtigte Anwendung erreicht und dass Verwaltungspfade, unerwartete Hosts, fehlerhafte Header und alternative Methoden sicher abgelehnt oder umgeleitet werden. Negative Tests decken Lücken auf, die normale Health Checks übersehen, insbesondere wenn mehrere Teams unabhängig voneinander Routen aus getrennten Repositories generieren.
Load Balancing hat ähnliche Grenzen. Traefik kann Anfragen auf entdeckte Backends verteilen und Health Checks verwenden, um ausgefallene Endpunkte zu entfernen. Sticky Sessions und Transporteinstellungen können bestimmten Anwendungen dienen. Diese Funktionen verbessern die Verfügbarkeit, beweisen jedoch nicht, dass ein Backend ein korrektes Geschäftsergebnis liefert; es kann mit veralteten Daten einen HTTP-Erfolg zurückgeben, Schreibvorgänge ablehnen oder von einem ausgefallenen Subsystem abhängen.
Das Gateway sieht nur einen Teil der Transaktion. Es kennt möglicherweise die Verbindungszeit, den Status und das gewählte Backend, weiß aber nicht unbedingt, ob die Anwendung eine Geschäftsoperation korrekt autorisiert hat. Es kann externe Richtlinien durchsetzen, ersetzt aber nicht die Anwendungsverifikation. Die Vereinheitlichung von Authentifizierung oder Ratenbegrenzungen kann Wiederholungsarbeit reduzieren, macht jedoch einen unsicheren Endpunkt nicht allein dadurch sicher, dass er das Gateway passiert.
Die Automatisierung verstärkt sowohl gute als auch schlechte Entscheidungen. Eine korrekte Route kann über Umgebungen hinweg mit weniger manuellem Drift repliziert werden, eine fehlerhafte Vorlage kann denselben internen Dienst überall offenlegen. Eine gute Middleware-Kette kann die Identitätsbehandlung vereinheitlichen, eine fehlerhafte Kette kann eine Schwachstelle in jeder Anwendung verbreiten, die sie wiederverwendet. Der Wert eines gemeinsam genutzten Gateways hängt daher von Tests und Change-Kontrolle ab, die dem Umfang der Wiederverwendung entsprechen.
Das sicherste Muster ist oft graduell: Linting der Konfiguration, Evaluierung in einer Staging-Umgebung, Bereitstellung auf einer begrenzten Instanz, Überwachung und anschließende Ausweitung. Kritische Dienste können von weniger vertrauenswürdigen Workloads isoliert werden, während dieselbe Software verwendet wird. Redundante Instanzen mildern Prozessausfälle, schützen jedoch nicht vor einem Konfigurationsfehler, der auf jede Replika auf dieselbe Weise verteilt wird.
Middleware-Ketten und die Grenzen der Identität
Middleware verwandelt Traefik von der Verkehrslenkung in die Verkehrsregelung. Weiterleitungen, Pfadumschreibungen, Authentifizierung, Header-Operationen, Ratenbegrenzungen und mehr können in Ketten zusammengesetzt und an Router gebunden werden. Das Modell ermöglicht es Plattformteams, genehmigte Kontrollen als wiederverwendbare Blöcke bereitzustellen, anstatt von jeder Anwendung zu verlangen, dasselbe externe Verhalten selbst zu implementieren.
Die Identitätsbehandlung gehört zu den riskantesten Anwendungen. Das Gateway kann einen Benutzer über einen externen Dienst authentifizieren und die Identitätsinformationen dann in Headern an die Anwendung weitergeben. Die nachgelagerte Anwendung vertraut darauf, dass das Gateway alle vom Angreifer bereitgestellten Kopien entfernt und vertrauenswürdige Werte setzt. Die Sicherheitsgrenze ist nicht allein ein Header-Name, sondern die gesamte Vertrauenskette des Proxys: Normalisierung, Löschung, Einfügung, Netzwerkzugriff und die Bereitschaft der Anwendung, nicht vertrauenswürdigen direkten Verkehr abzulehnen.
Die Traefik-Sicherheitsmeldung vom Juli 2026 verdeutlichte die Empfindlichkeit dieser Grenzen. In einigen betroffenen Authentifizierungs-Middleware-Konfigurationen konnte die Behandlung von Unterstrichen und Header-Namen dazu führen, dass nicht vertrauenswürdige Formen bestehen blieben, was einem Spoofing einer Identität ermöglichte, der die Anwendung vertraute. Dies erforderte ein Upgrade auf korrigierte Versionen und eine Überprüfung der Konfiguration.
Die Lehre ist nicht, dass die gesamte Traefik-Authentifizierung für immer unsicher war, noch dass ein Patch das architektonische Risiko beseitigte; es geht darum, dass die Kanonisierung von Headern und Vertrauensannahmen entscheidende Sicherheitsdetails sind.
Middleware-Reihenfolge kann ähnliche Probleme ohne Softwarefehler verursachen. Eine Umschreibung kann den Pfad ändern, den die Autorisierungskomponente sieht; ein Header-Zusatz kann einen unerwarteten Wert überschreiben oder bewahren; eine Ratenbegrenzung vor oder nach der Identitätsauflösung kann die Gruppierung verändern; eine Umleitung kann den Client zu einem Host mit anderen Kontrollen senden. Wiederverwendbare Ketten benötigen explizite Semantik, Versionierung und Tests.
Eigentümerschaft ist ebenso wichtig wie Syntax. Wenn Anwendungsteams jede Middleware binden können, könnten sie zentrale Kontrollen umgehen; wenn ein zentrales Team Erstellung und Referenzierung monopolisiert, könnte der Self-Service verlangsamt werden. Ein ausgewogenes Design trennt Erstellung von Bindung: Sicherheits- oder Plattformteams pflegen genehmigte Komponenten, und Anwendungsteams wählen aus autorisierten Richtlinien innerhalb von Namespace- und Host-Beschränkungen.
Das Gateway wird nur dann zu einer starken Identitätsgrenze, wenn der direkte Zugriff auf die Anwendung unterbunden ist. Umgeht ein Angreifer Traefik und erreicht ein Backend, das Gateway-Headern vertraut, wird die externe Authentifizierungsrichtlinie wertlos. Netzwerkrichtlinien, Service-Exposition, mTLS oder andere Maßnahmen müssen sicherstellen, dass vertrauenswürdige Identitätssignale nur über den autorisierten Pfad ankommen.
TLS-Automatisierung konzentriert gleichermaßen Komfort und Risiko
Die automatisierte Zertifikatsverwaltung trug dazu bei, Traefik für Entwickler attraktiv zu machen. Über ACME und konfigurierte Zertifikatsanbieter kann das Gateway Zertifikate beschaffen, erneuern, verschlüsselte Sitzungen terminieren und die Protokollrichtlinie vereinheitlichen. Dies entfernt repetitive manuelle Arbeit und macht die Service-Exposition praktisch standardmäßig sicher.
Die Zentralisierung konzentriert jedoch Schlüsselmaterial und Abhängigkeiten. Das Gateway kann Zertifikate für viele Anwendungen halten, und die Account-Credentials, der Zertifikatsspeicher und der Erneuerungszustand werden zu hochwertigen Vermögenswerten. Speicherbeschädigung, Berechtigungsfehler oder ein Migrationsfehler können mehr als einen Dienst betreffen. Ein kompromittiertes Gateway könnte private Schlüssel offenlegen oder Verkehr unter der Kontrolle eines Angreifers terminieren.
ACME-Vorgänge führen externe Abhängigkeiten und operative Einschränkungen ein. DNS-Challenges können Zugriff auf DNS-Anbieter-Credentials erfordern; HTTP-Challenges hängen von Routing und Zugriff ab; Zertifizierungsstellen wenden Ratenbegrenzungen an. Uhrenfehler, Erneuerungsfehler oder ein fehlerhafter Account-Status können Automatisierung in einen Verfügbarkeitsvorfall verwandeln. Ein Unternehmen benötigt Warnmeldungen vor Ablauf, getestete Backup- und Wiederherstellungsverfahren und ein Verständnis darüber, ob der Zertifikatszustand lokal, gemeinsam oder extern verwaltet wird.
TLS-Terminierung bestimmt auch die Transparenz. Das Gateway kann Anforderungsmetadaten und möglicherweise Inhalte nach der Entschlüsselung sehen. Dies ermöglicht Richtlinien, Protokollierung und Bedrohungserkennung, schafft jedoch Datenschutz- und Data-Governance-Verpflichtungen. Protokolle sollten keine Geheimnisse erfassen, nur weil das Gateway sie sieht, und der Zugriff auf Traces und Dashboards sollte wie der Zugriff auf Produktionsdaten behandelt werden.
Unternehmen können TLS an anderer Stelle terminieren oder für ausgewählte Dienste Passthrough verwenden. Das richtige Design hängt vom Bedrohungsmodell und der operativen Zuständigkeit ab. Die Fähigkeit von Traefik, Zertifikate zu vereinheitlichen, zwingt nicht jede Domäne in eine einzige Bereitstellung; kritische Domänen können isoliert und über separate CAs oder Geheimnisverwaltungssysteme mit getrennten Kontrollen versehen werden.
Die kommerzielle Bedeutung liegt darin, dass die Zertifikatsautomatisierung die Ablösung des Gateways erschwert, sobald viele Dienste davon abhängen. Eine Migration ist nicht nur eine Routing-Übung; sie kann die Übertragung des Account-Status, des Zertifikatsspeichers, der Erneuerungsverantwortung und der Vertrauensrichtlinie erfordern. Ein Gateway, das eine einfache Adoption verspricht, sollte auch den Ausstieg und die Übertragung des Zustands verständlich machen. Die Kontinuität hängt von der Wiederherstellung oder Übertragung der Identitätsschicht ab, nicht nur davon, einen einzelnen Proxy-Prozess am Leben zu erhalten.
Kubernetes Ingress, CRDs und Gateway API
Kubernetes bot Traefik eine natürliche Umgebung für das Provider-Modell. Traditionelle Ingress-Ressourcen boten eine standardisierte Methode, um HTTP-Dienste zu exponieren, und Annotationen füllten implementierungsspezifische Lücken. Traefiks eigene CRDs fügten reichhaltigere Objekte und Middleware-Beziehungen hinzu. Die neuere Kubernetes Gateway API zielt darauf ab, klarere Rollen und ausdrucksstärkere Ressourcen für Infrastrukturanbieter, Gateway-Betreiber und Anwendungsteams zu definieren.
Die Unterstützung aller drei Modelle bietet Abwärtskompatibilität: Ein Unternehmen kann bestehende Ingress-Ressourcen weiterverwenden, Traefik-spezifische Funktionen bei Bedarf nutzen und Gateway API übernehmen, wenn die Plattform reift. Sie erhöht jedoch auch die Implementierungs- und Migrationskomplexität; die Verfügbarkeit von Funktionen, Status, Referenzregeln und Konformität variieren je nach Version und Ressourcentyp.
Die strategische Bedeutung von Gateway API liegt darin, dass sie die organisatorischen Grenzen widerspiegelt, die Cloud-native Plattformen benötigen. Infrastrukturteams können GatewayClass und Gateway verwalten, und Anwendungsteams können Routen innerhalb des erlaubten Bereichs binden. ReferenceGrant und Namespace-Kontrollen machen die teamübergreifende Autorität klarer als in älteren, annotationsgetriebenen Mustern. Die Traefik-Implementierung dieses Modells platziert das Produkt innerhalb eines breiteren Kubernetes-Standards, nicht nur innerhalb seiner eigenen Ressourcen.
Die Konformität sollte überprüft, nicht angenommen werden. Ein Produkt kann Gateway API ohne alle optionalen Funktionen unterstützen. Ein API-Server kann eine Ressource akzeptieren, während ihr Status ungelöst bleibt oder ihre Felder nicht unterstützt werden. Plattformteams benötigen pro Release spezifische Tests für Routenbindung, Zertifikatsreferenzen, Filter, Protokolle und namespace-übergreifendes Verhalten.
Migration erfordert auch einen semantischen Vergleich. Eine Ingress-Annotation lässt sich möglicherweise nicht direkt in einen Gateway-API-Filter übersetzen, und eine CRD-Kette kann Richtlinien anders ausdrücken als eine standardisierte Route. Das blinde Umschreiben von Manifesten ohne Pfad-Tests kann zu stillen Verhaltensänderungen führen. Sicherer sind Verhaltenstests und ein schrittweises Nebeneinander anstelle einer rein textuellen, automatisierten Konvertierung.
Das weitere Wettbewerbsumfeld verändert sich. Unternehmen überdenken ihre Ingress-Controller-Strategie, da sich Projekte weiterentwickeln, Produkte eingestellt oder zusammengeführt werden. Traefik kann profitieren, wenn es einen vertrauenswürdigen Migrationspfad und eine robuste Gateway-API-Implementierung bietet; es kann verlieren, wenn die Unterstützung mehrerer Modelle das Produkt schwerer verständlich macht oder wenn verwaltete Cloud-Alternativen den Kundenbedarf mit weniger Aufwand decken.
Das offene Projekt und das kommerzielle Unternehmen
Traefik Proxy ist der Adoptionstreiber von Traefik Labs. Ein Entwickler kann ihn herunterladen, die offiziellen Images ausführen, den Quellcode einsehen, beitragen und interne Expertise aufbauen, ohne zuerst eine kommerzielle Plattform zu kaufen. Dies senkt die Bewertungskosten, schafft eine große Population, die die Konzepte des Projekts kennt, und setzt die Software einer breiten Sicherheitsforschung und -tests aus.
Traefik Labs wandelt einen Teil dieser Adoption in kommerzielle Nachfrage um. Unternehmen benötigen möglicherweise zentrale Verwaltung, Richtlinien-Governance, Support, gehärtete Pakete, Analysen oder Funktionen, die in der Community Edition nicht verfügbar sind. Traefik Hub und die zugehörigen Produkte adressieren diese Bedürfnisse. Das Unternehmen kann an Organisationen verkaufen, die den Proxy bereits nutzen, was die Kosten für die Erklärung der Data Plane von Grund auf reduziert.
Die Grenzen müssen klar bleiben. Das Unternehmen kontrolliert die kommerzielle Roadmap und beschäftigt wichtige Maintainer, aber externe Mitwirkende nehmen am offenen Repository teil. Beiträge gewähren keine Eigenkapitalbeteiligung oder gleichwertige Unternehmensführungsrechte. Umgekehrt bestimmen die Investorenbeziehungen des privaten Unternehmens nicht automatisch jede Entscheidung im Projekt. Die sichtbaren Mechanismen sind Code-Review, Maintainership, Issue-Bearbeitung, Release-Praktiken und Lizenzierung.
Open-Core-Unternehmen erleben eine wiederkehrende Spannung. Wenn zu wenig kostenlos verfügbar ist, leiden Adoption und Community-Vertrauen; wenn zu viel Unternehmenswert im kostenlosen Produkt verbleibt, ist der Umstieg auf Bezahlung begrenzt. Änderungen in der Paketierung können Nutzer unsicher machen, was eine stabile Community-Zusage und was kommerzielle Differenzierung ist. Ein Unternehmen, das dieselbe Marke wie das Projekt trägt, muss diese Spannung öffentlich und konsistent managen.
Sicherheit ist eine weitere gemeinsame Grenze. Eine Schwachstelle in Traefik Proxy betrifft Projektnutzer, unabhängig davon, ob sie ein Abonnement erworben haben. Das Unternehmen kann Maintainer und koordinierte Offenlegung finanzieren; die Community kann Meldungen und Überprüfungen beisteuern. Enterprise-Support mag die Reaktion für zahlende Kunden verbessern, aber die öffentliche Patch-Linie bleibt für den Ruf des Projekts grundlegend.
Die Größe des Projekts bringt Wartungsverpflichtungen mit sich, die Download-Zahlen nicht messen. Tausend Mitwirkende deuten auf eine breite Beteiligung hin, aber die kritische Überprüfung kann von einer viel kleineren Maintainer-Gruppe abhängen. Der Projektzustand hängt von Überprüfungskapazität, Release-Disziplin, Dokumentation und Nachfolge ab, nicht nur von der Anzahl der Namen im Contributor-Log.
Die Finanzierung 2020 und die Umbenennung in Traefik Labs
Containous gab am 15. Januar 2020 eine Series-A-Finanzierungsrunde in Höhe von 10 Millionen US-Dollar bekannt. Balderton Capital führte die Runde an, mit Beteiligung von Elaia und 360 Capital. Die Finanzierung lieferte Ressourcen für die Entwicklung von Unternehmensprodukten, kommerzielle Expansion und internationales Wachstum zu einer Zeit, als Kubernetes und Cloud-native Netzwerke von Nischenadoption zur Mainstream-Infrastrukturplanung übergingen.
Die bestätigte Runde ist bedeutsam, stellt aber keine vollständige Finanzierungsgeschichte dar. Aktuelle Unternehmensunterlagen nennen auch Kima Ventures und OSS Capital als Investoren. Öffentliche Beweise geben keinen Aufschluss über die Eigentumsanteile der Investoren, die derzeitigen Stimmrechtsverhältnisse im Board, das über verschiedene Instrumente hinweg aufgenommene Gesamtkapital oder die aktuelle Bewertung. Eine Investorenliste ist keine Cap Table.
Im September 2020 wurde Containous zu Traefik Labs. Das Unternehmen gab an, dass Traefik zwei Milliarden Downloads überschritten habe, und präsentierte ein breiteres Portfolio, das damals Proxy, Mesh, Enterprise und Pilot umfasste. Diese Namen sind historisch und sollten nicht als Darstellung des aktuellen Produktsets verstanden werden. Zum Stichtag 2026 lag der klarste strategische Fokus auf Proxy, Hub, AI Gateway und MCP Gateway.
Die Umbenennung vereinheitlichte die Unternehmensidentität mit dem Projekt, das die Nutzer kennen. Sie machte den kommerziellen Erfolg stärker vom Projektzustand abhängig. Ein Reputationsproblem des offenen Proxys könnte die Unternehmensverkäufe beeinträchtigen; eine Verpackungsentscheidung des Unternehmens könnte die Bereitschaft der Community beeinflussen, den Proxy weiterzuempfehlen. Die Vereinheitlichung der Marke steigert die Marketingeffizienz, erhöht aber gleichzeitig die Sensitivität der Governance.
Die Finanzierung und die Umbenennung markierten den Übergang von einem Unternehmen, das ein beliebtes Werkzeug unterstützte, zu einem, das eine breitere Plattformkategorie anstrebt. Das ursprüngliche Versprechen war automatisiertes Routing für sich ändernde Dienste. Die geschäftliche Frage wurde, ob dieselbe operative Beziehung API-Management, Sicherheitsrichtlinien und Unternehmenskontrolle unterstützen kann. Die spätere Expansion in KI und MCP folgt derselben Logik in größerem Maßstab.
Traefik Hub und der Übergang von Ingress zu API-Governance
Ingress beantwortet eine grundlegende Frage: Wie erreicht externer Verkehr eine Anwendung? API-Management fügt weitere Ebenen hinzu: Wer darf die API aufrufen, mit welcher Richtlinie, Rate, Version, Dokumentation, Transparenz und organisatorischer Zuständigkeit? Traefik Hub stellt den Übergang des Unternehmens von einer Routing-Komponente zu einem API-Gateway und einer kommerziellen Management-Plattform dar.
Das Produkt baut auf der Proxy-Laufzeit auf und fügt Erkennung, Richtlinien, Verwaltung und unternehmensweite Transparenz hinzu. Dies schafft eine Beziehung zwischen Control Plane und Data Plane. Die Data Plane verarbeitet den Verkehr nahe an den Anwendungen, während die Kontroll- oder Managementebene den Betreibern hilft, Richtlinien zu definieren, zu verteilen und über Gateways und APIs hinweg zu überwachen. Kunden müssen verstehen, welche Funktionen bei einem Ausfall der Managementebene lokal weiterbestehen und welche Änderungen nicht propagiert werden können.
Eine zentrale API-Erkennung hilft Unternehmen, Schnittstellen zu finden, die sonst in Clustern oder einzelnen Teams verborgen bleiben könnten. Gemeinsame Richtlinien reduzieren Inkonsistenzen bei Authentifizierung und Ratenbegrenzungen. Die Managementebene kann ein Inventar von Routen, Zertifikaten und Gateway-Zuständen bereitstellen. Der Wert dieser Funktionen wächst, wenn die Anzahl der Dienste schneller steigt, als ein zentrales Plattformteam sie manuell überprüfen kann.
Das Risiko besteht darin, dass API-Management nicht einfach ein Reverse-Proxy mit einem größeren Dashboard ist. Organisationen benötigen möglicherweise Entwicklerportale, Lebenszyklus-Governance, Versionsverwaltung, Analytik, Monetarisierung, komplexe Identitätsintegration und Policy-Workflows. Etablierte Plattformen wie Kong konkurrieren in diesen Dimensionen, während Cloud-Anbieter verwaltete Gateways anbieten, die in ihre Identitäts- und Abrechnungssysteme integriert sind.
Traefiks Vorteil ist die Kontinuität mit der Entwicklererfahrung und der Data Plane, die viele Teams bereits kennen. Ein Unternehmen, das Traefik Proxy nutzt, könnte es vorziehen, die Governance hinzuzufügen, ohne die Laufzeit zu ersetzen. Der Nachteil ist, dass hohe Unternehmenserwartungen das Produkt von der Einfachheit wegführen könnten, die die Adoption schuf. Traefik Labs muss die Kontrolle erweitern, ohne das Gateway in eine undurchsichtige Plattform zu verwandeln, deren Verhalten für Anwendungsteams schwer zu verstehen ist.
Kommerzielle Verpackung ist ebenfalls wichtig. Funktionen und Preise können je nach Edition und Vertrag variieren. Käufer sollten die genauen Fähigkeiten bewerten, anstatt anzunehmen, dass jede Hub-Funktion in jeder Bereitstellung vorhanden ist. Der strategische Test ist, ob Hub Richtlinienkonsistenz und operative Hebelwirkung schafft, ohne den Kunden von einer Managementebene abhängig zu machen, die er nicht wiederherstellen, überwachen oder migrieren kann.
AI Gateway: Modellverkehr ist kein gewöhnlicher API-Verkehr
KI-Anwendungen rufen externe oder interne Modellanbieter über HTTP-basierte Schnittstellen auf, weshalb es verlockend ist, Modellverkehr als eine weitere API-Kategorie zu betrachten. Der Transport mag vertraut erscheinen, aber die operative Semantik ist anders. Anfragen verbrauchen Token-basierte Kosten; Antworten können lange streamen; Anbieter legen unterschiedliche Namen und Limits offen; Prompts können sensible Daten enthalten; und ein Fehler kann eine Entscheidung darüber erfordern, ob ein alternatives Modell als Ersatz zulässig ist.
Traefik AI Gateway wendet Gateway-Funktionen auf diesen Verkehr an. Es kann Authentifizierung, Anbieter-Routing, Kontingente, Transparenz und Richtlinien rund um den Modellzugriff bereitstellen. Eine zentrale Schicht hilft einem Unternehmen, Anbieterzugangsdaten von jeder Anwendung fernzuhalten, konsistente Limits durchzusetzen und zu protokollieren, welche Teams oder Dienste Modellkapazität verbrauchen.
Das Routing zwischen Anbietern ist komplexer als gewöhnliches Load Balancing. Zwei Modelle liefern möglicherweise keine gleichwertigen Ergebnisse. Ein Failover, das die Verfügbarkeit erhält, kann die Qualität, das Sicherheitsverhalten, die Datenresidenz, die Kosten oder die vertraglichen Bedingungen ändern. Das Gateway benötigt eine KI-bewusste Richtlinie, kein generisches Round-Robin mit neuen Namen. Der Betreiber muss entscheiden, wann Substitution erlaubt ist und wie die Anwendung benachrichtigt wird.
Die Token-Ökonomie verändert auch die Ratenbegrenzung. Eine kleine Anfrage kann eine große Antwort erzeugen, und ein Aufruf kann viel teurer sein als ein anderer. Limits, die auf Anfragen pro Sekunde basieren, erfassen nicht die gesamte Ressourcenbelastung. Kontrollen müssen möglicherweise Token, Modellklasse, Mandantenbudget, Parallelität und Streaming-Dauer berücksichtigen. Die Genauigkeit hängt von den anbieterspezifischen Metadaten und der Fähigkeit des Gateways ab, sie zu interpretieren.
Data Governance ist zentral, weil das Gateway Prompts und Ausgaben sehen kann. Protokolle, die für das Debugging nützlich sind, können personenbezogene, proprietäre oder regulierte Informationen erfassen. Schwärzung, Aufbewahrung, Verschlüsselung, Zugriffskontrolle und Datenresidenz sollten vor einer breiten Einführung konzipiert werden. Ein zentrales KI-Gateway verbessert die Governance nur, wenn es nicht zu einem unkontrollierten Kopierpunkt für sensible Inhalte wird.
Unabhängige Belege für eine breite Akzeptanz des Traefik AI Gateway waren zum Stichtag begrenzt. Die sicherste Schlussfolgerung ist, dass es sich um ein aktuelles kommerzielles Angebot handelt, das mit einem echten Infrastrukturbedarf übereinstimmt, nicht dass es bereits zu einer dominierenden KI-Control Plane geworden ist. Sein Wert wird von Produktionsreferenzen, Anbieterbreite, Richtlinientiefe und der Fähigkeit des Unternehmens abhängen, mit sich schnell ändernden Modellschnittstellen Schritt zu halten.
MCP Gateway: Governance von Tools, nicht nur von Anfragen
Das Model Context Protocol schafft eine Kommunikationsebene, über die KI-Hosts und Agenten Server entdecken und nutzen können, die Tools und Ressourcen bereitstellen. Aus Gateway-Sicht bringt MCP vertraute Anforderungen wie Routing, Authentifizierung, Inventar und Richtlinien mit sich, aber das Ergebnis einer Anfrage kann sich grundlegend unterscheiden: Ein Tool-Aufruf kann ein Dokument lesen, eine Datenbank abfragen, ein Ticket ändern, Code ausführen oder eine externe Aktion auslösen.
Traefik MCP Gateway erweitert die politische Position des Unternehmens auf diese Verbindungen. Das Gateway kann Clients und Server identifizieren, Sitzungen routen, das Inventar offenlegen und Zugriffskontrollen durchsetzen. Dies kann Unternehmen helfen, unkontrollierte direkte Verbindungen zwischen jedem Agenten und jedem Tool-Anbieter zu vermeiden.
Die Sicherheitsgrenzen müssen feiner sein als der Zugriff auf Serverebene. Ein Agent, der zum Anzeigen von Dokumenten autorisiert ist, ist nicht unbedingt zum Löschen von Datensätzen berechtigt. Ein Benutzer kann ein Tool über einen Agenten nutzen dürfen, ein anderes auf demselben MCP-Server jedoch nicht. Damit das Gateway mehr als ein Verbindungsbroker ist, benötigt es Autorisierung auf Werkzeugebene, Mandantenisolation, Ursprungskontrollen und Prüfung.
Prompt Injection verkompliziert das Modell, da ein Agent durch nicht vertrauenswürdigen Inhalt beeinflusst werden kann, bevor er ein Werkzeug auswählt. Das Gateway kann die semantische Sicherheit jeder Entscheidung nicht allein durch die Authentifizierung der Verbindung bestimmen. Es kann die verfügbaren Werkzeuge einschränken, eine stärkere Genehmigung für risikoreiche Aktionen verlangen, Aufrufe protokollieren und den Netzwerkzugriff beschränken, macht aber einen unsicheren Agenten oder Server nicht allein durch seine Anwesenheit sicher.
MCP schafft auch Herausforderungen bei der Erkennung und im Lebenszyklus. Server und Werkzeuge können sich schnell ändern, Schemata entwickeln sich, und Zugangsdaten müssen rotiert werden. Ein Werkzeug kann vom Experiment zur geschäftlichen Kritikalität gelangen, ohne einen traditionellen API-Governance-Prozess zu durchlaufen. Das Inventar des Gateways kann Beziehungen aufzeigen, muss aber mit Zuständigkeit und Risikoklassifizierung verbunden werden.
Ähnlich wie beim AI Gateway war die unabhängige Evidenz zur Akzeptanz zum Stichtag begrenzt. Das Angebot zeigt eine logische strategische Erweiterung: Dynamische Endpunkte und Richtlinien waren das ursprüngliche Problem von Traefik, und MCP schafft eine neue Kategorie davon. Die Unsicherheit besteht darin, ob das Unternehmen schnell genug agentenspezifische Sicherheitssemantik hinzufügen kann, ohne die Zuverlässigkeit des Kern-Proxys und der API-Produkte zu schwächen.
Das Open-Core-Geschäftsmodell
Traefik Labs nutzt Open Source sowohl als Produkt als auch als Vertriebssystem. Ein Entwickler, ein Plattformteam oder ein Unternehmen kann Traefik Proxy ohne einen Verkaufsvertrag übernehmen. Dies schafft Vertrautheit, Integrationen, Dokumentationsnachfrage und eine breite Präsenz, die zu kommerziellen Möglichkeiten führen kann.
Der bezahlte Wert konzentriert sich auf Anforderungen, die auf Unternehmensebene zunehmend wichtiger werden: zentrale Verwaltung, Richtlinienkonsistenz, Unternehmenssupport, gehärtete Pakete, Governance, Analytik und spezialisierte Gateway-Funktionen. Traefik Hub, AI Gateway, MCP Gateway und die Support-Angebote wandeln die technische Adoption in eine kommerzielle Beziehung um.
Das Modell kann die Kosten der Kundenakquise senken, da die Nutzer die Kernkonzepte bereits kennen, und es kann die technische Validierung verkürzen: Ein Kunde kann über jahrelange Erfahrung mit Proxy verfügen, bevor er Hub bewertet. Das Community-Feedback liefert zudem Rückmeldungen aus vielen Umgebungen, die ein geschlossenes Produkt nur schwer reproduzieren könnte.
Die Wirtschaftlichkeit ist nicht öffentlich. Es gibt keine konsolidierten, geprüften Umsatz- oder Gewinnzahlen, keinen jährlich wiederkehrenden Umsatz, keine Anzahl zahlender Kunden, keine Konversionsrate von offen zu bezahlt. Docker-Pulls können diese nicht ersetzen. Automatisierte Builds, häufige Updates, CI und Spiegel erzeugen viele Pulls aus derselben Umgebung. Ein Pull ist ein Verteilungsereignis, kein Unternehmen, keine Person, keine Installation.
Die Open-Core-Verpackung erzeugt eine strategische Spannung. Unternehmenskunden wünschen sich langfristigen Support und differenzierten Wert; Community-Nutzer wollen ein leistungsfähiges, vertrauenswürdiges offenes Produkt; Investoren wollen Wachstum; Maintainer wollen Qualität und eine handhabbare Arbeitslast. Wenn kommerzielle Funktionen die Community Edition zu beschneiden scheinen, leidet der Vertriebsmotor; wenn die Differenzierung zu gering ist, kann es schwierig werden, die erwartete Wartung und Entwicklung zu finanzieren.
Die beste Formel richtet die Anreize aus: Kommerzielle Einnahmen finanzieren Sicherheit, Wartung und Dokumentation, die dem Projekt zugutekommen; das Projekt liefert transparenten Code und breite Adoption, die dem Unternehmen nützen; die Produktgrenzen sind so erklärt, dass die Nutzer wählen können, ohne das Gefühl zu haben, dass ihnen erwartete Fähigkeiten entzogen werden. Die schwächste Formel macht das Projekt zu einem Marketing-Funnel, dessen Risiken die Community trägt, während die strategische Kontrolle undurchsichtiger wird.
Führung nach dem Wechsel des Gründers aus der CEO-Rolle
Traefik Labs änderte die Geschäftsführung am 1. Februar 2024. Sudeep Goswami wurde CEO, und der Gründer Emile Vauge wechselte vom CEO zum CTO. Diese Struktur trennt die kommerzielle Skalierung und die organisatorische Führung von der technischen und Community-Rolle des Gründers.
Die derzeitige öffentliche Führung nennt Gerald Croes als VP of Engineering und Sebastien Francois als Head of Finance. Diese Rollen deuten auf ein Unternehmen hin, das spezialisiertes Management um Produktentwicklung und Finanzoperationen herum aufbaut, aber öffentliche Beweise zeigen kein vollständiges Board, keine Stimmrechte oder interne Berichtsstrukturen.
Der Übergang kann ein häufiges Problem in Open-Source-Unternehmen lösen. Ein Gründer, der die Kerntechnologie geschaffen hat, mag für die technische Glaubwürdigkeit unverzichtbar bleiben, ist aber möglicherweise nicht willens oder geeignet, jede Phase von Unternehmensverkauf, internationaler Expansion und Organisationsdesign zu leiten. Ein spezialisierter CEO kann sich auf den Marktzugang konzentrieren, während der Gründer die architektonische Kontinuität wahrt.
Der Übergang kann auch zwei Einflusszentren schaffen. Der CEO ist für die kommerzielle Leistung und die Erwartungen der Investoren verantwortlich, während der CTO und die Maintainer eine weniger formale, aber ebenso reale Verantwortung für Qualität und Vertrauen tragen. Wenn die Prioritäten übereinstimmen, wächst das Unternehmen, ohne seine technische Identität zu verlieren; wenn sie auseinandergehen, können Entscheidungen über Verpackung, Roadmap und Releases zu Governance-Konflikten werden.
Die offene Community ist kein formeller Wählerkreis des Unternehmens mit Stimmrechten, nur weil sie beiträgt oder Images pullt. Aber das Unternehmen hängt von ihrer Bereitschaft ab, zu nutzen, zu melden, zu überprüfen und zu empfehlen. Die Führung managt daher eine wirtschaftlich wichtige Beziehung, ohne dass diese einer Aktionärskontrolle gleichkommt.
Die anhaltende öffentliche Rolle des Gründers ist ein Stabilitätssignal, aber keine Garantie. Langfristige Resilienz erfordert Nachfolge in der Maintainerschaft, dokumentierte Prozesse und Überprüfungskapazität, die über eine einzelne Person hinausgeht. Dasselbe gilt für die Unternehmensführung: Die Kontinuität des Projekts und der Kunden muss über personelle Veränderungen hinweg gewahrt werden, nicht an eine einzelne Autorität gebunden sein.
Adoptionssignale ohne Mythen
Im Juli 2026 gab Emile Vauge bekannt, dass das Projekt 1.000 Mitwirkende und 3,5 Milliarden Pulls der offiziellen Docker-Images erreicht hat. Dies sind starke Signale für Sichtbarkeit und Aktivität und deuten auf eine breite Beteiligung und wiederholten Image-Konsum in Entwicklungs- und Bereitstellungspipelines hin.
Sie beweisen jedoch nicht 3,5 Milliarden einzigartige Installationen. Ein einzelner Cluster kann das Image viele Male pullen; CI-Systeme pullen es für jeden Build; Spiegel und Updates fügen weitere Ereignisse hinzu. Ein einziges Unternehmen kann eine riesige Anzahl von Pulls darstellen, ohne viele unabhängige Nutzer zu bedeuten. Die Zahl muss daher in ihrer genauen Bedeutung verstanden werden: gemeldete Pulls der offiziellen Images.
Die Zahl der Mitwirkenden hat ähnliche Grenzen. Eine Person kann einen einzigen Dokumentations-Patch einreichen, eine andere kann über Jahre ein kritisches Subsystem pflegen – beide zählen als Mitwirkende. Die Zahl belegt die Breite, nicht die Gleichheit des Einflusses, die aktuelle Aktivität oder die Maintainer-Kapazität, und sie schafft keine formelle Mitgliedschaft. Der Projektzustand hängt von der Verteilung der Überprüfung, der Reaktionsfähigkeit und der Releases hinter der Schlagzeile ab.
Das Unternehmen hatte während der Umbenennung 2020 über zwei Milliarden Downloads gemeldet, aber die Definitionen historischer und aktueller Metriken können variieren. Sie sollten nicht automatisch aggregiert werden, um ohne einheitliche Methodik eine Wachstumsrate zu erstellen. Der Adoptions-Trend ist klar; die genaue Zahl aktiver Bereitstellungen ist es nicht.
Die kommerzielle Adoption ist weniger sichtbar. Die Beweise bieten keine verifizierte Anzahl von Unternehmenskunden oder nach Produkt aufgeschlüsselte Umsätze. Produktseiten belegen die Verfügbarkeit und Positionierung, nicht die Anzahl der Produktionsnutzer. Fallstudien, Verlängerungsraten und bezahlte Konversion wären stärkere Metriken, wenn sie veröffentlicht würden.
Disziplin bei der Interpretation ist strategisch nützlich, nicht nur vorsichtig. Überhöhte Behauptungen schaffen unrealistische Support-Erwartungen und verschleiern die Fragmentierung der Versionen. In der Sicherheit ist die Verteilung aktiver Versionen wichtiger als die Gesamtzahl der Pulls. Ein reifes Infrastrukturunternehmen sollte Metriken anstreben, die unterstützte Versionen, Upgrade-Verhalten und Produktionsmuster zeigen, während die Kundendaten vertraulich bleiben.
Sicherheitsüberprüfung und die Hinweis-Historie 2026
Sicherheit ist ein inhärenter Bestandteil eines Reverse-Proxys, da er von Angreifern kontrollierten Verkehr an privilegierten Grenzen verarbeitet. Traefik kann komplexe Protokolle parsen, TLS terminieren, sich mit Authentifizierungsdiensten verbinden, Header ändern und interne Ziele auswählen. Jede Funktion schafft Codepfade und Konfigurationsannahmen, die überprüft werden müssen.
Das Projekt veröffentlichte oder aktualisierte 2026 mehrere Sicherheitshinweise und beschrieb das Jahr als Rekordjahr für Schwachstellenmeldungen. Zwei Interpretationen sollten gemeinsam betrachtet werden: Das hohe Volumen deutet auf eine große, geprüfte Angriffsfläche hin, aber es kann auch bedeuten, dass Forscher das Projekt untersuchen und die Maintainer offenlegen und beheben, anstatt zu verbergen.
Der am 1. Juli 2026 veröffentlichte Hinweis zum Identitäts-Header-Spoofing ist ein konkretes Beispiel. Betroffene Konfigurationen benötigten korrigierte Versionen, weil Unterschiede im Zusammenhang mit Unterstrichen dazu führen konnten, dass vom Angreifer bereitgestellte Header bestehen blieben, denen die Anwendung vertraute. Die Reaktion erforderte die Identifizierung der Versionen, das Verständnis der Nutzung des Middleware-Musters, ein Upgrade, Tests und die Überprüfung der gesamten Vertrauenskette des Proxys, nicht nur das Lesen eines Schweregrads.
Die Anzahl der Schwachstellen allein misst nicht die Sicherheitsqualität. Ein Projekt mit wenigen Hinweisen kann einfach, wenig genutzt, unzureichend erforscht oder schlecht offengelegt sein; eines mit vielen kann komplex, populär, transparent oder tatsächlich schwach sein. Die wichtigen Metriken sind Schweregrad, Ausnutzbarkeit, Reaktionszeit, Verfügbarkeit von Patches, Regressionsrisiko und die Akzeptanz korrigierter Versionen.
Die Konfiguration bleibt eine separate Risikofläche. Ein vollständig gepatchtes Gateway kann einen Dienst über eine zu breite Route exponieren, einem falschen Namespace vertrauen, Geheimnisse protokollieren oder direkten Backend-Zugriff ermöglichen. Leitlinien müssen daher sowohl Softwarefehler als auch Bereitstellungsrichtlinien abdecken. Distro Zero oder gehärtete Pakete können die Angriffsfläche des Images und der Abhängigkeiten reduzieren, beseitigen jedoch keine Routing-Fehler, Middleware-Reihenfolgeprobleme oder Zugangsdatenfehler.
Das erweiterte Produktportfolio vergrößert die Sicherheitslast. API-Gateways befassen sich mit Identitäten und Richtlinien; KI-Gateways können sensible Prompts und Anbieterschlüssel sehen; MCP-Gateways können Tools vermitteln, die Aktionen ausführen. Das Unternehmen muss die Bedrohungsmodellierung, Tests und Incident-Response im gleichen Tempo erweitern, in dem es Funktionen hinzufügt.
Betrieb: Upgrades, Inventar und die Kontrolle des Wirkungsbereichs
Traefik Proxy v3.7.10 wurde am 31. Juli 2026 veröffentlicht und bestätigt eine aktive Release- und Patch-Kadenz zum Stichtag. Häufige Releases sind nur dann nützlich, wenn der Betreiber weiß, was er ausführt, die Auswirkungen bewertet und das Update sicher bereitstellt. Eine alte, ungepatchte Version in einem Cluster ist nicht allein dadurch geschützt, dass ein Upstream-Fix existiert.
Inventar ist die erste Voraussetzung. Unternehmen müssen jede Traefik-Instanz, ihre Version, ihr Konfigurationsmodell, die aktivierten Provider, die exponierten Entrypoints und die gebundene Middleware kennen. Schatten-Gateways, die von einzelnen Teams erstellt wurden, können dem zentralen Patchen entgehen. Offizielle Pulls zeigen nicht, ob eine anfällige Instanz in der Produktion verbleibt.
Upgrade-Tests müssen das Verhalten umfassen, nicht nur die Prozessgesundheit. Ein Gateway kann erfolgreich starten, während sich die Routing-Priorität, die Middleware-Semantik oder der Gateway-API-Status geändert haben. Regressionstests sollten kritische Hosts, negative Zugriffszenarien, Zertifikatserneuerung, Authentifizierungsheader, Timeouts, Wiederholungen und Backend-Auswahl abdecken. Canary-Bereitstellungen reduzieren das Risiko vor der flächendeckenden Einführung.
Der Wirkungsbereich muss bewusst gestaltet werden. Ein Gateway, das von vielen Teams gemeinsam genutzt wird, reduziert Doppelarbeit, vergrößert aber die Auswirkungen eines Ausfalls. Separate Bereitstellungen können Mandanten, Umgebungen oder kritische Domänen isolieren, auf Kosten von mehr Betriebsobjekten. Die angemessenen Grenzen hängen vom Vertrauen, dem Verkehrsaufkommen und den Wiederherstellungsanforderungen ab.
Hochverfügbarkeit schützt vor Instanzausfällen, nicht vor Fehlern im gemeinsamen Zustand. Zwei Instanzen, die dieselbe fehlerhafte dynamische Konfiguration verwenden, werden denselben Ausfall replizieren. Redundanz muss daher unabhängige Verifikationspfade und Konfigurations-Rollback umfassen, und kritische Dienste sollten in der Lage sein, das Gateway zu umgehen oder einen zuletzt bekannten guten Zustand wiederherzustellen.
Observability muss Infrastrukturebenen verbinden. Eine Anfrage sollte vom Entrypoint über den Router, die Middleware und den Service verfolgt werden, die Konfigurationsquelle, die die Route erstellt hat, sollte identifiziert und mit der Anwendungsgesundheit verknüpft werden. Metriken ohne Herkunft können zeigen, dass der Verkehr ausgefallen ist, ohne zu erklären, welche Deklaration den Fehler verursacht hat.
Kontinuität erfordert eine Ausstiegsstrategie. Kunden sollten verstehen, wie sie Routen, Zertifikate, Richtlinien und den Zustand der Managementebene exportieren oder neu erstellen können. Die Fähigkeit, zu einem anderen Gateway zu wechseln, ist kein Argument gegen Traefik, sondern ein Beleg dafür, dass die Bereitstellung als eine Infrastruktur mit Wiederherstellungsfähigkeit gemanagt wird, nicht als eine dauerhafte Abhängigkeit ohne Alternativen.
Der Wettbewerb findet auf mehreren Märkten statt, nicht auf einem einzigen
Traefiks Wettbewerber unterscheiden sich je nach Problem des Käufers. Im offenen Reverse-Proxy- und Ingress-Bereich sind NGINX, NGINX Ingress und HAProxy vertraute Alternativen mit langer operativer Geschichte. Auf Envoy basierende Data Planes bieten Programmierbarkeit, die in Service Meshes und Gateways verwendet wird. Kubernetes-native Controller konkurrieren um Einfachheit, Konformität und Ökosystem-Integration.
Im Unternehmens-API-Management konkurrieren Kong, Tyk, Gravitee, Apache APISIX und andere um Richtlinien, Entwicklerportale, Analytik, Lebenszyklus und kommerziellen Support. Cloud-Anbieter bieten verwaltete Ingress- und API-Gateways, die die Last innerhalb eines einzigen Ökosystems reduzieren. Diese können attraktiv sein, selbst wenn sie die Anbieterbindung erhöhen oder Multi-Cloud-Richtlinien weniger konsistent machen.
Service-Mesh-Gateways überschneiden sich dort, wo Unternehmen Workload-Identität und Ost-West-Richtlinien neben Nord-Süd-Ingress wünschen. Ein Unternehmen kann Traefik an der Grenze und eine andere Data Plane intern verwenden oder einen einheitlichen, auf Envoy basierenden Stack bevorzugen. Der richtige Vergleich hängt von der Architektur ab, nicht von einer generischen Feature-Liste.
Aufstrebende KI-Gateway-Unternehmen und etablierte API-Anbieter fügen schnell modellspezifische Funktionen hinzu. Sie können bei der Token-Abrechnung, Anbietertransparenz und Leitplanken schneller innovieren. Traefik bringt einen bestehenden Proxy und eine Cloud-native Nutzerbasis mit, muss jedoch beweisen, dass seine KI-Semantik nicht nur ein umbenanntes API-Produkt ist.
Die MCP-Governance befindet sich in einem noch früheren Stadium. Das Feld umfasst spezialisierte Agentensicherheitsprodukte, Plattformkontrollen und direktes Server-Management. Marktführerschaft kann nicht aus der Ankündigung eines Gateways abgeleitet werden, während sich Protokolle und Betriebspraktiken noch entwickeln.
Traefiks Differenzierung liegt in der Kombination aus Entwicklervertrautheit, provider-gesteuerter Konfiguration und einem kohärenten Pfad vom offenen Proxy zur kommerziellen Governance. Zu den Einschränkungen gehören die Undurchsichtigkeit der privaten Finanzen, die Komplexität der Unterstützung mehrerer Märkte und die Konkurrenz durch Anbieter mit tieferen API-Portfolios oder verwalteter Cloud-Distribution.
Auch Standards werden den Wettbewerb prägen. Eine starke Konformität mit Kubernetes Gateway API senkt die Wechselkosten und erweitert die möglichen Bereitstellungen. Proprietäre Richtlinien können Differenzierung schaffen, erhöhen aber die Abhängigkeit. Das Unternehmen muss entscheiden, wo Interoperabilität die Distribution fördert und wo spezialisierte Fähigkeiten eine kommerzielle Kontrolle rechtfertigen.
Warum Traefik für die digitale Infrastruktur von Bedeutung ist
Traefik ist von Bedeutung, weil die Anwendungsinfrastruktur zunehmend von softwaredefinierten Grenzen abhängt. Ein Rechenzentrum oder eine Cloud-Region mag immense Rechenleistung beherbergen, aber die Anwendung bleibt unerreichbar oder unsicher, wenn der Verkehr nicht korrekt geroutet, authentifiziert und reguliert wird. Das Gateway ist eine relativ kleine Schicht mit enormem Einfluss auf die Nutzbarkeit der dahinterliegenden Systeme.
Für das Platform Engineering kann Traefik Anwendungsmetadaten in Netzwerkverhalten umwandeln. Dies ermöglicht es Entwicklern, Exposition über deklarative Ressourcen anzufordern, während Infrastrukturteams Entrypoints und gemeinsame Kontrollen beibehalten. Der Mechanismus reduziert die Bereitstellungsreibung und erleichtert die Wiederverwendung von Standardrichtlinien.
Für Sicherheitsteams bietet die Schicht einen Ort, um TLS, Authentifizierung, Header-Richtlinien und Ratenbegrenzungen durchzusetzen, bevor eine Anfrage den Anwendungscode erreicht. Zentrale Richtlinien können die Konsistenz verbessern, schaffen aber ein hochwertiges Ziel und einen breiten Fehlerbereich. Der Nutzen hängt von Least Privilege, Isolation, Patching und der Unmöglichkeit ab, das Gateway zu umgehen.
Traefik Hub kann API-Teams bei der Erkennung und Governance über Dienste hinweg unterstützen, die sonst isoliert verwaltet würden. Ein KI-Gateway kann Modellzugangsdaten, Kontingente und Anbieterrichtlinien vereinheitlichen. Ein MCP-Gateway kann Werkzeugbeziehungen sichtbar und steuerbar machen. Die Nutzer sind unterschiedlich, aber alle sind darauf angewiesen, dass das Gateway die organisatorische Absicht in Laufzeit-Verkehrsentscheidungen übersetzt.
Daher ist der Einfluss des Unternehmens auf die Infrastruktur direkt, aber begrenzt. Es besitzt weder die Anwendungen noch die Netzwerke oder die Modellanbieter, vor denen es steht, und es kann nicht die Anwendungsautorisierung, die Datenqualität oder die Werkzeugsicherheit garantieren. Es verteilt den Verkehr auch nicht automatisch global wie ein CDN. Sein Wert liegt in der Arbeit an der Schnittstelle, nicht darin, jede Schicht auf beiden Seiten zu ersetzen.
Deshalb ist Governance so wichtig. Eine Route ist nicht nur ein technisches Objekt; sie ist eine Expositionsentscheidung. Eine Authentifizierungskette ist eine Vertrauensentscheidung. Eine Anbieterregel ist eine Kosten- und Datenentscheidung. Eine MCP-Werkzeugberechtigung ist eine Handlungsentscheidung. Mit der Erweiterung des Portfolios wird Traefik zum Treffpunkt von Unternehmenspolitik und Infrastruktur.
Die Chance des universellen Gateways und das Risiko des Engpasses
Traefik Labs verfolgt eine kohärente Expansionsthese. Der ursprüngliche Proxy entdeckte dynamische Anwendungsendpunkte und leitete den Verkehr dorthin. APIs sind verwaltete Endpunkte, die Lebenszyklus und Richtlinien benötigen. Modellanbieter sind Endpunkte mit Kosten-, Daten- und Fehlersemantik. MCP-Server legen dynamische Werkzeuge und Ressourcen für Agenten offen. In jedem Fall kann das Gateway entdecken, routen, authentifizieren, beobachten und regulieren.
Wenn das Unternehmen erfolgreich ist, könnte Traefik Hub zu einer gemeinsamen Control Plane für Unternehmen werden – über Routen, APIs, KI und MCP hinweg. Unternehmen könnten Identität, Richtlinien, Transparenz und Praktiken wiederverwenden, anstatt für jeden Workload eine separate Gateway-Kategorie bereitzustellen. Der offene Proxy bietet eine vertraute Data Plane, und die kommerziellen Produkte fügen die Unternehmenskoordination hinzu.
Doch genau diese Konvergenz schafft Konzentration. Eine einzige Plattform müsste sich in HTTP-Routing, Kubernetes-Integration, API-Governance, KI-Anbietersemantik, Prompt-Datenverarbeitung und werkzeugspezifischer Autorisierung auszeichnen. Ein Defekt, eine Managementebenen-Kompromittierung oder ein Richtlinienfehler könnte mehrere Workload-Klassen gleichzeitig betreffen. Ein Unternehmen, das Vereinfachung verspricht, könnte eine Abhängigkeit schaffen, die die interne Komplexität vor dem Nutzer verbirgt.
Der Umfang wirkt sich auch auf den organisatorischen Fokus aus. Die Wartung eines weit verbreiteten offenen Proxys ist bereits eine große Aufgabe. Der Aufbau eines wettbewerbsfähigen API-Managements erfordert Produkt- und Vertriebstiefe. KI und MCP entwickeln sich schnell und bringen spezielle Sicherheitserwartungen mit sich. Investitionen in neue Kategorien können das Unternehmen stärken oder die Ressourcen von der Kernzuverlässigkeit abziehen.
Die entscheidende Frage ist nicht, ob eine Marke diese Produkte benennen kann, sondern ob die Architektur klare Grenzen beibehält. Die Data Planes sollten auch ohne die Managementebene sicher weiterlaufen, Richtlinien sollten portierbar und überprüfbar sein, kritische Workloads sollten isoliert werden, KI-Protokolle sollten keine gewöhnlichen API-Daten verunreinigen, MCP-Berechtigungen sollten feiner sein als der Routenzugriff, und die Sicherheitsreaktion sollte in jeder Edition schnell bleiben.
Chance und Risiko sind zwei Seiten derselben Hebelwirkung. Traefik wurde dadurch bekannt, dass es eine komplexe Betriebsaufgabe einfach erscheinen ließ. Die nächste Phase fragt, ob diese Einfachheit unter der Oberfläche einer weitaus größeren Verantwortung erhalten bleibt.
Was bekannt ist, was unbekannt ist und was die Beweise stützen
Die Beweise stützen eine klare Darstellung der Ursprünge und des Designs von Traefik. Emile Vauge schrieb den ersten Code im Jahr 2015. Das Unternehmen formierte sich 2016 als Containous. Es sammelte im Januar 2020 eine bestätigte Series-A-Finanzierung über 10 Millionen US-Dollar ein und wurde im September umbenannt. Sudeep Goswami wurde im Februar 2024 CEO, während Vauge CTO wurde. Das aktuelle Portfolio umfasst Proxy, Hub, AI Gateway und MCP Gateway, und Proxy v3.7.10 wurde am 31. Juli 2026 veröffentlicht.
Die Beweise stützen auch die Provider-Router-Service-Middleware-Architektur, die Trennung von statischer und dynamischer Konfiguration, die Unterstützung der Docker- und Kubernetes-Erkennung, die TLS-Automatisierung und die Expansion in API- und Agentenverkehr. Die Adoptionsmetriken vom Juli 2026 sowie die Hinweis-Historie sind als Unternehmens- oder Projekterklärungen und erste Repository-Aktivitäten dokumentiert.
Wichtige kommerzielle Fakten bleiben jedoch nicht verfügbar. Es gibt keine konsolidierten, geprüften Umsatz- oder Gewinnzahlen, keine dokumentierte aktuelle Bewertung, keine vollständigen Eigentumsanteile, keine nach Produkt aufgeschlüsselten Umsätze, keine Anzahl zahlender Kunden und keine unabhängige Zählung von Produktionsbereitstellungen. Die Series-A-Runde über 10 Millionen US-Dollar sollte nicht als gesamte Finanzierung beschrieben werden, solange keine weiteren Beweise vorliegen.
Der Reifegrad von AI Gateway und MCP Gateway muss qualifiziert werden. Die Produktverfügbarkeit ist bestätigt, eine breite unabhängige Nutzung jedoch nicht. Die sicherste Beschreibung ist, dass Traefik Labs in die Kategorien eingetreten ist und Produkte darauf aufgebaut hat, nicht dass es die Märkte kontrolliert.
Historische Produktnamen benötigen Zeitstempel. Traefik Mesh, Enterprise und Pilot erschienen in Materialien von 2020, aber die aktuelle Strategie wird anders dargestellt. Ein alter Katalog sollte nicht so stehen bleiben, als hätte er sich nie geändert. Ebenso werden 3,5 Milliarden Pulls nicht zu einzigartigen Nutzern, und die Anzahl der Mitwirkenden wird nicht zu formellen Governance-Rechten.
Diese Grenzen schwächen die Kernthese nicht, sie kalibrieren sie. Traefik Labs ist ein bedeutendes Open-Core-Gateway-Unternehmen mit einer breiten Präsenz und einem wachsenden Portfolio. Die offene Frage ist, wie erfolgreich es diese Präsenz in eine dauerhafte Unternehmenswirtschaft und Governance umwandeln kann, ohne die Einfachheit, Offenheit und das Vertrauen zu opfern, die sie geschaffen haben.
Die Gateway-Schicht für Cloud-native Anwendungen
Die Traefik-Geschichte beginnt mit einer engen operativen Idee: In einer dynamischen Plattform sollte die Verkehrsschicht dem Dienstzustand folgen, anstatt darauf zu warten, dass ein Mensch eine Datei neu schreibt. Die Idee passte zum Container-Zeitalter und verhalf Traefik Proxy zu einer vertrauten Wahl für Ingress und Reverse-Proxy.
Das um das Projekt herum aufgebaute Unternehmen erweiterte die Bedeutung des Gateways. Containous wurde zu Traefik Labs, und die Series-A-Finanzierung über 10 Millionen US-Dollar unterstützte die kommerzielle Expansion. Traefik Hub verlagerte das Portfolio in Richtung API-Erkennung, Richtlinien und Verwaltung. AI Gateway und MCP Gateway übertrugen dieselbe Routing- und Governance-Logik auf Modellanbieter, Prompts, Agenten, Server und Tools.
Die Expansion ist logisch, weil der Kernmechanismus konsistent ist. Dynamische Endpunkte benötigen Erkennung; Anfragen benötigen Abgleich; Backends benötigen Auswahl; Identitäten und Raten benötigen Richtlinien; Betreiber benötigen Transparenz. Das Unternehmen erfindet mit jedem Produkt keine unzusammenhängende Arbeit; es dehnt eine einzige Position der Verkehrskontrolle auf neue Workload-Kategorien aus.
Das Risiko ist ebenfalls konsistent. Je mehr das Gateway entscheidet, desto feinkörniger muss seine Governance sein. Dienstmetadaten können exponieren, Middleware kann Identität definieren, die Zertifikatsspeicherung konzentriert Schlüssel, KI-Protokolle erfassen sensible Prompts und MCP-Berechtigungen ermöglichen reale Aktionen. Ein gemeinsam genutztes Gateway reduziert Doppelarbeit und vergrößert gleichzeitig den Wirkungsbereich.
Die langfristige Bedeutung wird daher an mehr gemessen als an Pull-Zahlen oder Portfoliobreite. Sie wird daran gemessen, ob Betreiber den Richtlinienpfad verstehen, schnell korrigieren, Ausfälle isolieren, Standards validieren, die Anwendungsverantwortung wahren und bei Bedarf migrieren können. Das Gateway sollte die Infrastruktur anpassungsfähiger machen, ohne zu einer Institution zu werden, die der Nutzer nicht hinterfragen oder sicher ersetzen kann.
In seiner besten Form ist Traefik eine dünne, programmierbare Koordinationsschicht zwischen Anwendungsabsicht und Live-Verkehr. Die strategische Herausforderung für das Unternehmen besteht darin, diese Schicht verständlich und wiederherstellbar zu halten, während sie eine immer größere Verantwortung in der darüber liegenden digitalen Infrastruktur übernimmt.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten