
Zusammenfassung
- RFC 3539 verlangt, Duplikate einer AAA-Transaktion auf jeder Verbindung zu erwarten. Der Ersatzweg kann früher eintreffen, ohne dass die ursprüngliche Anfrage aus dem Netz verschwunden ist.
- Eine zustandsabhängige Authentifizierung kann für dieselbe logische Anfrage erst Accept und auf einem anderen Server Reject liefern. Peer-Liveness, Duplikaterkennung, dauerhafte Entscheidung, Antwortauswahl, NAS-Durchsetzung, Accounting und Nutzerergebnis brauchen eigene Belege.
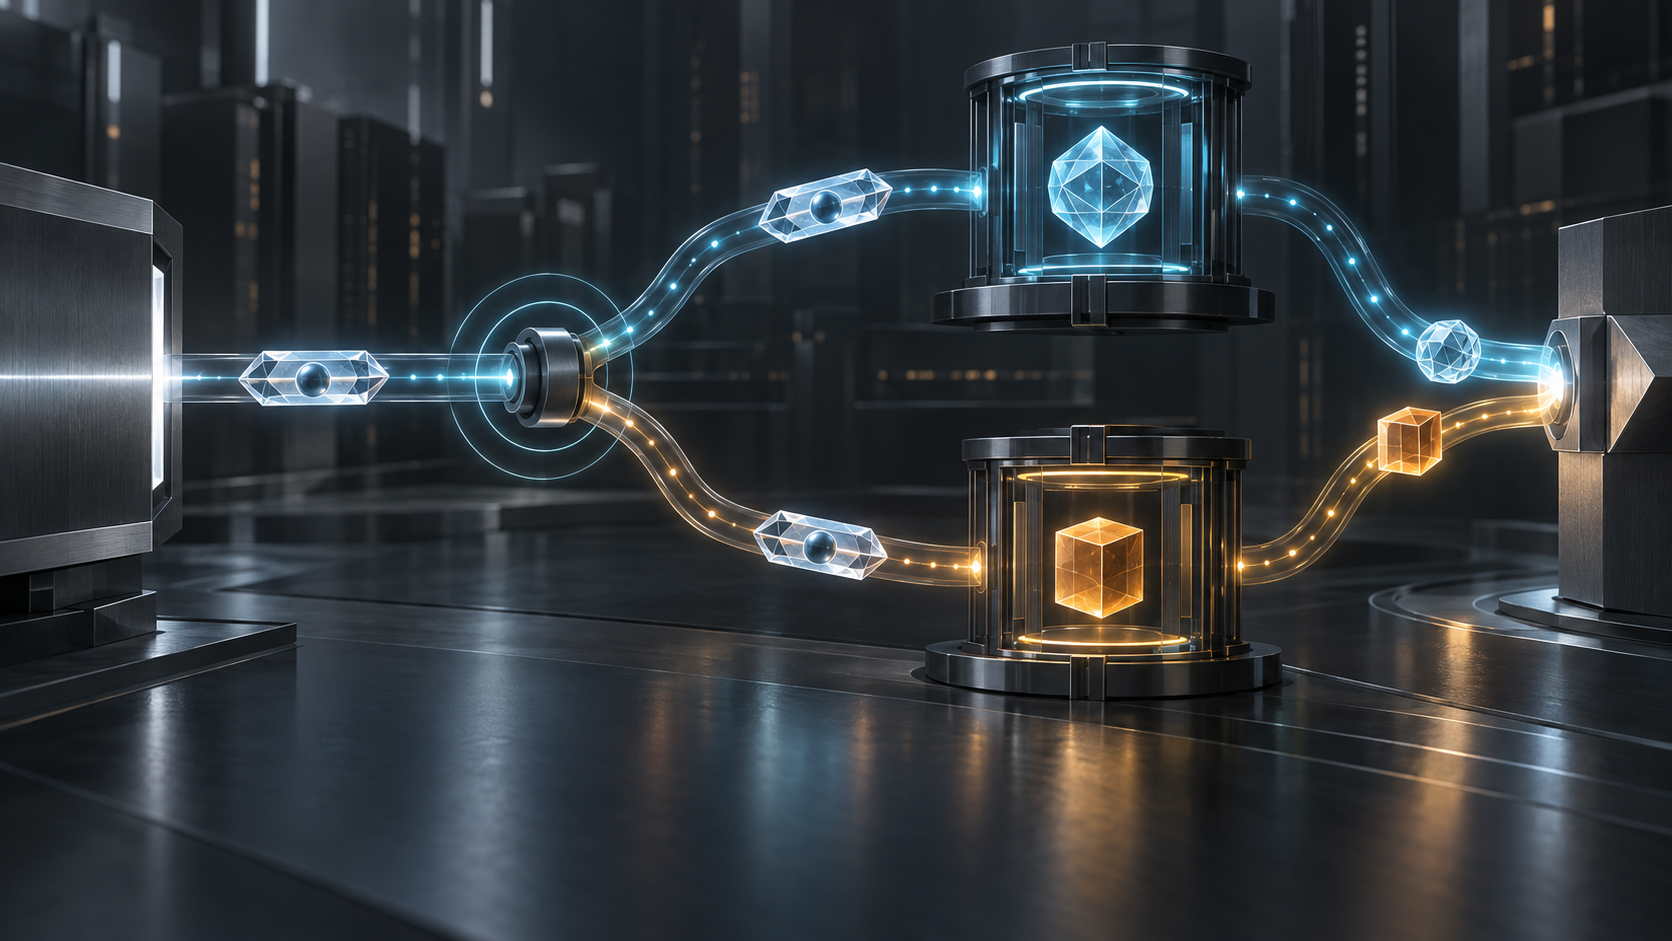
Failover klingt nach Ersatz: eine Verbindung endet, eine andere übernimmt. RFC 3539 beschreibt stattdessen eine Überlappung. Solange nicht feststeht, dass alle Pakete des alten Weges das Netz verlassen haben, kann die alternative Kopie die ursprüngliche Anfrage überholen oder ihr später begegnen.
Das im Juni 2003 veröffentlichte Proposed Standard Authentication, Authorization and Accounting (AAA) Transport Profile ist kein Bericht über einen benannten Ausfall. Es definiert die Transportgrenzen, an denen Hochverfügbarkeit in Entscheidungsmehrdeutigkeit umschlagen kann.
Die entscheidende Frage lautet nicht nur, ob der Ersatzserver antwortete. Sie lautet, wie viele Instanzen zu diesem Zeitpunkt noch befugt waren, dieselbe Absicht auszuwerten.
Verbindungsstatus und Transaktionsstatus sind verschieden
Ein AAA-Client kann mehrere Agenten oder Server erreichen und sie als primär/sekundär oder zum Lastausgleich verwenden. Sendet er eine Transaktion über eine andere Verbindung, bevor die alte sicher leer ist, können mehrere Agenten oder Server dieselbe Arbeit empfangen.
RFC 3539 verpflichtet sie deshalb zur Duplikatbehandlung und zur Annahme, ein Duplikat könne auf jeder Verbindung eintreffen. Die Verbindung ist der lokale Transportkontext. Die Transaktion ist die anwendungsbezogene Absicht. Ein neuer Socket schafft keine neue Absicht; ein geschlossener Socket widerruft keine bereits zugestellte.
„Primär ausgefallen“ beweist nicht, dass der erste Server nichts committed hat. „Sekundär antwortet“ beweist nicht, dass keine alte Antwort mehr zurückkommt. Ein belastbarer Verlauf hält Peer Failure, Queue Replay, Server Commit, Client Receive und NAS Apply getrennt fest.
Andernfalls wird der erste grüne Verfügbarkeitswert zum Ersatz für eine fehlende Transaktionsabrechnung.
Der Watchdog besitzt nur die unmittelbare Nachbarschaft
Das Profil fordert eine Watchdog-Nachricht auf Anwendungsebene, damit Transport- und Anwendungsfunktionsfehler eines Peers schneller erkannt werden. Dieser Watchdog ist ausdrücklich für den unmittelbaren Peer gedacht und soll von Ausfällen nachgelagerter Proxies oder Server unbeeinflusst bleiben. Er ist kein Cluster-Heartbeat.
Jede AAA Response des Peers gilt als Lebenszeichen. Das Ausbleiben einer normalen Geschäftsantwort reicht nicht aus, um den Peer als Down einzustufen, denn ein nachgelagertes System kann warten oder ausfallen. Erst die unbeantwortete Watchdog-Anfrage trägt die entsprechende Zustandsänderung im beschriebenen Algorithmus.
Diese Begrenzung ist Stabilitätsschutz. Ein defekter Home Server soll nicht tausende vorgelagerte Clients zu unnötigem Umschalten bringen. Gleichzeitig ist sie eine Beweisgrenze: eine Watchdog-Antwort sagt nichts über Home Realm, Replikationsstand, Autorisierungsentscheidung oder NAS-Durchsetzung.
Der Timer macht den Zielkonflikt messbar. RFC 3539 nennt 30 Sekunden als ungejitterten Standardwert für Twinit und erlaubt mindestens sechs Sekunden ohne Jitter. Der Text warnt, dass ein niedriger Wert die Wahrscheinlichkeit von Duplikaten sowie falschem Failover und Failback erhöht.
Wer den Wert verkürzt, entscheidet sich für schnellere Störungsreaktion und mehr Reconciliation-Risiko. Das ist eine Risikozuweisung, keine reine Leistungsoptimierung.
Die Pending Queue kennt keinen entfernten Commit
Für Failover führt Client oder Agent eine Pending Queue pro Peer. Eine passende Antwort entfernt die Anfrage. Beginnt das Umschalten, werden alle verbliebenen Nachrichten an einen verfügbaren alternativen Agenten gesendet.
Pending bedeutet lediglich, dass dieser Knoten noch keinen schließenden Beleg erhalten hat. Die Anfrage kann den Server erreicht, einen Zustand geändert und eine verzögerte Antwort erzeugt haben. Die lokale Queue sieht diesen entfernten Commit nicht.
Der Replay-Beleg muss daher den alten und neuen Peer, Auslöser, Watchdog-Generation, Queue Snapshot, End-to-End-Identität, Payload-Hash, Retransmission-Markierung und beide Sendezeitpunkte enthalten. Ein Zähler namens retry unterscheidet keine identische Kopie von einer neu gebauten Anfrage.
RFC 6733 übernimmt diese Architektur für Diameter. Pending Requests werden, soweit möglich, mit gesetzter Retransmission-Kennzeichnung an einen alternativen Agenten weitergegeben. Mehrere identische Requests oder Answers können als Folge eintreffen.
Hop-by-Hop schließt die lokale Schleife, End-to-End bündelt die Absicht
Der Hop-by-Hop Identifier ordnet auf einer Verbindung eine Antwort der wartenden Anfrage zu. Der End-to-End Identifier bildet zusammen mit Origin-Host die Kennung, mit der Duplikate über Agentengrenzen erkannt werden.
Die erste Koordinate beantwortet eine lokale Queue-Frage. Die zweite sagt, dass Nachrichten auf verschiedenen Wegen dieselbe logische Arbeit sind. Keine ist ein verteilter Lock, ein Freshness-Beweis oder eine Garantie für genau einen Effekt.
Nach der Erkennung braucht es eine Disposition. Der Server kann die dauerhaft gespeicherte Antwort wiederholen, auf einen maßgeblichen Entscheidungsträger warten, eine Neuberechnung ablehnen oder die Policy erneut ausführen. RFC 6733 empfiehlt für Duplikate dieselbe Antwort, abgesehen von Hop-spezifischen Details. Damit wird ein Replay nicht automatisch zur zweiten Entscheidung.
Doch die Regel funktioniert nur, wenn die erste Entscheidung auffindbar ist. Ist sie nicht persistiert, ist der Cache abgelaufen oder hat der zweite Server den Zustand nicht erhalten, erzeugt der gemeinsame Schlüssel keine Konsistenz. Erkennung, Unterdrückung, Abgleich und Kompensation bleiben getrennte Aufgaben.
Zwei Server können gegensätzlich und lokal korrekt entscheiden
RFC 3539 illustriert die Nicht-Idempotenz mit einer Begrenzung gleichzeitiger Nutzung. Die erste Authentifizierungsanfrage trifft ein, bevor der Benutzer als angemeldet gilt, und erhält Accept. Danach erreicht das Duplikat einen anderen Server. Dieser sieht bereits eine Sitzung und liefert Reject, weil nur eine zulässig ist.
Beide Server können ihre jeweilige Momentaufnahme korrekt bewerten. Der Konflikt entsteht aus Zeit und verteilter Zustandswahrnehmung, nicht zwingend aus einem Fehler im einzelnen Regelwerk.
Der Client kann Accept und Reject für dieselbe duplizierte Anfrage erhalten; laut RFC hängt das Ergebnis davon ab, welche Antwort zuerst eintrifft. Damit wird Latenz zur faktischen Autorisierungspolitik. Ein näherer Ersatzserver, ein neuer Proxy oder eine andere Queue kann den Sieger ändern, obwohl keine Policy-Datei geändert wurde.
Das ist ein spezifiziertes Beispiel, kein Nachweis eines realen Vorfalls. Die Kontrollfolgerung lautet: Entweder Antwortauswahl und Konfliktbehandlung werden ausdrücklich geregelt, oder ein logischer Schlüssel verweist auf genau eine dauerhafte Entscheidung.
Auch die nicht gewählte Antwort ist ein Beweisstück
Ein Client-Log, das nur den angewandten Result-Code behält, löscht die Ursache. Zu jeder Antwort gehören Serveridentität, End-to-End-Schlüssel, State Epoch, relevante Einschränkung, Ergebnis der Duplikatsuche, Commit-Zeit und Empfangszeit.
„Zuerst“ braucht einen Beobachtungspunkt. Zuerst gelesen, zuerst validiert, zuerst lokal committed, zuerst an das NAS gesendet und zuerst tatsächlich durchgesetzt können verschiedene Reihenfolgen ergeben.
Der Auswahlbeleg listet alle Antworten, ihre Validierung, die Regel, die Wahl und die Behandlung der übrigen Antwort. Er trennt Transportduplikat, Zustandsdivergenz und Ausführungsrennen.
Die verlorene Antwort aufzubewahren bedeutet nicht, Fehler künstlich zu vergrößern. Es verhindert, dass eine widersprüchliche Autorisierung im Rückblick wie ein normaler Login aussieht.
Accept muss noch in laufenden Zugriff übersetzt werden
Accept ist eine Serverentscheidung. Der Client muss sie korrelieren und validieren. Das NAS muss Attribute oder Profil installieren und den Zugriffszustand ändern. Erst Datenebenenbeobachtung zeigt, ob der Dienst nutzbar wurde.
Auch Reject ist begrenzt. Wurde ein Accept schon angewandt, beweist ein später Reject nicht, dass nie Zugriff bestand. Er kann Bereinigung auslösen, als Duplikat verworfen werden oder einen offenen Konflikt markieren.
Accounting besitzt eine weitere Identitätsfläche. RFC 3539 nennt Accounting Session-Id, Event-Timestamp und NAS-Identität zur Aussortierung doppelter Datensätze. Der konkrete Umgang — verwerfen, zusammenführen, akzeptieren oder kompensieren — muss mit Audit- und Abrechnungswirkung verbunden werden.
Eine vollständige Kette enthält logische Anfrage, Peer-Liveness, Replay, jede Serverentscheidung, Client-Auswahl, NAS-Durchsetzung, Accounting-Disposition und Nutzerergebnis. Kein Eigentümer darf für die nachgelagerte Fläche sprechen.
RADIUS- und Diameter-Koordinaten nicht vermischen
Klassisches RADIUS nutzt seinen Ein-Byte-Identifier, Request Authenticator, Transportkontext und Shared Secret für Antwortzuordnung und Wiederholung. RFC 2865, RFC 2866 und RFC 5080 begrenzen diese Mechanik.
Diese Felder sind keine früheren Namen für Diameter Hop-by-Hop Identifier, End-to-End Identifier und Origin-Host. Dieser Artikel wiederholt nicht die RADIUS-Transaktionsidentität. Er besitzt die RFC-3539-Grenze: ein Duplikat über Verbindungen hinweg kann eine zustandsabhängige Entscheidung ein zweites Mal aufrufen.
Gemeinsam ist nur die abstrakte Disziplin: Identität erhalten, damit Replay nicht zu neuer Absicht wird; Entscheidung erhalten, damit dieselbe Absicht nicht zwei Effekte erzeugt.
Der prüfbare Failover-Bericht
Er beginnt mit Origin, End-to-End-Key, unveränderlichem Request Digest, Benutzer-/Session-Scope, Anwendung und Erstellzeit. Für den Peer folgen Connection Generation, letzte gültige Antwort, Watchdog-Austausch, Timer, Jitter und Failure Classification.
Der Replay-Teil enthält alte und alternative Peers, Queue Snapshot, Retransmission-Markierung und Sendezeiten. Jeder Server liefert State Epoch, Regel, Duplicate Lookup, wiederverwendete oder neue Entscheidung und Commit-Zeit.
Der Client bewahrt alle Antworten und seine Auswahl auf. Das NAS dokumentiert das angewandte Profil. Accounting bindet Session, Event Time und NAS an die Disposition. Schließlich wird Zugriff oder Ablehnung beobachtet.
Dann darf der Bericht sagen: „Dieser unmittelbare Peer beantwortete diesen Watchdog nicht; diese Pending Identities gingen an diesen Ersatz; die Entscheidungen wurden nach dieser Regel abgeglichen; das NAS setzte diese Antwort um; Session und Accounting zeigten dieses Ergebnis.“ Fehlende Klauseln bleiben unbekannt.
Beweisgrenze
Der Artikel nennt keinen Betreiber, Anbieter, AAA Realm, RADIUS-/Diameter-Einsatz, Account, Login, NAS, Vorfall, Ausfall, Angriff, Doppelentgelt oder Nutzer. Er berichtet keine Adoption, aktuelle Konfiguration, gemessene Latenz oder reale Häufigkeit widersprüchlicher Antworten.
RFC 3539 wird als Proposed Standard von Juni 2003 behandelt. RFC 3588 ist historischer Kontext und wurde durch RFC 6733 ersetzt. RFC 6733 bewahrt Failure- und Duplicate-Mechanik, beweist aber keine Implementierung. RFC 8174 begrenzt normative Sprache; RFC 6298 liefert Timerkontext, keine AAA-Beobachtung.
Lu Hengs Texte zu Running-Code Primacy und Minimum Initial Specification sind offengelegte redaktionelle Perspektiven. Sie trennen Dokument, Umsetzung, lokale Entscheidung und Ergebnis. Sie belegen weder Autorenabsicht noch Betriebswirklichkeit.
Die enge Schlussfolgerung: Failover kann eine AAA-Anfrage kopieren, bevor das Original verschwunden ist. Gemeinsame Identität macht die Kopien erkennbar. Nur idempotente Disposition, explizite Auswahl, nachgewiesene Durchsetzung und beobachtetes Ergebnis machen den Effekt singulär.
Quellen
- https://www.rfc-editor.org/rfc/rfc3539.html
- https://www.rfc-editor.org/info/rfc3539
- https://datatracker.ietf.org/doc/rfc3539/
- https://www.rfc-editor.org/rfc/rfc6733.html
- https://www.rfc-editor.org/rfc/rfc3588.html
- https://www.rfc-editor.org/rfc/rfc2865.html
- https://www.rfc-editor.org/rfc/rfc2866.html
- https://www.rfc-editor.org/rfc/rfc5080.html
- https://www.rfc-editor.org/rfc/rfc8174.html
- https://www.rfc-editor.org/rfc/rfc6298.html
- https://heng.lu/running-code-primary-the-patch-needed-to-preserve-the-internet-original-design/
- https://heng.lu/minimum-initial-specification-localized-future-decision-voluntary-adoption-internet-coordination-system/
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten