
Zusammenfassung
- RFC 2056 definierte mit
z39.50sundz39.50rzwei unterschiedliche URL-Schemata für einen zustandsbehafteten Suchdienst beziehungsweise eine enger definierte Datensatzabfrage; die Wahl des Schemas signalisierte Absicht, bevor der übrige URL-Inhalt ausgewertet wurde. - Der RFC trennt Datenbank, serverseitigen Datensatzzeiger, logische Elementauswahl und Übertragungsdarstellung. Diese Felder liefern technische Beobachtungen, aber keinen Beweis für dauerhafte Identität, bibliografische Richtigkeit, fortbestehende Autorisierung oder heutige Erreichbarkeit.
- Der normative Text enthält bereits Sicherheitswarnungen gegen eine zu starke Gleichsetzung von scheinbar harmloser Abfrage und tatsächlicher Wirkung: Ein Verweis kann später auf etwas anderes zeigen, und eine vermeintlich idempotente Aktion kann auf einem entfernten System schädliche Folgen haben.
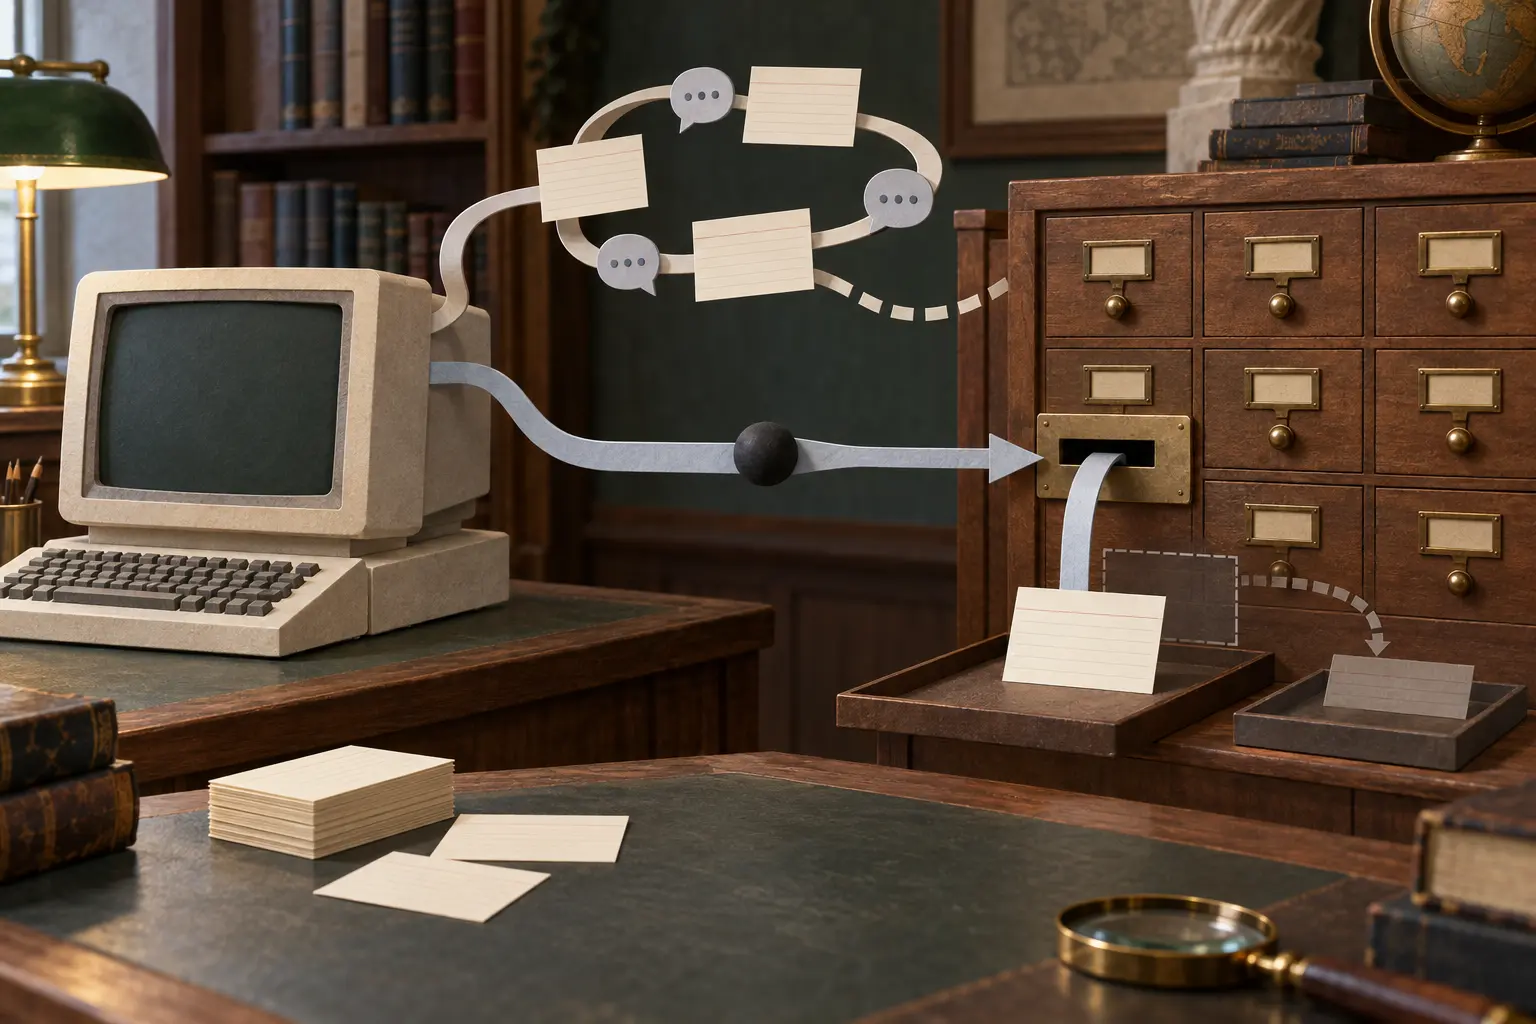
Als RFC 2056 im November 1996 erschien, trafen zwei sehr verschiedene Architekturwelten aufeinander. Auf der einen Seite stand die URL als kompakte Bezeichnung einer Netzressource. Auf der anderen Seite stand Z39.50, ein Protokoll für bibliografische und andere strukturierte Informationssysteme, dessen normale Anfrage keine einzelne atomare Operation war. Eine Z39.50-Abfrage konnte eine Sitzung aufbauen, mehrere Schritte durchlaufen, zusätzliche Parameter benötigen und je nach Programm sogar Benutzerbeteiligung einschließen. Das Ergebnis einer Search-Operation bestand zudem nicht zwingend aus den Datensätzen selbst: Der Server konnte zunächst Zeiger auf passende Einträge seiner Datenbanken erzeugen, die anschließend mit Present abgerufen wurden.
RFC 2056 löste dieses Übersetzungsproblem nicht, indem er Z39.50 auf ein einziges, zustandsloses Abrufmodell reduzierte. Stattdessen definierte er zwei URL-Schemata, z39.50s und z39.50r. Schon der Schemaname sollte der aufrufenden Schnittstelle verraten, welche Art von Handlung beabsichtigt war, bevor die übrigen, teilweise undurchsichtigen Bestandteile der URL verarbeitet wurden. Darin liegt ein wichtiges historisches Detail: Die URL war hier nicht bloß ein Ortsname. Sie wurde zum kompakten Träger einer Auswahl darüber, wie ein zustandsbehaftetes Anwendungsprotokoll angestoßen werden sollte.
z39.50s war die allgemeinere Variante. Ein Rechnername war erforderlich, eine Anschlussnummer optional; fehlte sie, galt 210. Alles Weitere war optional. Ein Programm sollte zu demselben Rechner und derselben Anschlussnummer eine Z39.50-Sitzung beginnen oder eine bestehende Sitzung weiterverwenden. War eine docid vorhanden, musste zugleich eine Datenbank angegeben sein; die Kennung führte dann zu einer Suche in Abrufform. Ohne docid konnten weitere Angaben je nach Programm als zwingende Anforderungen, als Präferenzen oder als ignorierbare Hinweise behandelt werden. Entscheidend war außerdem, dass die Sitzung nach diesem Vorgang offenbleiben sollte, damit der Benutzer weiterarbeiten konnte.
Damit war z39.50s ausdrücklich nicht nur ein syntaktischer Weg zu „einem Dokument“. Es war ein Einstieg in eine fortsetzbare Interaktion. Das macht den Unterschied zwischen einem URL-basierten Startpunkt und einem Beweis über den späteren Benutzerzustand sichtbar. Aus der URL lässt sich erkennen, welcher Rechner, welche Anschlussnummer und gegebenenfalls welche Datenbank oder Kennung angesprochen werden sollten. Daraus folgt aber nicht, dass die Sitzung fortbestand, dass dieselbe Gegenstelle später noch erreichbar war oder dass ein Benutzer tatsächlich einen bestimmten Datensatz erhielt.
z39.50r war enger gefasst. Rechner und Datenbank waren erforderlich; auch hier galt standardmäßig Anschluss 210. Die Bedeutung einer solchen URL ohne docid blieb undefiniert. Mit docid wurde die Sache präziser: Die Kennung war eine vom Server festgelegte, undurchsichtige Zeichenfolge und musste als einzelner Suchbegriff in einer Type-1-Anfrage erscheinen, im allgemeinen Format unter Kennung 45, mit Bib-1 Use=docid und Structure=URx. Die Search-Antwort musste genau einen Treffer melden. Tat sie das nicht, war die Anfrage erfolglos; das weitere Verhalten der Anwendung war nicht definiert. Befand sich der Datensatz bereits in der Search-Antwort, konnte er dort übernommen werden, andernfalls war Present zu verwenden. Nach dem Empfang durfte die Sitzung geschlossen oder weitergeführt werden.
Diese Regeln autorisierten keine unscharfe Auswahl und kein beliebiges „bestes“ Ergebnis. Die Trefferzahl eins war Teil der Bedeutung. Genau darin zeigt sich, wie stark der RFC zwischen einer serverdefinierten Kennung und einer frei interpretierbaren Suche unterschied. Eine docid war kein universeller bibliografischer Name. Sie war ein undurchsichtiger Wert innerhalb einer konkreten Kombination aus Gegenstelle, Datenbank und Z39.50-Suchsemantik. Wer daraus eine weitergehende Identitätsaussage ableiten würde, würde mehr behaupten, als der Mechanismus hergibt.
Der RFC unterscheidet außerdem mehrere Ebenen eines Datensatzes. Es gibt den lokalen Datenbankeintrag auf dem Server, den gemeinsamen abstrakten Datensatz und den schließlich für die Übertragung erzeugten Datensatz. Diese Ebenen sind nicht austauschbar. elementset bestimmt, welche logischen Elemente eines Datensatzes gewünscht werden; recordsyntax bestimmt, wie diese Elemente für die Übertragung verpackt werden. Fehlt esn, wählt das Programm. Ist esn vorhanden, soll es entweder bereits in den Feldern für kleine oder mittlere Ergebnismengen der Search-Operation verwendet oder später bei Present eingesetzt werden.
Für rs gilt ein ähnlicher Grundsatz. Fehlt die Angabe, wählt das Programm. Ist eine Liste angegeben, soll vorzugsweise die erste unterstützte Datensatzsyntax als PreferredRecordSyntax genutzt werden. Die Grammatik ist dabei leicht misszuverstehen: Mehrere Datenbanken werden mit + getrennt; optional folgt ?docid; hinzu kommen ;esn= und genau ein einzelner Parameter ;rs=, in dessen Wert mehrere Datensatzsyntaxen wiederum mit + voneinander getrennt werden. Der RFC definiert also nicht mehrere wiederholte ;rs=-Parameter.
Diese Details zeigen, warum technische Beobachtungen auseinandergehalten werden müssen. Schema, Netzendpunkt, Datenbank, Kennung, Suchkonstruktion, Trefferzahl, ausgewählte Felder, Übertragungssyntax und Auslieferung sind verschiedene Tatsachen. Keine davon beweist automatisch fortbestehende Identität, Autorisierung, bibliografische Korrektheit, Vollständigkeit, gefahrlose Auswertung, Sitzungsfortbestand oder das tatsächliche Benutzerergebnis.
Die URL-Syntax von RFC 2056 baute auf RFC 1738 auf. Zugleich waren Repräsentationsfragen bereits als Interoperabilitätsproblem bekannt; RFC 1729 dokumentierte solche Risiken. Die Trennung zwischen logischem Inhalt und Übertragungsdarstellung war daher mehr als eine Formatfrage: Zwei Systeme können sich auf „denselben“ Gegenstand beziehen und ihn dennoch mit unterschiedlichen Elementmengen, Repräsentationen und lokalen Annahmen behandeln.
Besonders bemerkenswert ist der Sicherheitsteil von RFC 2056. Der Text warnt davor, aus einer URL zu schließen, dass sie dauerhaft auf den ursprünglich gemeinten Gegenstand zeigt. Ein später aufgelöster Verweis kann ein anderes Ziel erreichen. Noch weiter geht die Warnung vor Fernwirkungen: Selbst eine Operation, die wie eine harmlose, wiederholbare Abfrage aussieht, kann auf dem entfernten System einen schädlichen Vorgang auslösen. Damit stellt der RFC die Semantik einer Benennung ausdrücklich unter Vorbehalt der tatsächlichen Serverwirkung.
Der heutige dokumentarische Status darf davon getrennt werden. Im IANA-Verzeichnis sind z39.50s und z39.50r als „Permanent“ eingetragen; z39.50 ist dort „Historical“. Solche Registrierungen belegen Namen und Registrierungsstatus. Sie belegen weder aktuellen Netzverkehr noch heutige Unterstützung durch Programme oder Server und auch keine operative Empfehlung. Ebenso beschreibt der aktuelle Metadatensatz zu RFC 2056 ihn als Standards-Track-Dokument mit dem damaligen Status „Proposed Standard“ und führt ihn im Legacy-Zusammenhang; aus den hier zugrunde gelegten Angaben ergibt sich keine ausdrückliche Aktualisierungs- oder Obsolet-Beziehung. Das ist dokumentarischer Status, keine Aussage über gegenwärtige Nutzung.
Auch RFC 1625 darf nicht mit diesem Modell vermischt werden. Dort ging es im WAIS-Zusammenhang um einen anderen Ansatz: eine Type-3-Textanfrage, das Löschen von Ergebnissen für eine zustandslose Behandlung und keinen anschließenden Present-Schritt. Gerade der Kontrast macht sichtbar, dass frühe Internetintegration nicht auf einen einzigen Weg hinauslief. Unterschiedliche Protokolle und Schnittstellen versuchten auf unterschiedliche Weise, lokale Zustände, Suchergebnisse und Netzadressen zusammenzubringen.
Drei spätere Essays von Heng liefern hierfür eine Interpretationsfolie, aber keine zusätzliche normative Aussage über die Absichten der RFC-Autoren. Die Idee einer minimalen gemeinsamen Spezifikation mit späteren lokalen Entscheidungen und freiwilliger Übernahme hilft zu erklären, warum RFC 2056 an mehreren Stellen Wahlmöglichkeiten beim Programm belässt. Die Unterscheidung verschiedener Wirklichkeitsebenen macht verständlich, weshalb ein formaler URL-Eintrag, ein lokaler Serverzustand und ein tatsächlich ausgelieferter Datensatz nicht identisch sind.
Und die Betonung lauffähiger Implementierung lenkt den Blick darauf, dass ein registriertes oder standardisiertes Schema allein noch kein laufendes System bildet. Diese Gedanken sind Interpretation; der normative Gehalt bleibt derjenige des RFC selbst.
Quellen
- RFC-2056-Text
- RFC-Editor-Eintrag zu RFC 2056
- IETF-Datatracker-Eintrag
- Errata-Suche zu RFC 2056
- RFC 1738
- RFC 1729
- RFC 1625
- IANA-Verzeichnis der URI-Schemata
- Minimale Anfangsspezifikation, lokale Zukunftsentscheidung und freiwillige Übernahme
- Über Wirklichkeitsebenen
- Vorrang lauffähiger Implementierung
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten