
Zusammenfassung
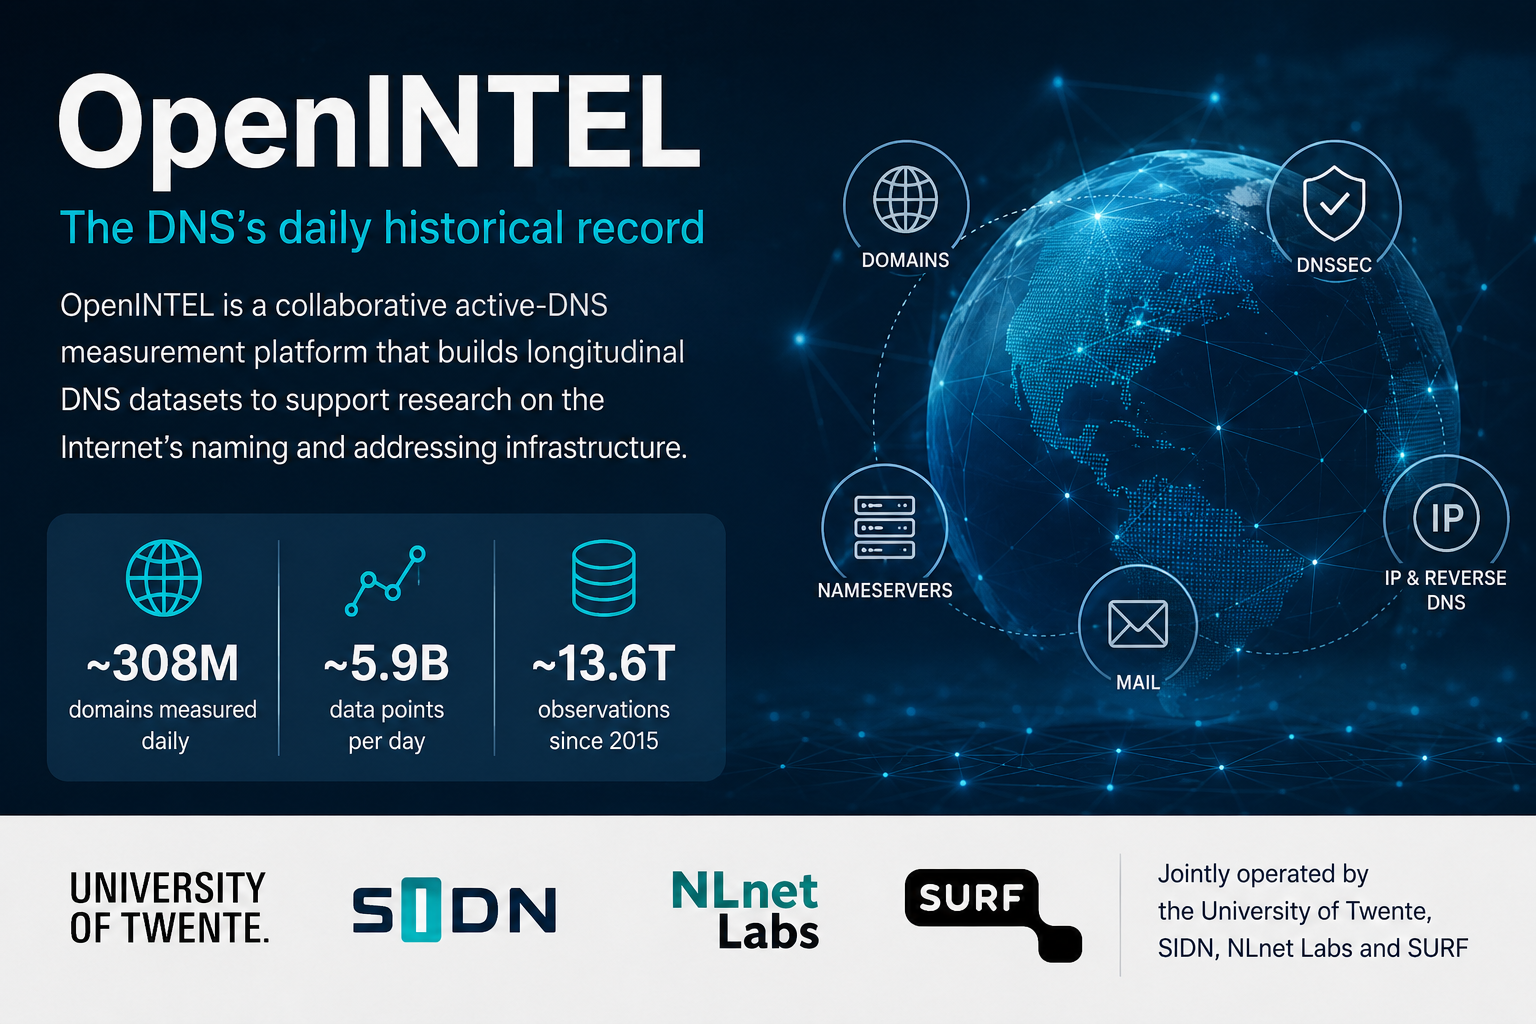
- OpenINTEL ist eine kollaborative Plattform für aktive DNS-Messungen, die von der University of Twente, SIDN, NLnet Labs und SURF betrieben wird – und keine Registry, kein Resolver und kein Unternehmen für passives DNS.
- Die Projektwebsite meldet rund 308 Millionen täglich gemessene Domains, 5,9 Milliarden täglich erzeugte Datenpunkte und 13,6 Billionen Beobachtungen, die seit Beginn des Regelbetriebs im Jahr 2015 gesammelt wurden.
- Die langfristige Konsistenz begründet den Wert der Plattform; zugleich begrenzen Quellenauswahl, Messstandort, Abfragemethode, Softwareversion, Methodenänderungen und Kontrollen für fehlende Daten jedes Ergebnis.
- OpenINTEL beobachtet weder die Nutzernachfrage noch jeden DNS-Zustand; einige Datensätze sind unter einer nicht kommerziellen Lizenz offen, während andere Materialien durch Zonenzugangsverträge kontrolliert bleiben.
Vom System der University of Twente zur gemeinsamen nationalen Forschungsinfrastruktur
Die Implementierung von OpenINTEL begann 2014 an der University of Twente. Der erste vollständige Tageslauf zeigte, dass die Pipeline einen sehr großen Namensraum innerhalb des für die Wiederholung erforderlichen Betriebsfensters abfragen, verarbeiten und speichern konnte. Die regelmäßigen Messungen begannen im März 2015. Der Übergang vom Experiment zum täglichen System schuf den eigentlichen Wert des Archivs: Kontinuität.
Das Projekt wurde von Forschenden gegründet, darunter Anna Sperotto, Mattijs Jonker und Roland van Rijswijk-Deij. Ihre aktuellen Projektrollen umfassen Forschungsleitung, Datenarchitektur, Messdesign und Finanzierung. Das Betriebsmodell wuchs über eine einzelne Universität hinaus. SIDN brachte Registry-Expertise und dauerhafte Unterstützung ein. NLnet Labs stieß als Partner für DNS-Software und Forschung hinzu. SURF lieferte den Kontext von Forschungsnetz und Infrastruktur. Die vier Institutionen betreiben das Projekt heute gemeinsam.
Dieses Arrangement sollte nicht als eigenständiges Unternehmen beschrieben werden. Es gibt keine verifizierte OpenINTEL-Körperschaft mit Aktionären, konsolidiertem Umsatz oder einer Bewertung. Personal, Hardware, Verträge, Fördermittel und Datenrechte liegen bei den Partnerinstitutionen. Die Governance des Projekts ist öffentlich weniger formal als ein Stiftungsvorstand, aber die institutionelle Vielfalt verringert die Abhängigkeit von einem einzelnen Labor.
Jeder Partner bringt zudem einen anderen Blick auf das DNS ein. Eine Universität schätzt reproduzierbare Forschung und studentische Arbeit. Eine Registry versteht Zonendaten, Betreiberbeziehungen und die Beschränkungen von Zugangsvereinbarungen. Eine DNS-Softwareorganisation bringt Protokoll- und Implementierungswissen ein. Ein nationales Forschungsnetz kann die für dauerhafte Messungen erforderliche Rechen- und Konnektivitätskapazität bereitstellen.
Das Modell schafft Grenzen. Partner können Geräte und Personal finanzieren, ohne ein einheitliches Projektbudget zu veröffentlichen. Vertraglich gewonnene Zonendaten dürfen gemessen, aber nicht frei weitergegeben werden. Mitwirkendenseiten können veralten, wenn Personen die Stelle wechseln; sie sind daher für die Projektgeschichte zuverlässig, für nicht damit zusammenhängende aktuelle Titel aber weniger. Gemeinsamer Betrieb bedeutet nicht, dass jeder institutionelle Vermögenswert gemeinsames Eigentum ist.
Die Entwicklung von OpenINTEL vom Laborsystem zur gemeinsamen Infrastruktur veränderte auch seine Servicepflichten. Forschende sind auf Datenkontinuität angewiesen. Betreiber benötigen identifizierbaren Datenverkehr und eine Möglichkeit, Schäden zu melden. Datennutzer benötigen stabile Formate und Zugangsbedingungen. Speichermigrationen müssen die Historie bewahren. Das Projekt muss sich wie ein langfristig angelegtes Observatorium verhalten und nicht wie der temporäre Datensatz einer Veröffentlichung.
Der erste vollständige Tag war ein technischer Meilenstein. Die Entscheidung, ein Jahrzehnt lang weiterzumessen, war die institutionelle Leistung.
Das DNS beantwortet die Gegenwart und vergisst die Vergangenheit
Eine DNS-Abfrage fragt nach der aktuellen Antwort, die über einen bestimmten Pfad verfügbar ist. Die Antwort kann Nameserver, Adressen, Mailsysteme, zertifikatsbezogene Datensätze oder andere Konfigurationen benennen. Morgen kann der Betreiber sie ändern. Der vorherige Zustand kann eine Weile in Caches verbleiben, in den Protokollen eines Anbieters auftauchen oder vollständig aus der öffentlichen Sicht verschwinden.
Dieses Verhalten ist für ein lebendes Namenssystem angemessen. Das DNS existiert nicht, um Historikern ein vollständiges Hauptbuch zu liefern. Es existiert, um Namen und andere Kennungen unter verteilter Autorität abzubilden. Registries, Registrare, autoritative Betreiber, rekursive Resolver und Anwendungen bewahren jeweils unterschiedliche Evidenz. Keine Institution erhält auf natürliche Weise eine Längsschnittbetrachtung über viele Namensräume und Datensatztypen hinweg.
Dieses Fehlen ist folgenreich. Forschende wollen wissen, wie sich die DNSSEC-Verbreitung verändert hat, wann Hosting- oder Mail-Infrastruktur umgezogen ist, wie stark sich autoritative Dienste konzentriert haben und ob eine Richtlinie oder eine Schwachstelle das Verhalten verändert hat. Sicherheitsteams möchten rekonstruieren, wohin eine Domain vor einem Vorfall aufgelöst wurde. Politische Entscheidungsträger benötigen Evidenz für die Abhängigkeit von Anbietern. Ein einmaliger Scan kann einen Zustand beschreiben; er kann den Übergang nicht sichtbar machen.
OpenINTEL wurde gebaut, um diese zeitliche Evidenz durch wiederholte aktive Messungen zu schaffen. Das Projekt beschafft oder erstellt Listen von Namen und Adressbereichen, sendet definierte DNS-Abfragen nach einem Zeitplan und speichert Antworten mit Zeitstempeln und Metadaten. Die Wiederholung des Prozesses erlaubt es Forschenden, über Tage und Jahre Gleiches mit Gleichem zu vergleichen.
Das Wort „Gleiches“ erfordert Disziplin. Quelllisten ändern sich. Neue Datensatztypen kommen hinzu. Software und Infrastruktur werden modernisiert. Manche Tage sind unvollständig. Ein autoritativer Server kann das Projekt drosseln oder blockieren. Eine Antwort kann je nach Messstandort, Anycast-Standort oder Zeitpunkt variieren. Der Längsschnittwert hängt davon ab, diese Änderungen zu dokumentieren, statt das Archiv als eine vollkommen einheitliche Tabelle zu behandeln.
Der zentrale Beitrag von OpenINTEL ist daher nicht bloß das Scanvolumen. Internetweite Scanner können ebenfalls enorme Datensätze erzeugen. Das besondere Gut ist ein lang laufendes Instrument, dessen Methoden, Partner und Datenprodukte stabil genug sind, um Veränderung selbst zum Untersuchungsgegenstand zu machen.
Diese Stärke trägt die Bezeichnung „das tägliche historische Archiv des DNS“ nur mit einer Einschränkung. OpenINTEL bewahrt eine Geschichte der Messungen, für die es konfiguriert wurde. Es zeichnet nicht jede DNS-Abfrage, jede Domain oder jede von Nutzern gesehene Antwort auf. Das Archiv ist genau so groß, dass unachtsame Sprache es universell klingen lassen kann. Seine Glaubwürdigkeit hängt davon ab, dieser Versuchung zu widerstehen.
Die Zielliste bestimmt das Sichtfeld des Archivs
Aktive DNS-Messung erfordert eine Zielpopulation. OpenINTEL kann aus Zonen abgeleitete Domain-Listen, Namen aus der Certificate Transparency, Popularitätslisten, Apex-Daten von Ländercodes, Adressbereiche und andere Quellen erhalten. Jede Quelle beantwortet eine andere Forschungsfrage und enthält eine andere Verzerrung.
Eine Registry-Zone kann eine breite Abdeckung der unter dieser Top-Level-Domain delegierten Namen liefern, vorbehaltlich vertraglicher Regelungen. Sie kann Namen in anderen Namensräumen auslassen und sagt nichts darüber, ob eine Domain einen aktiven Dienst hostet. Certificate-Transparency-Protokolle zeigen Namen, die mit öffentlich protokollierten Zertifikaten verbunden sind; sie bevorzugen TLS-fähige Dienste und legen Subdomains offen, die in Zonenlisten nicht vorkommen. Popularitätslisten betonen häufig aufgerufene Namen unter undurchsichtigen oder sich ändernden Methoden. Reverse-DNS-Messungen beginnen beim Adressraum statt bei Namen.
Die Kombination von Quellen erhöht die Reichweite, aber auch das Risiko von Doppelzählungen oder einer sich ändernden Zusammensetzung. Die auf der Projektwebsite genannte Zahl von 308 Millionen täglich gemessenen Domains ist als aktuelle Kennzahl des Projekts für konfigurierte Domain-Beobachtungen zu lesen und nicht als 308 Millionen eindeutige aktive Websites. Eine Domain kann geparkt, ohne Inhalt delegiert, über Listen hinweg doppelt geführt oder für Mail und Infrastruktur statt für eine Website genutzt sein.
Die Quellenauswahl beeinflusst die Längsschnittinterpretation. Angenommen, eine neue Top-Level-Domain wird in die Messung aufgenommen: Dann steigt die Gesamtzahl der beobachteten Datensätze, weil das Instrument erweitert wurde, und nicht, weil sich das DNS organisch verändert hat. Eine Popularitätsliste kann ihre Methodik überarbeiten und scheinbare Fluktuation erzeugen. Die Abdeckung durch Certificate Transparency kann zunehmen, wenn sich die Ausstellungspraktiken ändern. Analysten benötigen versionierte Listen und Aufnahmekriterien.
Die Methoden des Projekts können dennoch robuste Trends liefern, wenn Vergleiche klar abgegrenzt werden. Forschende können eine stabile Teilmenge von Namen über die Zeit untersuchen, für Ergänzungen kontrollieren und Quellentypen klassifizieren. Die Größe des Archivs erlaubt die Untersuchung seltener Ereignisse und Infrastrukturbeziehungen, aber große Zahlen gleichen eine undefinierte Population nicht aus.
Die Verwaltung der Listen ist auch kommerziell und politisch. Registries können Messungen im Rahmen von Vereinbarungen erlauben, die die Weiterverteilung einschränken. Betreiber können sich gegen die Last wehren. Ein Projekt, das sich offener Wissenschaft verpflichtet hat, kann Daten, die es nicht weitergeben darf, nicht einfach veröffentlichen. Das Archiv hat daher offene und kontrollierte Ebenen.
Die erste Frage bei jedem OpenINTEL-Ergebnis sollte daher lauten: Welche Namen oder Adressen durften an diesen Tagen überhaupt gemessen werden? Die Antwort ist kein Hintergrunddetail. Sie definiert die Aussage.
OpenINTEL misst Namen und Adressraum von einer niederländischen institutionellen Basis aus, mit globalen Quelllisten und Kooperationen. Das verleiht ihm weltweite Untersuchungsgegenstände, aber keine automatische Repräsentation jeder Region oder jeder Nutzererfahrung.
Der Zonenzugang variiert zwischen den Registries. Manche Ländercode-Listen sind umfassend, andere werden aus öffentlichen Quellen zusammengestellt, und manche dürfen nicht weitergegeben werden. Aus Zertifikaten abgeleitete Namen begünstigen Dienste, die öffentliche Zertifikate verwenden. Ein Messstandort kann eine Anycast-Antwort erhalten, die sich von einer auf einem anderen Kontinent beobachteten unterscheidet. Split-Horizon- und geolokalisiertes DNS können beide Beobachtungen gültig machen.
Forschende, die Länder vergleichen, müssen daher die Registrierungskennung einer Domain vom Standort ihres Betreibers, ihrer Nutzer und ihrer Infrastruktur trennen. Ein Name unter.brkann in Europa gehostet werden; eine generische Top-Level-Domain kann einer lokalen Organisation dienen. Namen nach Endung zu zählen ist nicht dasselbe wie nationale Abhängigkeit zu messen.
Replikation und komplementäre Messstandorte können die geografische Empfindlichkeit testen. Wo Ergebnisse voneinander abweichen, ist die Differenz ein Datum und keine Störgröße, die man wegmitteln sollte. Sie kann Anycast-Richtlinien, Inhaltslokalisierung oder Blockaden sichtbar machen.
Die Gemeinwohlfunktion des Projekts ist am stärksten, wenn Abdeckungslücken explizit kartiert werden. Regionen mit schwächeren Quellenvereinbarungen sollten nicht in einem globalen Prozentsatz verschwinden. Ein historisches Archiv kann Wissensungleichheit nur verringern, wenn Nutzer wissen, wo sein Instrument weniger gut sehen konnte.
Milliarden von Abfragen zählen nur, wenn ihr Kontext erhalten bleibt
Die Messpipeline verwandelt Ziellisten in geplante Abfragen. Worker senden Anfragen für definierte Datensatztypen, empfangen Antworten, normalisieren Felder und speichern Beobachtungen mit Zeitstempeln und Metadaten. In dem von OpenINTEL gemeldeten Umfang – rund 5,9 Milliarden Datenpunkte pro Tag – besteht die betriebliche Herausforderung nicht darin, ein einziges DNS-Paket zu senden. Sie besteht darin, den täglichen Zyklus zuverlässig abzuschließen, ohne die autoritative Infrastruktur zu überlasten oder die Bedingungen hinter dem Ergebnis zu verlieren.
Worker benötigen Ratenkontrolle, eine Wiederholungsrichtlinie und eine klare Quellenkennzeichnung. Eine Zeitüberschreitung kann fehlenden Dienst, Paketverlust, Ratenbegrenzung, einen vorübergehenden Fehler oder eine absichtliche Blockade bedeuten. Zu aggressives Wiederholen kann genau den Schaden verursachen, den das Projekt vermeiden will. Eine öffentliche Erklärung und ein Kontaktweg für Betreiber machen den Datenverkehr rechenschaftspflichtig.
Antworten müssen über viele Datensatztypen und DNS-Randfälle hinweg geparst werden. Namen können ungewöhnliche Kodierungen enthalten. Delegationen können fehlerhaft oder zyklisch sein. DNSSEC fügt Signaturen, Schlüssel und Nichtexistenz-Datensätze hinzu. Trunkierung kann eine Abfrage von UDP auf TCP verlagern. Autoritative Server können je nach Quellstandort unterschiedliche Antworten liefern. Die Normalisierung muss die Bedeutung erhalten, ohne jedes Paket in ein unhandhabbares Format zu verwandeln.
Das System benötigt außerdem eine Definition von Vollständigkeit. Ein Tageslauf kann für die meisten Ziele abgeschlossen sein und eine Teilmenge verfehlen. Nur erfolgreiche Antworten zu speichern würde Abwesenheit unsichtbar machen. Forschende müssen wissen, welche Abfragen versucht wurden, welche fehlschlugen und ob ein Plattformausfall einen Zeitraum beeinträchtigte. Ein fehlender Datensatz sollte nicht automatisch zum Beleg dafür werden, dass eine Domain ihn entfernt hat.
Die Projektwebsite von OpenINTEL meldet seit 2015 kumulativ 13,6 Billionen Datenpunkte. Diese Zahl vermittelt Größenordnung und bleibt eine Angabe des Projekts. Ihr analytischer Wert hängt davon ab, wie „Datenpunkt“ über Produkte und Zeit hinweg definiert ist. Eine Zahl kann durch mehr Domains, mehr Datensatztypen oder häufigere Beobachtungen wachsen. Nutzer sollten die jeweilige Datensatzmethodik heranziehen, statt kumulierte Summen als einfaches Maß für das DNS-Wachstum zu vergleichen.
Bei diesem Volumen prägen technische Entscheidungen die Forschung. Partitionierung, Komprimierung, Indizes und Speicherformate bestimmen, welche Abfragen praktikabel sind. Datenmigrationen können die Darstellung verändern. Qualitätskontrollsysteme müssen unvollständige Läufe erkennen. Das Archiv ist zugleich wissenschaftliches Instrument und Datenplattform.
Forward-DNS zeigt Konfiguration statt Anwendungsverhalten
Die Forward-Messung beginnt mit einem Namen und fragt ausgewählte Datensätze ab. Delegationsdaten können zeigen, welche autoritativen Anbieter die Domain bedienen. Adressdatensätze können Hosting- oder CDN-Beziehungen sichtbar machen. Mail-Exchange-Datensätze legen die E-Mail-Infrastruktur offen. DNSSEC-Datensätze zeigen Einsatz und Algorithmuswahl. Andere Typen offenbaren Dienst- und Richtlinienkonfiguration.
Wiederholte Beobachtungen machen Übergänge sichtbar. Eine Domain kann von einem autoritativen Anbieter zu einem anderen wechseln, IPv6 hinzufügen, DNSSEC aktivieren oder den Maildienst ändern. Im großen Maßstab können Forschende Verbreitung und Konzentration schätzen. Sie können prüfen, ob Änderungen allmählich oder um ein Ereignis herum auftreten.
Ein zurückgegebener Datensatz bleibt eine Beobachtung zu einem Zeitpunkt und von einem Messstandort aus. Eine A- oder AAAA-Adresse beweist nicht, dass eine Website geantwortet hat, dass die Adresse Nutzern denselben Inhalt lieferte oder dass die Anwendung sicher war. Ein Mail Exchange beweist keine erfolgreiche Zustellung. Eine DNSSEC-Signatur kann vorhanden sein, während die Validierung anderswo fehlschlägt. Tests auf Anwendungsebene erfordern separate Methoden.
CDNs und Anycast erschweren die Interpretation. Eine autoritative oder rekursive Antwort kann je nach Quellstandort variieren. Eine Domain kann Adressen zurückgeben, die für den OpenINTEL-Messstandort ausgewählt wurden, und nicht die Adressen, die ein Nutzer in einer anderen Region erhält. Split-Horizon-Systeme geben internen und externen Clients bewusst unterschiedliche Antworten. Die Messung des Projekts ist nicht falsch; sie ist eine Sicht.
Caching fügt eine weitere Unterscheidung hinzu. Das aktive System von OpenINTEL kann je nach Datensatz über definierte Resolver-Pfade oder autoritative Infrastruktur abfragen. Es beobachtet nicht, was jeder rekursive Resolver zwischengespeichert hat. Ein Nutzer kann bis zum Ablauf der TTL einen früheren Wert erhalten. Änderungen im Archiv können nutzersichtbaren Übergängen vorausgehen oder folgen.
Der Wert der Plattform ist dort am größten, wo die Forschungsfrage zur Methode passt: wie sich die vom Projekt beobachteten konfigurierten DNS-Antworten verändert haben. Er sinkt, wenn die Antwort ohne zusätzliche Evidenz als Näherungswert für Popularität, Anwendungserfolg oder Nutzererfahrung verwendet wird.
Reverse DNS und Adressraum-Produkte verbinden Namensgebung mit Netzverwaltung
Reverse DNS beginnt bei einer IP-Adresse und fragt, welcher Name – falls vorhanden – über die Hierarchie von in-addr.arpa oder ip6.arpa zugeordnet ist. OpenINTEL hat sich auf IPv4-Reverse-Messungen ausgeweitet und damit eine weitere große Längsschnittbetrachtung geschaffen. Der Datensatz kann administrative Benennungsmuster, Infrastrukturänderungen und das Vorhandensein von Datensätzen im gesamten Adressraum sichtbar machen.
Ein PTR-Datensatz ist kein autoritativer Nachweis dafür, wer eine Adresse nutzt oder welchen Dienst sie bereitstellt. Adressinhaber können Datensätze veralten lassen, generische Namen verwenden oder Reverse-Zonen delegieren. Cloud- und Zugangsnetze können systematische Benennungen anwenden. Manche Adressen haben keinen Reverse-Eintrag. Die Daten sind für Klassifizierung und Veränderungsanalyse nützlich, nicht als universelle Identitätskarte.
Die Messung des IPv4-Reverse-Raums ist im Vergleich zu IPv6 machbar, weil die Adresspopulation kleiner und unter definierter Richtlinie aufzählbar ist. IPv6 ist zu groß für ein erschöpfendes Adresse-für-Adresse-Scannen. Die Forschung muss zugewiesene Präfixe, beobachtete Adressen oder andere Zielauswahlmethoden verwenden. Dieser Unterschied verbietet es, die IPv4-Methodik ohne Einschränkung auf das neuere Protokoll zu übertragen.
Das Projekt veröffentlicht außerdem Produkte auf RIR- und Netzwerkpräfix-Ebene. Zeitliche Präfix-Top-Listen versuchen, Netzwerkpräfixe unter definierten Beobachtungen zu ordnen. Solche Listen können Messstichproben und Forschung unterstützen, sind aber keine objektive Hierarchie der Netzbedeutung. Ein Präfix kann allein wegen der Listenkonstruktion und der Dienstpopulation prominent erscheinen. Geschäftswert, Datenverkehr und Nutzerzahl bleiben getrennt.
Diese Produkte erweitern OpenINTEL von einem Domain-Observatorium hin zu einer Plattform für Namensgebung und Adressierung. Sie erhöhen auch den Bedarf an sorgfältigen Bezeichnungen. „DNS-Geschichte“ kann Domain-Datensätze, Reverse-Namen, aus Zertifikaten abgeleitete Ziele und abgeleitete Zonenänderungen umfassen – jeweils mit eigener Population und eigenem Rhythmus.
Die Erweiterung ist analytisch wertvoll, weil die Internet-Infrastruktur Namen, Adressen und Netze verbindet. Eine Hosting-Migration kann in Forward-Datensätzen und Präfixbeziehungen erscheinen. Reverse-Namen können betrieblichen Kontext liefern. RIR-Daten können Beobachtungen gruppieren. Die Verbindung bleibt ein Inferenzrahmen und kein vollständiges Eigentumsregister.
Zonestream verkleinert die Lücke zwischen täglichen Momentaufnahmen und tagesinternen Änderungen
Ein täglicher Scan hält einen breiten Zustand fest. Das DNS kann sich zwischen zwei Scans mehrfach ändern. Eine bösartige Kampagne kann aktiv werden und wieder verschwinden. Ein großer Anbieter kann Datensätze in Stufen migrieren. Ein Konfigurationsfehler kann eingeführt und vor dem nächsten geplanten Lauf behoben werden.
Zonestream und verwandte Arbeiten zielen darauf ab, stärker ereignisorientierte Evidenz zu liefern, indem sie Zonenänderungen ableiten und Feeds näher am Änderungszeitpunkt erzeugen. Der Ansatz ergänzt das tägliche Archiv, statt es zu ersetzen. Ein Stream kann schnelle Übergänge erkennen; die tägliche Pipeline liefert breite, konsistente Momentaufnahmen.
Schnellere Messungen schaffen Herausforderungen bei Last und Interpretation. Häufigere Abfragen erhöhen den Datenverkehr zu autoritativen Betreibern. Änderungen in einer Zonenquelle bedeuten nicht immer dasselbe wie Änderungen der beobachteten DNS-Antworten. Ein Stream kann Ausbrüche durch Wartungsarbeiten oder automatisierte Systeme enthalten. Konsumenten müssen rohe Ereignisse von bedeutsamen Infrastrukturübergängen unterscheiden.
Das Produkt zeigt, wie sich die Architektur von OpenINTEL über einen einzelnen Batch-Prozess hinaus entwickelt hat. Das Projekt begann mit dem Nachweis, dass ein riesiger Tageslauf abgeschlossen werden kann. Später kamen Wege hinzu, Veränderungen in unterschiedlicher zeitlicher Auflösung zu beobachten. Das erweitert die Anwendungsfälle und erschwert zugleich die Vergleichbarkeit.
Forschende sollten angeben, welcher Rhythmus eine Aussage stützt. Ein Tagesdatensatz kann zeigen, dass sich eine Konfiguration zwischen zwei Daten unterschied. Ein Stream kann eine Zwischensequenz zeigen. Keiner von beiden erklärt zwangsläufig, warum der Betreiber handelte. Die Kombination mit Registry-, Zertifikats- oder Vorfallsevidenz kann die Darstellung stärken.
Zonestream erhöht auch die betriebliche Bedeutung kontinuierlicher Verfügbarkeit. Ein fehlender Tages-Scan erzeugt eine Lücke. Ein ausgefallener Ereignis-Feed kann eine Sequenz verlieren, die schwer zu rekonstruieren ist. Redundanz, Replay und Überwachung werden Teil der Forschungsmethode.
Speicherung ist das dauerhafteste Ergebnis und die größte Verpflichtung des Projekts
Das Archiv von OpenINTEL ist wertvoll, weil sich das DNS von gestern nicht direkt abfragen lässt. Sobald sich ein Zustand ändert und Caches ablaufen, kann die wiederholte Messung die einzige öffentliche Evidenz dafür sein, dass der Messstandort des Projekts ihn beobachtet hat. Das macht Speicherung und Datenintegrität zur zentralen Infrastruktur.
Ein Archiv im Jahrzehntmaßstab braucht mehr als Kapazität. Es braucht versionierte Schemata, Prüfsummen, Replikation, dokumentierte Migrationen und eine Möglichkeit, die Beziehung zwischen Beobachtungen und Methoden zu bewahren. Eine ohne Migrationsdatensatz umbenannte Spalte kann die Reproduzierbarkeit zerstören. Eine Komprimierungsänderung kann Kosten senken und ältere Werkzeuge erschweren. Eine beschädigte Partition kann Evidenz entfernen, die kein neuer Scan wiederherstellen kann.
Aufbewahrung erzeugt finanziellen Druck. Milliarden täglicher Datenpunkte erfordern Rechen-, Netz- und Speicherkapazität. Öffentliche Quellen nennen keine konsolidierten Jahreskosten. Die Last verteilt sich auf Partnerinstitutionen und Förderprogramme. Mit wachsendem Archiv muss das Projekt wählen zwischen der Aufbewahrung roher Details, der Erzeugung abgeleiteter Datensätze und der Zugangskontrolle.
Abfragekosten sind eine weitere Einschränkung. Ein Forschender möchte möglicherweise Jahre von Datensätzen über Millionen Domains durchsuchen. Unbeschränkte Abfragen zuzulassen kann die Plattform überlasten. Download-Produkte und kontrollierter Zugang verteilen die Arbeit, verlangen aber, dass Nutzer die Daten selbst speichern und verarbeiten. In der Cloud gehostete Kopien könnten den Zugang verbessern, werfen jedoch Kosten- und Governance-Fragen auf.
Die Längsschnittintegrität hängt auch davon ab, Abwesenheit zu bewahren. Ein Tag ohne Datensatz kann bedeuten, dass der Domain der Wert fehlte, die Abfrage fehlschlug, das Ziel nicht in der Liste stand oder die Pipeline unvollständig war. Das Archiv braucht genügend Kontrolldaten, um diese Zustände zu unterscheiden. Andernfalls kann ein Trend ein Artefakt der Instrumentierung sein.
Die Zukunft des Projekts hängt teilweise davon ab, ob Institutionen diese unsichtbare Arbeit weiter finanzieren. Neue Datensatztypen und Dashboards ziehen Aufmerksamkeit auf sich. Die Pflege alter Bytes, Dokumentation und Kontext schafft das historische Gut. Gehen Speicher oder Fachpersonal verloren, lässt sich die Kontinuität des Archivs später nicht zurückkaufen.
Vier Institutionen teilen sich die Plattform ohne ein sichtbares Gesamtbudget
Die organisatorische Resilienz von OpenINTEL entsteht durch Partnerschaft. Die University of Twente stellt akademische Leitung und Forschende. SIDN bringt Registry-Wissen und Unterstützung ein. NLnet Labs steuert DNS-Software- und Betriebsexpertise bei. SURF trägt nationale Forschungsinfrastruktur bei. Diese Kombination ist stärker als ein Projekt, das von einer einzigen Projektleitung und einer einzigen Förderung abhängt.
Das Modell ist in herkömmlichen Finanzbegriffen zugleich undurchsichtig. Es gibt keine konsolidierten Projekteinnahmen, -ausgaben oder Personalzahlen. Hardware kann von einem Partner finanziert, Forschende können von einem anderen angestellt und Netzkapazität von einem dritten bereitgestellt werden. Öffentliche Seiten benennen Rollen, liefern aber keine einheitliche Abstimmungsordnung und kein Anlagenverzeichnis.
Das macht das Projekt nicht unregiert. Entscheidungen entstehen durch institutionelle Beziehungen und ein Kernteam. Es bedeutet aber, dass Änderungen der Partnerprioritäten die Plattform beeinflussen können, ohne als Unternehmensereignis sichtbar zu werden. Eine Förderung endet, ein Server erreicht das Austauschalter oder eine Fachkraft wechselt die Rolle. Das Archiv kann weiterlaufen, während die Entwicklungskapazität schrumpft.
Die Konzentration von Expertise ist ein Risiko. Lang laufende Messsysteme sammeln Wissen über Eigenheiten, Datenmigrationen und Betreiberbeziehungen. Dokumentation und Nachfolge sind ebenso wichtig wie neuer Code. Eine Partnerschaft kann die Last nur verteilen, wenn mehr als eine Institution kritische Komponenten betreiben kann.
Das Modell prägt auch die Rechenschaftspflicht gegenüber den gemessenen Betreibern. Eine sichtbare Projektidentität und ein Abuse-Kontakt ermöglichen es autoritativen Anbietern, übermäßigen Datenverkehr zu melden. Partner mit Ansehen in der DNS-Community können Probleme verhandeln. Das System muss dieses Vertrauen bewahren, wenn Umfang und Produkte wachsen.
OpenINTEL lässt sich am besten als gemeinsame Forschungsinfrastruktur beschreiben. Seine Autorität beruht auf Qualität und Kontinuität seiner Evidenz, nicht auf einem gesetzlichen Anspruch auf das DNS. Es misst ein verteiltes System unter der Toleranz von Organisationen, die es weiterhin blockieren oder einschränken können.
Offene Daten hängen weiterhin von Verträgen, Lizenzen und langfristiger Finanzierung ab
OpenINTEL fördert den Forschungszugang und veröffentlicht geeignete Datensätze unter CC BY-NC-SA 4.0. Die Lizenz verlangt Namensnennung, schränkt die kommerzielle Nutzung ein und sieht Share-Alike-Bedingungen vor. Anderes Material bleibt kontrolliert, weil Zonenzugangsvereinbarungen oder Quellenverträge eine uneingeschränkte Weiterverteilung nicht erlauben.
Diese Regelung kann Nutzer enttäuschen, die „OpenINTEL“ hören und annehmen, jede Beobachtung sei für jeden Zweck frei herunterladbar. Der Projektname beschreibt eine Forschungsverpflichtung, nicht das Eigentum an jedem Input. Eine Registry kann Messungen unter Bedingungen erlauben, ohne das Recht zur erneuten Veröffentlichung ihrer vollständigen zonabgeleiteten Daten zu gewähren.
Die nicht kommerzielle Einschränkung unterstützt akademisches Teilen und begrenzt manche industrielle Wiederverwendung. Ein Unternehmen benötigt für ein kommerzielles Produkt möglicherweise eine gesonderte Vereinbarung. Das Projekt veröffentlicht keine allgemeine kommerzielle Lizenz und keinen Preis. Nutzer sollten die Betreiber kontaktieren, statt anzunehmen, die Zugangsbedingungen ließen sich aus den offenen Datensätzen ableiten.
Kontrollierte Daten können Forschung weiterhin über Anträge, institutionelle Vereinbarungen oder abgeleitete Ergebnisse unterstützen. Der Prozess bringt Auswahl- und Verwaltungskosten mit sich. Forschende mit etablierten Zugehörigkeiten erhalten möglicherweise leichter Zugang als unabhängige Analysten. Reproduzierbarkeit wird schwieriger, wenn der zugrunde liegende Datensatz nicht weitergegeben werden darf.
Die Spannung ist strukturell. Längsschnitt-DNS-Forschung profitiert von breitem Quellenzugang. Registries und Betreiber haben vertragliche, sicherheitsbezogene und kommerzielle Anliegen. Eine Plattform, die diese Vereinbarungen verletzte, könnte kurzfristig mehr veröffentlichen und künftigen Zugang verlieren. Nachhaltige Offenheit erfordert manchmal eine dokumentierte Grenze statt maximaler Veröffentlichung.
Für Datennutzer ist die korrekte Praxis datensatzspezifisch. Quelle, Lizenz, Abdeckung und Zugangsbedingung sind anzugeben. Kontrollierte Daten sollten nicht als öffentlich bezeichnet werden. Es sollte nicht angenommen werden, eine offene abgeleitete Tabelle enthalte das vollständige zugrunde liegende Archiv. Die Governance der Daten ist Teil der Methode.
Die aktuellen offenen Datensätze verwenden eine nicht kommerzielle Creative-Commons-Lizenz, während anderes Material durch Quellenverträge kontrolliert bleibt. Das unterstützt akademische Arbeit und verhindert die einfache Annahme, sämtliche Archivinhalte seien für jede geschäftliche Nutzung frei.
Kommerzielle Analysten möchten historische DNS-Evidenz für Sicherheit, Marktforschung oder Due Diligence nutzen. Diese Nachfrage könnte helfen, Infrastruktur zu finanzieren, und kann zugleich mit Beschränkungen von Registries und den Erwartungen der gemessenen Betreiber kollidieren. Ein kostenpflichtiger Weg müsste Service und Support von Rechten trennen, die das Projekt nicht besitzt.
Die Partner könnten abgeleitete Aggregate, kontrollierte Forschungsumgebungen oder ausgehandelte Lizenzen für geeignete Daten bereitstellen. Jedes Modell verändert, wer ein Ergebnis reproduzieren kann. Ein privates Produkt, das aus einem Gemeinwohlarchiv entsteht, kann Wert schaffen, ohne Methoden oder Korrekturen zurückzugeben.
Die Governance-Frage lautet nicht, ob kommerzielle Nutzung gut oder schlecht ist. Sie lautet, ob Erlösmodelle die Längsschnittaufzeichnung bewahren, Quellenrechte respektieren und vermeiden, dass die vollständigsten Daten nur gut finanzierten Nutzern zur Verfügung stehen.
Die Nachhaltigkeit von OpenINTEL könnte künftig formellere Zugangsstufen erfordern. Deren Glaubwürdigkeit hängt von transparenten Kriterien und einer geschützten öffentlichen Basis ab. Das Archiv ist durch gemeinsame Forschung wertvoll geworden. Die Finanzierung seiner Zukunft sollte seine Vergangenheit nicht ununtersuchbar machen.
Eine DNS-Antwort dokumentiert Konfiguration, nicht Absicht oder Schaden
Große DNS-Datensätze laden zu kategorischen Schlüssen ein. Ein Datensatz zeigt auf eine Adresse, die mit einem Anbieter verbunden ist – also sei die Domain dort gehostet. Ein Name liefert NXDOMAIN – also sei er nicht existent. Ein aus einem Zertifikat abgeleiteter Name löst auf – also sei der Dienst aktiv. Jede dieser Schlussfolgerungen kann nützlich und im Einzelfall falsch sein.
Eine DNS-Antwort dokumentiert, was die abgefragte Infrastruktur unter den Messbedingungen zurückgegeben hat. Sie zeigt nicht, warum der Betreiber dies konfiguriert hat. Die Adresse kann ein Redirect, ein Sinkhole, eine geparkte Seite oder ein gemeinsam genutzter CDN-Edge sein. Die Anwendung kann den Hostnamen ablehnen. Der Datensatz kann veraltet sein. Ein vorübergehender Serverausfall oder eine Ratenbegrenzung kann eine scheinbare Abwesenheit erzeugen.
NXDOMAIN bedeutet, dass der antwortende DNS-Pfad die Nichtexistenz des abgefragten Namens in seinem aktuellen Zustand behauptet hat. Es beweist nicht, dass der Name nie existierte oder später nicht existieren wird. Delegationsfehler und inkonsistente autoritative Server können unterschiedliche Ergebnisse erzeugen. Wiederholte Beobachtungen und direkte autoritative Prüfungen erhöhen die Sicherheit.
Sicherheitsanalysen erfordern noch mehr Vorsicht. Schnelle Domain- oder Adressänderungen können mit Missbrauch, aber auch mit legitimen CDNs, Failover und Migrationen verbunden sein. Ein Datensatz beweist nicht, dass eine Domain bösartig ist. Eine Kennzeichnung erfordert zusätzliche Evidenz wie Inhalte, Kampagnenbeziehungen, Registrierung und beobachtetes Verhalten.
Die Nutzernachfrage liegt vollständig außerhalb der aktiven Messung. OpenINTEL erzeugt seine eigenen Abfragen. Es sieht nicht, wie oft Nutzer einen Namen anfragen, was rekursive Caches liefern oder welche Antwort Datenverkehr erzeugt. Passives DNS oder Resolver-Telemetrie beantwortet andere Fragen und birgt andere Datenschutzfragen.
Die stärkste analytische Kultur des Projekts behandelt diese Grenzen als zentralen Bestandteil. Ein riesiges Archiv kann bessere Schlussfolgerungen stützen, weil Muster und Geschichte verfügbar sind. Es ändert nicht den logischen Status einer einzelnen Beobachtung. Die Messung bleibt ein Input für Erklärungen, nicht die Erklärung selbst.
Eine NXDOMAIN-Antwort kann darauf hinweisen, dass ein Name in der relevanten DNS-Sicht nicht existiert. Eine Zeitüberschreitung kann auf einen nicht erreichbaren Server, Ratenbegrenzung, Paketverlust oder bewusste Ablehnung hindeuten. Ein SERVFAIL kann aus Validierungs-, Delegations- oder vorübergehenden Betriebsproblemen entstehen.
Die Längsschnittanalyse sollte diese Kategorien bewahren, statt sie zu „ausgefallen“ zusammenzufassen. Eine Domain, die von einer gültigen Antwort zu NXDOMAIN wechselt, hat eine andere Geschichte als eine, die immer wieder in Zeitüberschreitungen läuft. Eine Parser- oder Wiederholungsänderung kann die gemessene Verteilung verändern, ohne dass ein Betreiber seine Konfiguration ändert.
Die Unterscheidung ist besonders wichtig in der Sicherheits- und Politikforschung. Eine Nichtantwort ist kein Beleg dafür, dass eine Domain entfernt oder zensiert wurde. Möglicherweise sind zusätzliche Messstandorte, autoritative Abfragen und Anwendungsprüfungen erforderlich.
Der Umfang von OpenINTEL macht die Fehlerklassifizierung folgenreich. Eine kleine methodische Entscheidung kann Millionen Datensätze betreffen. Der sorgfältige Umgang mit negativer Evidenz ist einer der klarsten Wege, wie das Projekt verhindern kann, dass ein riesiges Archiv übermäßig selbstsichere Schlussfolgerungen erzeugt.
Längsschnittaussagen hängen von Methodengeschichte und fehlenden Beobachtungen ab
Ein Datensatz im Jahrzehntmaßstab enthält zwei Geschichten: die Geschichte des DNS und die Geschichte des Instruments. Hardware wird ersetzt, Abfragesoftware ändert sich, Parser werden repariert und Quellenvereinbarungen erweitert. Ein 2024 hinzugefügter Datensatztyp lässt sich nicht direkt mit einer Abwesenheit im Jahr 2018 vergleichen. Eine neue Wiederholungsregel kann die Vollständigkeit verbessern und zugleich die Wahrscheinlichkeit verändern, dass ein langsamer Server als antwortend erscheint.
Aus diesem Grund ist Methodenversionierung Teil der Daten. Jede Beobachtungsreihe sollte mit Zielliste, Abfragetyp, Messstandort, Softwareversion und bekannten Betriebsereignissen verknüpft sein. Fehlende Tage benötigen explizite Kennzeichen. Ein Analyst sollte nicht schlussfolgern, Millionen Domains hätten sich geändert, wenn ein Worker-Cluster ausfiel oder ein Eingabefeed zu spät eintraf.
Nach einer Speichermigration wird das Problem schwieriger. Ein neues kann wiederholte Felder komprimieren, Namen anders normalisieren oder Fehler neu klassifizieren. Diese Änderungen können das Archiv günstiger und leichter nutzbar machen, während sie alte Abfragen verändern. Die Aufbewahrung roher oder hinreichend detaillierter Quelldatensätze, des Migrationscodes und von Validierungsstichproben erlaubt es Forschenden, einen DNS-Trend von einer Datenbanktransformation zu unterscheiden.
Reproduzierbarkeit verlangt nicht, dass die gesamte Plattform eingefroren bleibt. Sie verlangt genügend Evidenz, um zu rekonstruieren, wie ein Ergebnis entstanden ist. Veröffentlichte Arbeiten sollten Datensatzversion oder Zugriffsdatum, Populationsfilter und Code benennen. Wenn Vertragsbedingungen die Weitergabe roher Datensätze verhindern, können Forschende innerhalb der Vereinbarung dennoch Methoden, Aggregate und Validierungsprüfungen veröffentlichen.
Die Partnerschaft von OpenINTEL mit externen Forschenden und die Replikationsarbeit sind hier wichtig. Eine zweite Implementierung oder unabhängige Messung wird keine identischen Antworten liefern, aber Unterschiede können Annahmen offenlegen. Replikation ist besonders wertvoll, wenn Anycast, Blockaden oder Listenlizenzierung einen Messstandort strukturell unvollständig machen.
Das Alter des Archivs erhöht die Kosten einer stillen Änderung. Eine geringfügige, rückwirkend angewendete Parser-Korrektur kann Jahre von Daten verändern. Den Fehler unangetastet zu lassen, kann einen bekannten Mangel fortschreiben. Der verantwortungsvolle Ansatz besteht darin, die Korrektur zu dokumentieren, den ursprünglichen Zustand wo möglich zu bewahren und anzugeben, welche Version einem Ergebnis zugrunde liegt.
Das ist die wenig glamouröse Arbeit, die Infrastruktur von einer Sammlung von Dateien unterscheidet. Die gemeldeten Billionen Datenpunkte der Plattform zählen nur, wenn künftige Nutzer erkennen können, welche Punkte in denselben Vergleich gehören. Längsschnittwissenschaft ist eine Übung darin, Kontext im selben Maßstab wie Beobachtungen zu bewahren.
Verantwortungsvolles Scannen muss für die Betreiber sichtbar bleiben, die seine Kosten tragen
Aktive Messungen verbrauchen Ressourcen außerhalb des Projekts. Eine DNS-Abfrage ist klein, aber Milliarden Abfragen erreichen autoritative Systeme, die von großen Anycast-Plattformen bis zu bescheidenen Servern reichen. Ratenkontrollen und Zeitplanung verringern die Auswirkungen; sie machen die Kosten nicht null. Zur ethischen Grundlage der Arbeit gehören daher Transparenz und ein praktischer Weg für Betreiber, Einspruch zu erheben.
Eine verantwortungsvolle Plattform verwendet identifizierbare Quelladressen, veröffentlicht eine Beschreibung ihres Datenverkehrs und überwacht Kontaktkanäle. Sie sollte berechtigte Aufforderungen, Messungen zu reduzieren oder zu blockieren, respektieren und Meldungen ungewöhnlicher Last untersuchen. Diese Maßnahmen schaffen keine universelle Zustimmung. Sie machen das Projekt für eine Aktivität rechenschaftspflichtig, die technisch ohne vorherige Erlaubnis möglich ist.
Die Last ist nicht gleich verteilt. Ein stark delegierter Anbieter kann Abfragen zu Millionen Namen erhalten, während ein kleiner Betreiber nur wenige sieht. Manche Server sind so konfiguriert, dass sie unbekannten Datenverkehr drosseln; das erzeugt ein scheinbares Messversagen. Andere liefern bewusst generische Antworten. Ein Analyst muss erkennen, dass Betreiberabwehr den beobachteten Datensatz verändert.
Das Datenschutzrisiko unterscheidet sich vom passiven Resolver-Logging. OpenINTEL erzeugt Abfragen aus Ziellisten und beobachtet keine einzelnen Nutzer. Das begrenzt die Exposition gegenüber Nutzerverhalten erheblich. Das Archiv kann dennoch Namen enthalten, die Organisationen, Geräte oder Dienste identifizieren, einschließlich aus Zertifikatsprotokollen abgeleiteter Subdomains. Die Veröffentlichung detaillierter historischer Datensätze kann vergessene Infrastruktur leichter auffindbar machen.
Zugangskontrollen und Lizenzierung können Missbrauch verringern, ohne jede DNS-Beobachtung zu vertraulichen Daten zu machen. Die angemessene Grenze hängt von Quelle, Granularität und Risiko ab. Breite Aggregate und Forschungsdatensätze können bedenkenlos veröffentlicht werden, während rohe zonabgeleitete Datensätze vertraglich kontrolliert bleiben. Ein der offenen Wissenschaft verpflichtetes Projekt muss diese Unterschiede erklären, statt Zugang als alles oder nichts darzustellen.
Ethische Prüfungen müssen auch nachgelagerte Behauptungen berücksichtigen. Eine Forschungsarbeit, die eine Domain oder ein Land als unsicher bezeichnet, kann Reputationsschaden anrichten, wenn die Messung tatsächlich nur einen vorübergehenden Fehler erfasst hat. Das Projekt kann nicht jeden Nutzer kontrollieren, aber klare Vorbehalte, Bedingungen und Beispiele können bessere Praxis fördern.
Die Legitimität von OpenINTEL beruht teilweise darauf, dass gemessene Betreiber sehen können, wer fragt. Diese Sichtbarkeit sollte eine Designanforderung bleiben, wenn Produkte schneller und vielfältiger werden. Ein Observatorium verdient sich die Toleranz des Systems, das es beobachtet, indem es sein eigenes Verhalten der Prüfung zugänglich macht.
Aktives DNS, passives DNS und allgemeines Scannen beantworten unterschiedliche Fragen
OpenINTEL wird manchmal mit passiven DNS-Datenbanken, internetweiten Scannern und verteilten Messsystemen verglichen. Der Vergleich ist erst nützlich, wenn das Beobachtungsmodell getrennt wird.
Passives DNS sammelt Datensätze, die im echten Abfragedatenverkehr an rekursiven Resolvern oder anderen Beobachtungspunkten gesehen werden. Es kann zeigen, was Nutzer oder Systeme angefragt haben und welche Antworten über diese Pfade zurückkamen. Die Abdeckung hängt von den teilnehmenden Sensoren ab und wirft Datenschutz- und Vertragsfragen auf. Eine passive Datenbank sieht eine populäre bösartige Domain möglicherweise schnell, übersieht aber eine unauffällige Domain, nach der kein beobachteter Nutzer fragt.
OpenINTEL wählt seine Ziele und stellt die Fragen selbst. Es kann dieselbe Population jeden Tag messen, selbst wenn kein Nutzer die Namen besucht. Diese Regelmäßigkeit stützt Längsschnittvergleiche. Aus den aktiven Abfragen kann es keine Popularität oder kein Cache-Verhalten ableiten. Beide Methoden ergänzen sich: Die eine spiegelt beobachtete Nachfrage an ausgewählten Resolvern, die andere konfigurierte Antworten für ausgewählte Ziele von Messstandorten aus.
Ein Scanner wie ZMap beginnt mit Adressen und fragt, ob ein Dienst antwortet, oft gefolgt von einem Protokoll-Handshake. Er kann exponierte Dienste kartieren, ohne auf Domain-Listen angewiesen zu sein. DNS-Messungen können Namen und Delegationen identifizieren, die auf gemeinsame Infrastruktur verweisen, einschließlich Datensätzen, deren Dienste nicht erreichbar sind. Auch hier sehen die Methoden unterschiedliche Oberflächen.
Eine verteilte Messplattform wie RIPE Atlas kann DNS-Fragen aus vielen Netzen und Standorten stellen und geografische sowie resolverabhängige Unterschiede sichtbar machen. OpenINTEL betont Breite, Wiederholung und Archivumfang aus seiner Messinfrastruktur heraus. Eine kleinere Population von vielen Messstandorten kann eine Frage beantworten, die ein einziger riesiger Tages-Scan nicht beantworten kann.
Diese Unterscheidungen verhindern einen häufigen Fehler: alle großen Internetdatensätze als austauschbare Evidenz zu behandeln. Eine Domain, die im aktiven DNS fehlt, in passiven Daten nicht sichtbar und in einem Adress-Scan nicht erreichbar ist, kann hinter Zugangskontrollen oder Split-Horizon-Namensgebung weiterhin existieren. Eine von allen drei Methoden beobachtete Domain weist stärkere Evidenz für öffentlichen Betrieb auf, aber selbst das belegt nicht, wer sie nutzte oder warum.
Die strategische Chance besteht nicht darin, eine universelle Datenbank zu bauen. Sie besteht darin, Methoden durch explizite Zeitstempel, Populationen und Unsicherheit zu verbinden. OpenINTEL kann in diesem größeren Evidenzsystem die Längsschnitt-Namensebene liefern. Sein Wert wächst, wenn Analysten wissen, welche Fragen ein anderes Instrument erfordern.
DNSSEC-Verbreitung wird erst durch wiederholte Messung lesbar
DNSSEC ist ein nützliches Beispiel dafür, warum ein tägliches Archiv wichtig ist. Eine Zone kann Delegationsmaterial veröffentlichen, autoritative Server können signierte Datensätze liefern und Validatoren können entscheiden, ob die resultierende Kette sicher ist. Diese Schritte bewegen sich nicht notwendigerweise gemeinsam. Eine Länderregistry kann signierte Delegationen aktivieren, während viele Domain-Inhaber unsigniert bleiben. Eine Domain kann Schlüssel veröffentlichen, aber die Validierung nicht bestehen, weil Signaturen ablaufen oder ein übergeordneter Datensatz fehlerhaft ist.
Ein Ein-Tages-Scan kann Zustände zählen; er kann nicht zeigen, wie Betreiber in sie hinein-, aus ihnen heraus- oder sie repariert haben.
OpenINTEL kann das Auftauchen und Verschwinden relevanter Datensätze innerhalb einer definierten Population verfolgen. Forschende können Domains, die unsigniert bleiben, von solchen trennen, die nur zeitweise konfiguriert sind, Änderungen rund um Algorithmus- oder Schlüsselübergänge erkennen und messen, wie lange defekte Zustände andauern. Die wiederholte Methode verwandelt einen Verbreitungsprozentsatz in eine Menge betrieblicher Pfade.
Die Interpretation hängt weiterhin vom Messdesign ab. DNSKEY- oder DS-Datensätze zu sehen ist nicht dasselbe, als jeden Validierungsschritt genau so auszuführen, wie es der rekursive Resolver eines Nutzers tun würde. Antworten können je nach Messstandort abweichen, und eine Domain kann signiert sein, während ihre Anwendung nicht erreichbar bleibt. Ein Projekt, das DNSSEC untersucht, muss angeben, welche Datensätze, welche Validierungslogik und welche Fehlerkategorien es verwendet hat. Vergleiche über Jahre müssen Listenwachstum und Softwareänderungen berücksichtigen.
Diese Einschränkungen machen das Ergebnis nützlicher, nicht weniger. Standardisierungsdiskussionen stützen sich oft auf Schlagzeilen-Verbreitungszahlen, die die Kosten der Wartung verbergen. Längsschnittdaten können zeigen, ob eine Änderung dauerhafte Konfiguration, einen Experimentierschub oder ein wiederkehrendes Fehlermuster erzeugt. Sie können eine langsame Einführung von einer unterscheiden, die ein Plateau erreicht hat, weil die verbleibende Population andere Anreize hat.
Dieselbe Logik gilt für IPv6-Datensätze, Mail-Sicherheit und andere Infrastrukturpraktiken. Eine Technologie ist nicht allein deshalb eingeführt, weil ein Datensatz einmal auftauchte. Sie wird zur Infrastruktur, wenn die Konfiguration bestehen bleibt, Fehler repariert werden und abhängige Systeme sich konsistent verhalten. Das Archiv von OpenINTEL kann solche Übergänge sichtbar machen, weil es genügend tägliche Evidenz bewahrt, um ein Ereignis von einer Gewohnheit zu trennen.
Für Betreiber kann diese Geschichte unbequem sein. Eine lange Aufzeichnung macht wiederholte Fehlkonfigurationen sichtbar. Sie kann auch belegen, dass ein Problem vor einem Vorfall oder einer politischen Intervention behoben wurde. Messungen weisen keine Absicht zu, verändern aber die Qualität der Argumentation. Die Diskussion bewegt sich von der Erinnerung zur datierten Evidenz.
Anbieterkonzentration zeigt sich in Mustern, während Kausalität außerhalb des Datensatzes bleibt
Das DNS kann sichtbar machen, wo Infrastruktur konzentriert ist. Viele Domains können an denselben autoritativen Anbieter delegieren, Mail an denselben Dienst verweisen oder Webnamen in Adressraum auflösen lassen, der zu einer kleinen Gruppe von Plattformen gehört. Die Verfolgung dieser Beziehungen über die Zeit kann Konsolidierung, Migration und Abhängigkeit zeigen, die nach einer Marktverschiebung schwer zu rekonstruieren wären.
OpenINTEL eignet sich gut für den deskriptiven Teil dieser Arbeit. Wiederholte Datensätze können zeigen, dass die Nameserver-Domains eines Anbieters in einem wachsenden Anteil einer gemessenen Population auftauchen, dass auf eine Übernahme eine Änderung der Benennungsmuster folgt oder dass Domains nach einem Ausfall abwandern. Die Anreicherung um Adressen und autonome Systeme kann Namen mit Netzinfrastruktur verbinden, vorbehaltlich der Genauigkeit und des Zeitbezugs von Routing-Daten.
Das Archiv kann nicht jeden Grund für einen Wechsel erklären. Eine Domain kann einen Anbieter wegen Preis, Leistung, Sicherheit, eines Registrar-Bündels oder einer Fusion nutzen. Gemeinsames Nameserver-Branding kann mehrere unabhängige Infrastrukturen verbergen. Eine große Plattform kann viele autonome Systeme nutzen, während ein autonomes System nicht verwandte Kunden hosten kann. DNS-Daten stützen ein Konzentrationsmaß; sie beweisen keine Marktmacht und keine Kundenzufriedenheit.
Die politische Konsequenz ist unmittelbar. Eine Regulierungsbehörde könnte versucht sein, einen hohen gemessenen Anteil als Evidenz für schädliche Kontrolle zu behandeln. Ein Betreiber könnte denselben Anteil als Evidenz dafür behandeln, dass ein Dienst Vertrauen verdient hat. Der Datensatz kann das Muster und das Datum belegen. Wirtschaftliche und rechtliche Schlussfolgerungen erfordern Verträge, Eigentumsunterlagen, Ausfallevidenz und Wechselkosten der Nutzer.
Längsschnittmessungen liefern zwei Erkenntnisse, die einer Marktmomentaufnahme entgehen. Erstens können sie die Geschwindigkeit der Konzentration zeigen. Eine langsame, jahrzehntelange Bewegung hat andere Ursachen und Abhilfen als ein plötzlicher Wandel durch die Einstellung eines Produkts. Zweitens können sie Umkehrbarkeit zeigen. Wenn Domains häufig den Anbieter wechseln, kann ein konzentrierter Markt dennoch praktische Mobilität aufweisen. Bleiben Delegationen trotz wiederholter Ausfälle bestehen, kann die Bindung tiefer sein, als der Schlagzeilenanteil vermuten lässt.
Die Geschichte kann auch versteckte Gleichfehler-Risiken sichtbar machen. Organisationen glauben möglicherweise, unterschiedliche Anwendungshosts zu nutzen, während sie DNS, Mail und Zertifikate über dieselbe Anbieterfamilie delegieren. Ein Ausfall in dieser gemeinsamen Schicht kann ansonsten getrennte Systeme beeinträchtigen. OpenINTEL modelliert nicht die gesamte Abhängigkeitskette, kann aber die Namensevidenz liefern, mit der eine vollständigere Karte beginnt.
Die verantwortungsvollste Nutzung des Archivs besteht daher darin, Konzentration als beobachtete Struktur zu behandeln und anschließend den Mechanismus zu untersuchen. Eine Messplattform sollte Abhängigkeit sichtbar machen, ohne so zu tun, als enthalte eine Liste von Datensätzen die gesamte politische Ökonomie des Internets.
Zertifikate, Mail-Datensätze und Namen lassen sich verknüpfen, ohne ein einziges System zu werden
Das DNS arbeitet nicht isoliert. Certificate-Transparency-Protokolle legen Namen offen, die für öffentliche Zertifikate eingereicht wurden. Mail-Datensätze identifizieren Exchange-Infrastruktur und Richtlinien. Adressdatensätze verweisen auf Hosting-Netze. Reverse-Namen können administrative Hinweise liefern. Die Quellenprodukte und wiederholten Abfragen von OpenINTEL ermöglichen es zu untersuchen, wie diese Systeme sich im Zeitverlauf zueinander verhalten.
Aus Zertifikaten abgeleitete Namen erweitern die beobachtbare Population über die in einer Zonenliste verfügbaren Apex-Domains hinaus. Sie können Service-Subdomains und temporäre Namen sichtbar machen, die für die PKI-Forschung relevant sind. Die Quelle ist selektiv: Sie bevorzugt öffentlich protokollierte Zertifikate und enthält Namen, die möglicherweise nie Datenverkehr bedient haben. Ein Zertifikat kann in einem Protokoll verbleiben, nachdem der zugehörige Dienst verschwunden ist.
Die aktive DNS-Messung fügt eine aktuelle Konfigurationsbeobachtung hinzu, aber keinen Beleg dafür, dass das Zertifikat installiert ist oder von einem Browser als vertrauenswürdig eingestuft wird.
Mail-Datensätze erzeugen eine andere Karte. MX-Ziele und zugehörige TXT-Datensätze können den Wechsel zu gehosteten Mail-Anbietern, die Einführung von Authentifizierungsrichtlinien und Konfigurationsfehler zeigen. Wiederholte Beobachtungen können erkennen, ob eine Richtlinie dauerhaft beibehalten oder nur kurz getestet wurde. Sie zeigen weder Nachrichtenvolumen noch Zustellerfolg noch, wie empfangende Systeme die Richtlinie angewendet haben.
Infrastrukturdaten können auch die Rekonstruktion von Vorfällen unterstützen. Änderte eine Domain innerhalb eines engen Zeitraums Nameserver, Mail-Hosts und Adressen, erhalten Ermittler eine Zeitleiste. Die Abfolge kann eine legitime Migration, die Erholung nach einer Kompromittierung oder eine Übernahme widerspiegeln. Die DNS-Geschichte grenzt die Fragen ein; sie etikettiert das Ereignis nicht.
Der Wert entsteht durch die Verknüpfung von Evidenz unter Bewahrung ihrer Herkunft. Ein Zertifikatsprotokoll, eine Zone, eine aktive Antwort und eine Routing-Tabelle haben jeweils unterschiedlichen Zeitbezug und unterschiedliche Autorität. Sie in einer Analyse zu kombinieren kann eine Beziehung offenlegen, aber die Schlussfolgerung ist nur so stark wie die schwächste Verknüpfung. Ein von mehreren Diensten wiederverwendeter Name, eine Adresse hinter einer gemeinsamen Plattform oder ein veraltetes Zertifikat können eine falsche Assoziation erzeugen.
Die Rolle von OpenINTEL ist am stärksten, wenn es diese Datensätze unterscheidbar hält. Forschende sollten sagen können, dass ein Name über ein Zertifikatsprotokoll in die Zielliste gelangte, während der aktiven Messung einen bestimmten Datensatz zurückgab und unter einer separat datierten Routing-Sicht einem Netzpräfix zugeordnet wurde. Dieser Satz ist weniger spektakulär als die Aussage, die Plattform „kenne das Internet“, aber er ist reproduzierbar.
Diese multiquellenbasierte Disziplin ist zugleich ein Schutz gegen rückblickende Gewissheit. Nach einem Vorfall suchen Analysten in den Daten naturgemäß nach einer Geschichte. Eine versionierte Messspur zwingt die Geschichte dazu, zu respektieren, was zum jeweiligen Zeitpunkt beobachtbar war. Sie kann zeigen, dass zwei Ereignisse korreliert waren, ohne zu behaupten, das eine habe das andere verursacht.
Präfix-Rankings erweitern das Archiv von Namen hin zu Netzen
Die zeitlichen Präfix-Top-Listen des Projekts veranschaulichen, dass OpenINTEL abgeleitete Produkte und nicht nur rohe DNS-Antworten erzeugen kann. Ein Präfix-Ranking aggregiert Evidenz auf Netzebene und verfolgt, wie sich die Prominenz im Zeitverlauf verändert. Das kann Forschenden helfen, repräsentative Netze auszuwählen, Infrastrukturkonzentration zu untersuchen oder Messziele zu vergleichen, ohne für jede Arbeit dieselben Verknüpfungen neu aufzubauen.
Ein Präfix ist keine Organisation. Routing-Ankündigungen können sich ändern, Adressraum kann verleast werden, und ein Netz kann viele nicht verwandte Dienste hosten. Rankings hängen von den einbezogenen Namen und Datensatztypen, dem Datum der Routing-Daten und der zur Messung der Prominenz verwendeten Metrik ab. Eine hohe Position kann breites Hosting, gemeinsame Infrastruktur oder einen Listenauswahleffekt bedeuten.
Das zeitliche Design ist der nützliche Teil. Eine statische Liste veraltet schnell, wenn Dienste umziehen und sich Routing ändert. Wiederholte Rankings können zeigen, wann ein Netz eine prominente Position erreicht oder verlässt, und ermöglichen es Forschenden, eine zu einem früheren Zeitpunkt passende Population zu reproduzieren. Sie legen zudem Instabilität offen, die eine einzelne „Top-Netzwerke“-Liste verbergen würde.
Abgeleitete Datensätze senken die Forschungskosten. Sie können ausgefeilte Infrastrukturanalysen Teams zugänglich machen, die nicht über die Speicher- und Rechenressourcen zur Verarbeitung des vollständigen Archivs verfügen. Dieser Nutzen erhöht die Verantwortung des Projekts, Methodik und Versionierung zu veröffentlichen. Nutzer könnten ein bequemes Ranking als objektive Grundwahrheit behandeln, obwohl es nur eine aus ausgewählten Eingaben erzeugte Sicht ist.
Die Erweiterung hin zu netzbezogenen Produkten macht OpenINTEL nicht zu einem Routing-Observatorium oder einer RIR. Es nutzt öffentlichen Registry- und Routing-Kontext, um DNS-Beobachtungen anzureichern. Routengültigkeit, Eigentumsstreitigkeiten und Betriebsleistung bleiben getrennte Fragen.
Diese Grenze ist strategisch gesund. Das Projekt kann gemeinsame abgeleitete Evidenz anbieten, ohne Autorität über die von ihm gerankten Entitäten zu beanspruchen. Das Produkt ist am wertvollsten, wenn es Rechenarbeit spart und das analytische Urteil sichtbar lässt.
Sicherheitsforschung gewinnt eine Zeitleiste statt eines Urteils über Bösartigkeit
Historische DNS-Daten sind für Sicherheitsteams attraktiv, weil Missbrauchsinfrastruktur häufig umzieht. Eine Domain kann Adressen, Nameserver oder Mailsysteme rotieren; eine Kampagne kann Anbieter wiederverwenden; ein Vorfall kann entdeckt werden, nachdem sich die relevante Konfiguration bereits geändert hat. OpenINTEL kann datierte Beobachtungen liefern, die solche Übergänge rekonstruierbar machen.
Diese Evidenz ist besonders nützlich für die Eingrenzung. Ermittler können fragen, wann eine verdächtige Domain erstmals in einer gemessenen Liste auftauchte, ob sich ihr autoritativer Dienst um ein Ereignis herum veränderte und welche anderen Namen zu diesem Zeitpunkt dieselbe Infrastruktur teilten. Ein Sicherheitsforscher kann diese Beziehungen nutzen, um Hypothesen zu bilden und zu entscheiden, welche Systeme genauer untersucht werden müssen.
Keiner der Datensätze belegt für sich allein Bösartigkeit. Schnelle Änderungen können ein Zeichen für Ausweichverhalten sein, kommen aber auch in Content-Delivery-Netzen, bei der Notfallwiederherstellung und bei legitimen Migrationen vor. Gemeinsames Hosting legt gutartige und schädliche Domains auf dieselbe Adresse. Eine Nameserver-Assoziation kann einen Registrar-Standard widerspiegeln und keine gemeinsame Kontrolle. Selbst ein Muster, das einer bekannten Kampagne stark ähnelt, benötigt Bestätigung durch Inhalte, Registrierung, Malware, Telemetrie oder rechtliche Evidenz.
Diese Unterscheidung ist wichtig, weil historische Datensätze Assoziationen dauerhafter erscheinen lassen können, als sie waren. Eine Domain, die einen Tag lang eine Adresse teilte, kann in der abgeleiteten Datenbank eines Analysten jahrelang mit einer anderen gruppiert werden. Zeitfenster und Konfidenz sollten mit der Beziehung mitwandern. Dasselbe gilt für die Quellenpopulation: Eine aus einem Zertifikat abgeleitete Subdomain und ein Apex-Name aus einer Registry-Zone sind nicht auf dieselbe Weise ins Archiv gelangt.
Die Rolle von OpenINTEL besteht darin, Infrastrukturfakten zu bewahren, die andernfalls verschwinden könnten. Kennzeichnung, Attribution und Reaktion gehören in getrennte Prozesse. Sicherheitsarbeit ist am stärksten, wenn das Archiv Unsicherheit einengt, ohne zur Klärung von Absichten herangezogen zu werden.
Das Archiv macht Infrastrukturveränderungen anfechtbar
Jeder Messtag erhöht den betrieblichen Wert und die Speicherverpflichtung. Das Projekt muss Abfragekapazität erhalten, Hardware ersetzen, Datenbanken migrieren und Fachleute halten, die sowohl das DNS als auch die Geschichte des Systems verstehen. Keine dieser Aufgaben ist allein dadurch gesichert, dass das Archiv wichtig geworden ist.
Das Vier-Partner-Modell verteilt Risiken, macht Nachhaltigkeit aber von außen schwerer lesbar. Eine Institution kann Personal finanzieren, eine andere Rechenkapazität und eine dritte den Zugang zu Quelldaten. Eine Änderung in einer Komponente kann die Abdeckung verringern, ohne dass es eine übliche Unternehmensankündigung gibt. Öffentliche Finanzberichte für das Projekt als Ganzes liegen nicht vor; Nutzer sollten daher technische und institutionelle Signale beobachten, statt Kontinuität vorauszusetzen.
Archivpflege erfordert Redundanz über Backups hinaus. Eine replizierte Kopie muss Schemata, Methodenaufzeichnungen, Versionen der Quelllisten und das Wissen enthalten, das zur Interpretation von Anomalien nötig ist. Ein Stapel Dateien an einem anderen Standort ist kein funktionierendes historisches Instrument. Die Zusammenarbeit mit Organisationen wie CAIDA kann Resilienz und methodischen Vergleich verbessern, auch wenn vertraglich geschützte Daten begrenzen können, was kopiert werden darf.
Das Lizenzmodell prägt ebenfalls die Zukunft. Nicht kommerzieller offener Zugang unterstützt akademische Wiederverwendung, schränkt aber manche kommerziellen Anwendungen ein. Kontrollierte Zonendaten lassen sich nicht einfach unter einer breiteren Lizenz veröffentlichen. Die Partner benötigen möglicherweise Finanzierungsmodelle, die den Forschungszugang bewahren und zugleich die tatsächlichen Kosten für Speicherung und Support decken. Ein kommerzieller Weg sollte, falls er entsteht, die öffentliche Aufzeichnung, auf der die Legitimität des Projekts beruht, nicht stillschweigend einschränken.
Erfolg kann selbst Fragilität erzeugen. Wenn mehr Arbeiten und politische Aussagen von OpenINTEL abhängen, betrifft ein fehlender Zeitraum oder ein geänderter Datensatz eine breitere Gemeinschaft. Das Projekt benötigt möglicherweise formellere Veröffentlichungsaufzeichnungen, Serviceerwartungen und Bewahrungsrichtlinien, als ein Forschungssystem normalerweise veröffentlicht. Das sind keine Anzeichen dafür, dass es ein Unternehmen werden sollte. Sie sind Anzeichen dafür, dass es Infrastruktur geworden ist.
Der wertvollste künftige Meilenstein könnte einer sein, der keine Schlagzeile erzeugt: eine transparente Migration zu neuem Speicher, bei der alte Ergebnisse, Vorbehalte und Zugangswege intakt bleiben. OpenINTEL hat bereits gezeigt, dass es in bemerkenswertem Umfang messen kann. Die schwierigere Prüfung ist, ob die Organisationen dahinter die Bedingungen bewahren können, die zehn Jahre Messungen mit den nächsten zehn Jahren vergleichbar machen.
OpenINTEL kann nicht die ganze Geschichte des DNS erzählen. Es kann zeigen, dass ein definierter Name an einem Datum von seinem Messstandort aus eine definierte Antwort zurückgab, und es kann diese Beobachtung über enorme Populationen wiederholen. Das genügt, um viele Aussagen zu verändern.
Ein Anbieter kann sagen, die DNSSEC-Verbreitung sei gestiegen; das Archiv kann den gemessenen Übergang und die Population zeigen. Ein Forschender kann behaupten, autoritatives Hosting habe sich konzentriert; die Daten können zeigen, welche Listen und Zeiträume das stützen. Ein Vorfallsermittler kann rekonstruieren, wann sich ein Datensatz änderte. Ein anderer Analyst kann die Methodik angreifen, statt einen Screenshot zu akzeptieren.
Der Umfang des Projekts ist beeindruckend: Hunderte Millionen Domains, Milliarden täglicher Datenpunkte und Billionen kumulativer Beobachtungen nach seinen eigenen aktuellen Kennzahlen. Die wichtigere Leistung ist die Kontinuität über institutionelle und technische Veränderungen hinweg. Das Archiv macht die Vergangenheit des DNS als Evidenz verfügbar statt als Erinnerung.
Diese Evidenz bleibt durch Listen, Verträge, Messstandort und Methode begrenzt. Die Glaubwürdigkeit von OpenINTEL entsteht daraus, diese Grenzen zu bewahren. Es eine vollständige Kopie des DNS zu nennen, würde das Projekt überzeichnen und den Nutzen seiner tatsächlichen Aufzeichnung schwächen.
Ein historisches Observatorium muss nicht alles sehen. Es muss sagen, was es gesehen hat, die Bedingungen bewahren und lange genug verfügbar bleiben, damit Veränderung gemessen werden kann. OpenINTEL hat ein solches Instrument für die Namensinfrastruktur gebaut. Seine nächste Herausforderung ist sicherzustellen, dass das Archiv und die Institutionen dahinter so dauerhaft bleiben wie die Trends, die Forschende untersuchen möchten.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten