
Zusammenfassung
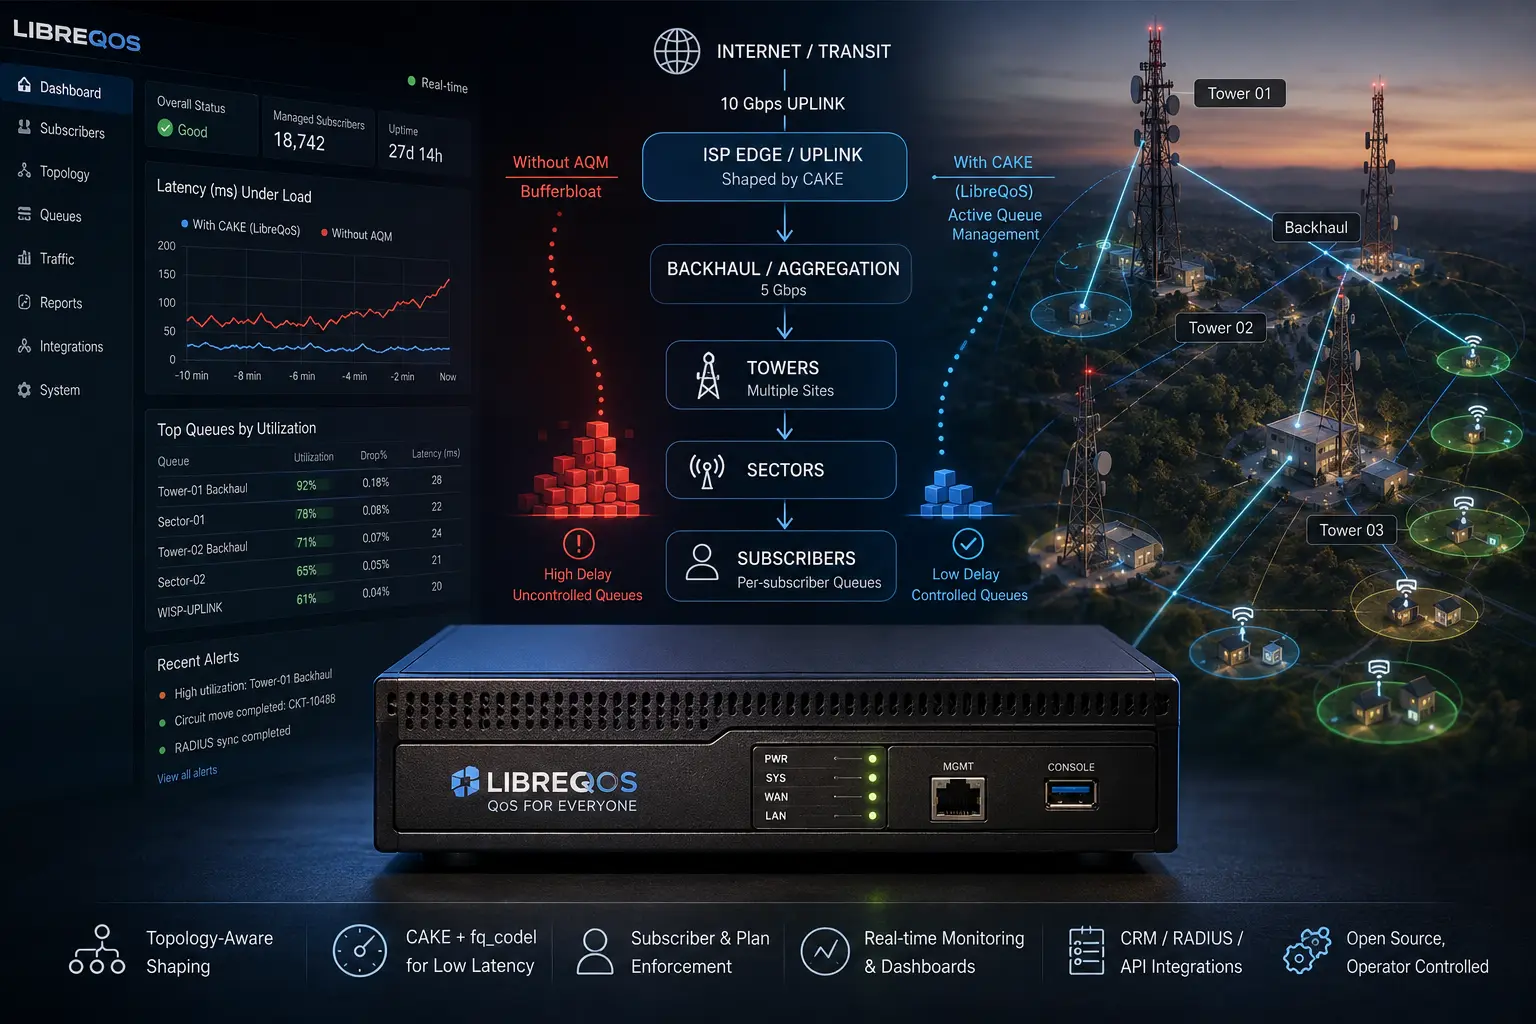
- LibreQoS läuft inline und wendet CAKE auf Teilnehmer- und gemeinsam genutzte Engpässe an; es zielt auf Verzögerungen, die herkömmliche Geschwindigkeits- und Auslastungswerte übersehen können.
- Seine Hierarchie aus Circuits, Sektoren, Türmen und Backhauls übersetzt Topologiedaten in laufende Queueing-Richtlinien, sodass veraltete Datensätze das Kundenerlebnis direkt verzerren können.
- Die Versionen vom März 2026 erweiterten die lokale Oberfläche und die betrieblichen Abläufe und schärften zugleich die Grenze zwischen dem GPL-Kern und den kostenpflichtigen LibreQoE-Diensten.
- Das System kann keine Kapazität erzeugen und keine Warteschlangen außerhalb seines Pfads steuern; falsche Raten, asymmetrisches Routing, variable Funkstrecken und Inline-Ausfälle bleiben wesentliche Einschränkungen.
Jedes Paket durchläuft den Shaper, deshalb kommt zuerst die Ausfallplanung
LibreQoS läuft üblicherweise als transparente Bridge: Der Verkehr tritt über eine Netzwerkschnittstelle ein, durchquert einen Linux-Server und verlässt ihn über eine andere. Diese Platzierung gibt dem System die Befugnis, jedes Paket auf dem Pfad zu klassifizieren und in Warteschlangen einzureihen. Sie bedeutet aber auch, dass ein Softwareabsturz, eine defekte Netzwerkkarte, eine fehlerhafte Bridge-Konfiguration oder ein überlasteter Prozessor die gesamte dahinterliegende Verbindung beeinträchtigen kann.
Die physische Position ist die erste Tatsache, die ein Betreiber verstehen muss. Eine Out-of-Band-Überwachungsplattform kann ausfallen, während die Pakete weiterlaufen. Ein Inline-Shaper wirkt unmittelbar an der Weiterleitung mit. Bypass-Hardware, redundante Stromversorgung, Kernel-Updates, Recovery-Images und ein getesteter ungeshaper Pfad gehören zur Bereitstellung und sind keine optionale Arbeit, über die man erst nachdenkt, wenn die Latenzgraphen besser aussehen.
LibreQoS nutzt diese Inline-Position, um zu steuern, wo sich Warteschlangen bilden. Wenn Linux knapp unter der Rate einer nachgelagerten Verbindung sendet, warten Pakete in einer Warteschlange, die der Host verwalten kann, statt in einem undurchsichtigen Modem, einer Funkstrecke oder einem Provider-Gerät. Das System kann außerdem gemeinsam genutzte Engpässe abbilden – etwa einen Tower-Backhaul oder einen Funksektor – und übergeordnete Warteschlangen auf die darunter konkurrierenden Teilnehmer anwenden.
Das Betriebsmodell lässt eine Frage offen: Kann ein kleiner Anbieter Topologie und modernes Warteschlangenmanagement in dauerhaft bessere Kundenerlebnisse übersetzen, ohne dass ein Inline-Server und ein unvollständiges Netzwerkinventar zu neuen Fehlerquellen werden?
Die Antwort hängt von Platzierung und Genauigkeit ab. Hat der Anbieter einen 10-Gigabit-Uplink und konfiguriert LibreQoS unterhalb dieses Werts, wird der Server absichtlich zum Engpass. Das kann nützlich sein, weil die Warteschlange nun sichtbar und steuerbar ist. Wird der Wert zu niedrig angesetzt, geht Kapazität verloren. Wird er zu hoch angesetzt, können sich Pakete weiterhin auf der unkontrollierten Verbindung stauen.
Auch die Pfadsymmetrie ist wichtig. Durchquert nur eine Richtung den Shaper, kontrolliert LibreQoS nur das, was es sieht. Routing-Änderungen können Verkehr am Knoten vorbeiführen. Eine Topologie, die bei der Installation korrekt war, kann nach gewöhnlicher Netzwerkwartung falsch werden.
Hochverfügbarkeit erfordert neben einem zweiten Server auch eine Zustandsrichtlinie. Ein Failover kann den Pfad ändern, Zähler zurücksetzen oder das Shaping entfernen. Ein Bypass-Gerät kann die Konnektivität erhalten, aber das alte Queueing-Problem zurückkehren lassen. Der Anbieter muss entscheiden, ob der Fehlerzustand ungeshaper Dienst, reduzierter Dienst oder ein anderer Shaper mit aktueller Richtlinie ist.
Standardhardware hält das System zugänglich, macht Leistung aber nicht automatisch. CPU, Netzwerkkarten, PCIe-Bandbreite, Interrupt-Verhalten und nicht-uniformer Speicherzugriff können alle eine Rolle spielen. Die Projektdokumentation nennt einen ungefähren Virtualisierungs-Overhead von 30 Prozent; dieser Wert ist lastabhängig und keine universelle Konstante.
LibreQoS bietet inspizierbare Warteschlangensteuerung auf gewöhnlichen Linux-Systemen. Der Betreiber muss darum herum dennoch Zuverlässigkeit auf Appliance-Niveau aufbauen. Weil jedes Kundenpaket die Box durchquert, ist der Ausfallplan Teil des Qualitätsversprechens für das Nutzungserlebnis.
Volle Geschwindigkeit kann immer noch mit unerträglicher Verzögerung ankommen
Breitbandleistung wird meist als Rate verkauft. Ein Kunde kauft einen Tarif in Megabit oder Gigabit pro Sekunde, führt einen Geschwindigkeitstest aus und erwartet, dass das Ergebnis das Erlebnis erklärt. Die Kennzahl ist nützlich und unvollständig. Eine Verbindung kann während eines Tests ihre beworbene Rate erreichen und schmerzhaft werden, wenn ein Upload, ein Cloud-Backup oder ein Software-Update eine Warteschlange füllt. Webseiten zögern, Anrufe werden abgehackt und Spiele reagieren spät, obwohl Pakete weiterhin mit hohem Durchsatz fließen.
Dieser Zustand wird mit Bufferbloat in Verbindung gebracht: übermäßige Warteschlangenverzögerung unter Last. Puffer sind notwendig, weil Verkehr in Bursts ankommt und Verbindungen unterschiedliche Geschwindigkeiten haben. Eine kurze Warteschlange kann einen Engpass ausgelastet halten. Eine große ständige Warteschlange kann Pakete hunderte Millisekunden oder länger festhalten, ohne die nutzbare Kapazität zu erhöhen. Der Nutzer erlebt die Wartezeit, während ein Betreiber, der nur auf die durchschnittliche Auslastung schaut, eine gesunde Verbindung sehen kann.
Große Betreiber können spezialisierte Traffic-Management-Systeme kaufen, umfangreiche Telemetrie ausrollen und Teams zu deren Abstimmung einsetzen. Kleine und regionale Anbieter haben dieselbe Physik, aber weniger Personal und engere Margen. Funk-Internetanbieter stehen vor einer zusätzlichen Komplikation: Kapazität kann über Türme und Sektoren geteilt werden, und die verfügbare Rate kann sich mit den Funkbedingungen ändern. Ein pauschaler Begrenzer pro Teilnehmer schützt nicht unbedingt den gemeinsamen Backhaul, den alle nutzen.
LibreQoS ist aus dieser Lücke entstanden. Frühe Versionen erschienen etwa 2020 und 2021 durch Arbeiten, die die Bufferbloat-Community mit betrieblichen ISP-Anforderungen verbanden. Das Projekt bot ein Inline-System auf Linux-Basis, das Teilnehmerverkehr erkennen, Tarife durchsetzen und aktives Warteschlangenmanagement am Engpass anwenden konnte. Es wollte Verfahren wie CAKE als Betriebsplattform nutzbar machen und nicht nur als Sammlung von Kommandozeilen-Rezepten.
Das Projekt ist heute mit LibreQoE, LLC verbunden, die die Software entwickelt und unterstützt und kostenpflichtige Produkte rund um den offenen Kern anbietet. LibreQoS ist eine GPL-2.0-Codebasis und ein Community-Projekt. LibreQoE ist der kommerzielle Verwalter und Dienstleister. Bis August 2026 meldete die Website des Unternehmens mehr als 950 Netzwerke, die die Plattform nutzen. Diese Zahl ist als selbstberichtetes Adoptionssignal nützlich und keine unabhängig geprüfte Bestandszählung.
LibreQoS gibt ein engeres Versprechen als „das Internet schneller machen“. LibreQoS fügt keine Glasfaser, kein Spektrum und keinen Backhaul hinzu. Es entscheidet, wie vorhandene Kapazität geteilt wird und wie viel Warteschlange sich aufbauen darf. Am tatsächlichen Engpass konfiguriert, kann aktives Warteschlangenmanagement die Reaktionsfähigkeit erhalten, während eine Verbindung ausgelastet ist. Am falschen Punkt platziert oder mit der falschen Rate versehen, kann das System Verkehr unnötig shapen oder die entscheidende Warteschlange nicht kontrollieren.
Die kommerzielle Konsequenz ist klar. Ein Anbieter kann einen Kapazitätsausbau verschieben, wenn besseres Warteschlangenmanagement das unmittelbare Kundenproblem löst. Er kann durch bessere Sichtbarkeit auch feststellen, dass der Engpass real ist und investiert werden muss. LibreQoS sollte nicht als Ersatz für Kapazitätsplanung dargestellt werden. Es ist ein Weg, Überlastung so lesbar und kontrollierbar zu machen, dass der Betreiber warteschlangenbedingte Verzögerung von einer die Netzkapazität übersteigenden Nachfrage unterscheiden kann.
Die Geschichte des Projekts handelt daher von betrieblicher Übersetzung. CAKE und fq_codel sind ausgefeilte Kernel-Mechanismen. Ein Anbieter braucht Teilnehmerimporte, Topologie, Dashboards, sichere Updates, Support und einen Weg zur Wiederherstellung, wenn das Inline-System ausfällt. LibreQoS hat diese Algorithmen zu jenem größeren Betriebssystem für die Qualität von Zugangsnetzen ausgebaut.
Die Topologie ist eine ausführbare Behauptung darüber, wo Überlastung lebt
Ein Teilnehmer existiert in einem Zugangsnetz nicht allein. Der Circuit kann über einen Sektor, einen Turm, einen Aggregationsstandort und einen Backhaul führen. Jede Ebene kann eine Kapazitätsgrenze haben. LibreQoS bildet diese Struktur als Hierarchie ab und baut daraus Warteschlangen. Das Modell bestimmt, welcher Verkehr konkurriert und wo das System eine aggregierte Rate durchsetzt.
Das ist eine erhebliche Verbesserung gegenüber einer flachen Liste von IP-Adressen und Tarifgeschwindigkeiten. Angenommen, fünfzig Teilnehmer teilen sich einen Funksektor mit weniger Kapazität als die Summe ihrer Tarife. Einzelne Shaper können jeden Teilnehmer unter der gekauften Rate halten, während sich die Sektorwarteschlange andernorts füllt. Eine übergeordnete Warteschlange für den Sektor kann den gemeinsamen Engpass steuern und den Dienst bei Nachfragespitzen gerechter aufteilen.
Die Topologie unterstützt auch Geschäftsrichtlinien. Ein Anbieter kann einen Circuit mit einem Tarif verknüpfen, ihn einem Standort zuordnen und Upstream-Beschränkungen abbilden. Das System kann diese Beziehungen aus CRM-, RADIUS- oder Netzwerkmanagement-Plattformen importieren. Automatisierung vermeidet doppelte Dateneingabe und ermöglicht, dass Tarifänderungen den Shaper schnell erreichen.
Das Modell wird zur Risikoquelle, wenn Geschäftsdaten und Netzrealität auseinanderlaufen. Ein Kunde kann die Adresse wechseln. Ein Circuit kann in einen anderen Sektor verschoben werden. Ein Backhaul kann ausgebaut werden, ohne dass die konfigurierte Kapazität aktualisiert wird. Doppelte oder veraltete Datensätze können Verkehr in die falsche Warteschlange leiten. Der Shaper setzt dann eine kohärente Richtlinie auf eine falsche Welt durch.
Fehler können subtil sein. Ein Kunde unter dem falschen übergeordneten Element wirkt möglicherweise nur während der Spitzenzeit eines anderen Standorts langsam. Eine ausgebaute Verbindung kann künstlich begrenzt bleiben. Ein fehlender Circuit kann in eine Standardklasse fallen und der Tarifdurchsetzung entgehen. Ein Support-Mitarbeiter kann das Dashboard als Netzbeleg interpretieren, wenn das Problem der Import selbst ist.
Daher ist Datenhoheit wichtig. Das CRM kann für Tarife maßgeblich sein, RADIUS für aktive Adressen und ein Netzwerkinventar für die Topologie. LibreQoS muss sie abgleichen. Widersprechen sich die Quellen, braucht der Betreiber eine definierte Priorität und eine Warnung. Stiller Konflikt verwandelt Automatisierung in Drift.
Die Hierarchie ist auch ein Planungsinstrument. Sie kann zeigen, welche übergeordneten Warteschlangen viel Zeit nahe der Kapazität verbringen und welche Teilnehmer Nachfrage erzeugen. Diese Beobachtungen können Backhaul-Ausbauten oder Tarifgestaltung leiten. Es bleiben Messungen vom Standort des Shapers aus. Verkehr, der den Knoten umgeht, oder Überlastung in einem entfernten Netz liegt außerhalb des Modells.
Die Topologie sicher zu ändern ist schwierig, weil Warteschlangenobjekte laufenden Verkehr und Zähler halten. Ein Circuit kann von einem übergeordneten Element zu einem anderen wechseln, während Pakete fließen. Das Neuerstellen der gesamten Hierarchie kann Unterbrechungen verursachen oder Belege zurücksetzen. Das 2.1-Engineering-Programm umfasst transaktionale Verschiebungen und sicherere Reloads, die diese Änderungen weniger störend machen sollen.
Das Wort „transaktional“ sollte als Betriebsziel gelesen werden, nicht als Annahme, dass jeder verteilte Effekt atomar ist. Kernel-Zustand, Klassifizierung, Überwachung und importierte Daten brauchen einen koordinierten Übergang. Ein fehlgeschlagenes Update sollte die alte gültige Struktur hinterlassen statt einer teilweise neuen. Tests müssen gleichzeitigen Verkehr und große Hierarchien abdecken.
Das Topologiebewusstsein von LibreQoS ist eines seiner wichtigsten Unterscheidungsmerkmale. Es übersetzt die physische und kommerzielle Struktur eines ISPs in Queueing-Richtlinien. Es macht außerdem Datenqualität zu einem Teil der Paketweiterleitung. Die Installation des Systems erklärt zugleich, dass das Inventar des Betreibers genau genug ist, um das Kundenerlebnis zu steuern.
CAKE kontrolliert die Warteschlange, die LibreQoS erzeugt, nicht jede Warteschlange auf dem Pfad
CAKE – die Warteschlangendisziplin Common Applications Kept Enhanced – kombiniert aktives Warteschlangenmanagement, Flussisolierung und Rate-Shaping in Linux. Es baut auf Arbeiten der Bufferbloat-Community auf und enthält Mechanismen, die mit fq_codel verbunden sind. LibreQoS nutzt diese Kernel-Fähigkeit, um Verzögerung zu begrenzen und Kapazität auf Flüsse und Teilnehmer aufzuteilen.
Die Grundidee ist, eine große First-in-first-out-Warteschlange zu vermeiden, in der ein Massentransfer jedes andere Paket verzögern kann. Flow-Queueing trennt Verkehr in kleinere Warteschlangen, sodass sporadischer Verkehr wie ein Spielpaket oder ein Sprachframe bedient werden kann, ohne hinter einem großen Download zu warten. Aktives Warteschlangenmanagement erkennt anhaltende Verzögerung und signalisiert Überlastung, bevor Puffer übermäßig groß werden.
Shaping erzeugt einen kontrollierten Engpass. Sendet Linux etwas weniger, als die nachgelagerte Verbindung tragen kann, bildet sich die Warteschlange im Host, wo CAKE sie verwalten kann. Ohne Shaping können sich Pakete in einem Modem, einer Funkstrecke oder einem Provider-Gerät stauen, dessen Warteschlangenverhalten unbekannt ist. Die Technik beseitigt Überlastung nicht; sie verlagert und diszipliniert die Warteschlange.
Kapazitätsgenauigkeit ist zentral. Ist die Rate zu hoch angesetzt, kann sich die unkontrollierte Warteschlange weiterhin nachgelagert füllen. Ist sie zu niedrig, lässt der Anbieter nutzbare Bandbreite ungenutzt. Funkverbindungen erschweren das, weil sich die verfügbare Kapazität mit Modulation, Interferenz und Scheduling ändert. Ein fester Wert kann zu einem Zeitpunkt sicher und zu einem anderen verschwenderisch oder wirkungslos sein.
Die Fairness von CAKE ist außerdem durch das begrenzt, was es klassifizieren kann. Network Address Translation, gemeinsam genutzte Adressen und verschlüsselte Transporte können die Identifikation erschweren. LibreQoS verwendet Teilnehmerzuordnungen und kernelgestützte Klassifizierung, um Verkehr in die vorgesehenen Warteschlangen zu legen. Eine falsche Zuordnung ändert, wer mit wem teilt.
Der Algorithmus kann entfernte Engpässe nicht steuern. Tritt Überlastung in einem Transitnetz, einem Content-Server oder einer heimischen Wi-Fi-Verbindung auf, kann der Inline-ISP-Shaper Symptome beobachten, ohne Befugnis über die Warteschlange zu haben. Ein gutes Latenz-unter-Last-Ergebnis am Zugangsengpass garantiert keine niedrige Ende-zu-Ende-Latenz zu jedem Ziel.
Verkehrstypen reagieren unterschiedlich auf Überlastung. TCP passt seine Senderate an. Manche Echtzeit- oder Individualtransporte verhalten sich anders. Aktives Warteschlangenmanagement kann reaktionsfähige Flüsse vor ständigen Warteschlangen schützen und Flüsse isolieren, aber nicht jede Anwendung zu gutem Verhalten zwingen. Für missbräuchlichen Verkehr können Policing und Richtlinien weiterhin nötig sein.
Der sichtbare Nutzen kann erheblich sein, weil interaktive Verzögerung empfindlich auf Warteschlangen reagiert. Das macht Vorher-Nachher-Demonstrationen überzeugend und leicht überverallgemeinerbar. Ergebnisse hängen vom ursprünglichen Problem, Pfad, Tarif und Workload ab. Ein Anbieter, dessen Hauptproblem unzureichende Funkkapazität ist, sieht möglicherweise nur begrenzte Verbesserungen. Ein Anbieter mit überdimensionierten Puffern kann große Gewinne ohne zusätzliche Bandbreite erzielen.
Der Beitrag von LibreQoS besteht darin, diese Mechanismen über eine ISP-Topologie hinweg zu operationalisieren. Es besitzt weder CAKE noch die zugrunde liegende Linux-Queueing-Arbeit. Dave Täht war ein bedeutender wissenschaftlicher und Community-Beitragender der Bufferbloat-Bewegung und von LibreQoS; sein Tod im April 2025 war ein erheblicher Verlust. Aktuelle Versionen werden von einem breiteren Team gepflegt, und die zugrunde liegende Kernel-Arbeit hat viele Beitragende.
Die Zuordnungsgrenze ist wichtig, weil die Plattform eine Integration ist. Ihr Wert entsteht aus der Kombination von Algorithmen, Netzdaten und Betrieb. Die Algorithmen bleiben außerhalb von LibreQoS nützlich; LibreQoS bleibt von ihrer Upstream-Pflege abhängig.
Variable Funkkapazität zeigt die Grenze einer festen Shaping-Rate
Eine Glasfaserübergabe hat meist eine Kapazität, die sich mit angemessener Stabilität messen und konfigurieren lässt. Ein Funksektor verhält sich anders. Der verfügbare Durchsatz ändert sich mit Signalqualität, Modulation, Interferenz, Wetter, Scheduling und der Mischung der Clients. Der Engpass kann sich innerhalb von Minuten oder Sekunden verschieben. Eine statische Warteschlangenrate kann nicht jede Bedingung treffen.
Wird LibreQoS auf die Best-Case-Kapazität des Sektors konfiguriert, kann die Funkstrecke bei schlechteren Bedingungen zum unkontrollierten Engpass werden. Pakete stauen sich in Geräten außerhalb der Befugnis von CAKE, und die Latenz steigt. Wird die Rate für einen konservativen Worst Case angesetzt, lässt der Anbieter immer dann Kapazität ungenutzt, wenn die Funkstrecke gut arbeitet.
Dynamisches Shaping ist eine verlockende Antwort und hängt von vertrauenswürdigem Feedback ab. Das System braucht eine zeitnahe Schätzung der nutzbaren Kapazität statt eines Link-Speed-Felds oder der theoretischen Rate eines Herstellers. Funktelemetrie kann nacheilen, schwanken oder über eine offene API nicht verfügbar sein. Aggressive Anpassung kann Oszillation erzeugen: Der Shaper jagt Messwerten hinterher, die selbst vom Verkehr beeinflusst werden, den er steuert.
Betreiber können Margen, tageszeitabhängige Profile oder externe Telemetrie nutzen, um die Schätzung zu verbessern. Jede Methode fügt Richtlinie hinzu. Eine Marge schützt die Latenz und opfert Spitzenrate. Ein Profil setzt wiederkehrende Nachfrage und Bedingungen voraus. Eine Telemetrie-Integration schafft eine weitere Abhängigkeit, deren Ausfall einen sicheren Standard braucht.
Die Hierarchie kann das Problem verringern, indem sie stabile Upstream-Engpässe und Teilnehmertarife steuert, auch wenn die Funkstrecke schwankt. Flussisolierung verhindert weiterhin, dass ein Transfer eine Warteschlange dominiert, die LibreQoS gehört. Dem System sollte nicht zugeschrieben werden, Verzögerung zu kontrollieren, die in einem undurchsichtigen Funk-Scheduler entsteht.
Diese Grenze ist in der Kundenkommunikation wichtig. Ein Anbieter kann zeigen, dass seine kontrollierten Warteschlangen gesund bleiben, während die physische Rate eines Sektors abgenommen hat. Der Beleg kann eine Kapazitäts- oder Wartungsentscheidung stützen. Er kann die Latenz des Nutzers nicht verschwinden lassen.
Die schwierigste technische Frage für Access-QoE ist daher nicht, ob CAKE an einem bekannten Engpass funktioniert. Es ist die Frage, wie man einen wandernden Engpass schnell genug erkennt, um zu handeln, ohne Instabilität zu erzeugen. Die Topologie und die Integrationen von LibreQoS geben dem System einen Ort, diese Belege einzubeziehen. Die öffentliche Dokumentation stützt nicht die Aussage, das Problem sei allgemein gelöst.
Die Weboberfläche hat Queueing-Belege in den täglichen Betrieb geholt
Eine Warteschlangenhierarchie auf der Kommandozeile kann technisch wirksam und für das Supportteam, das eine Kundenbeschwerde erklären muss, unzugänglich sein. LibreQoS 2.0 und 2.1 bewegten das Projekt in Richtung einer breiteren Betriebsplattform mit stärkerer lokaler Weboberfläche, Karten, Integrationen und Laufzeitansichten.
Version 2.0 wurde am 19. März 2026 veröffentlicht, gefolgt von 2.1 am 31. März. Das kurze Intervall spiegelt einen aktiven Übergang wider und nicht zwei unzusammenhängende Generationen. Die Versionen aktualisierten, wie Betreiber mit Teilnehmer-, Warteschlangen- und Verkehrsdaten interagieren, und klärten die Grenze zwischen dem offenen lokalen System und kostenpflichtigen Diensten.
Eine Betriebsoberfläche ändert, wer die Belege nutzen kann. Ein Netzwerktechniker kann Warteschlangenzustand und Topologie prüfen. Ein Support-Mitarbeiter kann sehen, ob ein Teilnehmer zugeordnet, aktiv oder begrenzt ist. Ein Manager kann ausgelastete Standorte erkennen. Dieselben Daten leben nicht mehr nur in Kernel-Zählern und Konfigurationsdateien.
Diese Zugänglichkeit ist wertvoll und kann falsche Sicherheit erzeugen. Ein Graph ist nur so genau wie die Importe und Messungen darunter. Verkehrsklassifizierung kann gesampelt oder aggregiert sein. Ein Teilnehmer kann unter einer alten Adresse erscheinen. Eine Karte kann das konfigurierte übergeordnete Element zeigen statt des realen Pfads. Die Oberfläche sollte Datenherkunft und Aktualität sichtbar machen.
Eine lokale Weboberfläche hält Kernabläufe unter der Kontrolle des Anbieters. Sie kann je nach Bereitstellung ohne kommerziellen Cloud-Dienst weiterarbeiten. Sie wird zugleich eine weitere Anwendung, die abgesichert werden muss. Authentifizierung, Zugriffsrollen, Browser-Exposition und Software-Updates sind wichtig, weil die Oberfläche Verkehr offenlegen und Richtlinien ändern kann.
Die Benutzeroberfläche kann Konfigurationsfehler durch Validierung und Kontext verringern. Sie kann leistungsfähige Änderungen aber auch leichter ausführbar machen. Ein sicheres Design braucht Rollentrennung, Bestätigung für Aktionen mit großem Wirkungsradius und einen Audit-Verlauf. Wer das Erlebnis eines Kunden betrachtet, sollte nicht unbedingt einen ganzen Standort verschieben oder Tarifraten ändern dürfen.
Der Betriebsfokus von Version 2.1 ist bedeutsam, weil Open-Source-Netzwerktools oft zwischen einem wirksamen Algorithmus und einem unterstützbaren Produkt stecken bleiben. LibreQoS versucht, diese Lücke zu überwinden. Das Engineering geht über die visuelle Oberfläche hinaus. Es umfasst sicherere Laufzeitänderungen, Integrationen und Grundlagen für den Mehrknotenbetrieb.
Die aktuelle Angabe von LibreQoE zu mehr als 950 Netzwerken deutet auf eine Zielgruppe für diese Arbeit hin. Die Zahl bleibt eine Anbieterangabe. Ein vollständigeres Bild würde aktive Produktionsinstallationen, Tests und Versionen trennen. Es würde auch zeigen, wie viele nur den offenen Kern nutzen und wie viele LibreQoE-Dienste abonnieren.
Der langfristige Test der Oberfläche ist Upgrade-Fähigkeit. Ein Anbieter kann Ansichten oder Integrationen anpassen. Blockieren diese Erweiterungen künftige Versionen, erbt der Betreiber einen Fork. Stabile APIs und Plugin-Grenzen sind wichtiger als ein poliertes Dashboard zum Start.
Die Produktentwicklung von LibreQoS sollte daher als Wechsel des betrieblichen Publikums verstanden werden. Der Shaper begann als Weg, modernes Queueing anzuwenden. Das aktuelle System wird zu einem Ort, an dem technische und kundennahe Teams tägliche Entscheidungen treffen. Das erhöht seinen Wert und die Folgen falscher Daten.
CRM- und RADIUS-Datensätze werden zu Eingaben für die laufende Durchsetzung
Ein ISP hat bereits Systeme, die Kunden, Tarife und Adressen kennen. Dieselben Informationen erneut in einen Shaper einzugeben, erzeugt Verzögerung und Inkonsistenz. LibreQoS integriert sich mit CRM, RADIUS und Plattformen wie UISP und Sonar, damit Teilnehmer- und Topologiedaten in das Warteschlangenmodell importiert werden können.
Der Effizienzgewinn ist unmittelbar. Eine Tarifänderung im Geschäftssystem kann die konfigurierte Rate aktualisieren. Ein neuer Circuit kann ohne manuelle Bearbeitung erscheinen. Authentifizierungsdatensätze können eine aktive Adresse einem Teilnehmer zuordnen. Betriebsteams vermeiden parallele Tabellen.
Die Vertrauensgrenze erweitert sich mit jeder Integration. Eine fehlerhafte API-Antwort oder ein doppelter Kundendatensatz kann die laufende Durchsetzung ändern. Ein für die Abrechnung gedachtes CRM-Feld drückt möglicherweise nicht den exakten physischen Engpass aus. RADIUS-Daten können flüchtig sein. Eine Netzplattform kann Standortnamen verwenden, die nicht zur LibreQoS-Hierarchie passen.
Der Betreiber braucht eine Übersetzungsschicht mit Validierung. Importierte Kapazität sollte in sinnvollen Grenzen liegen. Adressen sollten nicht ohne explizites Shared-Service-Modell mehreren aktiven Circuits zugewiesen werden. Eine Standortverschiebung sollte eine Bestätigung verlangen, wenn sie die übergeordnete Warteschlange ändert. Die Integration sollte abgelehnte Datensätze melden, statt sie stillschweigend in einen Standard zu legen.
Timing ist wichtig. Ein Kunden-Upgrade sollte nicht Stunden brauchen, um den Shaper zu erreichen, während eine versehentliche Tarifänderung nicht ohne Prüfung sofort über die Flotte propagieren sollte. Unterschiedliche Felder verdienen unterschiedliche Bereitstellungsrichtlinien. Die API kann den Transport automatisieren; sie kann nicht die Risikobereitschaft der Organisation entscheiden.
Datenabgleich ist bei Ausfällen besonders schwierig. Ist das Quellsystem nicht verfügbar, sollte der Shaper den letzten bekannten Zustand behalten? Meist ja, denn das Verwerfen aller Richtlinien wäre störend. Das System braucht dann einen Weg, veraltete Daten zu erkennen und sich zu erholen, ohne einen Rückstau widersprüchlicher Änderungen anzuwenden.
Integrationen erzeugen außerdem eine Abhängigkeit von kommerziellen Systemen, deren APIs sich ändern. Ein Anbieter kann LibreQoS teilweise einführen, um eine proprietäre Appliance zu vermeiden, und bleibt dennoch an einen CRM-Konnektor gebunden. Offene Formate, dokumentierte Zuordnungen und exportierbarer Zustand erhalten Optionen.
Datenschutz gehört in das Design. Teilnehmeradressen, Verkehrsvolumen und Tarifdaten sind sensibel. Ein lokales System reduziert externe Datenübertragung, während Insight oder andere kommerzielle Dienste zusätzliche Datenpfade nutzen können. Der Betreiber sollte verstehen, welche Felder das Netz verlassen und warum.
Die Integrationen sind ein Grund, warum LibreQoS nützlicher ist als eine Sammlung vontc-Befehlen. Sie verbinden Queueing-Richtlinien mit dem Geschäfts- und dem physischen Netz. Sie sind auch der Punkt, an dem ein Netzfehler in einem Kundenservice-Workflow beginnen kann. Betriebliche Reife verlangt, jeden Konnektor als Produktionscode mit Tests, Versionierung und einem Verantwortlichen zu behandeln.
Transaktionale Verschiebungen zielen darauf, Live-Topologie zu ändern, ohne sie abzureißen
Ein ISP-Netz steht nicht still. Kunden wechseln Tarife, Adressen ändern sich, Türme werden geteilt und Backhauls ersetzt. LibreQoS muss seine Warteschlangenhierarchie ändern, während Verkehr fließt. Frühere Ansätze, die große Teile der Struktur neu aufbauen, können Pakete unterbrechen, Zähler zurücksetzen oder einen Zeitraum erzeugen, in dem Klassifizierung und Warteschlangen nicht übereinstimmen.
Das 2.1-Programm, teilweise unterstützt durch ein NLnet-Projekt, zielt auf transaktionale Verschiebungen und sicherere Reloads. Ziel ist, einen Circuit zu verschieben oder Topologie zu aktualisieren, ohne mehr Zustand als nötig abzureißen. Das ist ein weniger sichtbares Feature als ein Dashboard und eines der klarsten Zeichen, dass das Projekt den Produktivbetrieb ernst nimmt.
Eine sichere Verschiebung hat mehrere Teile. Das neue übergeordnete Element und die Warteschlange müssen existieren. Die Klassifizierung muss beginnen, neue Pakete an das richtige Objekt zu senden. Bestehende wartende Pakete brauchen eine definierte Behandlung. Zähler brauchen Kontinuität oder einen dokumentierten Reset. Schlägt ein Schritt fehl, sollte das System in einen gültigen alten Zustand zurückkehren.
Atomarität ist schwierig, weil die Operation Userspace, Kernel-Queueing und importierte Daten umfasst. Der Kernel kann Primitive bereitstellen, die einzeln geändert werden können. Verkehr fließt zwischen den Aufrufen weiter. Ein Transaktionsmanager kann Operationen ordnen und Fehler erkennen, aber nicht jeden externen Effekt in einem einzigen Moment eintreten lassen.
Das praktische Ziel ist begrenzte Inkonsistenz. Der Betreiber sollte wissen, welche Übergänge sicher sind, wie lange sie dauern und welcher Fallback besteht. Tests sollten unter Last laufen und Ressourcenerschöpfung, doppelte Kennungen und gleichzeitige Updates einschließen. Große Topologien legen Timing- und Speicherprobleme offen, die in einem kleinen Labor fehlen.
Zählerkontinuität hat betrieblichen Wert. Betreiber nutzen Verkehrshistorie für Support und Kapazitätsplanung. Ein Reload, der jede Warteschlange zurücksetzt, kann falsche Einbrüche in einem Graphen erzeugen oder Belege rund um einen Vorfall löschen. Das System sollte Diskontinuitäten markieren, damit Nutzer keine inkompatiblen Intervalle vergleichen.
Das Feature verbessert außerdem das Vertrauen in Automatisierung. Eine CRM-Integration ist nützlicher, wenn eine Standortverschiebung ohne Wartungsfenster angewendet werden kann. Dieser Komfort erhöht die Bedeutung der Validierung, weil schlechte Eingaben Richtlinien nun schneller ändern können.
Externe Förderung ist für die Ökonomie des Projekts relevant. Arbeit an transaktionalem Zustand und Skalierung ist gemeinsame Infrastruktur, die möglicherweise kein sofortiges Premium-Feature hervorbringt. Eine Förderung kann das Engineering finanzieren, während Ergebnisse dem umgebenden Ökosystem verfügbar bleiben. Die erklärten Ziele des Programms sind Belege für die Richtung; veröffentlichtes, getestetes Verhalten ist der Beleg für den Abschluss.
Der Schritt von LibreQoS zu transaktionalen Updates spiegelt einen breiteren Wandel in Netzsoftware wider. Konfiguration wird kontinuierlich statt episodisch. Das Sicherheitsmodell muss sich von „Neustart und Hoffnung“ zu kontrollierter Zustandsänderung bewegen. Für ein Inline-System ist das keine Verfeinerung. Es ist die Bedingung dafür, Automatisierung zu vertrauen.
Mehrknoten-Skalierung tauscht eine Durchsatzgrenze gegen verteilten Zustand
Ein einzelner Server hat endliche CPU-, Speicher- und NIC-Kapazität. Projektmaterialien diskutieren Hochraten-Stufen und den Einsatz auf leistungsfähiger Hardware, aber es lässt sich keine allgemeine Aussage treffen, dass ein Knoten eine bestimmte Rate in jeder Konfiguration bewältigt. Paketgröße, Warteschlangenzahl, Verkehrsverteilung, Telemetrie und Hardware spielen alle eine Rolle.
Die geplante und in Entwicklung befindliche Mehrknoten-API soll LibreQoS über einen Shaper hinaus erweitern. Ein größerer Anbieter kann Knoten an mehreren Aggregationspunkten platzieren oder einen Hochkapazitätspfad aufteilen. Eine zentrale Ebene kann Konfiguration und Sichtbarkeit darüber koordinieren.
Verteilung passt zur Topologie. Shaping näher am tatsächlichen Engpass kann genauer sein, als jedes Paket durch eine zentrale Appliance zu senden. Es kann den Wirkungsradius eines Knotenausfalls verringern. Es schafft aber auch Fragen zu Zustandskonsistenz und Betrieb.
Ein Teilnehmer sollte nicht unbeabsichtigt von zwei Knoten durchgesetzt werden. Eine Routenänderung kann Verkehr zu einem anderen Shaper verschieben, während das Steuerungssystem weiterhin den alten Knoten für maßgeblich hält. Zähler müssen ohne Doppelzählung aggregiert werden. Über Knoten geteilte Kapazität braucht ein Modell oder bleibt unkontrolliert.
Die Steuerungsebene muss Teilausfälle bewältigen. Ein Knoten kann offline sein, während andere weiterlaufen. Konfiguration sollte versioniert sein, damit der Betreiber weiß, welchen Zustand jeder Knoten ausführt. Ein Ausfall der zentralen API sollte die lokale Queueing-Richtlinie nicht entfernen. Die Wiederherstellung sollte abgleichen statt blind zu überschreiben.
Uhr- und Messausrichtung sind für Analysen wichtig. Zwei Knoten können Intervalle unterschiedlich melden. Die Kombination von Latenz und Volumen erfordert Zeitstempel und Identität, die stabil genug sind, um einem Circuit über Verschiebungen hinweg zu folgen. Die Benutzeroberfläche muss zeigen, ob eine plötzliche Änderung Verkehr oder einen Knotenwechsel widerspiegelt.
Verteiltes Shaping ändert auch den Support. Hardware kann je Standort variieren. Ein Knoten kann eine andere NIC oder Kernel-Version verwenden. Ein Leistungsproblem kann lokal statt systemisch sein. Standardisierte Bereitstellungsprofile und Health Checks werden wichtiger, je größer die Flotte wird.
Der strategische Nutzen ist, dass LibreQoS größere regionale Netze bedienen könnte, ohne eine riesige Appliance zu benötigen. Das Risiko ist, dass ein Projekt, das für sein zugängliches Inline-Design geschätzt wird, zu einer komplexen verteilten Plattform wird. Das Engineering-Team muss entscheiden, welche Koordination in den offenen Kern gehört, welche in Insight und welche eine Betreiberarchitektur bleibt.
Mehrknoten-Arbeit sollte durch Fehlertests und veröffentlichte Skalierungshüllkurven bewertet werden. Ein aggregierter Headline-Durchsatz ist weniger nützlich als Belege für Failover, Routenänderungen und konsistente Richtlinien. Die Reife des Projekts wird daran gemessen, ob Betreiber den verteilten Zustand verstehen können; Pakete durch mehrere Server zu schicken genügt nicht.
Das Bypass-Design entscheidet, ob Wartung zum Ausfall wird
Ein Inline-Server braucht irgendwann ein Kernel-Update, einen NIC-Austausch oder ein LibreQoS-Upgrade. Der Wartungsplan kann nicht damit beginnen, den Prozess zu stoppen und herauszufinden, was die Bridge als Nächstes tut. Betreiber brauchen einen definierten Pfad, der die Konnektivität erhält, während der Shaper nicht verfügbar ist.
Ein Hardware-Bypass kann die beiden Netzwerkports verbinden, wenn Strom oder Software ausfällt. Das Netz läuft ohne Warteschlangenmanagement weiter, und der unkontrollierte Engpass kann zurückkehren. Ein geroutetes Failover kann Verkehr über einen anderen Knoten senden und muss Symmetrie- und Kapazitätsannahmen erhalten. Ein Wartungsfenster kann Unterbrechungen akzeptieren und braucht einen Plan für die Kundenwirkung.
Jede Wahl hat Testfälle. Ein Bypass-Relais sollte unter Last und nach Stromausfall geprüft werden. Der Alternativpfad sollte auf Schleifen, Adresslernen und maximale Rate kontrolliert werden. Die Überwachung sollte „gesundes Shaping“ von „Verkehr im Bypass“ unterscheiden, denn beides kann wie Erreichbarkeit aussehen.
Upgrades brauchen ein Rollback-Image und einen Konfigurationsexport. Kernel- und Treiberänderungen können das Warteschlangenverhalten beeinflussen, selbst wenn LibreQoS selbst unverändert bleibt. Ein Anbieter sollte die Produktionstopologie und eine repräsentative Flusszahl testen, nicht nur, ob die neue Version startet.
Das Wartungsverfahren sollte Belege erhalten. Zähler können zurücksetzen, und das Dashboard sollte das Intervall markieren. CRM-Importe können sich ändern, während ein Knoten offline ist; die Wiederherstellung sollte Versionen abgleichen, bevor sie angewendet werden. Ein veralteter Knoten darf keine neuere Topologie überschreiben.
Diese Arbeit lässt sich leicht aufschieben, weil das System zur Verbesserung des Dienstes eingeführt wird und nicht, um eine neue Fehlerdomäne zu werden. Die Inline-Position macht es zu einer. Anbieter, die Bypass und Rollback vor der Bereitstellung nachweisen, verwandeln offene Software in verlässliche Infrastruktur. Wer darauf vertraut, dass der Server nie ausfällt, hat einen einzigen Punkt des Optimismus gebaut.
Offener Kern und bezahlte Analyseebene teilen Kontrolle und Umsatz
Das Geschäftsmodell von LibreQoS ist explizit genug, um zwei einfachen Beschreibungen zu widerstehen. Das Kern-Repository steht unter GPL-2.0 und kann selbst gehostet werden. LibreQoE, LLC bietet kostenpflichtige Local- und Insight-Dienste sowie Support rund um das Projekt an. Ab Version 2.0 erfordert die Aufnahme zugeordneter Circuits oberhalb der ersten 1.000 Circuits eine Insight-Lizenz zu den genannten Bedingungen.
Im August 2026 nannte die Preisseite als Beispiel für 1.000 Teilnehmer 150 US-Dollar pro Monat für Local und 282 US-Dollar pro Monat für Insight. Preise und Paketierung können sich ändern. Die Zahlen zeigen die Form des Modells: ein zugänglicher offener Kern, kostenpflichtige Betriebs- und Datendienste sowie Gebühren, die mit der Teilnehmerbasis des Anbieters skalieren.
Diese Anordnung schafft einen Umsatzpfad für Wartung und Support. Open-Source-Infrastruktur braucht Ingenieure, Testsysteme, Dokumentation und Incident Response. Ein kommerzielles Unternehmen kann diese Arbeit finanzieren und Betreibern einen Ansprechpartner geben. Das Modell ist kein Beleg dafür, dass jeder Projektbeitrag dem Unternehmen gehört oder dass Community-Arbeit unbezahlt ist.
Die Lizenzgrenze verdient Klarheit, weil „frei“ Quellverfügbarkeit, Nullpreis, unbegrenzte Nutzung oder Community-Governance bedeuten kann. Der LibreQoS-Kern ist Open Source. Einige Funktionen und Datendienste haben kommerzielle Bedingungen. Ein Betreiber sollte die aktuellen Lizenz- und Servicebedingungen für seine Größe prüfen, statt anzunehmen, die gesamte Plattform sei kostenlos.
Die Schwelle kann einen Adoptionspfad schaffen. Kleinere Netze können den Kern nutzen und das System lernen. Größere Anbieter tragen Umsatz bei, wenn sie mehr zugeordnete Circuits oder erweiterte Dienste benötigen. Das Risiko ist, dass sich eine künftige Grenze so verschiebt, dass ein Betreiber nach erheblicher Integration abhängig wird.
Die GPL-Lizenz erhält den Zugriff auf den abgedeckten Code und Änderungen zu ihren Bedingungen. Sie garantiert keinen gehosteten Dienst, keine Markenrechte, keinen Support und keinen Zugriff auf proprietäre Analysen. Das Unternehmen kann sich oberhalb des Kerns differenzieren, ohne das Repository zu schließen.
Die kommerzielle Ebene kann auch die Produktdisziplin verbessern. Zahlende Kunden verlangen Upgrades, Dokumentation und berechenbaren Support. Ihre Anforderungen können Funktionen finanzieren, die der breiteren Community nützen. Sie können Prioritäten aber auch zu Vertragskunden verschieben. Transparente Roadmaps und offene Prüfung helfen, die Balance zu halten.
Betreiber sollten erfassen, welche Funktionen bei einer Dienstunterbrechung oder einem Abonnementwechsel verfügbar bleiben. Läuft der lokale Shaper weiter, während zentrale Analysen verschwinden, unterscheidet sich das Betriebsrisiko von einer Plattform, die die Durchsetzung einstellt. Datenexport und Migrationspfade entscheiden, ob Insight ein nützlicher Dienst oder ein neuer Lock-in-Punkt ist.
Der Erfolg des Modells sollte an Nachhaltigkeit und Optionalität gemessen werden. Kann das Unternehmen die Maintainer unterstützen? Können Nutzer den Kern unabhängig betreiben? Können zahlende Kunden ihre Daten abrufen und den Support-Anbieter wechseln? Ein sauberes Label offen-gegen-proprietär beantwortet keine dieser Fragen.
Die Support-Ökonomie entscheidet, ob niedrige Latenz Routine wird
Die Bereitstellung eines Shapers kann eine sichtbare Verbesserung bewirken und dem Anbieter ein neues System zur Wartung hinterlassen. Supportteams müssen die Oberfläche interpretieren, Netzwerktechniker müssen die Topologie besitzen, und das Management muss verstehen, warum eine stark ausgelastete Verbindung Aufmerksamkeit erfordern kann, selbst wenn Kunden Geschwindigkeitstests bestehen.
Der wirtschaftliche Nutzen kann in weniger Beschwerden, schnellerer Diagnose und verschobenen Upgrades liegen. Nichts davon ist automatisch. Ein Anbieter kann die Latenz verbessern und weiterhin Skripte verwenden, die Tarifänderungen unzuverlässig machen. Support-Mitarbeitern fehlt möglicherweise der Zugriff auf die richtigen Belege. Einsparungen müssen gegen Hardware, Abonnement und Personalzeit gerechnet werden.
Die Local- und Insight-Angebote von LibreQoE sind ein Weg, die Bereitstellung zu professionalisieren. Bezahlter Support kann die Kosten des Lernens senken und zentrale Analysen liefern. Der offene Kern gibt dem Betreiber die Möglichkeit, interne Kompetenz aufzubauen oder einen anderen Anbieter zu nutzen. Ob diese Option praktikabel ist, hängt von Dokumentation und der Verfügbarkeit qualifizierter Ingenieure ab.
Ein kleiner WISP mag die aktuellen Beispielpreise neben den Kosten eines Senior-Ingenieurs moderat finden. Ein größeres Netz zahlt mit teilnehmerbasierter Skalierung möglicherweise mehr und profitiert stärker von flottenweiter Sichtbarkeit. Der Preis allein lässt sich nicht mit einer proprietären Appliance vergleichen, solange Supportumfang, Datenaufbewahrung und Ausfallverantwortung nicht einbezogen sind.
Der Support-Desk ist auch eine Quelle der Produktwahrheit. Beschwerden zeigen Topologiefehler, variable Engpässe und Zuordnungen, die Dashboards übersehen. Ein reifer Workflow sollte Support-Mitarbeitern erlauben, einen Fall mit Warteschlangen- und Verkehrshistorie zu verknüpfen, ohne ihnen die Befugnis zu geben, das Netz zu ändern. Feedback sollte das Engineering als strukturierter Beleg erreichen, nicht als Anekdote.
Schulung ist wichtig, weil Bufferbloat kontraintuitiv ist. Ein Mitarbeiter kann sehen, dass ein Kunde die volle Rate erhält, und schlussfolgern, es gebe kein Netzproblem. Das Verständnis von Latenz unter Last verändert das Diagnosegespräch. LibreQoS kann die Belege sichtbar machen; Organisationen müssen vermitteln, was die Graphen bedeuten und wo sie nicht hinreichen.
Der langfristige Erfolg hängt weniger von installierten Servern ab als davon, ob Anbieter die Daten sechs Monate später noch korrekt halten. Integrationen brauchen Verantwortliche, Firmware und Kernel brauchen Upgrades, und Bypass-Pfade brauchen Tests. Kommerzieller Support kann das zur Routine machen. Community-Dokumentation kann den unabhängigen Betrieb glaubwürdig machen.
Das ist die gewöhnliche Ökonomie offener Infrastruktur. Die Software senkt eine Hürde und schafft eine gemeinsame Wartungsbasis. Der Betreiber zahlt weiterhin für Kompetenz. LibreQoS wird wertvoll, wenn diese Kompetenz in den täglichen Betrieb eingebettet ist statt im Ingenieur, der die erste Bereitstellung abgeschlossen hat.
Ein Bufferbloat-Score beginnt eine Untersuchung; er kann die Warteschlange nicht verorten
Öffentliche Latenz-unter-Last-Tests spielten eine wichtige Rolle dabei, Bufferbloat sichtbar zu machen. Ein Nutzer kann sehen, dass die Verzögerung während eines Downloads oder Uploads drastisch steigt. LibreQoE kündigte im März 2026 Bufferbloat Test v2 an und führte damit die Verbindung des Projekts zwischen Messung und betrieblichem Handeln fort.
Der Test kann ein Symptom zeigen: Der Pfad sammelt unter Last Verzögerung an. Er kann nicht jede Warteschlange auf diesem Pfad identifizieren. Der Engpass kann im Heimrouter, im WLAN, im Zugangsnetz, im Transit oder im Server liegen. Testverkehr kann eine Route und ein Protokoll nutzen. Browser- und Gerätelimits können das Ergebnis beeinflussen.
Für einen ISP wird der Test nützlicher, wenn er mit internen Belegen kombiniert wird. LibreQoS kann zeigen, ob die Teilnehmer- oder übergeordnete Warteschlange aktiv war, welche Verkehrsvolumen vorhanden waren und ob der konfigurierte Engpass erreicht wurde. Ein Support-Mitarbeiter kann eine Zugangsnetzwarteschlange wirksamer von einem lokalen Funkproblem unterscheiden als allein anhand des öffentlichen Scores.
Der Test kann auch falsche Anreize schaffen, wenn er als Ranking behandelt wird. Anbieter können für den Testpfad optimieren, ohne das breitere Erlebnis zu verbessern. Nutzer können ein einzelnes Ergebnis als Beweis für Nachlässigkeit des Providers deuten. Verantwortungsvolle Darstellung sollte Variabilität erklären und wiederholte Messungen anregen.
Synthetische Tests sind wertvoll, weil sie kontrolliert sind. Reale Anwendungen sind wertvoll, weil sie die Nutzung widerspiegeln. Ein reifes Qualitätsprogramm kombiniert beides. Sprache und Spiele reagieren anders auf Latenz als Massentransfers. Cloud-Anwendungen können viele Verbindungen öffnen. Kapazitätsplanung verwendet längere Intervalle als ein interaktiver Test.
Die Verbindung von LibreQoS zur Bufferbloat-Community gibt dem Projekt ein starkes Erklärungsfundament. Es rahmt Latenz als Warteschlangenmanagement-Problem, das oft durch Engineering statt durch vage Beschwerden behoben werden kann. Der Verlust von Dave Täht entfernte einen prominenten Fürsprecher und Beitragenden; die fortgesetzten Veröffentlichungen zeigen, dass das Projekt nicht allein von einer Person abhängt.
Die Messgeschichte sollte von Produktbehauptungen getrennt bleiben. Ein gutes Testergebnis nach der Bereitstellung von LibreQoS stützt diese Konfiguration und diesen Pfad. Es beweist nicht, dass jeder Kunde gleichermaßen profitiert. Ein schlechtes Ergebnis kann ein Problem außerhalb der Kontrolle des Shapers offenbaren.
Der Wert des Tests besteht darin, eine strukturierte Untersuchung zu beginnen. Die Gefahr ist, beim Score stehen zu bleiben. LibreQoS ist am glaubwürdigsten, wenn es das öffentliche Symptom mit Warteschlangen-, Topologie- und Kapazitätsbelegen verbindet und zugleich die Unsicherheit zwischen ihnen bewahrt.
Konkurrierende Systeme bepreisen Support, Kontrolle und Nachweis unterschiedlich
LibreQoS konkurriert mit mehreren Kategorien statt einem Produkt. Kommerzielle Quality-of-Experience-Plattformen wie Preseem zielen mit verwalteten Analysen und Traffic-Management auf WISPs. Größere Observability-Produkte von Anbietern wie Kentik oder Nokia Deepfield konzentrieren sich auf netzweite Verkehrsinformationen. Policy-Appliances von Sandvine oder Allot bieten tiefere kommerzielle Kontrolle. MikroTik und andere Router-Plattformen bieten eingebautes Queueing. Betreiber können auch direkt Linux-tc-Skripte bauen.
Eine verwaltete Plattform reduziert Integrationsarbeit und bietet einen klaren Supportvertrag. Sie kann ausgereiftes Benchmarking und Flottenanalysen bieten. Der Betreiber akzeptiert Abonnementkosten, Datenübertragung und Abhängigkeit von der Roadmap des Anbieters.
Eine große Policy-Appliance kann Klassifizierung, Durchsetzung und kommerzielle Funktionen in hoher Skalierung kombinieren. Sie kann für einen kleinen ISP teuer und undurchsichtig sein. Tiefe Anwendungsklassifizierung wirft zudem Datenschutz- und Verschlüsselungsherausforderungen auf.
Router-eigenes Queueing vermeidet einen zusätzlichen Inline-Server. Es kann durch Hardware, Herstellerschnittstellen und die Fähigkeit zur Topologieabbildung eingeschränkt sein. Ein handgebautes Linux-System bietet maximale Kontrolle und minimalen Produkt-Overhead, legt aber die gesamte Wartung auf den Betreiber.
Das Unterscheidungsmerkmal von LibreQoS ist die Kombination aus offenem Code, topologiebewusstem CAKE-Shaping und einer betreiberseitigen Plattform. Die kostenpflichtige Insight-Ebene verringert den Abstand zu verwalteten Produkten, ohne die Self-Hosted-Option zu entfernen. Das System ist am attraktivsten für Anbieter, die modernes Queueing schätzen und bereit sind, Linux-Infrastruktur zu betreiben.
Preisvergleiche müssen Personal und Ausfallrisiko einbeziehen. Ein niedriges Abonnement kann billiger sein als die Zeit eines Ingenieurs. Ein offenes System kann über mehrere Jahre billiger sein, wenn es Appliance-Lizenzen und Herstellerbindung vermeidet. Die Antwort hängt von Flottengröße, Kompetenz und Supportbedarf ab.
Die Wahl hängt auch von Anforderungen an Belege ab. Ein Anbieter mag inspizierbare qdiscs und offene Zähler bevorzugen. Ein anderer braucht eine herstellerzertifizierte Appliance mit einem verantwortlichen Lieferanten. Offenheit ist ein Kontrollvorteil, keine universelle Beschaffungsregel.
LibreQoS muss nicht jede Alternative ersetzen, um Bedeutung zu haben. Es kann die Erwartung erhöhen, dass Latenz unter Last gemanagt wird, dass Topologie das Shaping informiert und dass Betreiber die Richtlinie prüfen können, die Teilnehmer steuert. Wettbewerbsdruck kann diese Praktiken verbreiten, selbst wo ein anderes Produkt gewählt wird.
Queueing-Belege informieren die Tarifgestaltung, können Fairness aber nicht definieren
LibreQoS liefert einem Anbieter Daten darüber, wann Teilnehmer und gemeinsame übergeordnete Elemente ausgelastet sind. Diese Belege können eine Tarifstufe zeigen, die regelmäßig ihr Limit erreicht, oder einen Backhaul, dessen Kunden während Abendspitzen konkurrieren. Das Engineering-System entscheidet nicht, wie der Anbieter diese Beobachtungen in Produkte übersetzen sollte.
Ein Anbieter kann Kapazität erhöhen, die Überbuchung ändern, Tarifstufen neu gestalten oder eine realistische Servicebandbreite kommunizieren. Er kann Shaping auch nutzen, um einen eng formulierten Tarif durchzusetzen, während das geteilte Netz chronisch gesättigt bleibt. Beide Entscheidungen können technisch mit der konfigurierten Richtlinie übereinstimmen und sehr unterschiedliche Kundenergebnisse erzeugen.
Fairness hat mehrere Bedeutungen. CAKE kann Flüsse isolieren, sodass ein Transfer nicht dominiert. Teilnehmertarife können je nach Preis unterschiedliche Raten zuweisen. Eine übergeordnete Warteschlange kann knappe Kapazität unter Circuits aufteilen. Regulierer und Kunden können Transparenz, Mindestleistung oder Gleichbehandlung über die Scheduling-Definition des Algorithmus hinaus wichtig finden.
Die Daten sollten daher kaufmännisches und öffentliches Urteil unterstützen, nicht ersetzen. Das Management muss sehen, wie oft Warteschlangen den Dienst einschränken, welche Gruppen betroffen sind und ob beworbene Tarife unter gewöhnlicher Last erreichbar sind. Supportteams brauchen Sprache, die Überlastung erklärt, ohne einzelne Nutzer dafür verantwortlich zu machen, dass sie den gekauften Dienst nutzen.
Eine offene Plattform kann diese Entscheidungen prüfbarer machen, weil Warteschlangenhierarchie und Raten inspizierbar sind. Der Betreiber kontrolliert sie dennoch. LibreQoS ist ein Mechanismus, Knappheit mit weniger vermeidbarer Verzögerung zu verteilen; die Legitimität dieser Verteilung hängt von Richtlinien außerhalb des Codes ab.
Der gefährlichste Fehler ist ein falsches Modell, das perfekt durchgesetzt wird
LibreQoS bringt Präzision ins Queueing. Es kann Verkehr klassifizieren, Hierarchien erstellen und sorgfältig entworfene Algorithmen anwenden. Die Präzision der Ausführung garantiert nicht die Richtigkeit der Richtlinie. Eine ungenaue Topologie oder ein falscher Kapazitätswert kann mit gleicher Effizienz durchgesetzt werden.
Das ist eine allgemeine Gefahr der Infrastrukturautomatisierung. Manuelle Systeme scheitern sichtbar und inkonsistent. Automatisierte Systeme können eine falsche Annahme über tausende Circuits verbreiten. Die Antwort ist nicht, Automatisierung zu vermeiden, sondern Verifikation um das Modell zu bauen.
Betreiber sollten importierte Teilnehmerzahlen mit aktivem Verkehr vergleichen, auf doppelte Adressen prüfen und bei unklassifiziertem Volumen warnen. Kapazitätsänderungen sollten mit Router- und Funkdaten abgeglichen werden. Übergeordnete Warteschlangen sollten unter kontrollierter Last getestet werden. Ein Konfigurations-Diff sollte geprüft werden, bevor er Kernel-Zustand wird.
Die Plattform braucht außerdem klare Standards. Unbekannter Verkehr muss irgendwohin. Ist er uneingeschränkt, können Kunden über eine nicht zugeordnete Adresse die Richtlinie umgehen. Ist er stark begrenzt, kann legitimer Dienst nach einem Importfehler ausfallen. Die Wahl sollte explizit und überwacht sein.
Der Inline-Betrieb vergrößert Sicherheitsfragen. Der Server empfängt den gesamten Verkehr und kann Verwaltungsschnittstellen offenlegen. Updates für Kernel, NIC-Treiber und Anwendung müssen qualifiziert werden. Ein Angreifer mit Administrationskontrolle kann den Dienst vieler Kunden verändern. Netzsegmentierung und eingeschränkter Zugriff sind unerlässlich.
Datenschutz ist eine weitere Einschränkung. Verkehrsvolumen und -ziele können Verhalten auch ohne Payload-Prüfung offenbaren. Insight und lokale Telemetrie brauchen Aufbewahrungs- und Zugriffsrichtlinien. Der offene Code des Projekts macht Datenflüsse besser prüfbar; jede Bereitstellung entscheidet, was gesammelt wird.
Das Geschäftsmodell wirft Kontinuitätsfragen auf. Betreiber sollten wissen, welche Funktionen von einer aktiven Lizenz oder einem Cloud-Dienst abhängen und wie Daten exportiert werden können. Die aktuellen Preise und Schwellen von LibreQoE sind transparent genug zur Bewertung, aber künftige Bedingungen können sich ändern. Lock-in-Vermeidung erfordert periodische Tests des unabhängigen lokalen Pfads.
Die Nachhaltigkeit der Beitragenden bleibt eine offene Frage. Das Projekt hat ein aktives Unternehmen, Community und Förderunterstützung, aber kein geprüftes projektbezogenes Budget und keine vollständige Arbeitszählung. Der Verlust eines wichtigen Beitragenden zeigt, warum Dokumentation und geteilte Maintainer-Verantwortung wichtig sind.
Die Einschränkungen von LibreQoS sind keine Gründe, die Plattform abzulehnen. Sie definieren die Arbeit, die für einen verantwortungsvollen Einsatz nötig ist. Das Projekt bietet einen starken Mechanismus für ein Problem, das viele Anbieter ignoriert haben. Sein Erfolg hängt davon ab, Daten, Hardware und Organisation rund um diesen Mechanismus mit gleicher Sorgfalt zu betreiben.
LibreQoS wird zu einer offenen Quality-Control-Ebene für Zugangsnetze
Bis August 2026 war LibreQoS 2.1 nach dem 2.0-Übergang im März die aktuelle Hauptversion. Das Projekt hatte einen gepflegten GPL-Kern, einen kommerziellen Verwalter, Integrationen, eine lokale Betriebsoberfläche und aktive Arbeit an sichereren Zustandsänderungen und Mehrknoten-Skalierung. LibreQoE meldete mehr als 950 Netzwerke, die die Plattform nutzen – eine anbieterbezogene Adoptionszahl und keine unabhängig geprüfte Zählung.
Diese Fakten stützen die Beschreibung einer reifenden Infrastrukturplattform. Sie stützen nicht die Behauptung, jeder Standard-Server bewältige jeden Durchsatz, CAKE behebe jede Kundenbeschwerde oder jedes gemeldete Netzwerk sei eine aktive Produktionsbereitstellung.
Der klarste Beitrag von LibreQoS ist, Latenz unter Last neben Bandbreite als Betriebsgröße zu behandeln. Es verbindet Queueing-Richtlinien mit der Topologie und den Teilnehmerdatensätzen des ISPs und gibt kleineren Anbietern eine Alternative zu proprietären Appliances. Die Versionen von 2026 erweiterten die Steuerungsebene rund um den Shaper durch Dashboards, Karten, Importe und sicherere Workflows.
Diese breitere Steuerungsebene vergrößert auch die Wartungslast. Geschäftsdaten können nun die Paketbehandlung ändern. Ein Software-Upgrade kann einen Inline-Pfad betreffen. Bezahlte Analysen können eine neue Abhängigkeit schaffen, selbst während der lokale Kern offen bleibt. Der Wert der Architektur hängt von klaren Grenzen zwischen Shaper, Datenquellen und kommerziellem Dienst ab.
Der nächste Nachweis ist ein Betriebsprotokoll statt einer weiteren Installationszahl. Ein Anbieter sollte Hardware, Verkehrsmix, Topologieänderungen, Bypass-Verhalten, gemessene Latenz und Kapazitätsentscheidungen über einen längeren Zeitraum offenlegen können. Mehrknoten-Bereitstellungen müssen zeigen, dass Richtlinienhoheit und Zähler bei Umleitung und Teilausfall verständlich bleiben.
LibreQoS kann keine Bandbreite herstellen. Es kann eine vermeidbare Warteschlange davon abhalten, vorhandene Bandbreite schlechter wirken zu lassen, und offenlegen, wo physische Investitionen weiterhin nötig sind. Das System wird zu dauerhafter Infrastruktur, wenn ein Anbieter die Latenz verbessern, einen Inline-Ausfall überstehen und dieselben Belege für den nächsten Kapazitätsausbau nutzen kann.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten