
Zusammenfassung
- Rapport nimmt nun durch Leerzeichen getrennte Kategorien und Testnamen entgegen und bildet daraus alle Paare. Fehlt das Verzeichnis eines Paars, kehrt die Funktion vor der Ausführung zurück; das Paar erscheint in keinem der vier Zähler.
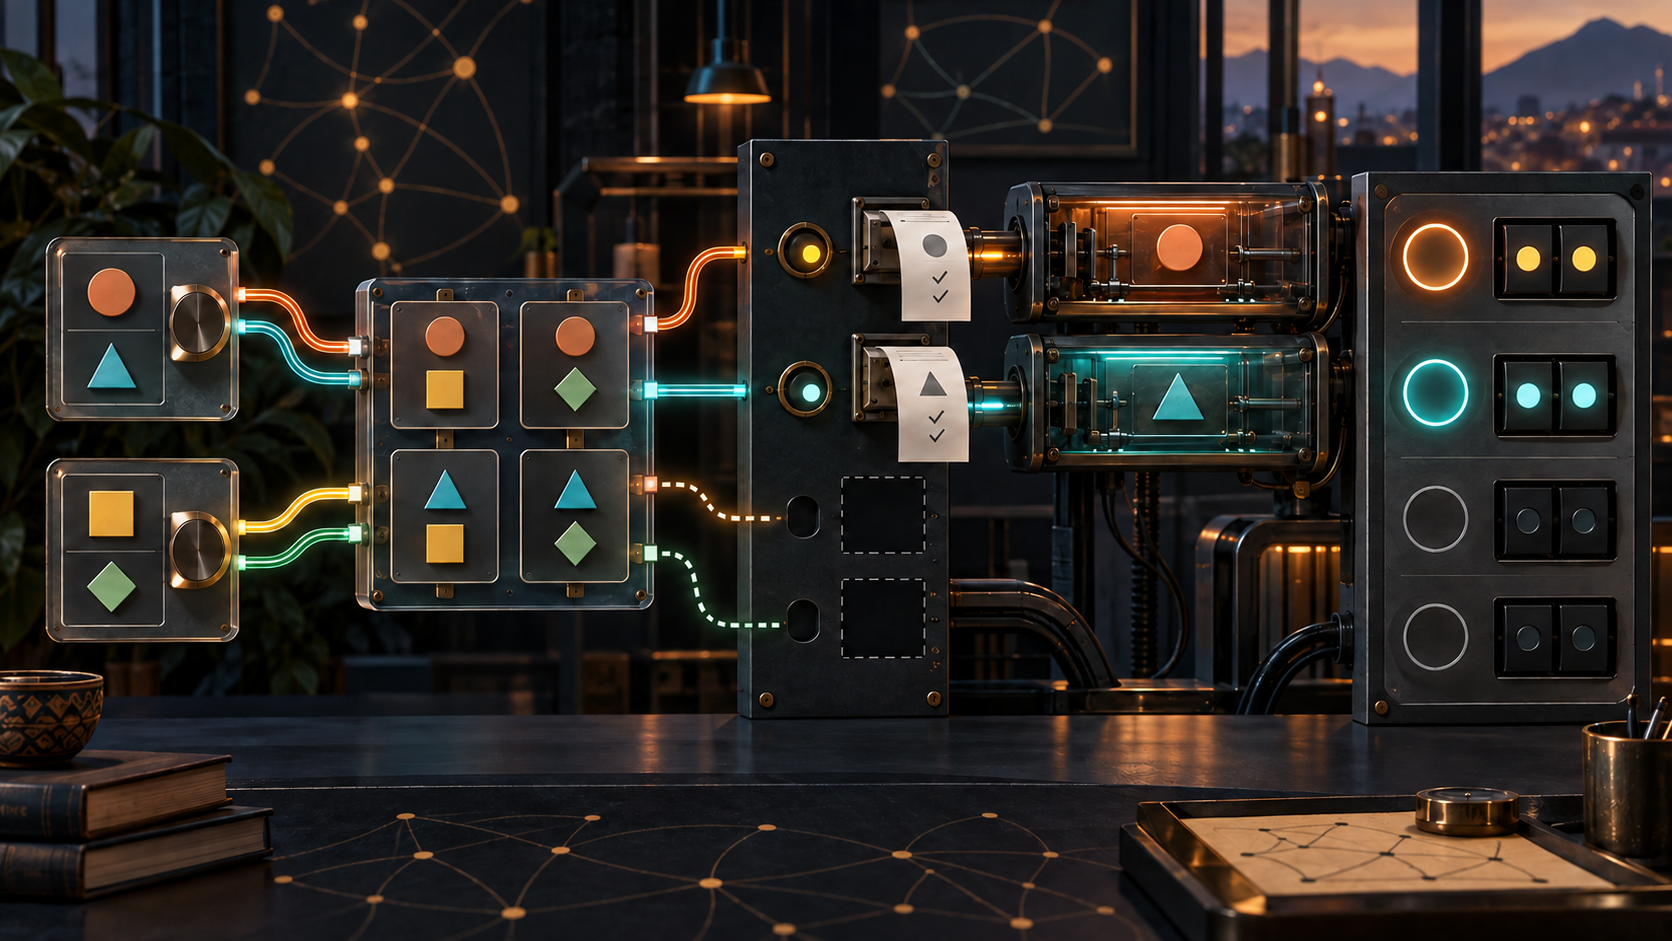
- Ein statisches Beispiel aus dem fixierten Repository-Baum ergibt vier angeforderte Zellen, zwei vorhandene Pfade und zwei fehlende. Die Summen können für das Ausgeführte stimmen, ohne den angeforderten Umfang offenzulegen.
Vier Zellen werden angefordert. Zwei werden im Ergebnis sichtbar. Für die übrigen beiden gibt es keine Zeile.
Diese Lücke folgt aus dem Rapport-Commit vom 7. September mit dem Titel „Allow running multiple specific categories and tests“. Der Commit ändert ausschließlich 2-test.sh, erweitert aber die Beweisfläche des Werkzeugs: Zwei Selektorlisten werden zur Matrix; anschließend entscheidet die Existenz eines Verzeichnisses, ob eine angeforderte Zelle überhaupt eine berichtete Identität erhält.
Der auf diesen Commit fixierte Runner liest Argument eins als durch Leerzeichen getrennte Kategorien und Argument zwei als entsprechend getrennte Testnamen. Eine äußere Schleife durchläuft die Kategorien, eine innere wendet dieselbe Testliste auf jede Kategorie an. Für jedes Paar entsteht tests/<category>/<test>, das an run_test geht.
run_test prüft zuerst, ob der Pfad ein Verzeichnis ist. Wenn nicht, kehrt die Funktion sofort mit Status null zurück. Das geschieht vor der Zuweisung von TESTID, vor der Ausgabe Test:, vor dem Aufruf des szenariospezifischen run.sh und vor jeder Erhöhung von Success, Failure, Skipped oder Unknown.
Ein fehlender Pfad ist folglich kein Erfolg. Er ist auch kein übersprungener Test. Er gehört gar nicht zum Ergebnisuniversum.
Eine Matrix mit unsichtbar verkleinertem Nenner
Der unveränderliche Baum derselben Revision enthält 21 Kategorieverzeichnisse und 337 Pfade nach dem Muster tests/<category>/<test>/run.sh. Vorhanden sind sample/100-simple und sample/500-multi-step; nicht vorhanden sind rfc9286/100-simple und rfc9286/500-multi-step.
Wer die Kategorien sample rfc9286 mit den Tests 100-simple 500-multi-step kombiniert, veranlasst den Quelltext, vier Paare zu bilden. Die beiden sample-Pfade können ausgeführt werden. Die beiden rfc9286-Pfade enden an der Verzeichnisprüfung. Nur ausgeführte Szenarien können einen der vier Zähler verändern.
Das ist eine statische Ableitung aus öffentlichem Quelltext und Repository-Baum, kein für diesen Artikel ausgeführter Rapport-Lauf. Es gibt weder ein CI-Protokoll noch einen Betreiberbericht oder einen Nachweis von Produktionsfolgen. Die Quellen behaupten auch nicht, alle Kategorien müssten dasselbe Vokabular an Testnamen besitzen. Eine fehlende Zelle kann völlig legitim sein. Die Informationslücke besteht darin, dass eine ausdrücklich angeforderte Zelle keine sichtbare Disposition erhält.
Diese Abgrenzung schützt zugleich die Aussagekraft der Summen. Wenn beide vorhandenen Szenarien erfolgreich enden, beschreibt „zwei Erfolge“ die ausgeführten run.sh-Dateien korrekt. Als Rechnung über vier angeforderte Zellen bleibt die Angabe unvollständig. Die beiden fehlenden Pfade pauschal als Fehler zu zählen, wäre ebenfalls unbelegt. Auswahlabsicht, Expansion, Existenz, Ausführung und Ergebnis brauchen getrennte Felder.
Mehr Auswahl ohne korrespondierenden Beleg
Der übergeordnete Runner unterstützte engere Formen: alle Kategorien, alle Tests einer Kategorie oder ein exaktes Kategorie-Test-Paar. Der neue Commit ersetzt diese Zweige durch verschachtelte Schleifen. Seine Nachricht zeigt mehrere Kategorien und mehrere Tests getrennt voneinander, dokumentiert jedoch weder ihre kombinierte Verwendung noch die Bedeutung einer nicht vorhandenen Zelle.
Daraus lässt sich keine Absicht des Autors und kein Wissen über die Lücken ableiten. Feststellbar ist lediglich die Trennung zweier Abschlussbegriffe. Für die Shell-Funktion endet ein fehlender Pfad erfolgreich. Für den Testbericht hat dieses Paar nie eine Testkennung erhalten. Ein Inventar, das beide Mengen abgleicht, fehlt.
Die fixierte README beschreibt Rapport als frühen, aus Shell-Skripten bestehenden Tester für RPKI relying parties, wobei ein Lauf jeweils eine Implementierung adressiert. Der Runner erkennt fort-Familien, Routinator, rpki-client und rpki-prover. Seine Hinweise warnen sowohl vor möglichen Fehlern der Testsuite als auch vor abweichenden Ergebnissen anderer relying parties. Gerade deshalb muss eine Vergleichsaussage erkennen lassen, welche Szenarien einbezogen wurden.
LACNIC führt Rapport im Kontext seiner Open-Source-Projekte; das öffentliche Repository macht den Mechanismus prüfbar. Keine Quelle bezeichnet Rapport als Zertifizierung, Beschaffungshürde oder Produktionsvalidator. Hier geht es um die Auswahlprovenienz eines öffentlichen Testwerkzeugs.
Der Auswahlbeleg vor dem Ergebnis
Rapport könnte seine vier Ergebnisarten unverändert lassen und davor einen Beleg erzeugen. Dieser würde Rohargumente, normalisierte Kategorie- und Testtokens sowie jedes expandierte Paar festhalten. Pro Zelle genügten Angaben wie exists und die Disposition execute oder absent-path; nach der Ausführung kämen TESTID und das vorhandene Ergebnis hinzu.
Der Beleg müsste eine Abwesenheit nicht verurteilen. Er würde eine bewusst dünn besetzte Matrix von Tippfehlern, veralteten Namen und nicht anwendbaren Tests unterscheiden. Automatisierung könnte angeforderte, vorhandene, ausgeführte und berichtete Mengen vergleichen, ohne den Nenner aus Schweigen herzuleiten.
Die vier Zähler beantworten: „Was gab das Szenario zurück?“ Der fehlende Beleg beantwortet die frühere Frage: „Was geschah mit jeder angeforderten Zelle?“
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten