
Zusammenfassung
- IBM führte die Störung auf falsche Wegeinformationen eines nicht genannten externen Netzbetreibers zurück. Der öffentlich beschriebene Mechanismus lässt sich mit dem Border Gateway Protocol (BGP) erklären, dem Verfahren, mit dem Netze einander mitteilen, welche Zielbereiche erreichbar sind.
Eine Routenankündigung (englisch route advertisement) übermittelt dabei ein Netzpräfix, also einen Block zusammengehöriger IP-Adressen. Falsche Angaben können die Erreichbarkeit — die Möglichkeit, ein Ziel über das Netz tatsächlich zu erreichen — beeinträchtigen und eine schwere Überlastung (congestion) auslösen, wenn Daten in ungeeignete Wege gelenkt werden.
- Zeitgenössische Berichte zeigten eine breite Störung von IBM-Cloud-Netzfunktionen. Zello dokumentierte Anmelde- und Wiederverbindungsfehler, unterbrochene Kommunikation, nicht erreichbare Administrationsoberflächen und ausgehenden Datenverkehr über IPv4 (Internet Protocol Version 4, das weit verbreitete Adressierungsverfahren des Internets), der nach Zellos Darstellung zu falschen Zielen geschickt wurde. Diese Beobachtungen belegen konkrete Auswirkungen, aber weder einen vollständigen Kundenschaden noch eine einheitliche weltweite Ausfalldauer.
- Die entscheidende Frage liegt an der Anbietergrenze (provider boundary), dem technischen Übergabepunkt zwischen zwei Netzen. IBM konnte die Annahme fremder Wegeinformationen, eigene Schutzregeln, Alarme, Wiederherstellung und Kundenbelege steuern; der externe Anbieter war für seine ausgehende Prüfung und Korrektur zuständig. Die Managementebene (management plane) — getrennte Werkzeuge und Wege zum Überwachen, Entscheiden und Kommunizieren — muss auch dann erreichbar bleiben, wenn der normale Kundendatenverkehr gestört ist. Welche Pflichten der private Vertrag genau verteilte, ist nicht öffentlich bekannt.
Was am 9. Juni 2020 sichtbar wurde
TechCrunch beobachtete am 9. Juni 2020 ab etwa 14:30 Uhr pazifischer Zeit eine weitreichende Netzwerkstörung bei IBM Cloud. Gehostete Dienste waren betroffen, und selbst die zentrale IBM-Statusseite gab zeitweise einen internen Serverfehler zurück. Das ist für die Einordnung wichtig: Nicht nur einzelne Anwendungen wirkten gestört; auch ein Kanal, auf den Kunden zur Lageeinschätzung angewiesen waren, war nicht zuverlässig verfügbar.
IBM erklärte später in einer erhaltenen Mitteilung, ein externer Netzbetreiber habe IBM Cloud mit falschen Wegeinformationen überflutet. Dadurch sei es zu starker Netzüberlastung gekommen, die Cloud-Dienste und Rechenzentren beeinträchtigt habe. Diese Ursache ist eine IBM zugeschriebene Aussage. Öffentlich zugängliche Routerprotokolle oder interne Konfigurationsdaten, mit denen Außenstehende sie vollständig nachprüfen könnten, liegen in den herangezogenen Quellen nicht vor.
IBM meldete außerdem, die Dienste seien wiederhergestellt und Gegenmaßnahmen ergriffen worden. Die eigene Ursachenanalyse habe nach Angaben des Unternehmens keine Hinweise auf Datenverlust oder Probleme der Cybersicherheit ergeben. Diese negative Feststellung ist nützlich, bleibt aber begrenzt: Sie ist keine unabhängige Prüfung jedes Kundenkontos, jeder Transaktion oder jedes betroffenen Systems.
CRN berichtete über den Verlust des Zugangs zu Cloud-Umgebungen, Bedienkonsolen und Statusanzeigen. Der Bericht hielt auch fest, dass IBMs Netzwerkbetrieb während der Wiederherstellung seine Routing-Richtlinien anpasste — also Regeln, nach denen ein Netz eingehende und ausgehende Wegeinformationen annimmt, bevorzugt oder verwirft. Das stützt die Aussage, dass die Wiederherstellung aktiv über Netzregeln gesteuert wurde; es verrät jedoch nicht, welche einzelne Regel geändert wurde oder wie die frühere Einstellung aussah.
Zello macht die Kundenauswirkung greifbar
Zellos eigener Störungsbericht liefert eine konkretere Sicht auf die Folgen. Das Unternehmen verzeichnete verbreitete Fehler bei Anmeldung und Wiederverbindung. Bereits verbundene Nutzer verloren Kommunikation, Administrationskonsolen waren nicht erreichbar, und vier von Zello benannte Dienste waren betroffen. Damit wird aus einer allgemeinen Cloud-Meldung ein nachvollziehbares Betriebsproblem: Menschen konnten einen Kommunikationsdienst nicht zuverlässig beginnen, fortsetzen oder verwalten.
Zello beschrieb außerdem eine große Zahl eingespeister Routen. Dadurch hätten Server in IBM Cloud ausgehende IPv4-Daten an falsche Ziele gesendet. Diese Beobachtung passt zu einem Fehler bei der Wegeauswahl, darf aber nicht überdehnt werden. Sie nennt weder das verantwortliche autonome System noch konkrete Netzpräfixe, Pfade, Sitzungen oder technische Kennzeichnungen der übermittelten Routen.
Die vier betroffenen Zello-Dienste sind ein wichtiger Fallbeleg, aber kein Gesamtmaß für den IBM-Ausfall. Die verfügbaren Quellen nennen keinen vollständigen Nenner für Kunden, Regionen, Transaktionen oder finanzielle Verluste. Ebenso lässt sich aus den öffentlich berichteten Zeitpunkten keine einzige, weltweit gültige Wiederherstellungsminute ableiten. Verschiedene Dienste und Abhängigkeiten können in unterschiedlichen Schritten zurückkehren.
Wie falsche Wegeinformationen einen Cloud-Dienst treffen können
BGP verbindet nicht einzelne Endgeräte, sondern hilft großen Netzen bei der Auswahl von Wegen zu anderen Netzen. Ein Betreiber teilt Nachbarn mit, welche Netzpräfixe über ihn erreichbar sein sollen. Der Empfänger bewertet diese Meldungen mit eigenen Regeln und wählt daraus Wege für den Datenverkehr. Die bloße Existenz einer Ankündigung zwingt ein Netz daher nicht automatisch zu ihrer Annahme; die Regeln des empfangenden Netzes bleiben ein eigener Kontrollpunkt.
Werden sehr viele unerwartete oder falsche Routen angenommen, kann das mehrere Wirkungen haben. Daten können zu einem Weg geschickt werden, der das Ziel nicht korrekt erreicht. Geräte können mehr Zustandsinformationen verarbeiten müssen. Verkehr kann sich auf ungeeigneten Verbindungen sammeln und dort Engpässe erzeugen. In einem Cloud-Angebot können diese Effekte nicht nur Kundenanwendungen, sondern auch Bedienoberflächen, Überwachung und Statuskommunikation treffen, wenn sie zu eng an dieselbe Netzerreichbarkeit gekoppelt sind.
Routenkonvergenz (route convergence) bezeichnet die Zeit, in der beteiligte Netze nach einer Änderung zu einer stabilen gemeinsamen Wegeauswahl finden. Eine fehlerhafte Route kann zurückgezogen oder durch neue Regeln abgelehnt werden, doch diese Änderung muss sich durch die betroffenen Nachbarschaften fortpflanzen. Darum ist eine Wiederherstellung oft gestuft: Ein Teil der Systeme ist schon wieder erreichbar, während andere Wege, Zwischenspeicher oder abhängige Dienste noch aufholen.
Die öffentlich bekannten Angaben beweisen nicht, ob IBM im Jahr 2020 eine bestimmte Grenze falsch gesetzt, eine Warnung übersehen oder eine Schutzfunktion nicht eingesetzt hat.
Ein Maximum-Prefix-Limit (maximum-prefix limit) ist eine anbieterbezogene Obergrenze für die Zahl der akzeptierten Netzpräfixe; bei Überschreitung kann ein System warnen oder die Verbindung begrenzen. RFC 7454 empfiehlt solche peer-spezifischen Grenzen sowie Filter für eingehende und ausgehende Präfixe. Der Standard beschreibt gute Vorsorge, nicht die damalige Konfiguration von IBM oder des externen Anbieters und auch keine Garantie, dass genau diese Störung damit verhindert worden wäre.
Zwei Betreiber, getrennte Pflichten
Ein Fehler an einer Anbietergrenze ist kein Grund, Verantwortung in einem einzigen Satz dem jeweils anderen Unternehmen zuzuschieben. Der externe Anbieter kontrolliert, welche Routen er erzeugt oder weitergibt, wie er ausgehende Informationen prüft und wie schnell er falsche Angaben zurückzieht. IBM kontrolliert seinerseits, welche Ankündigungen das eigene Netz akzeptiert, welche Grenzen und Filter gelten, welche Alarme ausgelöst werden und wie der Betrieb bei einem Fehler reagiert.
Kontrollverantwortung (control ownership) bedeutet in diesem Zusammenhang, für jede Schutzmaßnahme festzuhalten, wer sie technisch ändern kann, wer Warnungen erhält, wer im Störungsfall entscheiden darf und wer die Wirkung belegen muss. Diese Zuordnung sollte nicht bei einer abstrakten Aussage wie „der Anbieter ist zuständig“ enden. Ein prüfbarer Plan benennt den konkreten Betreiber, die konkrete Maßnahme, den Eskalationsweg und den erwarteten Nachweis.
Bei IBM liegt außerdem die Verantwortung für die Widerstandsfähigkeit des eigenen Dienstes. Dazu gehören eine sinnvolle Begrenzung des Auswirkungsradius (blast radius), also des Anteils von Kunden und Funktionen, den ein einzelner Fehler erreichen kann, sowie unabhängige Wege für Administration und Kommunikation. Ein Fehler in einem externen Netz muss nicht zwangsläufig Statusseite, Kundenkonsole und regulären Datenverkehr zugleich unbrauchbar machen. Ob und wie diese Funktionen 2020 technisch voneinander getrennt waren, ist allerdings nicht öffentlich dokumentiert.
Auch der Vertrag zwischen IBM und dem nicht genannten Anbieter bleibt unbekannt. Deshalb lässt sich aus den Quellen nicht ableiten, welches Unternehmen eine bestimmte Filterpflicht vertraglich übernommen hatte, welche Fristen galten oder welche Folgen vereinbart waren. Die technische Aufgabenverteilung lässt sich analysieren; eine rechtliche Schuldzuweisung lässt sich daraus ohne Vertrags- und Beweisdaten nicht seriös ableiten.
Welche Belege ein belastbares Störungsbild braucht
Telemetrie — damit sind laufend erhobene Mess- und Betriebsdaten gemeint — sollte den Weg von der ersten ungewöhnlichen Routenänderung bis zur vollständigen Wiederherstellung nachvollziehbar machen. Dazu gehören Zeitpunkte, Anzahl und Art abgelehnter oder angenommener Routen, betroffene Verbindungen, ausgelöste Alarme, getroffene Entscheidungen und die Entwicklung der Kundenerreichbarkeit. Solche Daten helfen, Behauptungen über Ursache und Wirkung zu prüfen, ohne interne Details unnötig öffentlich zu machen.
Ein guter Nachweis trennt mindestens vier Ebenen. Erstens: Was wurde von außen beobachtet? Zweitens: Welche Ursache nennt ein beteiligtes Unternehmen? Drittens: Welche technische Schlussfolgerung ist daraus plausibel? Viertens: Was bleibt mangels Daten unbekannt? Im IBM-Fall sind die sichtbare Störung und Zellos Kundenerfahrungen beobachtbar; die Flut falscher Wegeinformationen ist IBMs zugeschriebene Erklärung; die genaue interne Konfiguration bleibt unbekannt.
Ebenso wichtig ist ein außerhalb des betroffenen Netzes geführter Zugang mit eigener Statuskommunikation (out-of-band access and status communication). Gemeint ist ein administrativer und öffentlicher Kommunikationsweg, der nicht von genau den Verbindungen und Systemen abhängt, deren Ausfall er melden und beheben soll. Eine Statusseite, ein gesicherter Verwaltungszugang und ein Kundenkanal können dafür getrennte Abhängigkeiten benötigen.
Diese Trennung ist nicht nur eine Frage technischer Eleganz. Wenn Kunden weder den Dienst noch die Konsole noch die Statusseite erreichen, fehlt ihnen die Grundlage für eigene Notfallentscheidungen. Ein unabhängiger Kommunikationsweg verkürzt nicht automatisch die technische Reparatur, verbessert aber die Fähigkeit, Auswirkungen zu begrenzen, Alternativen zu wählen und die Lage später zu prüfen.
Was die Quellen nicht belegen
Der Name des externen Netzbetreibers ist in den zugrunde liegenden öffentlichen Belegen nicht verlässlich genannt. Es gibt keine belastbaren Angaben zum Ursprungssystem, zu einzelnen Präfixen, Pfaden, Sitzungen, internen Kennzeichnungen oder zum privaten Regelcode. Spekulationen darüber würden die Beleglage durch Vermutungen ersetzen.
Auch ein absichtlicher Angriff ist nicht belegt. Ein Distributed-Denial-of-Service-Angriff (DDoS) ist der Versuch, einen Dienst durch viele verteilte Anfragen oder Datenströme zu überlasten. Die hier beschriebenen falschen Routen und die daraus folgende Überlastung sind nicht automatisch ein DDoS-Angriff, eine böswillige Routenübernahme, Sabotage oder ein sonstiger Cyberangriff. IBM erklärte im Gegenteil, seine Analyse habe keine Probleme der Cybersicherheit festgestellt; auch diese Aussage bleibt dem Unternehmen zugeschrieben.
Die Quellen belegen ferner weder Fahrlässigkeit noch einen Verstoß gegen Regulierung, Vertrag oder Dienstgütevereinbarung. Sie nennen keinen vollständigen Schaden und keine persönliche Verantwortlichkeit einzelner Mitarbeiter. Verantwortungsanalyse bedeutet hier deshalb nicht, ein Urteil vorwegzunehmen. Sie bedeutet, die technischen Kontrollpunkte, die verfügbaren Belege und die offenen Fragen so präzise zu trennen, dass spätere Entscheidungen auf überprüfbaren Tatsachen beruhen können.
Die gemeldeten Gegenmaßnahmen sind ebenfalls kein Beweis heutiger Ausfallsicherheit. Ohne Angaben zu Umsetzung, Umfang, Tests und unabhängiger Überprüfung lässt sich nicht beurteilen, wie wirksam sie damals waren oder heute wären. Ein abgeschlossener Störungsbericht sollte daher zwischen sofortiger Wiederherstellung, dauerhafter Änderung und später nachgewiesener Wirksamkeit unterscheiden.
Praktische Kontrollen für die nächste Anbietergrenze
Betreiber sollten zunächst jede externe BGP-Nachbarschaft mit einer benannten technischen Eigentümerschaft versehen. Dazu gehören zuständige Personen oder Funktionen auf beiden Seiten, erreichbare Notfallkontakte, erlaubte Präfixbereiche, Schwellenwerte, Alarmwege sowie eindeutige Befugnisse zum Filtern oder Trennen. Diese Angaben müssen mit der tatsächlich laufenden Konfiguration übereinstimmen; eine Richtlinie auf Papier reicht nicht, wenn das aktive System anders arbeitet.
Zweitens sollten eingehende und ausgehende Präfixfilter sowie peer-spezifische Mengenbegrenzungen getestet werden. Tests müssen nicht nur zeigen, dass eine gute Route angenommen wird. Sie sollten auch nachweisen, dass unerwartete Mengen, unzulässige Präfixe und fehlerhafte Änderungen erkannt werden und eine kontrollierte Reaktion auslösen. Dabei ist zu prüfen, ob eine harte Trennung selbst zusätzliche Ausfälle verursachen könnte und welche abgestufte Reaktion angemessen ist.
Drittens braucht die Wiederherstellung vorab festgelegte Entscheidungspunkte. Wer darf eine Richtlinie ändern? Welche Messwerte rechtfertigen eine Rücknahme? Wie wird verhindert, dass eine Notmaßnahme den Fehler auf weitere Regionen oder Dienste ausweitet? Wie lässt sich nachweisen, wann die Erreichbarkeit für Kunden tatsächlich zurückkehrte? Solche Fragen verbinden technische Reaktion mit nachvollziehbarer Verantwortung.
Viertens sollten Managementebene, Statuskommunikation und Kundendatenverkehr auf gemeinsame Abhängigkeiten untersucht werden. Vollständige physische Trennung ist nicht immer möglich, doch kritische Informations- und Verwaltungswege sollten nicht alle am selben Fehlerpunkt scheitern. Übungen müssen genau dieses Szenario prüfen: Das Produktionsnetz ist gestört, während Betriebsteams und Kunden dennoch verlässliche Informationen und sichere Handlungswege benötigen.
Schließlich sollte der Abschlussbericht einen begrenzten, aber überprüfbaren Datensatz liefern. Er kann die zeitliche Abfolge, betroffene Dienstklassen, erkannte Wegeanomalien, Schutzreaktionen, Wiederherstellungsphasen und offene Punkte nennen, ohne private Topologie oder sicherheitskritische Details offenzulegen. Dadurch wird aus einer pauschalen Schuldzuweisung ein lernfähiger Betriebsprozess.
Das Verantwortungsmaß ist die laufende Wirklichkeit
Netzregister, Verträge und Richtliniendokumente sind wichtige Aufzeichnungen. Entscheidend ist jedoch, was die tatsächlich betriebenen Systeme angenommen, verworfen, gemeldet und wiederhergestellt haben. Für eine Anbietergrenze zählen deshalb genaue Live-Daten, eindeutige Zuständigkeiten und ein belastbarer Nachweis darüber, ob Schutzmaßnahmen unter realen Bedingungen funktionieren.
Der IBM-Vorfall macht zugleich die Grenze öffentlicher Analyse sichtbar. Aus zeitgenössischen Berichten lässt sich ein plausibler Mechanismus und ein konkreter Kundeneffekt rekonstruieren. Nicht rekonstruierbar sind die private Topologie, die genaue Vertragsverteilung, der einzelne technische Auslöser und die heutige Wirksamkeit der gemeldeten Maßnahmen. Gute Rechenschaft benennt beides: das, was belegt ist, und das, was offen bleibt.
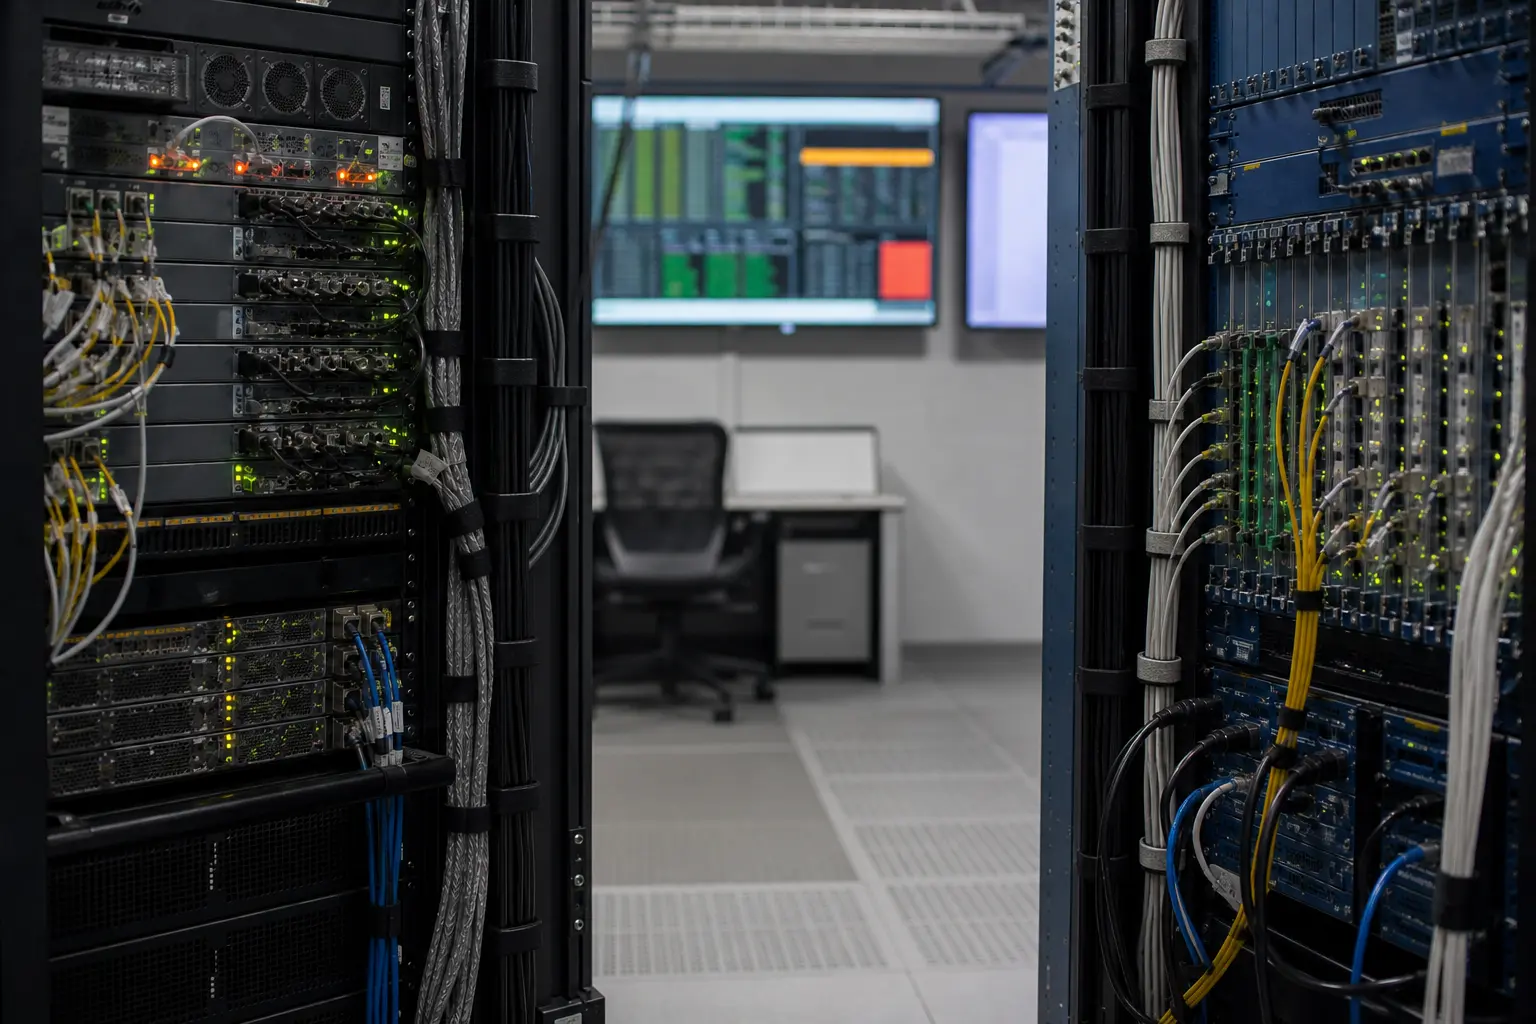
Alternativtext: Konzeptionelle, markenfreie Übergabe am Rand eines Cloud-Netzes mit Routing-Geräten und Glasfaser-Kreuzverbindungen in einem ruhig beleuchteten Betriebsraum.
Bildunterschrift: Konzeptionelles redaktionelles Bild. Es zeigt weder IBM noch den nicht genannten externen Anbieter, weder eine reale Einrichtung noch den Vorfall von 2020; ebenso wenig bildet es eine verifizierte Netztopologie oder einen Routing-Nachweis ab.
Quellen
- https://www.theregister.com/2020/06/11/ibm_blames_external_network_provider/
- https://techcrunch.com/2020/06/09/ibm-cloud-suffers-prolonged-outage/
- https://www.crn.com/news/cloud/ibm-blames-massive-cloud-outage-on-third-party-network-provider
- https://status.zellowork.com/issues/5ef227ab4a0ebd6da0cb113e
- https://www.rfc-editor.org/rfc/rfc7454.html
- https://btw.media/en/directory/international-business-machines-corporation-united-states-of-america-the
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten