
Zusammenfassung
- RFC 2987 verglich
charsetundlanguagemit derselben Gleichheitslogik, bezeichnete das erste Merkmal aber meist als Fähigkeit und das zweite meist als Präferenz. - Hauptnamen für Zeichensätze und der Vergleich vollständiger Sprach-Token verringerten Mehrdeutigkeit, ohne Dekodierung, Anzeige oder Verständnis zu beweisen.
- Ein
q-Wert ordnete Prädikate in einer lokalen Entscheidung; er bescheinigte weder verfügbare Varianten noch Nutzerzufriedenheit oder Diensterfolg.
Zwei Registrierungen in einer Form
RFC 2987 war kein umfangreiches Protokoll. Der Proposed Standard bestand im Kern aus zwei Registrierungsformularen nach RFC 2506. charset erhielt die OID 1.3.6.1.8.1.31, language die OID 1.3.6.1.8.1.32. Im aktuellen IANA-Register stehen beide weiterhin als Einträge 31 und 32 des IETF-Baums.
Das Register ermöglichte Anwendungen, Fähigkeiten und Präferenzen zur Darstellung mit gemeinsamen Namen auszutauschen. RFC 2533 lieferte eine Syntax, um Merkmalsprädikate zu verbinden und mit Qualitätswerten zu versehen. Der Wortschatz konnte unabhängig vom Transport wiederverwendet werden.
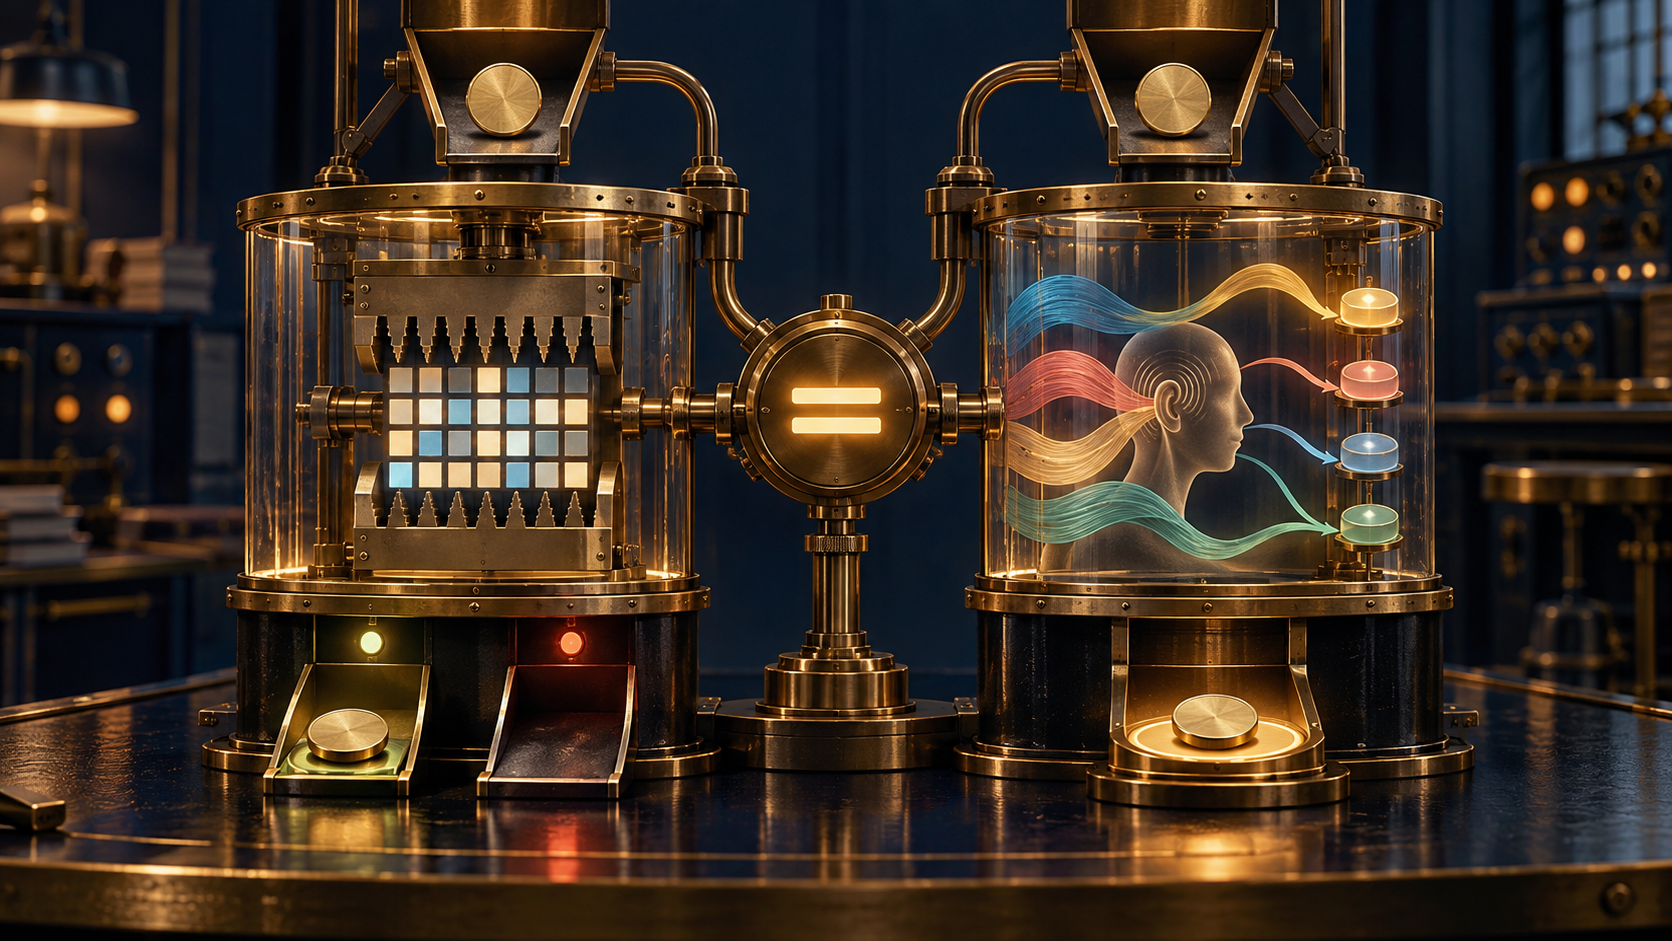
Formal waren die Einträge nahezu gleich. Die Werte waren registrierte Token. Nur Gleichheitsvergleiche waren zulässig. Groß- und Kleinschreibung spielte keine Rolle. Beide Beispiele ordneten Alternativen mit q-Werten.
Dann zog RFC 2987 eine semantische Trennlinie.
Für die meisten Geräte sei charset üblicherweise eine Fähigkeit. Text in einem unbekannten Zeichensatz könne das Gerät gewöhnlich nicht sinnvoll verarbeiten. language sei dagegen meist eine Präferenz und keine Anforderung. Mit „Darstellung“ war häufig computergenerierte Sprache gemeint. Doch der Grundsatz reicht weiter: Eine bevorzugte Sprache beschreibt den Menschen, nicht zwangsläufig eine technische Schranke des Geräts.
Dieselbe Ausdrucksform trug somit zwei unterschiedliche Arten von Grenzen.
Der Zeichensatz muss ausführbar sein
Im Beispiel stehen utf-8, iso-8859-1 und utf-16 mit 1,0, 0,9 und 0,5. Diese Reihenfolge hilft nur, wenn die genannten Decoder tatsächlich vorhanden sind.
Ein Treffer für charset=utf-8 beweist nicht, dass die empfangenen Bytes UTF-8 sind. Er beweist weder einen installierten, korrekten Decoder noch passende Schriften. Selbst korrekt gerenderte Zeichen können für den Leser unverständlich bleiben. Das übereinstimmende Token ist ein früher Beleg, kein Abschlussbeleg.
RFC 2913 registrierte type separat. Ein Gerät konnte text/plain verarbeiten und dennoch nicht jede Kodierung für Klartext kennen. Medientyp und Byte-zu-Zeichen-Regel sind verbundene, aber verschiedene Fähigkeiten.
Auch Aliasnamen konnten die Auswertung stören. RFC 2978 erlaubte mehrere Namen für einen Zeichensatz, verlangte aber einen Hauptnamen und eine eindeutige Zuordnung jedes Namens. RFC 2987 riet von Aliasen in Merkmalsausdrücken ab, weil Werkzeuge sie beim Bearbeiten in den Hauptnamen umwandeln konnten.
Der kleingeschriebene Hauptname verringerte vermeidbare Schreibunterschiede. Er prüfte keine Konvertierungstabelle und keinen laufenden Decoder. Kanonisierung schuf Namensgleichheit, nicht Funktionsfähigkeit.
Zudem sollte die charset-Fähigkeit zusammen mit jeder Fähigkeit zur Verarbeitung von Textdaten angegeben werden. Die Kategorie „Text“ allein ließ offen, wie Bytes in Zeichen überführt werden konnten.
Sprache ordnet Wünsche
Das Sprachbeispiel reihte no-nynorsk, no-bokmaal und i-sami-no. Der Operator blieb gleich, aber ein Nichttreffer bedeutete nicht automatisch technische Unfähigkeit.
RFC 1766 setzte Sprach-Tags aus einem primären Tag und möglichen Subtags zusammen. Anwendungen sollten das vollständige Tag dennoch als ein Token behandeln. Subtags dienten der Verwaltung; sie bildeten keinen universellen Baum gegenseitiger Verständlichkeit. Ein gemeinsames Präfix bescheinigte kein Verstehen.
RFC 2987 behielt diese Begrenzung bei: Gleichheit des ganzen Tokens, ohne Beachtung der Schreibweise, ohne Vergleich einzelner Subtags. Aus der Zeichenkette sollte keine unverdiente sprachliche Gewissheit entstehen.
Als Präferenz konnte Sprache jedoch einen Rückfall erlauben. Ein Nutzer akzeptiert vielleicht die zweite Wahl lieber als gar keinen Inhalt; ein anderer kann die Alternative nicht nutzen. Verfügbare Fassungen, erklärte Prioritäten und lokale Regeln entscheiden darüber.
Wer jede Präferenz als harte Schranke behandelt, verwirft brauchbare Angebote. Wer jede Präferenz beliebig übergeht, entfernt den Nutzer aus der Auswahl. Das Register normierte die Eingabe, nicht eine weltweite Politik.
Der Qualitätswert ist keine Qualitätsmessung
RFC 2533 gab einem nicht qualifizierten Prädikat den Standardwert 1, definierte aber keine universelle Formel für die Kombination aller Präferenzen. Anwendungen hatten unterschiedliche Kandidaten und unterschiedliche Kosten eines Fehlers.
q=1.0 belegt deshalb nur eine hohe Einordnung in einem bestimmten Profil. Es zeigt nicht, ob das Profil aktuell ist, die Variante existiert, eine Stimme verständlich klingt, die Bytes zum Label passen oder der Nutzer sein Ziel erreicht.
Auch bei Zeichensätzen kann ein Gewicht keinen Decoder installieren, keine Byte-Treue über Zwischenstationen beweisen und keine Darstellung bestätigen.
Ein prüfbarer Vorgang bewahrt den empfangenen Merkmalsatz, die Normalisierung, die Version des Auswerters, die lokale Regel, alle Kandidaten, die Auswahl, die verwendete Ressource und das Ergebnis. „Aushandlung erfolgreich“ beantwortet diese Fragen nicht gemeinsam.
Ein Register benennt, laufender Code entscheidet
Das fortbestehende IANA-Register zeigt den Wert minimaler Koordination. Unabhängige Implementierungen können auf dieselben Namen und Vergleichsregeln verweisen. Daraus entsteht kein zentraler Entscheider.
Der Profilhersteller bestimmt die Aussage. Der Anbieter bestimmt die Varianten. Der Empfänger bestimmt Normalisierung, Rangfolge und Rückfall. Der Nutzer erfährt die Folge. Kein Akteur besitzt die gesamte Kette.
Lu Hengs Konzept der minimalen Anfangsspezifikation beschreibt diese Grenze: Gemeinsam festgelegt werden nur Namen, Wertebereiche und Vergleiche, die Interoperabilität verlangen. Spätere Entscheidungen bleiben lokal.
Lokale Freiheit verlangt jedoch lokale Nachweise. Wer eine Sprachpräferenz verhärtet oder eine Zeichensatzfähigkeit aufweicht, kontrolliert die entscheidende Interpretation. Diese Regel muss sichtbar sein und darf nicht als Befehl des Registers erscheinen.
Running-Code Primacy stellt die nächste Frage: Was tat die eingesetzte Implementierung tatsächlich? Ein Standarddokument beweist keinen Decoder, keine Schrift, keine Stimme, keinen Inhalt und kein aktuelles Profil. Erst die Ausführung belegt Vergleich, Auswahl, Dekodierung und Darstellung.
Die Realitätsschichten lauten Register, Ausdruck, Normalisierung, Auswertung, Auswahl, Fähigkeit, Ausführung, Wahrnehmung und Ergebnis. Eine wahre frühere Schicht hat kein Mandat, für alle späteren zu sprechen.
Die begrenzte Sicherheitswarnung
Beide Registrierungen bemerkten, dass die Offenlegung einer akzeptierten Zeichenkodierung oder Sprache einem Angreifer geringfügig helfen könnte, wenn für die Anzeige in dieser Umgebung ein Sicherheitsfehler bekannt war. RFC 2987 nannte weder Produkt noch Vorfall.
Die Warnung zeigt dennoch: Fähigkeitsprofile sind Betriebsdaten. Sie lenken Entscheidungen und können Angriffsfläche offenlegen. Ein System sollte nur notwendige Angaben veröffentlichen und „akzeptiert“ nie als „sicher“ auslegen.
Die historische Leistung von RFC 2987 liegt nicht in der Gleichsetzung beider Tags. Sie liegt darin, gemeinsame Mechanik zu ermöglichen und den Bedeutungsunterschied zu bewahren.
Das eine antwortete gewöhnlich: Kann die Maschine das? Das andere: Was möchte der Mensch? Gleiche Syntax bedeutete nicht gleiche Beweiskraft.
Quellen
- IETF-Verlauf zu RFC 2987
- Lu Heng — Minimum Initial Specification, Localized Future Decision, and Voluntary Adoption
- Lu Heng — Realitätsschichten und symbolische Macht
- Lu Heng — Running-Code Primacy
- IANA-Register der Medienmerkmal-Tags
- Errata zu RFC 2987
- RFC-Editor-Information zu RFC 2987
- RFC 1766 — Tags zur Kennzeichnung von Sprachen
- RFC 2277 — IETF-Richtlinie zu Zeichensätzen und Sprachen
- RFC 2506 — Registrierung von Medienmerkmal-Tags
- RFC 2533 — Syntax für Medienmerkmalsätze
- RFC 2913 — MIME-Typen in Merkmalsausdrücken
- RFC 2978 — IANA-Verfahren für Zeichensatzregistrierungen
- RFC 2987 — Registrierung von
charsetundlanguage
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten