
Zusammenfassung
- Eric Dumazet ist derzeit als Maintainer für Linux-Netzwerke, TCP und Sockets gelistet und Mitglied des Technischen Lenkungsausschusses der Netdev Foundation. Diese Verantwortlichkeiten teilt er mit anderen Maintainern und Reviewern; sie geben ihm erhebliche Merge-Verantwortung, aber keine alleinige Autorität über den Netzwerk-Stack.
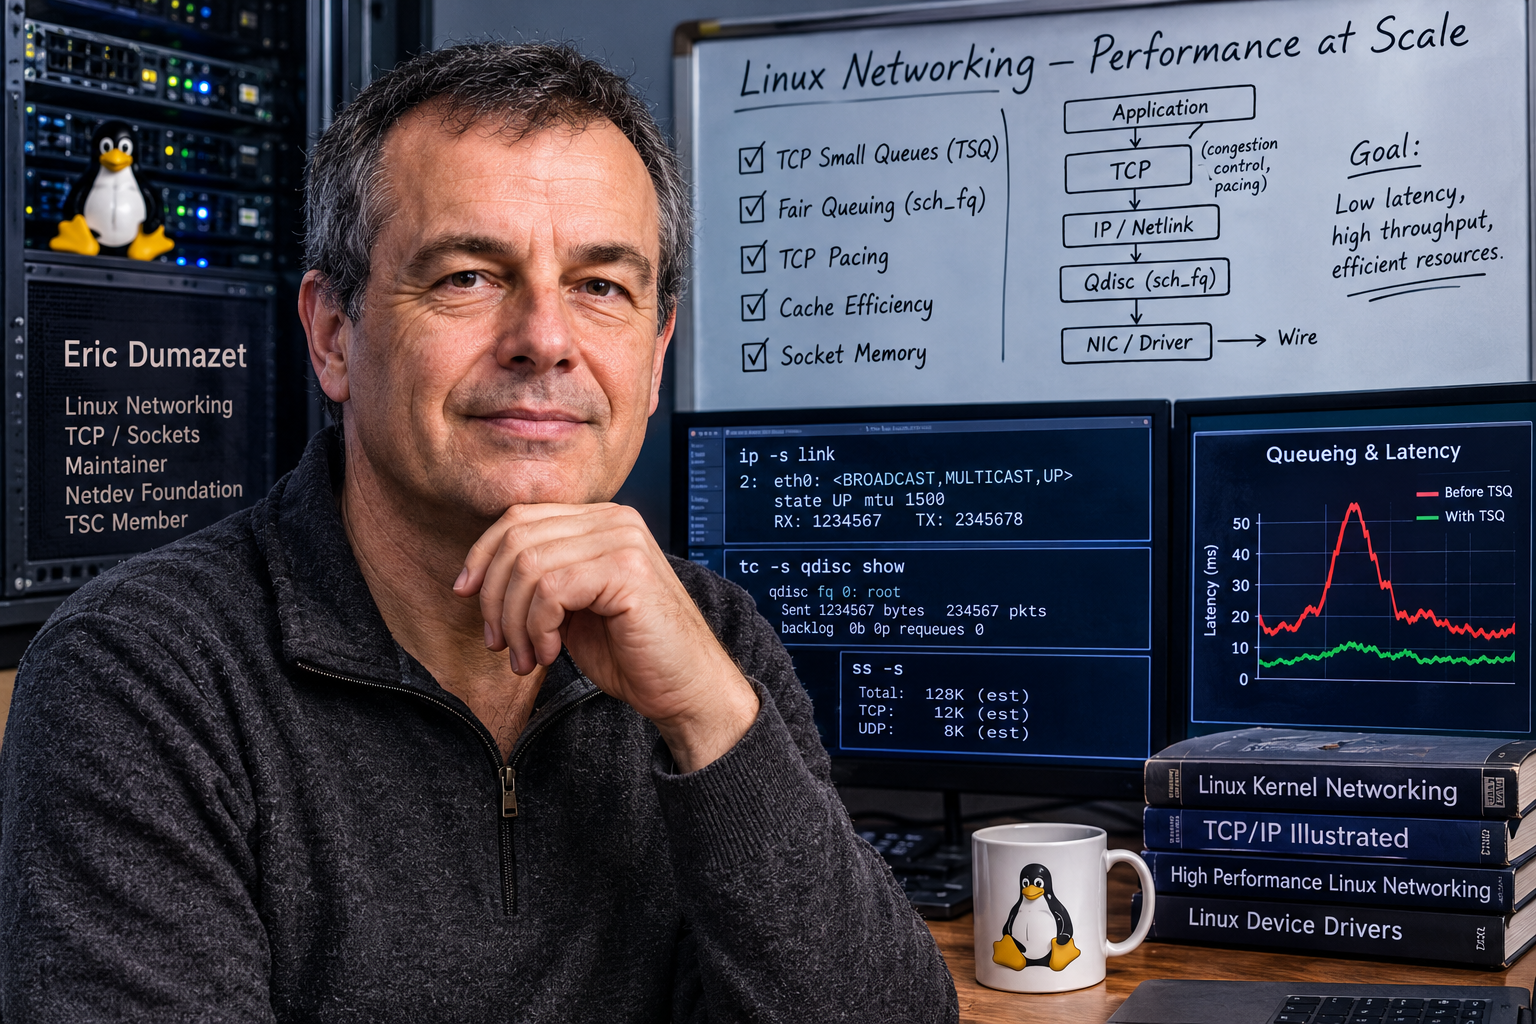
- Sein bekanntester benannter Beitrag ist TCP Small Queues, das er 2012 über eine Patch-Serie einführte, um zu verhindern, dass ein einzelner TCP-Fluss übermäßig viele Daten in Warteschlangen unterhalb der Transportschicht ablegt. TSQ verknüpfte das lokale Warteschlangenbudget eines Sockets mit dem Abschluss von Paketen, reduzierte so Latenz und Speicherdruck beim Sender, ohne jede Warteschlange auf dem Pfad zu entfernen.
- Seine spätere Arbeit an
sch_fqund internem TCP-Pacing verlagerte das Sende-Timing auf eine explizite Steuerungsebene. Faire Warteschlangenverwaltung trennt Flüsse, während Pacing Pakete zeitlich verteilt. Diese Mechanismen unterstützen mehrere Überlastkontrollalgorithmen, einschließlich Umgebungen mit BBR, aber BBR hat unabhängige Autoren und eine eigene Designgeschichte. - Seine jüngste Arbeit verbindet die Anordnung von Datenstrukturen, Cache-Zeilen-Verkehr und socketbezogenen Zustand mit der Effizienz großer Flotten. Die breitere Schlussfolgerung: Linux-Netzwerke sind ein Abrechnungssystem für Prozessor, Speicher, Warteschlangentiefe und Zeit. Die wirtschaftliche Wirkung kann erheblich sein, aber die öffentlichen Belege erlauben keine konkrete finanzielle Zahl oder ein allgemeines Leistungsergebnis für jede Hardware.
Ein schneller Server kann Zeit hinter seinen eigenen Paketen verschwenden
Die Geschichte beginnt in einer Sendewarteschlange eines Linux-Hosts. Die Anwendung hat Daten geschrieben, TCP entschied, dass der Pfad mehr aufnehmen kann, und der Kernel übergab die Daten an tiefere Schichten. Aus Sicht der Anwendung scheinen die Bytes das System verlassen zu haben, aber sie können noch innerhalb des Geräts warten.
Der Durchsatz kann hoch bleiben und die Latenz verbergen. Eine interaktive Anfrage wartet hinter einem großen Transfer, Speicher bleibt in Puffern gebunden, und TCPs Wahrnehmung dessen, was „in flight“ ist, weicht von den lokal gestapelten Daten ab. TCP Small Queues änderte dieses Verhältnis, indem es begrenzte, was ein Socket unterhalb von TCP ablegen konnte, und das Senden erst wieder erlaubte, wenn der Paketabschluss bewies, dass die Hardware tatsächlich vorangekommen war.
Der öffentliche Datensatz ist reich an Technik und bewusst begrenzt in der Biografie
Die stärksten Belege über Dumazet stammen aus Linux selbst: die DateiMAINTAINERS, Patch-Diskussionen, Dokumentation, Vorträge und jahrelange öffentliche Reviews. Diese Aufzeichnungen belegen seine aktuellen Verantwortlichkeiten für Netzwerke, TCP und Sockets, seine Rolle in der Netdev Foundation und seine öffentliche Verbindung zu Google über die Maintainer-Adresse.
Sie liefern jedoch keine vollständige Biografie, keinen bestätigten aktuellen Jobtitel und keine endgültige Zählung von Patches und Reviews. Solche Details zu erfinden, würde den Artikel schwächen. Deshalb konzentriert sich das Profil auf das Überprüfbare: Mechanismen, Designs und Review-Entscheidungen. Dumazet zeigt sich als Ingenieur mit technischer Verantwortung; seine Arbeit wird erst dann zu gemeinsamer Infrastruktur, wenn andere sie prüfen, ändern, testen und veröffentlichen.
Die Maintainer-Rolle bringt ihn näher an Entscheidungen, stellt ihn aber nicht über die Gemeinschaft
Bis zum 4. August 2026 führten die Linux-Aufzeichnungen ihn für allgemeine Netzwerke, TCP und Sockets. Ein Maintainer kann ein Interface-Redesign verlangen, eine Last ablehnen, die jahrelang nicht unterstützt werden kann, oder eine akzeptierte Änderung anwenden und das Subsystem auf dem Weg in den Mainline-Kernel vertreten.
Dieselben Aufzeichnungen zeigen, dass die Autorität verteilt ist. David S. Miller, Jakub Kicinski und Paolo Abeni teilen sich die allgemeinen Netzwerke, Neal Cardwell teilt sich TCP, und spezialisierte Reviewer arbeiten je nach Patch-Thema. Änderungen durchlaufen außerdem Architekturen, Treiber, Sicherheit, Tests, Stable-Zweige und den endgültigen Kernel-Pfad. Dumazets Stärke ergibt sich aus seiner Arbeit innerhalb dieses Systems, nicht aus dessen Umgehung.
Linux-Details wurden mit wachsender Verbindungszahl zur Infrastrukturökonomie
Auf einem kleinen Gerät fallen ein paar zusätzliche Bytes pro Socket oder ein einzelner Cache-Miss kaum auf. Auf einem Server mit Hunderttausenden von Verbindungen vervielfachen sich diese Kosten, bis sie mit der Anwendung um Prozessor, Speicher und Energie konkurrieren.
„Serverökonomie“ bedeutet keine veröffentlichte finanzielle Zahl. Gemeint ist, wie technische Kosten zu Verbindungsdichte, verbleibender CPU-Zeit für den Dienst, für Netzwerke reserviertem Speicher und Latenz werden, die Antwortzeitziele zunichtemacht. Distributionen und Betreiber wählen Kernel-Version, qdisc, Überlastkontrollalgorithmus und NIC. Dumazet kontrolliert diese Entscheidungen nicht; er verbessert die gemeinsame Basis, von der sie ausgehen.
Die vertraute TCP-Funktion verbirgt ein intensives Abrechnungssystem
TCP wird üblicherweise als zuverlässiger Byte-Stream definiert. Die Implementierung muss jedoch entscheiden, wie viele unbestätigte Daten erlaubt sind, wann erneut gesendet wird, wie Speicher angerechnet wird, wie Pakete geordnet werden und wie Tausende von Sockets Prozessor und Warteschlangen teilen.
Eine Implementierung kann protokollarisch korrekt und betrieblich schlecht sein: ein tiefer lokaler Backlog, Bursts, Sperrenkonkurrenz oder cache-lastige Strukturen. Der gemeinsame Faden in Dumazets Arbeit ist Abrechnung. Bytes werden Sockets zugeordnet, Abschlüsse geben Budget zurück, Sendezeitpunkte werden berechnet, Flüsse getrennt und heiße von kalten Feldern unterschieden. Das Ziel ist, nur die nötigen Ressourcen zu verwenden, ohne ein zweites verstecktes Netzwerk im Host aufzubauen.
Vor TSQ konnte der Sender einen Backlog aufbauen, den er nicht mehr kontrollierte
Vor TCP Small Queues konnte TCP eine große Datenmenge an qdisc und Treiber übergeben. Das Überlastfenster mochte auf Pfadebene sinnvoll sein, während unterhalb der Transportschicht eine lange lokale Warteschlange verblieb. Wenn ein dringlicherer Fluss auftauchte, konnte die Anwendung nicht zurückholen, was sie nach unten geschoben hatte.
Das schwächte das Feedback. TCP las Bestätigungen vom entfernten Ende, aber ein Teil der Daten hatte den Host noch nicht verlassen. Die Warteschlangen verbrauchten außerdem Speicher, besonders wenn viele Flüsse dasselbe taten. Das System musste den Durchsatz erhalten, ohne jedem Socket zu erlauben, die unteren Schichten als unbegrenzten Puffer zu nutzen.
Die TSQ-Serie von 2012 gab das lokale Warteschlangenbudget an den Socket zurück
Die Patches von 2012 begrenzten, wie viele Daten jeder Socket unterhalb von TCP ablegen konnte. Wenn das lokale Budget erschöpft ist, stoppt das Senden; wenn Pakete abgeschlossen werden, erhält der Socket das Recht, mehr zu senden.
Die Idee ist einfach: lokale Bytes zählen und den Abschluss als Beweis nutzen, dass der untere Pfad sich bewegt hat. Ihre Bedeutung liegt darin, dass sie die Kontrolle an die Transportschicht zurückgab, die den Fluss versteht. Den Link ausgelastet zu halten, erforderte nicht mehr, einen großen Batch im Voraus abzulegen. Anwendungen profitierten von einer disziplinierteren internen Basis, ohne ihren Code zu ändern.
Der Paketabschluss wurde zu einem praktischen Feedback-Signal im Host
Ein Abschluss mag wie bloßes Aufräumen von Ressourcen wirken. TSQ nutzte ihn als Information: Unterhalb von TCP wurde Kapazität frei, und dem Socket konnte neues Budget gewährt werden.
Dieses lokale Feedback ergänzt das entfernte ACK. Ersteres beschreibt den Fortschritt der Schichten unterhalb des Transports, letzteres den Fortschritt des Pfads; qdisc-, Treiber- und NIC-Statistiken beschreiben weitere Teile. Kein einzelnes Signal erklärt alles. TSQ machte eines dieser Signale nützlich, um lokale Überlastung zu begrenzen, ohne die Ende-zu-Ende-Überlastkontrolle abzuschaffen.
TSQ beseitigte eine wichtige Bufferbloat-Quelle, nicht alle Warteschlangen
TSQ hat Bufferbloat nicht beendet. Es behandelt den Sendebacklog unterhalb von TCP. Warteschlangen bleiben in qdisc, Treiber, NIC, Zugangsnetz, Routern, Switches und beim Empfänger bestehen.
Die präzisere Aussage ist nützlicher: TSQ verringert die Fähigkeit eines einzelnen Sockets, eine große versteckte Warteschlange im Host aufzubauen. Es kann Latenz und Speicher senken und den TCP-Zustand näher an den Gerätefortschritt bringen, ersetzt aber weder aktives Warteschlangenmanagement noch Warteschlangen-Tuning oder Überlastkontrolle.
Grenzen, Offloads und Workloads bestimmen, wie viel TSQ bringt
Die Wirkung hängt vom lokalen Limit, der Paketgröße, der qdisc, den Gerätewarteschlangen, der Segmentierung und der Flussmischung ab. Ein interaktiver Dienst mit kurzen Transfers profitiert anders als eine große Kopieraufgabe.
Die Implementierung entwickelte sich nach 2012 weiter. Spätere Beitragende passten Grenzen, Integration und Randfälle an. Die ursprüngliche Idee kann Dumazet zugeschrieben werden, während die heutige Form das Ergebnis langer gemeinsamer Pflege ist.
sch_fqtrennte Flüsse und führte Zeit in die Planung ein
2013 veröffentlichte Dumazet die grundlegende Arbeit zusch_fq. Der Scheduler hält Zustand pro Fluss und eine zeitlich geordnete Struktur und sendet Pakete gemäß ihrer Ziel-Sendezeit. Neue Flüsse erhalten schnellen Dienst, während gepacte Flüsse auf ihren Termin warten.
Das Design behandelt zwei Probleme: Es verhindert, dass ein massiver Fluss die lokale Warteschlange dominiert, und gibt TCP einen Ort, an dem Sendezeiten umgesetzt werden. Es garantiert keine gleichen Ergebnisse für alle Anwendungen, sondern bietet eine diszipliniertere Politik und eine praktische Umsetzungsfläche für Pacing.
Fair Queueing ist eine Politikwahl, kein Versprechen perfekter Gleichheit
Das Wort „fair“ kann mehr suggerieren, als das System liefert. Flüsse in einer Warteschlange zu trennen, gleicht nicht die Anwendungsleistung aus. Paketgröße, Pfad, Empfänger, Überlastkontrollalgorithmus, Offload und Verbindungszahl bleiben wichtig.
Sogar die Definition eines Flusses ist Politik. Eine Anwendung kann viele Verbindungen öffnen, während eine andere nur eine nutzt.sch_fqreduziert lokal die Dominanz eines einzelnen Flusses, definiert aber keine Fairness zwischen Nutzern oder Organisationen. Es ist ein Scheduling-Werkzeug, kein umfassendes Gerechtigkeitsurteil.
Pacing verwandelt Geschwindigkeitsschätzung in eine Folge von Sendezeiten
Ein Überlastkontrollalgorithmus mag einen korrekten Durchschnitt wählen und dann erlauben, die Menge in einem Burst zu senden. Der Durchschnitt bleibt korrekt, aber der Burst füllt vorübergehend die Warteschlange.
Pacing verteilt Pakete über die Zeit. Es kann Warteschlangen stabilisieren, die gemeinsame Nutzung verbessern und das Überlastmodell genauer umsetzen. Die Implementierung hängt von Zeitstempeln, Timern, qdisc, Segmentierung und NIC ab. Die programmierte Rate wird erst real, wenn sie zu tatsächlichen Abständen auf dem Draht wird.
Pacing und Überlastkontrolle lösen unterschiedliche Teile
Der Überlastkontrollalgorithmus entscheidet, wie viel vom Pfad genutzt wird; Pacing entscheidet, wann die erlaubten Daten gesendet werden. Bursts können ein gutes Modell verderben, und exzellentes Pacing kann eine schlechte Rate ausführen.
Dumazets Arbeit schuf eine ermöglichende Struktur, die verschiedenen Algorithmen erlaubt, Rate in Zeit umzuwandeln. Das Design jedes Überlastmodells und seine Zuordnung bleiben bei seinen Autoren.
BBR nutzt die Pacing-Struktur, hat aber unabhängige Autoren und Geschichte
BBR wird oft mit Dumazets Namen verbunden, weil es auf Pacing beruht und in der Google-TCP-Umgebung entstand. Diese Verbindung macht ihn nicht zum alleinigen Erfinder. BBR hat eigene Autoren, ein eigenes Modell und eigene Versionen.
Die präzise Formulierung ist, dass Warteschlangen, Pacing, Metriken und Socket-Abrechnung spätere Algorithmen veröffentlichbar machten. Diese Formulierung bewahrt Dumazets Wert und lässt Neal Cardwell und anderen Überlastingenieuren ihren Verdienst.
TSO spart Prozessorarbeit und kann den Burst zurückbringen, den Pacing verhindern wollte
TCP Segmentation Offload erlaubt dem Kernel, ein großes Segment an die NIC zu übergeben, die es später teilt. Das senkt die Kosten pro Paket, fügt aber eine Hardwareschicht zwischen Timing-Entscheidung und tatsächlichem Senden hinzu.
Wird ein großes Segment als Einheit freigegeben, kann die NIC einen Burst erzeugen. TSQ, qdisc, TSO, Treiber und Hardware sollten als ein System verstanden werden. Eine Optimierung kann dem Prozessor nutzen und dem Timing schaden, wenn sie nicht mit dem Verkehrsmuster abgestimmt ist.
Quantum, Zeitstempel und NIC-Verhalten müssen sich auf eine Realität einigen
Der Kernel arbeitet mit Scheduling-Einheiten, Timer-Genauigkeit, Zeitstempeln, Offload-Einheiten und Hardware-Warteschlangen. Ein großes Quantum bringt Bursts zurück, ein kleines verbraucht CPU, und unterschiedliche NIC-Implementierungen verändern, was auf dem Draht passiert.
Deshalb ist qdisc Teil der Kapazitätsplanung, kein Detail. Entwickler müssen den gesamten Pfad messen, und jeder Benchmark, der nur Überlastalgorithmus oder Linkrate erwähnt, übersieht wichtige Teile.
Internes TCP-Pacing reduzierte die Abhängigkeit von einer bestimmten qdisc
2017 veröffentlichte Dumazet Pacing innerhalb von TCP. Der Transport konnte das Senden gemäß eigener Rate und Timer verzögern, ohne vollständig auf eine bestimmte qdisc in erwarteter Weise angewiesen zu sein.
Die qdisc wurde nicht unwichtig; sie ordnet weiterhin und wendet Politik an. Ein Teil der Logik wanderte zur Schicht, die die Absicht besitzt, aber das endgültige Timing blieb das Ergebnis von TCP, qdisc, Treiber und NIC zusammen.
Die Wahl der qdisc bleibt eine Betreiberentscheidung, die den Dienst tatsächlich verändert
Linux bietet Warteschlangen für verschiedene Ziele.sch_fqeignet sich für Pacing; FQ-CoDel kombiniert Flusstrennung mit aktivem Warteschlangenmanagement. Sie sind nicht dasselbe.
Die Annahmen unterscheiden sich zwischen Distributionen, Cloud-Images, Geräten und Container-Hosts, und Offload kann die Ausführung in Hardware verlagern. Der Kernel stellt die Fähigkeit bereit; der Betreiber entscheidet, ob sie zu realem Dienstverhalten wird.
Wenige Bytes pro Socket werden zur Einschränkung für eine ganze Flotte
Jede Verbindung trägt Sequenznummern, Timer, Überlastzustand, Warteschlangen und Abrechnungsfelder. Bei großen Zahlen vervielfacht sich jedes Byte, und jedes häufig genutzte Feld wird zur Cache-Last.
Weniger Speicher pro Socket kann die Dichte erhöhen, und bessere Anordnung kann Cache-Misses und Kohärenzverkehr zwischen Kernen reduzieren. Das ist die stärkste Verbindung zur Serverökonomie, erlaubt aber keine allgemeine Einsparungsquote oder einen persönlichen finanziellen Wert.
Eine Cache-Zeile wird zur Infrastruktur, wenn sie bei jedem Paket berührt wird
Der Prozessor bewegt ganze Cache-Zeilen, nicht einzelne Quellfelder. Liegen heiße Daten neben kalten Feldern, werden unnötige Bytes bewegt; aktualisieren verschiedene Kerne Werte in derselben Zeile, entsteht Kohärenzkonkurrenz.
Dumazets neuere Arbeit liest den Code mit dieser Physik. Heiße und kalte Felder zu trennen, reduziert Speicherverkehr, der mit Paketen und Sockets wächst. Das Ergebnis hängt von Prozessor und Workload ab; ein Flottenprofil darf nicht zur Regel für alle Systeme gemacht werden.
Die Strukturarbeit von 2024 zeigt eine reife Phase der Leistungstechnik
Der Vortrag von 2024 begann mit Profiling: Welche Felder sind heiß, welche Zeilen bewegen sich, welche Strukturen dominieren den Speicher. Werkzeuge können eine Anordnung vorschlagen, ersetzen aber nicht die Überprüfung von Ausrichtung, Sperren, Kompatibilität und Wartbarkeit.
In einer reifen Struktur kann der Gewinn aus der Beseitigung eines Cache-Miss oder dem Verschieben eines Feldes kommen, nicht aus einem neuen Algorithmus. Das ist weniger glamourös, kann aber die tatsächliche Leistung im großen Maßstab bestimmen.
Hyperscale-Profile sind starke Belege, aber unvollständige öffentliche Wissenschaft
Große Betreiber sehen Verbindungszahlen, NICs und Verkehr, die schwer zu reproduzieren sind. Sie können Kosten offenlegen, die im Labor nicht auftauchen. Dumazets Verbindung zu Google liefert diese Art von Produktionsbelegen.
Aber manche Workloads, Werkzeuge und Daten bleiben privat. Ein Vortrag kann Methode und Richtung erklären, ohne alle Eingaben zu veröffentlichen. Erforderlich ist, Schlussfolgerungen einzuschränken und möglichst viele private Beobachtungen in öffentliche Tests und CI zu überführen.
Sperren und Empfangswarteschlangen gehören zur selben Ressourcengeschichte
Der Artikel konzentriert sich auf das Senden, aber Dumazets Aufzeichnung umfasst Sockets und den Empfangspfad. Eingehende Pakete benötigen Polling, Speicher, Klassifizierung, Warteschlangen und Zustellung zwischen Kernen. Bei hohen Raten werden gemeinsamer Zustand und Sperren zu Kosten.
Linux senkt das durch Batching, Arbeitsverlagerung und verringerte Konkurrenz. Das Prinzip ist dasselbe: genug Koordination für Korrektheit, ohne dass die Abrechnung die Anwendungskapazität verbraucht.
Batching erhöht den Durchsatz und verändert Latenz und Fairness
Pakete oder Abschlüsse zu sammeln, verteilt die Kosten von Sperren, Aufrufen und Cache-Verkehr. NAPI, Treiber und Offloads beruhen darauf.
Aber ein Batch wartet auf seine Bildung und kann als Burst ankommen. Je größer er wird, desto besser die Amortisation, aber desto länger wartet das erste Element oder ein einzelner Fluss dominiert. TSQ, Fair Queueing und Pacing bekämpfen das Batching nicht, sondern setzen ihm Grenzen, die Feedback und Latenz bewahren.
TCP-Leistung entsteht aus Schichten, die einander aufheben können
Der Überlastkontrollalgorithmus entscheidet die Absicht, TCP erstellt Pakete und Timing, TSQ begrenzt den Backlog, qdisc ordnet, TSO sammelt, der Treiber bereitet Speicher vor, die NIC sendet, und dann fügt das Netzwerk seine Warteschlangen und Verluste hinzu.
Ein grober Offload kann feines Pacing zunichtemachen, übermäßiges Enqueue kann eine latenzarme qdisc überfluten, und eine neue Sperre kann einen Layout-Gewinn zunichtemachen. Dumazets Arbeit ist wichtig, weil sie die Verbindungen zwischen diesen Schichten behandelt.
Öffentliche Patch-Reviews verwandeln lokale Optimierung in gemeinsame Infrastruktur
Eine Änderung beginnt mit einem Leistungsversprechen: weniger Latenz, Speicher oder CPU. Um in Linux aufgenommen zu werden, muss sie netdev-Fragen zu Messung, Allgemeingültigkeit, seltenen Architekturen, Tests und künftigen Kosten beantworten.
Ein Maintainer kann verlangen, die Serie aufzuteilen, eine anbieterspezifische Abstraktion ablehnen oder eine unfertige Änderung verschieben. Der Pfad ist langsamer als ein interner Patch und dauerhafter. Ein Teil von Dumazets Autorität ist die Einschätzung, ob Linux die Änderung jahrelang unterstützen kann.
netundnet-nexttrennen dringende Korrekturen von künftiger Entwicklung
Korrekturen gehen normalerweise annet, Funktionen und Umbauten annet-next. Das verhindert die Vermischung heutiger Wartung mit Änderungen der nächsten Version.
Die Grenze erfordert Urteilsvermögen. Ein „Fix“ kann Verhalten ändern, und eine Funktion kann einen alten Fehler aufdecken. Maintainer verlangen getrennte Serien, um Risiken zu zeigen; Anbieter-Veröffentlichungstermine sind kein ausreichender Grund für einen Merge.
Review, Ablehnung und Redesign erscheinen nicht in Commit-Zahlen
Commits messen den sichtbaren Autor, nicht ein Review, das ein Interface zur Änderung zwang, oder eine Ablehnung, die eine langfristige Last verhinderte. Einen Patch anzuwenden, ist Merge-Verantwortung, kein Anspruch auf Erfindung der Idee.
Das Profil sollte TSQ,sch_fq, Pacing und Layout, die zuschreibbar sind, mit der Betreuung verbinden, die nicht auf eine Rangliste reduzierbar ist. Nicht alles, was Dumazet merged, ist seine persönliche Erfindung.
Tests reduzieren Risiken, bilden aber nicht jedes Gerät ab, dem Linux begegnet
Builds, Selftests, KUnit, syzbot, Treiberlabore und Downstream-Bereitstellung finden viele Regressionen, decken aber nicht jede CPU, NIC, qdisc und jeden Workload ab.
Eine Hyperscale-Verbesserung kann ein seltenes Gerät schädigen. Erfahrung, Kompatibilität und Rollback bleiben nötig. Tests stärken die Governance, ersetzen aber kein Urteilsvermögen.
Backport auf Stable schafft eine zweite Entscheidung nach Mainline
Ein Patch gelangt nicht automatisch aus Mainline in jeden Stable-Zweig. Er muss eine echte, begrenzte und risikoarme Korrektur sein, und dann treffen Distributionen eine weitere Entscheidung.
Leistungsänderungen hängen oft mit Kontext zusammen, der im alten Zweig fehlt. Die Wirkung bewegt sich stufenweise: Upstream, dann Stable, dann Distribution, dann Cloud, dann Konfiguration. Keine einzelne Person kontrolliert die gesamte Kette.
Die aktuelle TCP- und Socket-Pflege ist bewusst geteilt
DieMAINTAINERS-Datei verteilt die Verantwortung zwischen Dumazet, Neal Cardwell und anderen. Das verringert die Abhängigkeit von einer Person und integriert Wissen über Überlastkontrolle, Sockets, Treiber und Tests.
Aber Teilen erfordert klare Zuständigkeit. Überlappende Bereiche können Lücken hinterlassen, wenn alle denken, jemand anderes sei verantwortlich. Gesunde Nachfolge überträgt Gründe, Tests und Autorität, nicht nur Namen.
Die Netdev Foundation kann finanzieren, ohne Merge-Autorität zu werden
Die Stiftung unterstützt unter Aufsicht der Linux Foundation CI, Werkzeuge, Reisen und Forschung; Dumazet sitzt im TSC. Ein Stipendium garantiert keine Patch-Annahme.
Tiefe Wartung braucht Geld, Zeit und Hardware. Das anzuerkennen bedeutet nicht, Upstream-Legitimität auf den Geldgeber zu übertragen. Geld sollte die Entscheidungsfähigkeit der Gemeinschaft erhöhen, nicht eine Ausnahme kaufen.
Die Google-Verbindung liefert Ingenieurskapazität ohne Eigentum an Linux-TCP
Die Google-E-Mail belegt die Verbindung, nicht einen vollständigen Jobtitel. Ein Hyperscaler kann Profiling, Hardware und Review-Zeit finanzieren, von denen nach dem Upstream alle profitieren.
Das Problem ist, dass manche Belege privat sind und die Prioritäten großer Flotten deutlicher hervortreten. Öffentliches Review ist das Gleichgewicht: Ein Patch muss allgemein, verständlich und außerhalb von Google akzeptabel bleiben. Das Unternehmen stellt Zeit und Belege, besitzt aber nicht den Stack.
Downstream-Betreiber entscheiden, ob eine Upstream-Verbesserung den Dienst verändert
Distributionen wählen Kernel und Backports, Clouds wählen qdisc und Überlastkontrolle, Geräte behalten ältere Versionen, der NIC-Anbieter bestimmt Fähigkeiten, und Anwendungen erzeugen das Verkehrsmuster. Es gibt keine zuverlässige globale Erhebung zur Nutzung von TSQ odersch_fq.
Der Mechanismus kann vorhanden und nicht aktiviert sein oder standardmäßig laufen, ohne dass der Nutzer seinen Namen kennt. Dumazets Wirkung ist breit und indirekt: Er verändert gemeinsame Optionen, und jeder Betreiber übersetzt sie in Erfahrung.
User-Space-Stacks konkurrieren bei spezialisierten Workloads, nicht bei jeder Linux-Rolle
DPDK, VPP und Anwendungs-Stacks umgehen Teile des Kernels für hohe Raten und feine Kontrolle, benötigen aber oft dedizierte Kerne, Huge Pages, Gerätebindung und ein eigenes Betriebsmodell.
Linux-TCP bietet breitere Integration mit Sockets, Sicherheit, Namespaces, Überwachung und Treibern. Dumazets Arbeit senkt die Kosten des allgemeinen Pfads, ohne zu behaupten, er sei für jeden Fall der beste. Umgehung bleibt für Sonderfälle, Linux die gemeinsame Basis für die Mehrheit.
Linux bleibt Standard, weil Integration breiter ist als rohe Paketgeschwindigkeit
Der Stack muss schnell, kompatibel, sicher, beobachtbar und auf Tausenden Geräten unterstützt sein. Ein separater Pfad mag höhere pps liefern und erhöht Betriebs- und Supportkosten.
Eine Anwendung nutzt einen normalen Socket und erbt TSQ, Pacing und Speicherabrechnung. Diese Unsichtbarkeit ist Teil der Stärke der Infrastruktur: Die Wirkung bleibt, auch wenn der Nutzer den Namen des Autors nicht kennt.
Ein schnellerer Host beweist keinen besseren Netzwerkpfad
Eine bessere lokale Warteschlange behebt keinen überlasteten Uplink, keinen belasteten Empfänger und keine paketverwerfenden Router. TSQ und Pacing steuern den Sender, nicht den gesamten Weg.
Sie können eine Latenzquelle senken und das Senden glätten, aber das Anwendungsergebnis bleibt zwischen Sender, Empfänger, Netzwerk und Einstellungen geteilt.
Ein einzelner Benchmark repräsentiert nicht jeden Server, jede NIC und jeden Workload
Paketgröße, Verbindungszahl, CPU, Cache, NIC, Offloads, qdisc, Timer, Kernel-Version und Workload verändern das Ergebnis. Ein Google-Profil deckt reale Kosten auf, prognostiziert aber keine exakte Quote in einer anderen Flotte.
Ein guter Bericht hält die Messbedingungen fest. Dumazets Vorträge sind zuordenbare Betriebsbelege; Verallgemeinerung erfordert öffentliche Tests und unabhängige Messungen.
Nachfolge ist ein technisches Problem, weil ein Teil des Designs im menschlichen Gedächtnis lebt
Es mag eine seltsame Grenze wegen einer alten NIC geben, eine noch genutzte API oder eine Regression, die vor Jahren behoben wurde. Der Code allein erklärt den Grund nicht immer.
Erfahrene Maintainer tragen diese Geschichte, und mit ihnen entsteht ein gewisses Schlüsselpersonenrisiko. Dokumentation, Tests, Archive und neue Maintainer verwandeln individuelles Gedächtnis in institutionelles Wissen. Gute Nachfolge bewahrt Prinzipien und erlaubt, die Implementierung an neue Hardware anzupassen.
Hardware-Pacing und Gerätespeicher könnten die Grenze erneut verschieben
Moderne NICs können Pakete planen, mehr Warteschlangen verwalten, Telemetrie liefern und lokalen Speicher bereitstellen. Sie senken CPU-Last und verlagern Verhalten in Firmware.
Die Herausforderung wird koordinativ: Linux muss Absicht ausdrücken, sehen, was die Hardware tat, und bei Abweichungen reagieren. APIs, Zeitstempel und Fehler werden so wichtig wie Rate. Dumazets Prinzipien bleiben: Abrechnung nahe am Absichtsträger, Feedback, Grenzen für versteckte Warteschlangen und klare Grenzen.
Die nächsten Gewinne könnten aus Cache-Ökonomie kommen, nicht aus neuen Übertragungsformeln
Weitere Überlastkontrollalgorithmen werden erscheinen, aber der praktische Gewinn auf einem riesigen Host könnte aus der Teilung einer Struktur, dem Entfernen einer Sperre, der Anpassung eines Batch oder dem Verhindern einer Cache-Zeile, die zwischen Kernen springt, kommen.
Das sind markenlose Änderungen, die vielen Algorithmen nützen. Die Arbeit von 2024 zeigt eine reife Phase, in der der Stack an seinen physischen Kosten gemessen wird. Die Frage wandelt sich von „Welches Protokoll gewinnt?“ zu „Wie viel verbraucht jede Verbindung still von der Maschine?“
Dumazets bleibender Beitrag ist Ressourcendisziplin, nicht der Mythos des einsamen Helden
Eine schlechte Erzählung macht ihn allein zum Erfinder von modernem TCP und BBR; eine andere löscht das Individuum in der Gemeinschaft aus. Die Belege stützen eine präzisere Mitte.
Er führte TSQ ein, trug zur Grundlage vonsch_fqbei, entwickelte internes Pacing, zeigte die Bedeutung von Layout und trägt heute Verantwortung in einem gemeinsamen Wartungssystem. Der Kern seines Beitrags ist, Pakete und Sockets als Ansprüche auf begrenzte Zeit, Speicher, Warteschlangen und CPU-Lokalität zu behandeln.
Die endgültige Wirkung verteilt sich auf Design, Review, Merge und Betrieb. Ein Commit ist leicht zuzuschreiben, schwerer die Dichte einer Flotte oder ein vermiedener Ausfall. Diese Schwierigkeit rechtfertigt weder Übertreibung noch Auslöschung; sie zeigt, dass der Wert der Infrastruktur aus identifizierbaren Ingenieurentscheidungen und kollektiver Umsetzung entsteht.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten